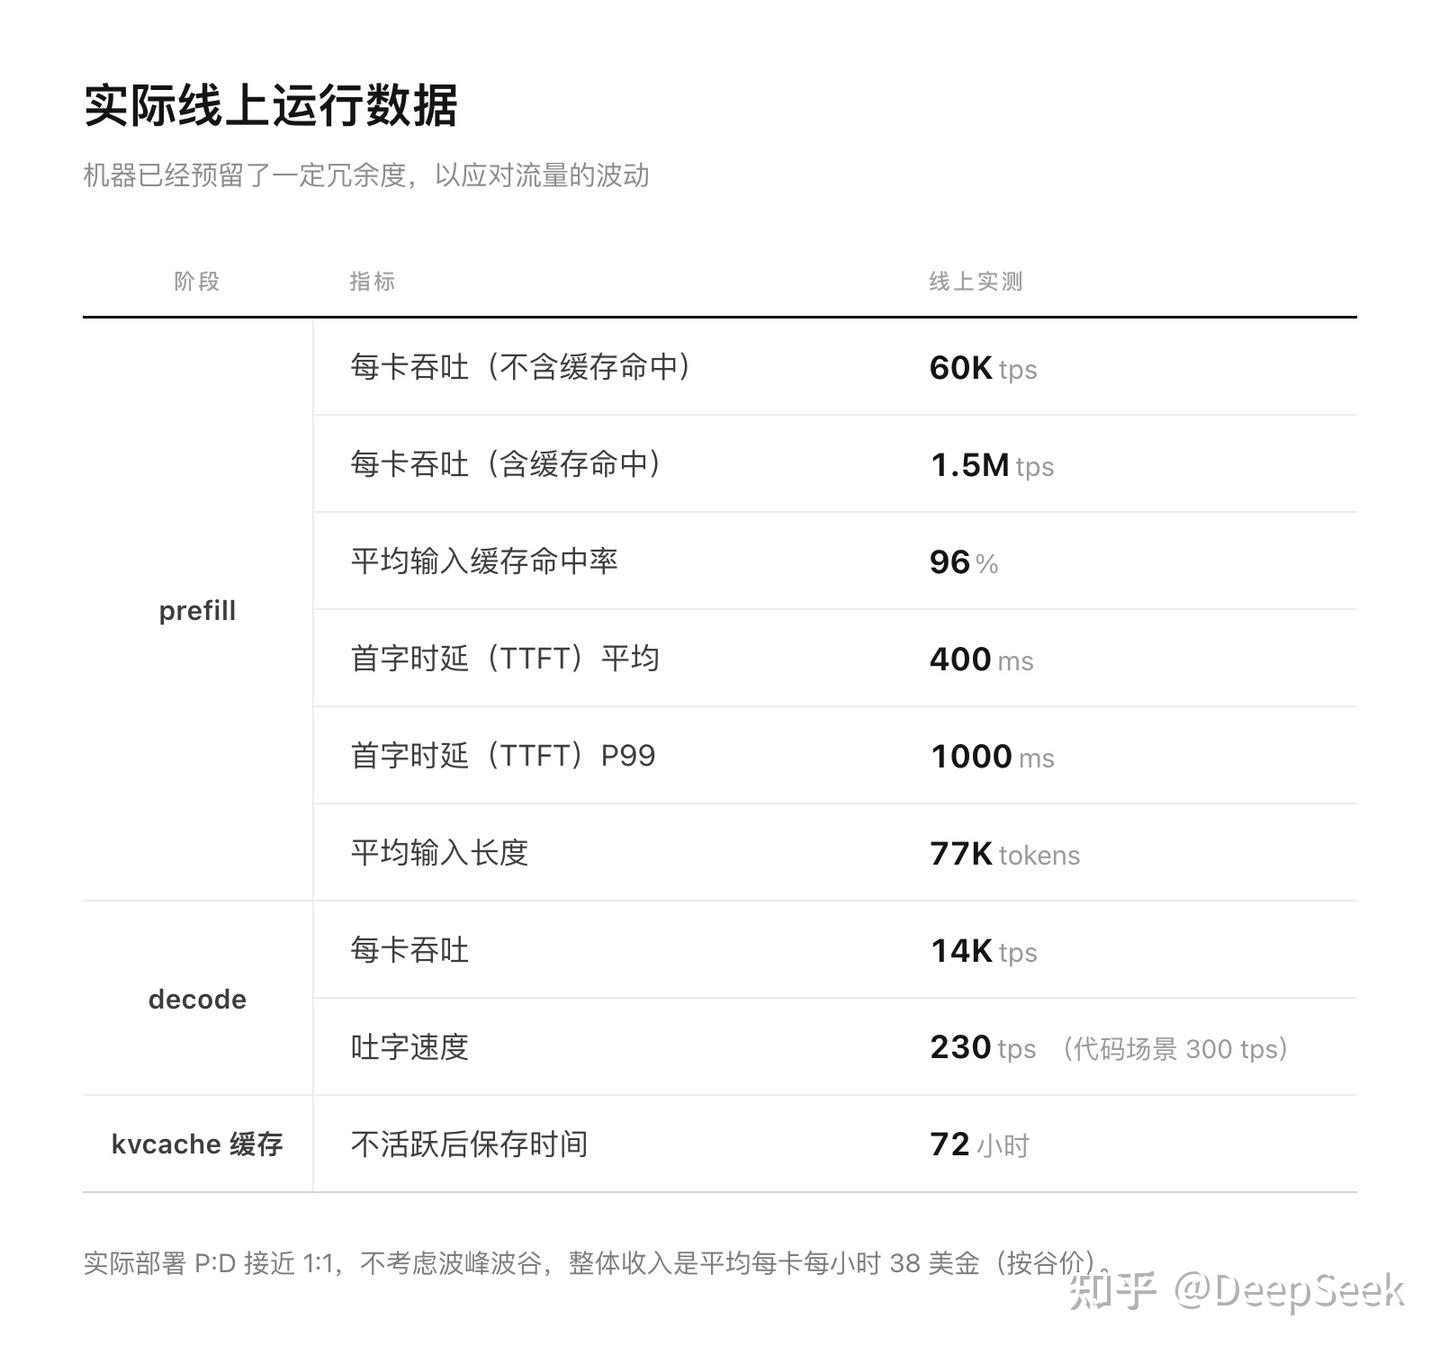
DeepSeek hat sein Inferenz-Framework vollständig als Open Source veröffentlicht: Es ist kompatibel mit NVIDIA-Chips und Huawei Ascend-Chips, erreicht einen täglichen Durchsatz von 155 Billionen Token pro einzelnem Cluster und generiert einen Erlös von 38 US-Dollar pro Karte pro Stunde.
DeepSeek hat das vollständige Open-Source-Inferenzframework DeepInfer und die Token-Codec-Komponente deepseek-recipe veröffentlicht, die sowohl mit NVIDIA- als auch mit Huawei-Ascend-Plattformen kompatibel sind. Auf Basis dieses Frameworks erreicht DeepSeek V4.1 Flash in einem einzelnen Cluster einen täglichen Durchsatz von 155 Billionen Token, was einem Einkommen von 38 US-Dollar pro Grafikkarte und Stunde bei Niedrigstromtarifen entspricht. Durch Technologien wie die Trennung von Prefill und Decode, die Wiederverwendung von KVCache und spekulatives Dekodieren zielt DeepSeek darauf ab, die Inferenzeffizienz zu steigern sowie die Rechenkosten und den Energieverbrauch zu senken.
DeepSeek öffnet darüber hinaus die Infrastruktur für die Inferenz großer Modelle weiter.
Nach der Veröffentlichung von Open-Source-Großmodellen, dem TileLang-Compilierungstool und einer Reihe von Inferenzoperator-Bibliotheken kündigte DeepSeek die vollständige Open-Source-Veröffentlichung seines internen Inferenzframeworks DeepInfer an und veröffentlicht gleichzeitig die Token-Codec-Komponente deepseek-recipe. Das Ziel besteht darin, Entwicklern und Unternehmen bei der Optimierung des Einsatzes großskaliger Modelle zu helfen und die Rechenkosten sowie den Energieverbrauch von KI-Diensten zu senken.
Laut DeepSeek hat das Team auf Basis von DeepInfer bereits einen großskaligen Inferenzdienst mit hohem Durchsatz und niedriger Latenz für DeepSeek V4.1 Flash realisiert. Derzeit erreicht der Dienstdurchsatz eines einzelnen Clusters 155 Billionen Token pro Tag, was einem Einkommen von 38 US-Dollar pro Grafikkarte und Stunde bei Niedrigstromtarifen entspricht.
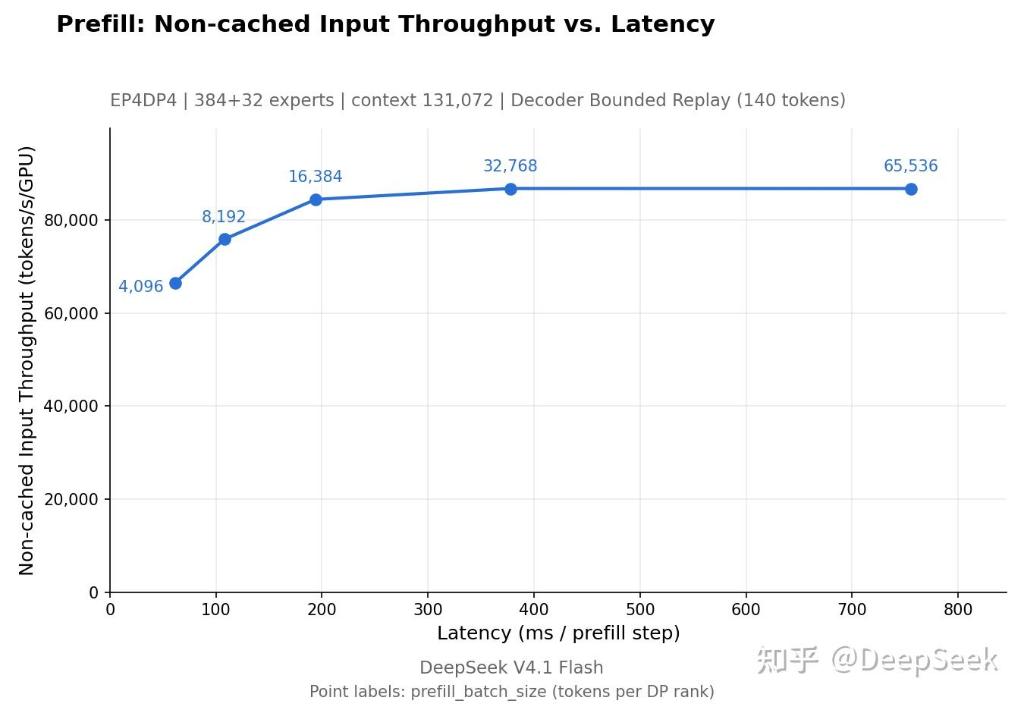
Inferenzframeworks sind die entscheidende Infrastruktur, die die Fähigkeiten großer Modelle mit den Endnutzern verbindet. Mit dem Anstieg der Aufrufvolumina von KI-Anwendungen hängen die Kosten von Inferenzdiensten nicht nur vom Modell selbst ab, sondern werden auch durch Gliederungen wie Berechnung, Kommunikation, Aufgabenplanung und Cache-Verwaltung beeinflusst. Wie man die effektive Durchsatzrate unter Einhaltung der Latenzanforderungen steigern kann, ist zu einem wichtigen Glied für die Kostensenkung und Effizienzsteigerung großskaliger KI-Dienste geworden.
Kompatibel mit NVIDIA und Huawei Ascend, Optimierung der Rechenkapazitätskonfiguration für verschiedene Inferenzphasen
DeepInfer integriert Hochleistungsoperatoren und tiefgehend optimierte Inferenz-Engines, unterstützt Fähigkeiten wie verteilte Inferenz, spekulatives Dekodieren, SWA Bounded Replay und strukturierte Ausgabe und kann auf NVIDIA- sowie Huawei-Ascend-Plattformen ausgeführt werden. In der Zukunft werden der Inferenzcode neuer DeepSeek-Modelle und nachfolgende Leistungsoptimierungen auch in diesem Framework kontinuierlich als Open Source veröffentlicht.
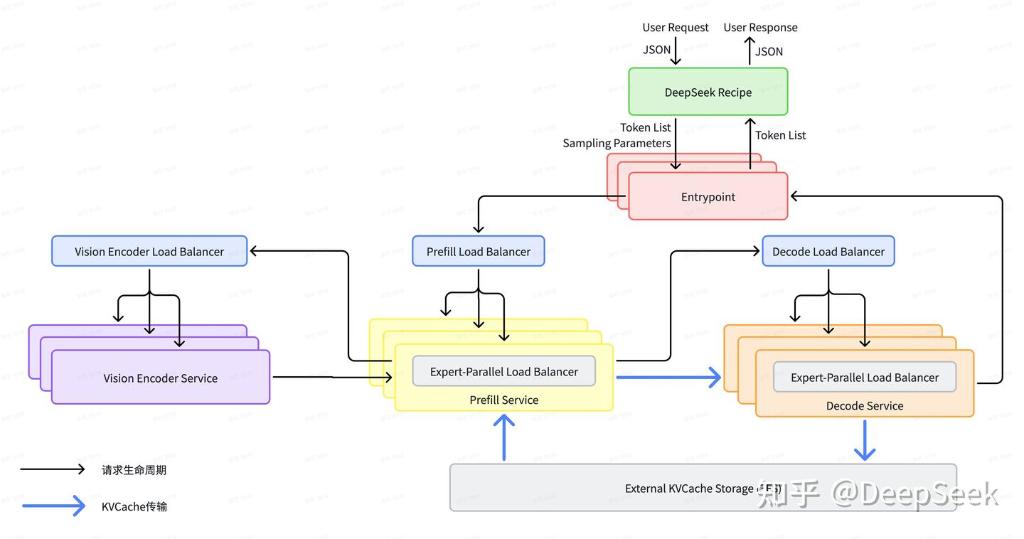
Angesichts der großskaligen KI-Aufrufanforderungen legt DeepSeek den Optimierungsschwerpunkt des Inferenzsystems auf Durchsatz und Latenz. Das System setzt die getrennte Bereitstellung von Prefill und Decode ein: Ersteres ist für die Verarbeitung von Eingabeprompts zuständig, Letzteres für die schrittweise Generierung von Token. Da die Rechenlasten der beiden Phasen unterschiedlich sind, ermöglicht die getrennte Bereitstellung eine unabhängige Konfiguration der Ressourcen und die separate Optimierung der Generierungszeit des ersten Tokens sowie des Generierungsintervalls nachfolgender Token.
Bei der Hardware-Organisation nutzt DeepSeek übliche Maschinen mit 8 Grafikkarten für die Prefill-Aufgaben und Superknoten mit 64 bis 128 Grafikkarten für die Decode-Aufgaben. Gleichzeitig passt das System das Instanzenverhältnis der beiden Phasen durch automatische Skalierung dynamisch an, um Ressourcenfehlzuordnungen aufgrund von Verkehrsschwankungen zu reduzieren. Bei der Inferenz von MoE-Modellen wird durch Expertenparallelisierung und dynamische Lastverteilung die Lastdifferenz zwischen verschiedenen Rechenkarten verringert.
KVCache wird maximal 7 Tage aufbewahrt, um den Overhead durch wiederholte Berechnungen zu reduzieren
Die Wiederverwendung von Caches ist ein weiteres zentrales Design von DeepSeek zur Senkung der Inferenzkosten. Mit der Zunahme von Konversationen mit langem Kontext und KI-Agent-Anwendungen kann das gleiche Präfix in verschiedenen Anfragen wiederholt auftreten. Wenn diese Inhalte jedes Mal neu verarbeitet werden, entsteht zusätzlicher Berechnungsaufwand.
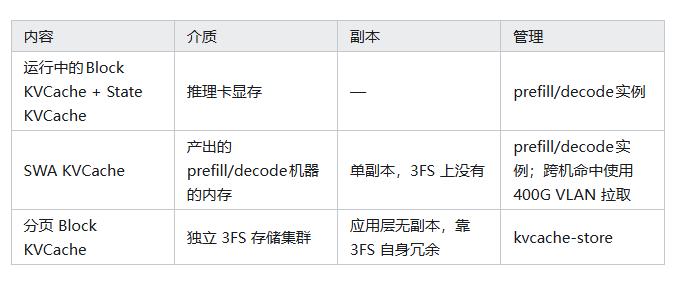
DeepSeek V4.1 Flash unterteilt den KVCache in zwei Teile: Block KVCache und SWA KVCache, für die unterschiedliche Speicherstrategien angewendet werden. Der Block KVCache wird im verteilten 3FS-Dateisystem gespeichert, dessen Speicherkapazität etwa 100 PiB beträgt. Laut den von DeepSeek veröffentlichten Daten beträgt die Aufbewahrungsdauer des KVCache für Agent-Verkehr 3 Tage, für Chatbot-Verkehr sogar 7 Tage.
Wenn nachfolgende Anfragen einen vorhandenen Cache treffen, kann das System die vorherigen Berechnungsergebnisse wiederverwenden und wiederholte Prefill-Berechnungen reduzieren. DeepSeek gibt an, dass der Spitzenwert der aggregierten Lesebandbreite des 3FS-Speicherclusters 10 TiB/s und der Spitzenwert der aggregierten Schreibbandbreite etwa 850 GiB/s erreicht, um den Anforderungen großskaliger Cache-Lese- und Schreibvorgänge gerecht zu werden.
Für den SWA KVCache, der hauptsächlich in aktiven Sitzungen kurzfristig wiederverwendet wird, wählt DeepSeek die Speicherung im Arbeitsspeicher der Maschine aus, ohne permanente Speicherung. Online-Daten zeigen, dass die Aufbewahrungsdauer dieses Caches etwa 180 Sekunden beträgt und die Trefferquote über 98 % liegt.
Für Fälle, in denen der SWA KVCache nicht getroffen wird, wendet DeepSeek den SWA-Bounded-Replay-Mechanismus an, bei dem nur die letzten 128 Token neu berechnet und das Aufmerksamkeitsfenster auf den Neuberechnungsbereich beschränkt wird, um die zusätzlichen Berechnungskosten aufgrund von Cache-Fehlern zu senken.
Spekulatives Dekodieren steigert den Durchsatz, Codec-Komponenten werden gleichzeitig als Open Source veröffentlicht
Neben der Cache-Wiederverwendung steigert DeepSeek die Inferenzeffizienz auch durch spekulatives Dekodieren und asynchrone Planung.
DeepSeek verwendet das DSpark-Framework für spekulatives Dekodieren, das den Überprüfungsbereich dynamisch entsprechend der erwarteten Akzeptanzwahrscheinlichkeit der Kandidaten-Token bestimmt, um zu vermeiden, dass Überprüfungsrechenkapazität für Kandidatenergebnisse mit niedriger Akzeptanzwahrscheinlichkeit verschwendet wird. Laut DeepSeek erhöht die variable Längenprüfung den Durchsatz im Online-Einsatz um 6 % im Vergleich zur Methode mit fester Überprüfung von 5 Token.
Im Planungsabschnitt lässt das System durch die asynchrone Zusammenarbeit zwischen CPU und GPU Operationen wie Anfrageplanung, Vorwärtsberechnung und Stichprobenerhebung so weit wie möglich überlappen, um die Wartezeit der Geräte zu reduzieren. Darüber hinaus unterstützt DeepInfer strukturierte Ausgaben, die die Generierungsergebnisse des Modells gemäß Einschränkungen wie JSON-Schema und regulären Ausdrücken steuern können, um die Anforderungen bestimmter Anwendungen an das Ausgabeformat zu erfüllen.
DeepSeek veröffentlicht außerdem gleichzeitig die produktionsreife Token-Codec-Komponente deepseek-recipe. Diese Komponente unterstützt gängige Schnittstellen wie die Chat Completions API, Responses API und Messages API und steigert die Verarbeitungseffizienz für lange Texte durch Mechanismen wie spezielle Token-Grenzenerkennung, parallele Kodierung von Abschnitten von Normaltext und Analyse von Streaming-Ausgaben, um sicherzustellen, dass die API-Verarbeitungslogik von Drittanbieter-Bereitstellungen mit dem offiziellen Dienst übereinstimmt.
Allerdings hat DeepSeek nicht alle Komponenten des Inferenzsystems geöffnet. Da die Teile der KVCache-Verwaltung und Lastverteilung eng mit der internen Infrastruktur gekoppelt sind, wurde der entsprechende Code derzeit noch nicht vollständig als Open Source veröffentlicht.
Von Modellen und Operator-Bibliotheken bis hin zum großskaligen Inferenzframework erweitert DeepSeek mit dieser Maßnahme den Abdeckungsbereich des Open-Source-Technikstapels weiter. Für Entwickler und Unternehmen dürfte dies die technischen Hürden für den Aufbau von privaten und öffentlichen Cloud-KI-Diensten senken. Für die Branche der großen Modelle wird die Steigerung des Inferenzdurchsatzes, die Wiederverwendung von Berechnungsergebnissen und die Anpassung an verschiedene Hardwareplattformen zu einer wichtigen Richtung für die Kontrolle der Kosten von KI-Diensten.
Dieser Artikel stammt aus „Wallstreetcn“, Autor: Bu Shuqing, veröffentlicht mit Genehmigung von 36Kr.