Wird der Preis-Leistungs-König der chinesischen KI-Branche abgelöst? MiniMax meint es wirklich ernst.
Wie weit hat der Preiskrieg um inländische Großmodelle bereits zugenommen?
Am 19. Oktober stellte MiniMax offiziell M3.1 Flash vor: Für die Eingabe von einer Million Token werden nur 1 Yuan verlangt, für die Ausgabe 4 Yuan, und das Lesen aus dem Cache kostet sogar nur 0,1 Yuan.
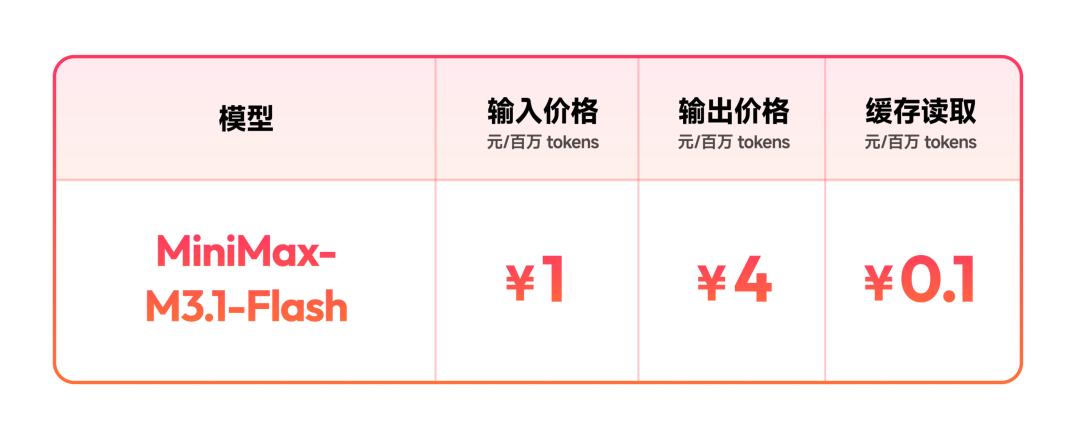
Laut offizieller Angaben hat die Modellinferenzgeschwindigkeit um fast das 3-fache zugenommen, und die Gesamtkosten für die Nutzung von Agent-Aufgaben sind um 70 % gesunken.
Na also, die inländischen Modelle haben die Preise diesmal wieder gedrückt.
Aber wenn es nur billig wäre, wäre das nichts Besonderes.
Schließlich haben inländische Modelle wie Tongyi, Zhipu und Doubao die Eingabepreise einiger Flash-Modelle schon lange unter 1 Yuan gedrückt.
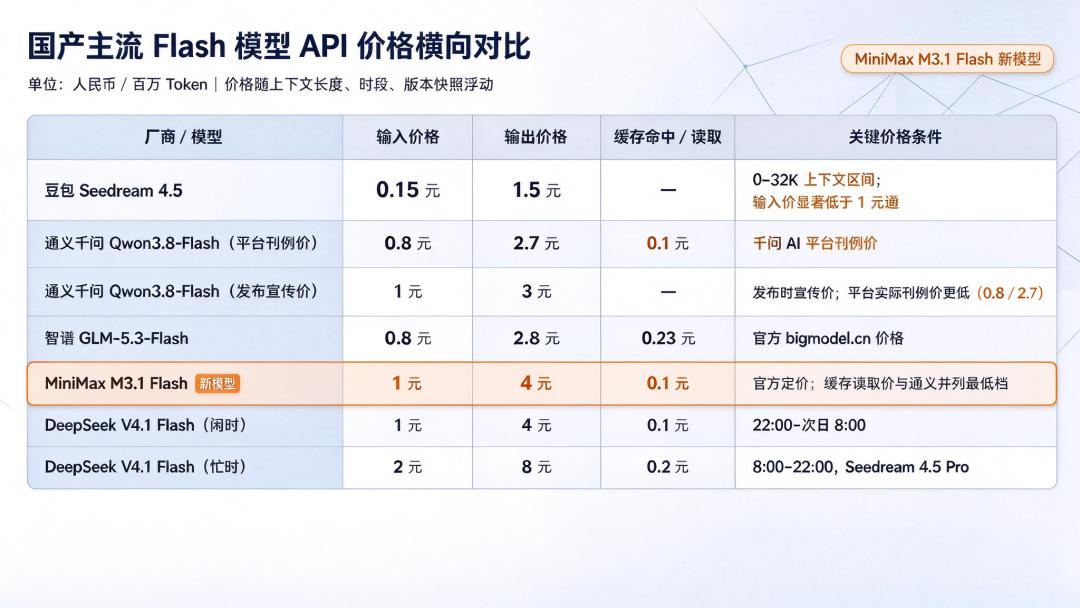
Bevor dieser Preiskrieg begann, hatte M3.1 Flash bereits unter einem anderen Namen an Tests teilgenommen.
Zuvor wurde es unter dem Namen des anonymen Modells Space Bunny in der Entwicklergemeinde praktischen Nutzungsprüfungen unterzogen.
Innerhalb von 3 Tagen nach der Veröffentlichung erreichte es den ersten Platz bei der täglichen Token-Nutzungsmenge von OpenRouter und OpenCode und erregte große Aufmerksamkeit.
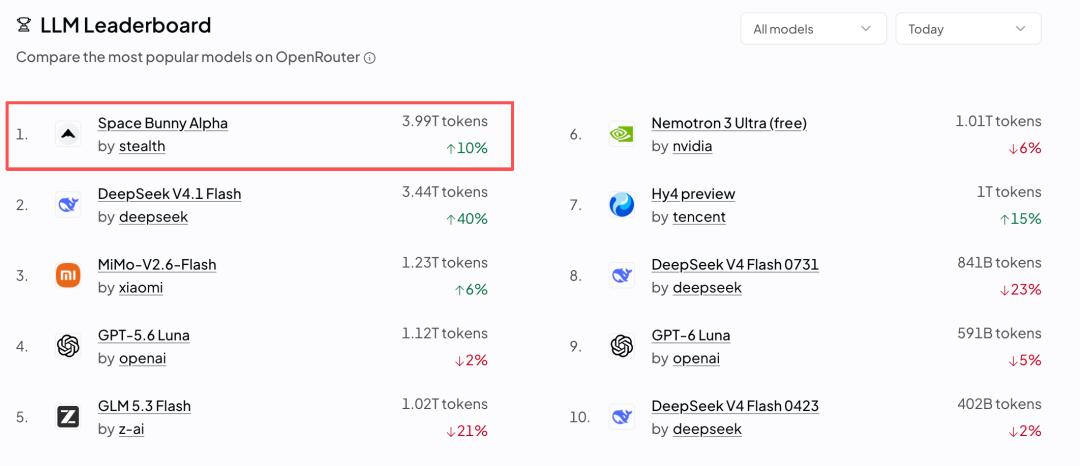
Jetzt wurde seine Identität offiziell bekannt gegeben, und die Richtung, die MiniMax vorgibt, ist sehr klar: Es zielt auf Aufgaben wie Codierung, komplexe Agenten und Computerbedienung ab, versucht, das Modell schneller und leistungsfähiger zu machen und gleichzeitig die Aufrufkosten zu senken.
Schließlich bemerken Nutzer kaum einen Unterschied, wenn der Preis für AI-Chats um ein paar Cent sinkt.
Aber wenn ein Agent das Modell Dutzende Male nacheinander aufrufen muss, um Code zu schreiben, Fehler zu beheben und Tests durchzuführen, kann sich der Kostenunterschied vervielfachen.
Benchmarks, Geschwindigkeit, Kosten – der Wettbewerb läuft in vollem Umfang
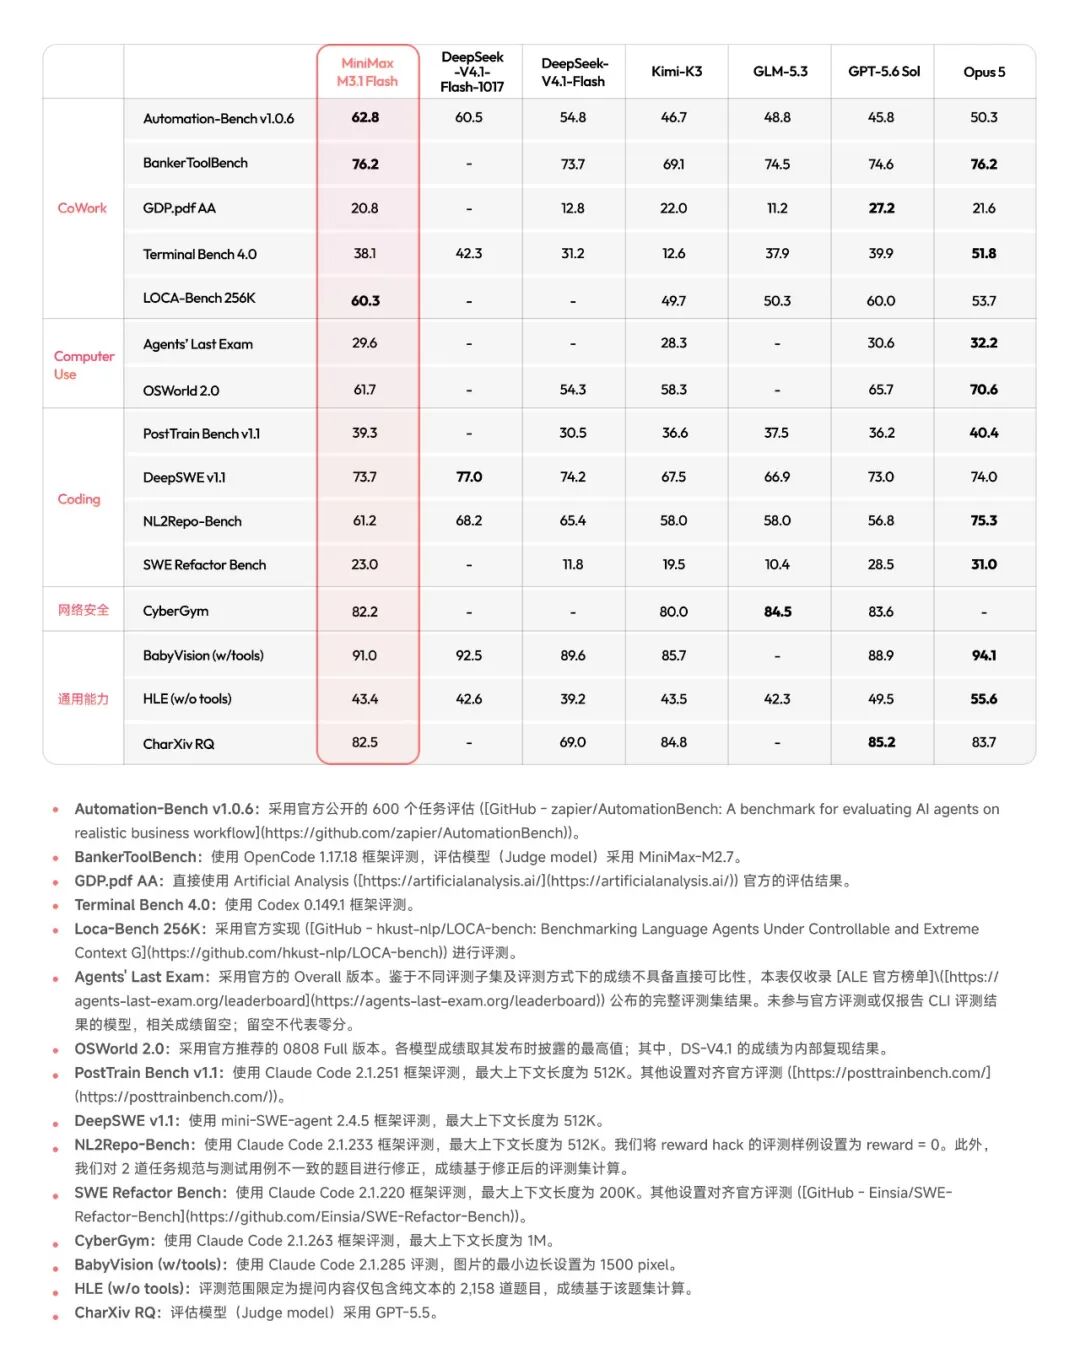
Betrachten wir zuerst die Stärken von M3.1 Flash: Automatisierung von Unternehmensworkflows und Aufruf von Finanzwerkzeugen.
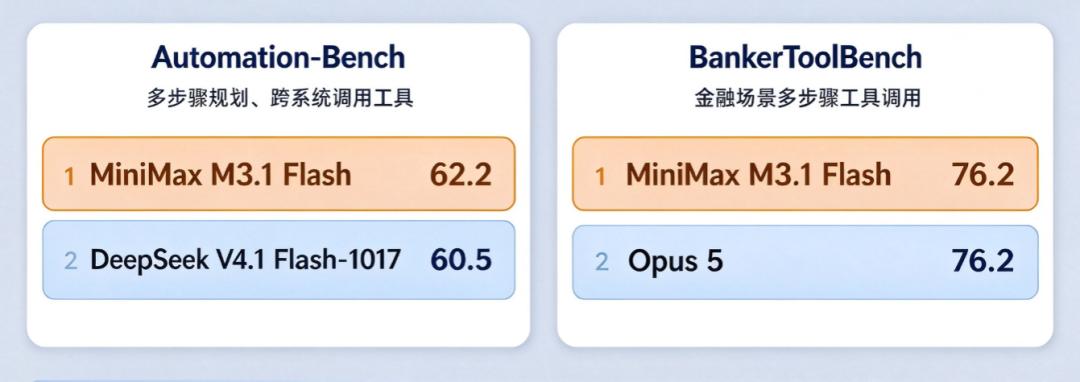
Diese beiden Ergebnisse zeigen, dass die Stärke von M3.1 Flash nicht nur in der Textgenerierung liegt, sondern darin, Aufgaben zu verstehen, Werkzeuge aufzurufen, Prozesse voranzutreiben und Dinge so weit wie möglich abzuschließen.
Tests zur Computerbedienung bestätigen diese Richtung.
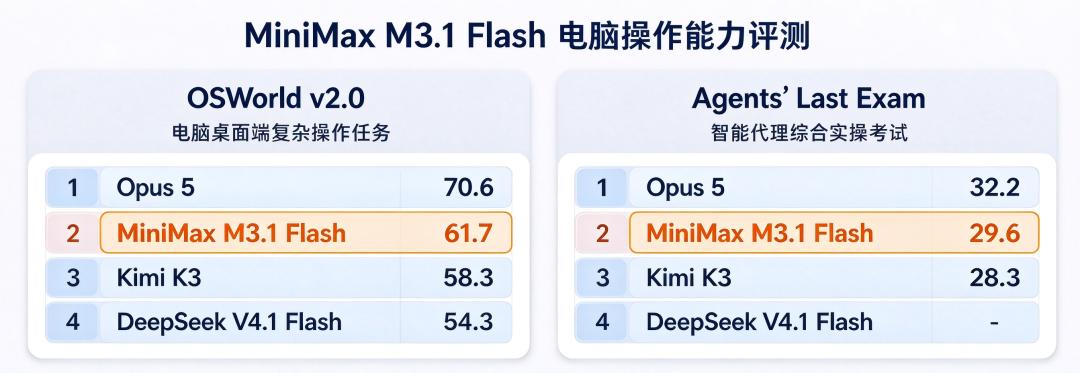
Laut MiniMax belegen diese beiden Ergebnisse den ersten Platz unter allen inländischen Modellen.
Mit anderen Worten, es ähnelt eher einem ausführenden Spieler: Es ist gut darin, Aufgaben aufzuteilen, Werkzeuge aufzurufen und dann den Prozess Schritt für Schritt abzuschließen.
Aber wenn es um komplexe Codeentwicklung und Terminalbedienung geht, ist M3.1 Flash nicht mehr so konkurrenzfähig.
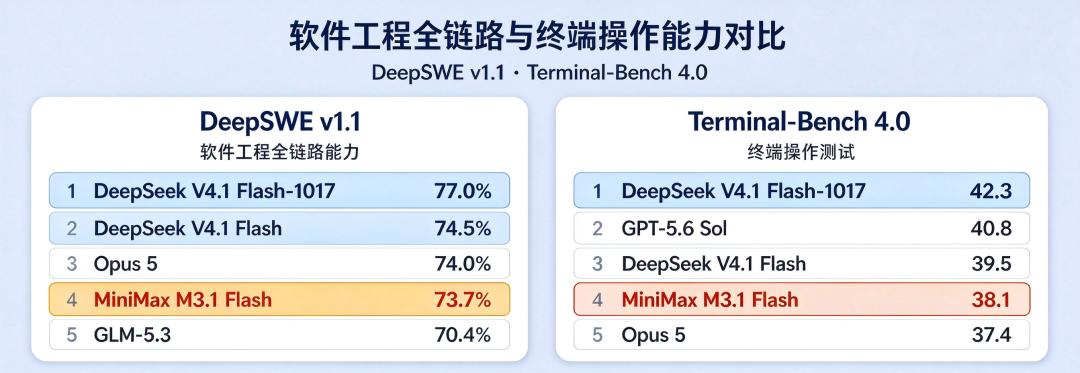
Schauen wir uns die Bewertung der Drittplattform Artificial Analysis an ⬇️
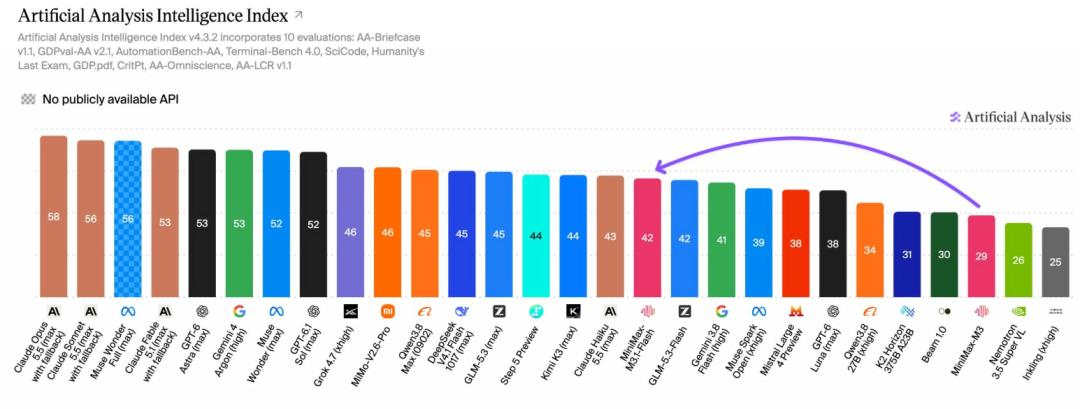
Die Gesamtpunktzahl von M3.1 Flash beträgt 42, was deutlich höher ist als die des Vorgängermodells M3, aber etwas unter den 45 Punkten von DeepSeek V4.1 Flash-1017 liegt.
Die Fortschritte sind zwar beträchtlich, reichen aber noch nicht aus, um vergleichbare Modelle weit hinter sich zu lassen.
Aber interessant ist, dass sich die Kosten deutlich auseinanderhalten ⬇️
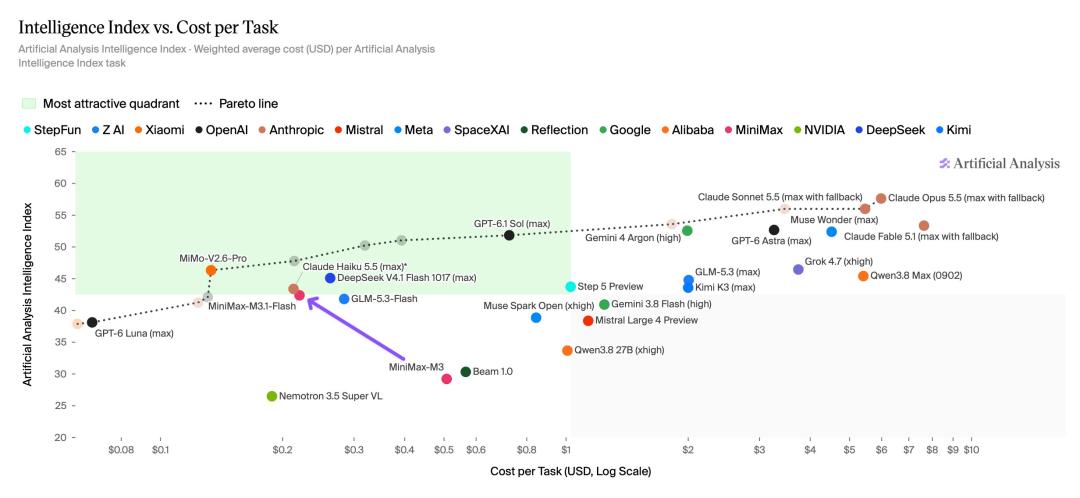
Für die Durchführung der gesamten Intelligence Index-Bewertung betragen die Kosten von M3.1 Flash etwa 0,22 US-Dollar, was unter den 0,26 US-Dollar von DeepSeek, den 0,28 US-Dollar von GLM und weit unter den 1,24 US-Dollar von Gemini 3.8 Flash liegt.
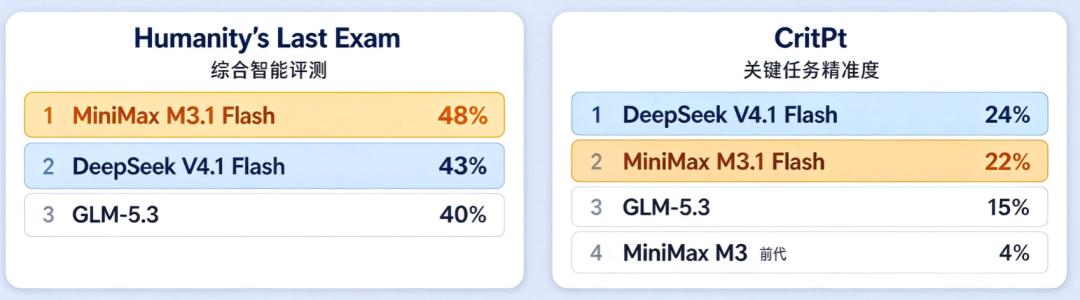
Auch in den einzelnen Unterpunkten hat es seine Highlights ⬇️
Schauen wir uns noch die Kosten für automatisierte Aufgaben an. Eine weitere offizielle Datenreihe von MiniMax aus Automation-Bench zeigt: Unter den Testeinstellungen mit der höchsten Inferenzintensität erreicht M3.1 Flash eine Punktzahl von 62,8 % und die Kosten pro einzelner Aufgabe betragen etwa 0,045 US-Dollar.
Hinzu kommt die von der offiziellen Seite angegebene Ausgabegeschwindigkeit von über 200 TPS sowie die um 70 % gesenkten Gesamtkosten für Agent-Aufgaben im Vergleich zum Vorgängermodell.
Zusammengenommen wird das Verkaufsargument von M3.1 Flash deutlich: Bei gleichem Budget kann es mehr Agent-Aufgaben erledigen.
Praxisprüfung von M3.1 Flash
Benchmarks bleiben Benchmarks – ob das Modell wirklich gut funktioniert, zeigt sich erst, wenn es praktisch eingesetzt wird.
Ein Entwickler hat mit MiniMax Code ein Projekt für die kleine Eisenbahn in einer japanischen Kleinstadt getestet.
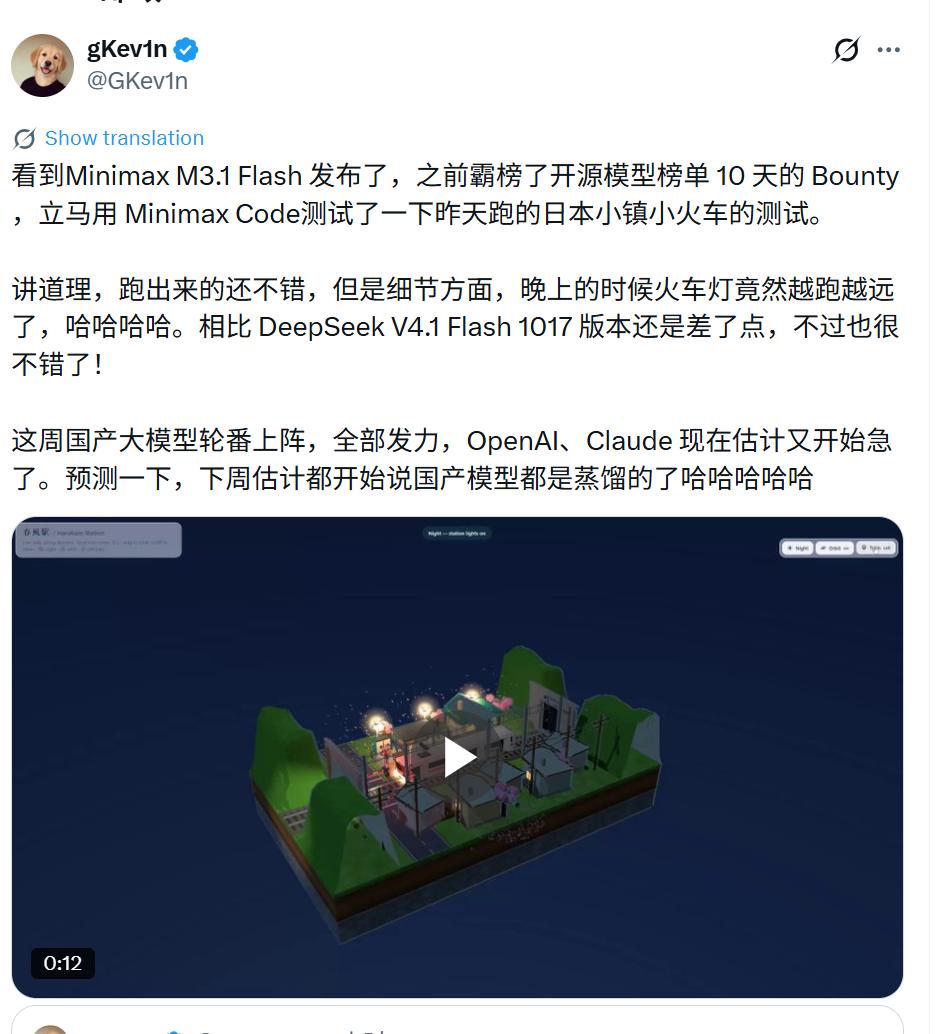
Das Gesamtergebnis der Generierung ist recht gut, aber es ist auch ein interessanter Fehler aufgetreten: In der Nachtszene scheint sich das Scheinwerferlicht des fahrenden Zuges immer weiter zu entfernen.
Ein anderer Entwickler hat mit MiniMax M3.1 Flash und DeepSeek V4.1 Flash 1017 dasselbe Projekt zum Eiffelturm abgeschlossen.
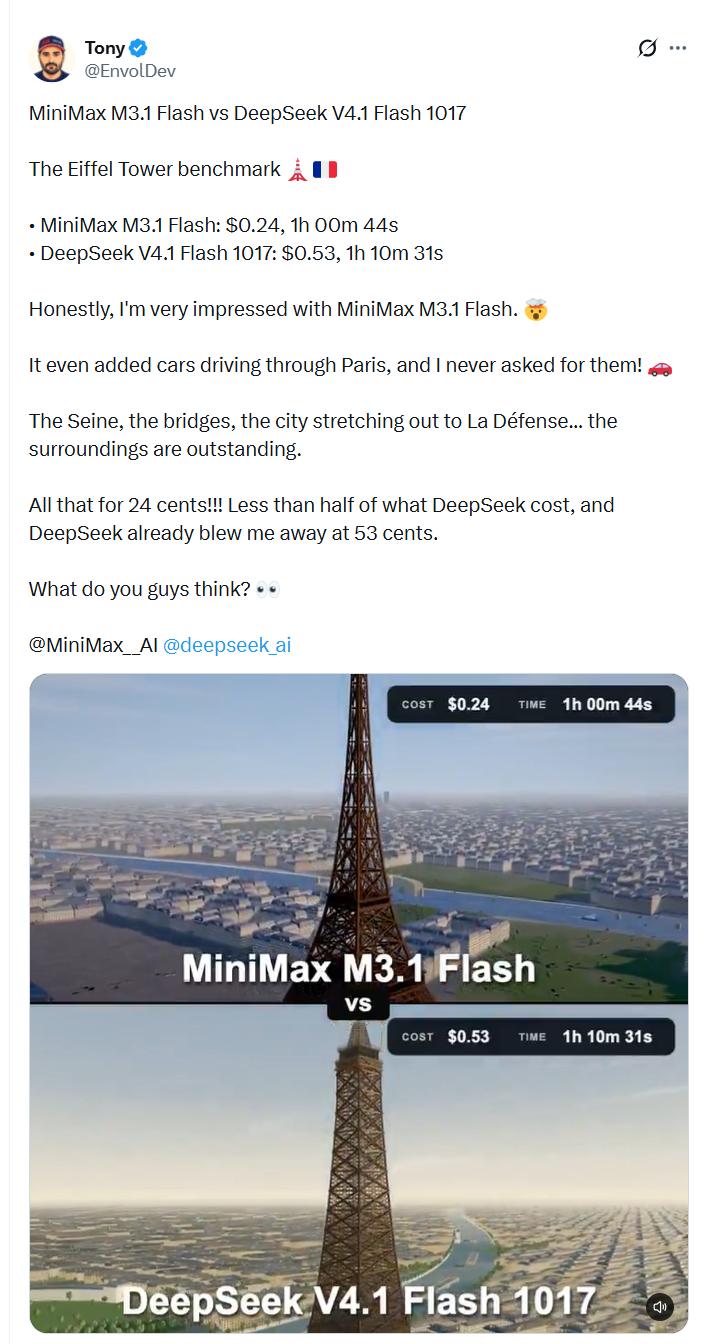
Die niedrigen Kosten und die Generierungsfähigkeit von M3.1 Flash sind wirklich beeindruckend: Es hat nicht nur die Seine, die Brücken und die Stadtsilhouette wiedergegeben, sondern auch aktiv Fahrzeuge hinzugefügt, die auf den Straßen von Paris fahren.
Aber bei einem weiteren Test zur Egoperspektive beim Fahren eines Tesla Roadsters meinte der Blogger, dass MiniMax M3.1 Flash zwar billig sei, aber die schlechteste visuelle Wirkung liefere.
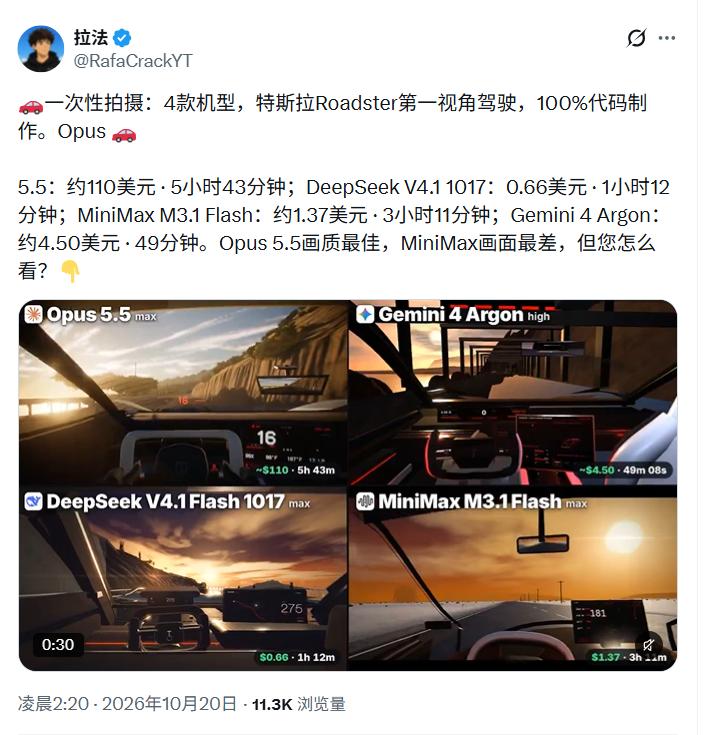
Im Vergleich dazu ist DeepSeek V4.1 Flash 1017 wirklich überlegen.
Man sieht, dass sich der Kostenvorteil von M3.1 Flash bei etwas komplexeren Aufgaben nicht immer in einen Vorteil bei der Ergebnisqualität umwandeln lässt.
Aber bei der Generierung einer pixeligen Wasserstadt sieht das Ergebnis wieder anders aus.
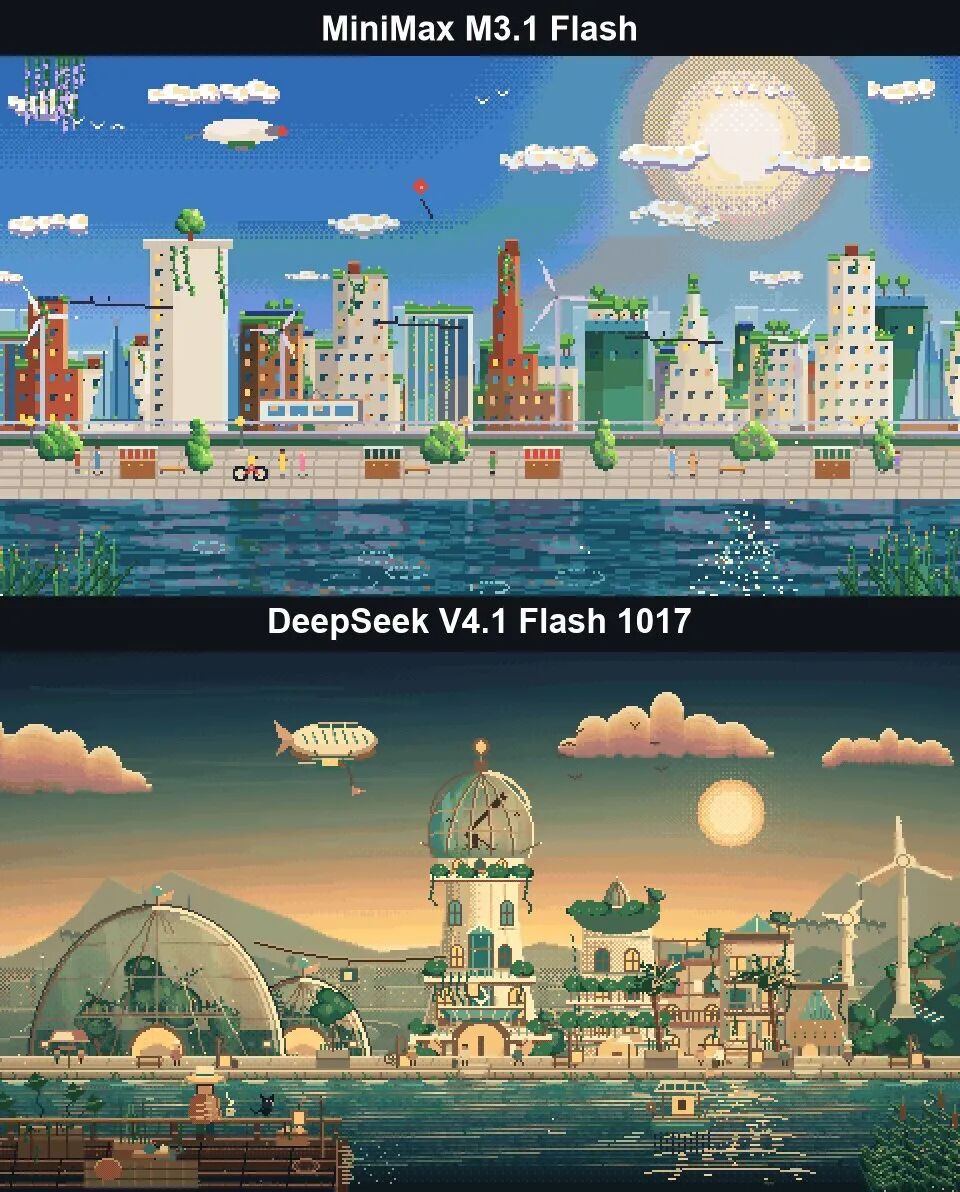
Bei gleichen Eingabewörtern und Inferenzparametern haben MiniMax M3.1 Flash und DeepSeek V4.1 Flash 1017 unterschiedliche Stile, die sich kaum voneinander unterscheiden lassen.
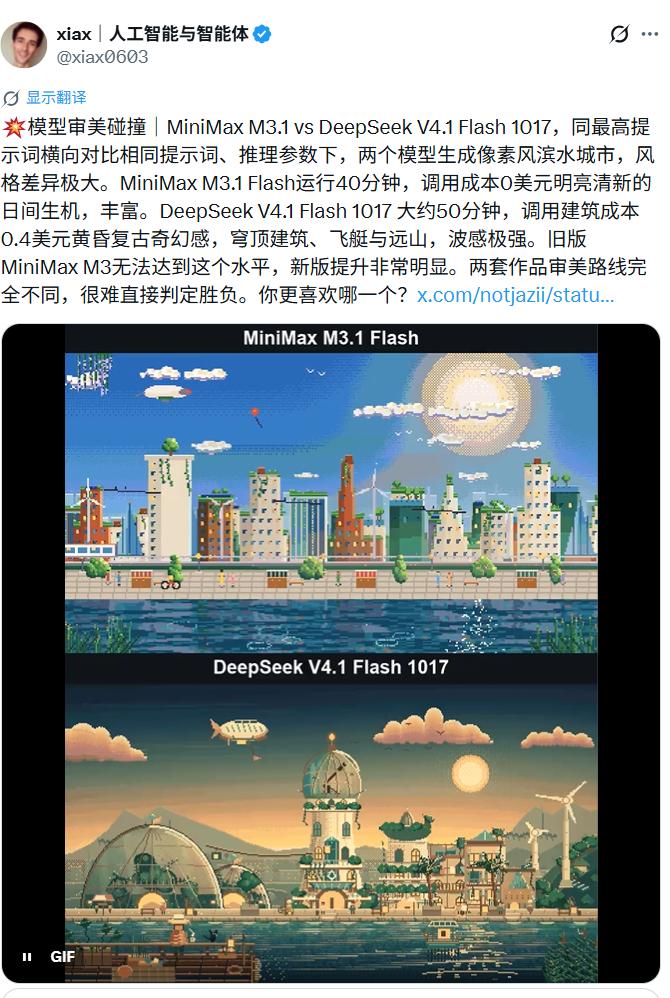
Zusammenfassend haben viele Tester in dieser Testrunde angegeben, dass M3.1 Flash im Vergleich zum Vorgängermodell deutliche Fortschritte gemacht hat.
Aber im direkten Vergleich mit DeepSeek V4.1 Flash 1017 schneiden beide Modelle in verschiedenen Bereichen jeweils gut ab, sie sind kaum voneinander zu unterscheiden und haben jeweils ihre eigenen Kostenvorteile.
Aber zumindest aus diesen Praxistests geht hervor, dass M3.1 Flash bereits über die Fähigkeit verfügt, direkt mit DeepSeek zu konkurrieren. Welches Modell man letztendlich wählt, hängt von der konkreten Aufgabe und den tatsächlichen Kosten ab.
Inländische Flash-Modelle beginnen, sich in der Arbeitsleistung zu messen
In der Vergangenheit wurden Flash-Modelle oft als kostengünstige Alternative zu Hochleistungsmodellen betrachtet, die für einfache Fragen und Antworten, Zusammenfassungen und Klassifizierungen geeignet sind.
Heute beginnen die Hersteller, sie für Codierung, Computerbedienung, komplexe Agenten und automatisierte Prozesse einzusetzen. Der Schwerpunkt des Wettbewerbs verschiebt sich von „ausreichend billig“ zu „ob komplexe Aufgaben gut erledigt werden können“.
Die Modelle der verschiedenen Hersteller haben jeweils ihre eigenen Vorteile und sind kaum voneinander zu unterscheiden. Das zeigt, dass der Wettbewerb auf dem Markt für inländische Flash-Modelle kein Nullsummenspiel ist.
Für Entwickler muss die Wahl des Modells nicht nur auf Ranglisten beruhen, sondern es müssen auch die Aufgabenerfolgsrate, die Aufrufgeschwindigkeit, die Gesamtkosten und das Endergebnis gemeinsam berücksichtigt werden.
Welche Änderungen die kommende Pro-Version von MiniMax bringen wird, bleibt abzuwarten, bis sie offiziell veröffentlicht und praktisch getestet wird.
Aber sicher ist, dass dieser Wettbewerb der inländischen Modelle, der sich von dem Preiswettbewerb zum Wettbewerb um Fähigkeiten ausweitet, noch lange nicht beendet ist.