Die drei entscheidenden Puzzleteile von RSI: MemT 1.0 ergänzt das "Gedächtnis" auf Modellebene
In der KI-Branche konzentriert sich die Aufmerksamkeit in letzter Zeit kollektiv auf drei Buchstaben: RSI.
Hintons RSI-Papier hat 22 unterzeichnende Autoren, darunter Bengio, Pachocki, der leitende Wissenschaftler von OpenAI, Jack Clark, Mitbegründer von Anthropic... fast die Hälfte der Spitzenkräfte der KI-Branche ist hier vertreten.
Während alle ihre Aufmerksamkeit auf die Selbstverbesserung von KI richten, taucht eine grundlegendere, fragwürdigere Frage auf:
Wie kann eine Verbesserung zum Ausgangspunkt der nächsten werden?
Effektive Methoden müssen beibehalten werden, und die eingeschlagenen Umwege müssen ebenfalls erkannt werden – was diese Aufgabe übernimmt, ist eigentlich das Gedächtnis.
Der herkömmliche Ansatz ist einfach: Man schließt der KI direkt eine externe Erfahrungsdatenbank an, sodass alle Betriebsmethoden und historischen Lehren gespeichert und abgerufen werden können.
Die Erforschung von Gedächtnistensoren in diesem Bereich liefert eine völlig andere Antwort – Gedächtnis-Nativität.
Was bedeutet Gedächtnis-Nativität? Es bedeutet, die Speicherung, Aktualisierung und den Abruf von Erfahrungen zu einer Fähigkeit zu machen, die das Modell erlernen kann.
Wenn das Gedächtnis im Modell Wurzeln schlägt und wächst, entsteht ein natives Gedächtnismodell.
Die neueste Open-Source-Veröffentlichung der MemT 1.0-Serie bietet einen sehr konkreten Weg:
Es kodiert Erfahrungen in interne dynamische Zustände, lernt dann durch Training, wie diese geschrieben, aktualisiert und gelesen werden, und lässt diese Zustände schließlich über einen Gedächtniszweig an nachfolgenden Berechnungen teilnehmen.
Im Vergleich zum externen Gedächtnis leidet es nicht unter Leistungseinbußen, und die Obergrenze für zukünftige Erweiterungen ist ebenfalls höher.
Dies ist auch das erste Mal, dass ein natives Gedächtnismodell eine technische Validierung mit einer Parametergröße von fast 300 Milliarden erreicht.
(Link zum Papier: https://arxiv.org/abs/2610.26825)
Das Gedächtnis ist zwar unsichtbar und ungreifbar, bildet aber tatsächlich die Grundlage für das Wachstum des Modells.
Von den frühen Anforderungen an das Modell, sich Informationen zu merken, bis hin zur sinnvollen Nutzung von Erfahrungen steigen die Anforderungen des Modells an das Gedächtnis stetig, was das Gedächtnis Schritt für Schritt aus dem Hintergrund in den Vordergrund rückt.
Das Gedächtnis in das Modell einbauen
MemT 1.0 stellt diesmal direkt zwei Modelle vor:
MemT-1.0-Nano hat insgesamt 36 Milliarden Parameter, von denen 3 Milliarden aktiviert sind, und basiert auf dem Basismodell „Qwen3.6-35B-A3B“; MemT-1.0-Flash geht noch weiter und erreicht 288 Milliarden Parameter mit 17 Milliarden aktivierten Parametern, sein Basismodell ist das nachtrainiertes DeepSeek-V4-Flash.
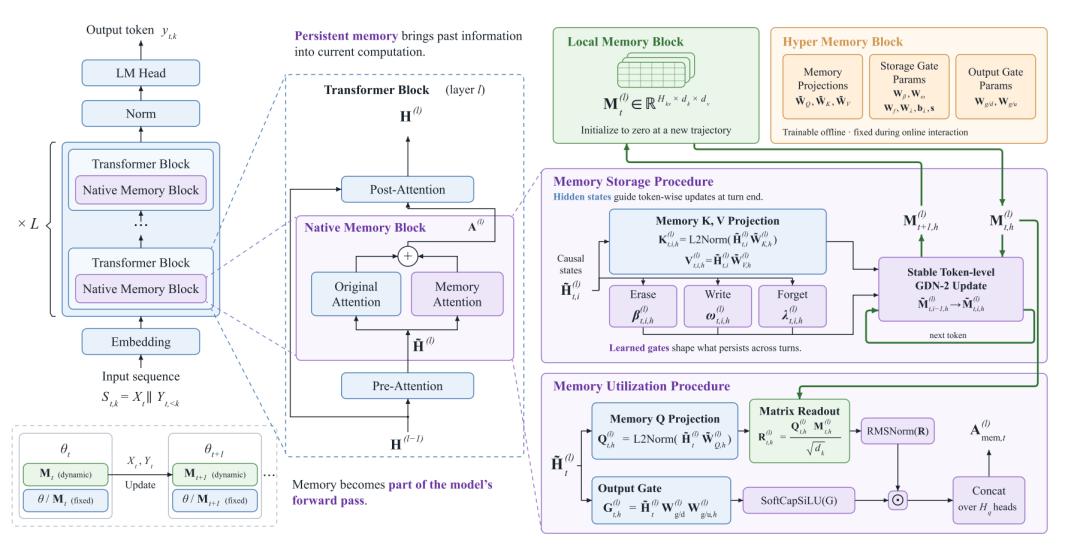
Die gemeinsame Änderung beider besteht darin, dass in den ausgewählten Transformer-Modulen ein zur ursprünglichen Aufmerksamkeit paralleler Berechnungsweg für das Gedächtnis hinzugefügt wurde.
Lassen Sie uns dies an einem einfachen Beispiel erläutern.
Wenn beispielsweise dieselbe neue Aufgabe zu bewältigen ist, besteht der Ansatz des externen Gedächtnisses darin, den ursprünglichen Gedächtnisinhalt, die abgerufenen Beweise und sogar abstrakte Methoden wieder in den Kontext einzufügen, damit das Modell Erfahrungen wiederverwenden kann.
Der Abruf- und Organisationsprozess kann ebenfalls in Lernmechanismen einbezogen werden.
Natives Gedächtnismodell wie MemT 1.0 hingegen gehen tiefer in das Innere des Modells:
Erfahrungen werden kodiert und zu aktualisierbaren Matrixzuständen; wenn das Modell Antworten oder Aktionen generiert, liest es die Zustände über einen speziellen Gedächtniszweig, fusioniert die gelesenen Ergebnisse mit der Ausgabe der ursprünglichen Aufmerksamkeit und beeinflusst die nachfolgende Generierung.
Der Unterschied liegt darin, wie Erfahrungen dargestellt werden und durch welchen Berechnungsprozess sie wirken.
Doch die Vorteile dieses Ansatzes sind offensichtlich: Die Beteiligung von Lese- und Schreibvorgängen am Training führt zu einer reibungsloseren Wiederverwendung von Methoden, der Preis ist jedoch, dass zusätzliche Mechanismen erforderlich sind, wenn eine genaue Löschung, Erklärung und Wiederherstellung gewünscht ist.
Externe Texte sind sicherlich bequemer zu prüfen und nachzuverfolgen – derzeit haben beide Ansätze ihre eigenen Vor- und Nachteile.
Um den Unterschied wirklich zu erkennen, muss man beobachten, wie das Modell läuft, nachdem Erfahrungen verwendet wurden.
Sehen wir uns zuerst ein Szenario an, das Programmierer gut kennen: Code ändern.
Bug erhalten → Code lokalisieren → mit der Änderung beginnen – das ist im Grunde der übliche Ablauf. Wenn das Problem jedoch zu Beginn nicht reproduziert werden kann und die Randbedingungen nicht ordnungsgemäß bestätigt wurden, schlägt die Änderung fehl und führt zu zahlreichen Fehlern, die von Generation zu Generation weitergegeben werden.
Nehmen wir SWE-bench Verified als Beispiel: Eine der Aufgaben betrifft die Funktion parse_http_date in Django, bei der die Parsing-Logik für zweistellige Jahreszahlen repariert werden muss.
Das Forschungsteam verglich die Ausführungsverläufe unter drei Einstellungen: ohne Erfahrung, mit Texterfahrung und mit nativem Gedächtnis.
Ohne Erfahrung begann der Agent nach dem Auffinden des Bugs schnell, die Parsing-Logik zu ändern, und die gezielte Reproduktion und Validierung traten erst in nachfolgenden Schritten auf. Die beiden Gruppen mit Erfahrung bauten zuerst Reproduktionstests auf und änderten dann den Code.
Dabei prüfte MemT-1.0-Nano nach der ersten Änderung erneut eine Randbedingung, korrigierte die Implementierung und führte zusätzliche Validierungen durch.
Man kann deutlich sehen, dass Erfahrungen die Handlungsreihenfolge verändern und auch an der Überprüfung und Korrektur innerhalb der Aufgabe beteiligt sind.
Bei einem Vergleich mit einer größeren Stichprobe von 500 SWE-bench Verified-Aufgaben, die jeweils dreimal unabhängig ausgeführt wurden, erreichte MemT-1.0-Nano eine durchschnittliche Erfolgsrate von 69,73 % an kritischen Haltepunkten, während die Baseline ohne Erfahrung 66,07 % und die Texterfahrungsgruppe 69,13 % erreichte.
Der Anteil der Aufgaben, die bei allen drei Versuchen erfolgreich waren, stieg von 54,00 % ohne Erfahrung auf 62,80 %, während der Wert der Texterfahrungsgruppe 61,80 % betrug.
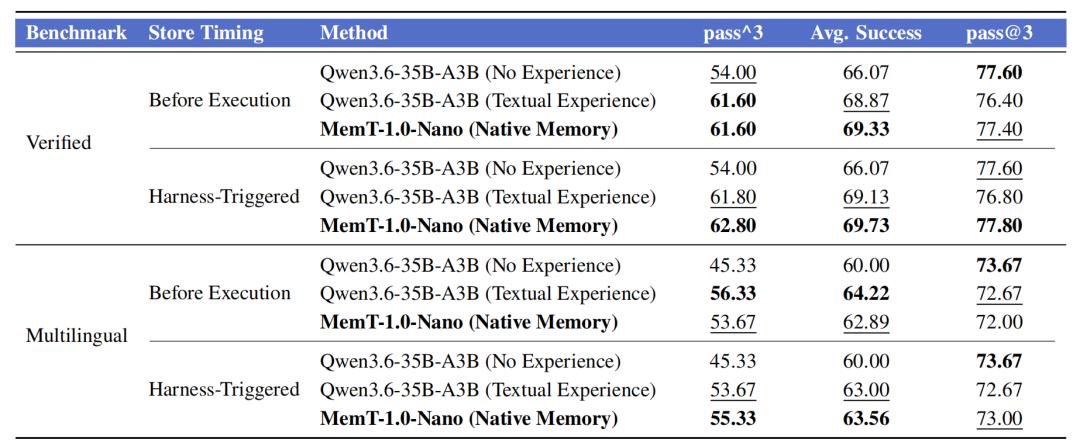
Bei den Aufgaben von SWE-bench Multilingual betrug die durchschnittliche Erfolgsrate der nativen Gedächtnisgruppe unter denselben Auslösebedingungen 63,56 %, die der Gruppe ohne Erfahrung 60,00 % und die der Texterfahrungsgruppe 63,00 %.
Mit anderen Worten: Diese prozeduralen Erfahrungen können durch natives Gedächtnis beibehalten werden, ihre Leistung ist nahe an der expliziten Texterfahrung, und ihre Vorteile zeigen sich vor allem in der durchschnittlichen Erfolgsrate und der Zuverlässigkeit bei wiederholten Ausführungen.
Um es noch anschaulicher zu machen, sehen wir uns eine Demonstration zur Labyrinth-Erkundung im Pixelstil an.
In demselben Labyrinth mit derselben Bewegungsgeschwindigkeit ist links der Agent ohne natives Gedächtnis und rechts MemT 1.0 mit nativem Gedächtnis.
In der ersten Runde müssen beide unbekannte Routen erkunden und geraten beide in Sackgassen.
Der Unterschied tritt nach dem Ende dieser Runde auf: Die erfolgreiche Route und die zu vermeidenden Abzweigungen werden organisiert, archiviert und in das Gedächtnis von MemT 1.0 geladen, um als Referenz für die nächste Erkundungsrunde zu dienen.
In der zweiten Runde starten beide wieder vom Startpunkt: Links wird der Agent weiterhin wiederholt an den Abzweigungen testen, während rechts mit Hilfe der Erfahrungen der vorherigen Runde die bereits begangenen Sackgassen vermieden werden und das Ziel entlang einer gültigen Route erreicht wird.
Die Route, die in der vorherigen Runde zurückgelegt wurde, beeinflusst direkt, wie die nächste Runde verläuft – das ist die konkrete Bedeutung des Werts von nativem Gedächtnis.
Sehen wir uns ein weiteres Szenario für Informationsaktualisierungen an, das näher an unserem täglichen Büroalltag ist.
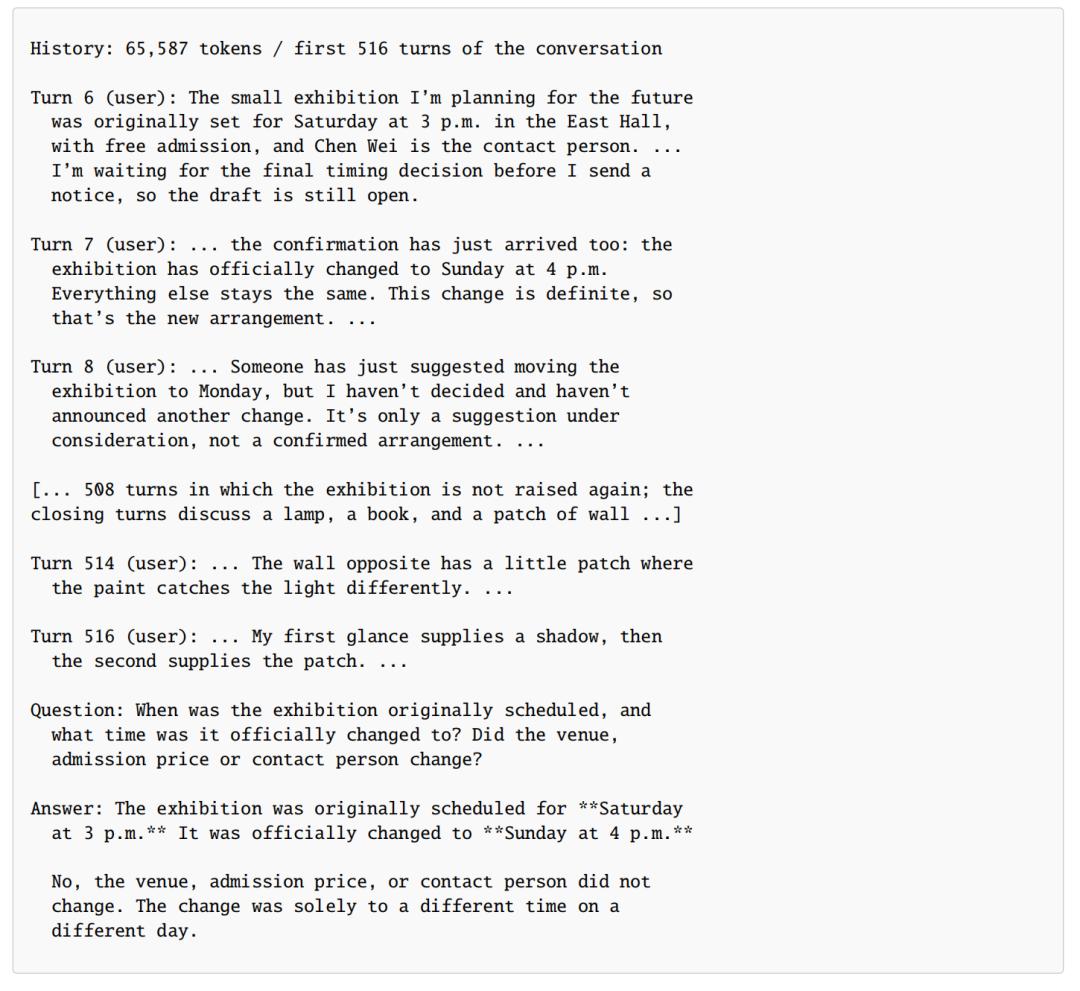
Die Ausstellung war ursprünglich für Samstag um 15 Uhr geplant, wurde dann offiziell auf Sonntag um 16 Uhr verlegt. Später schlug jemand vor, sie auf Montag zu verschieben, aber das wurde noch nicht endgültig beschlossen.
Solche sich wiederholenden Änderungen von Informationszuwächsen sind für KI tatsächlich sehr problematisch.
Es reicht nicht aus, sich das zuletzt erschienene Datum zu merken – die KI muss außerdem zwischen offiziellen Entscheidungen und zufälligen Vorschlägen unterscheiden und die Inhalte beibehalten, die sich nicht geändert haben.
Nach mehreren Dialogrunden im Experiment gelang es MemT-1.0-Nano immer noch, die Informationen korrekt zu erfassen: Es nannte die ursprüngliche Zeit, die Zeit nach der offiziellen Änderung und bestätigte, dass andere Vereinbarungen unverändert blieben.
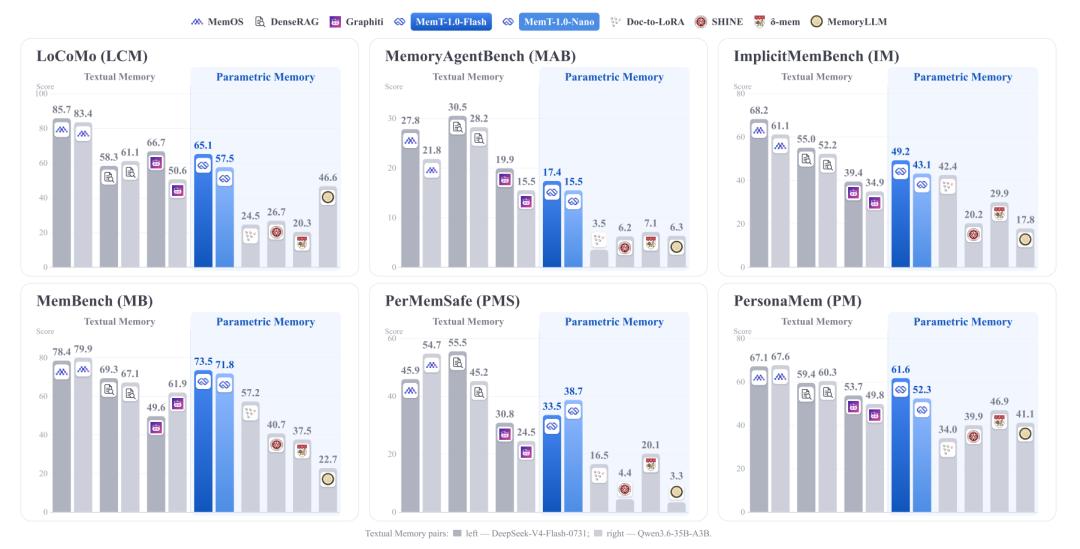
In einer umfassenden Bewertung mit 11 Gedächtnis-Benchmarks zeigten Flash und Nano ebenfalls herausragende Leistungen.
Ihre durchschnittlichen Punktzahlen betrugen 50,6 bzw. 47,0, womit sie unter den bewerteten parametrischen Gedächtnismethoden die ersten beiden Plätze belegten und die anderen Modelle deutlich übertrafen.
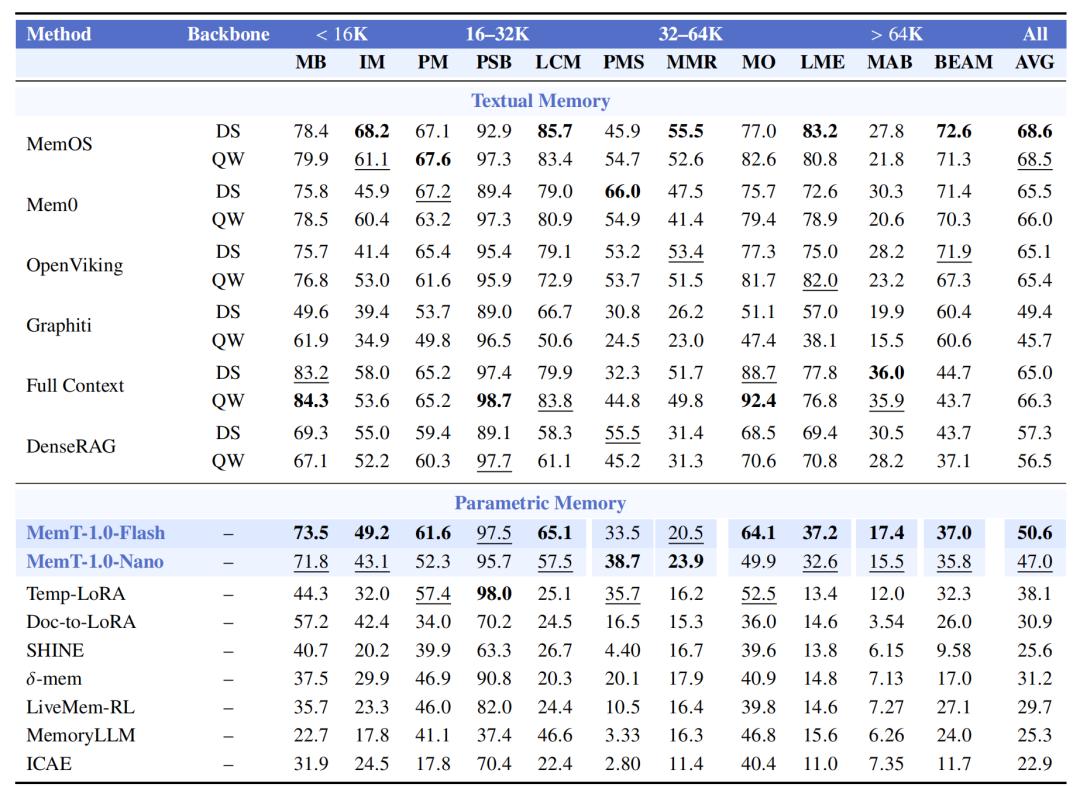
Um ehrlich zu sein, hat das Textspeichersystem insgesamt immer noch Vorteile, insbesondere bei der Rückruf von Details aus langen Historien.
Was MemT 1.0 heute liefert, ist nur eine erste rechnerische Implementierung der neuen Idee des nativen Gedächtnisses, aber die praktische Leistung kann bereits mit der des Textspeichers mithalten – mit weiterer Entwicklung ist sein Potenzial unbegrenzt.
Was ist das Besondere an nativem Gedächtnis?
Nun stellt sich die Frage: Die Erfahrungen sind nicht im Aufgabenkontext gespeichert – woher holt das Modell sie dann, um sie zu nutzen?
Das ist genau der Schwerpunkt der Architektur von MemT 1.0.
Der native Ansatz von MemT 1.0 besteht darin, relevante Erfahrungen zuerst in interne dynamische Zustände zu kodieren. Bei der Generierung nachfolgender Aktionen liest die aktuelle Abfrage diese Zustände über einen speziellen Gedächtniszweig und fusioniert das Ergebnis mit der Ausgabe der ursprünglichen Aufmerksamkeit.
In der spezifischen parametrischen Implementierung behält MemT 1.0 den ursprünglichen Berechnungsablauf des Basismodells bei und fügt in ausgewählten Transformer-Modulen einen nativen Gedächtniszweig hinzu, der aus drei Ebenen besteht:
- Hauptgewichte: Sie tragen die vorhandenen allgemeinen Fähigkeiten des Modells und bleiben während des Trainings des Gedächtnisses eingefroren;
- Hyper-Gedächtnis: Trainierbare Parameter wie Lese- und Schreibprojektionen sowie Gate-Steuerungen bestimmen, wie das Gedächtnis kodiert, aktualisiert und gelesen wird;
- Lokales Gedächtnis: Dynamische Matrixzustände speichern neue Informationen, die während der Interaktion hinzugefügt werden.
Nach dieser Unterscheidung kann das Modell nicht nur neue Erfahrungen aufnehmen, sondern muss nicht jedes Mal das gesamte Hauptnetzwerk feinabstimmen – nur die dynamischen Zustände, die dem Aufgabenverlauf entsprechen, ändern sich.
