Wette auf Memory-Native: MemT 1.0 durchbricht die zweite Hälfte der entwicklungsorientierten KI
Die frustrierendsten Momente bei der Nutzung von KI sind zweifellos die, wenn Sie einen halben Tag damit verbringen, sie zu korrigieren, damit sie die Aufgabe richtig erledigt, und wenn Sie eine neue Sitzung starten, fällt sie sofort wieder in dieselbe Falle. Das Modell hat die Aufgabe erledigt, aber es ist nicht zu seinem Wachstum geworden. Über die einmalige erfolgreiche Ausführung einer Aufgabe hinaus fehlt es ihm wirklich daran, Feedback in Erfahrung umzuwandeln und es später aktiv abzurufen.
Diese Trennung ist besonders offensichtlich im Hype um persönliche Assistenten, der von Meta Muse, OpenAI Dots und xAI Grok Bot ausgelöst wird: Die gängige externe Abruf-Funktion zählt höchstens zum Nachschlagen statischer Notizen und kann den Trainingsprozess nicht zu einer geübten Übereinkunft verankern – genau das ist aber die zentrale Hürde für einen langfristig nutzbaren Assistenten.
Heute veröffentlicht Memory Tensor offiziell das speicher-native Large Language Model MemT 1.0 und stellt es als Open Source zur Verfügung.
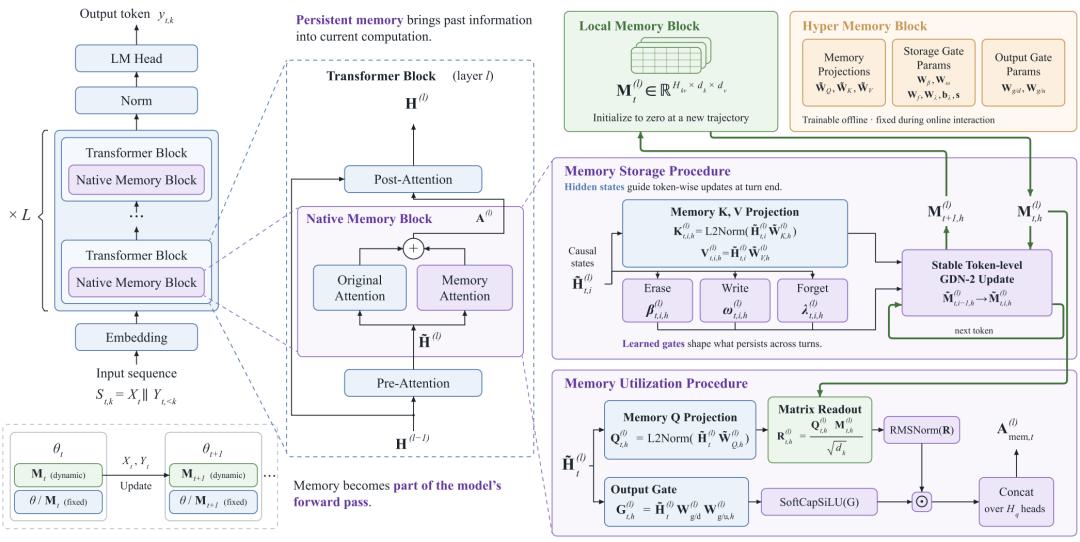
Der größte Unterschied zu externen Lösungen besteht nicht nur darin, dass der Speicher aus externen Modulen herausgelöst und in die untere Architektur integriert wird, sondern vor allem darin, dass das Modell durch Training selbst lernt, wie es Speicherinhalte lesen, schreiben, aktualisieren und abrufen kann, sodass die Erfahrungssammlung selbst zu einem Teil der Fähigkeiten des Modells wird.
Den Speicher tief in das Wesen des Modells einprägen
Die meisten Lösungen auf dem Markt betrachten das Speichern von Chat-Protokollen als Speicherfunktion, aber das Speichern von bloßen Verlaufsprotokollen reicht nicht aus, um mit der dynamischen Interaktion in der realen Welt umzugehen – es ist noch weit von einem echten Assistenten entfernt.
Im technischen Bericht von MemT 1.0 wird ein anspruchsvoller Test beschrieben: Zuerst gibt der Nutzer den ursprünglichen Zeitraum einer Ausstellung an, legt dann fest, dass die Ausstellung offiziell auf Sonntag verschoben wird, und erwähnt nebenbei eine nicht angenommene Alternative für Montag. Danach unterhalten sich die beiden über mehr als 500 Runden über verschiedene Themen und sammeln Chat-Protokolle mit etwa 66.000 Token, ohne dass das Thema Ausstellung noch einmal erwähnt wird.
Bei herkömmlichen externen Abrufverfahren würde man bei so weit auseinanderliegenden Informationen mehrerer Versionen sehr leicht die zufälligen Unterhaltungen als endgültige Festlegung betrachten. MemT 1.0 gibt aber im „geschlossenen Buch“-Zustand, in dem es vollständig vom Originaltext getrennt ist, trotzdem genau den ursprünglichen und den verschobenen Zeitpunkt an, weist ausdrücklich darauf hin, dass Veranstaltungsort, Ticketpreis und Kontaktperson unverändert sind, und unterscheidet klar zwischen der endgültigen Festlegung für Sonntag und der Alternative für Montag.
Der Grund dafür liegt darin, dass MemT 1.0 den technischen Ansatz des „speicher-nativen“ Modells verfolgt.
Abbildung |🔗 Code:https://github.com/MemTensor/MemT-1.0Model:https://huggingface.co/collections/MemTensor/memt-1
Bei der Architekturgestaltung teilt MemT 1.0 die Rechenleistung des Modells in zwei Teile auf:
Hauptnetzwerk (allgemeine Fähigkeiten): Es entspricht den Werkseinstellungen der KI und enthält ihr allgemeines Wissen über die Welt.
Dynamischer Speicherzustand (unabhängiger Speicher): Er entspricht dem „exklusiven Arbeitszustand“, der sich im Verlauf der spezifischen Interaktion des Modells in Echtzeit weiterentwickelt. Er ist zwischen verschiedenen Nutzern oder Aufgaben unabhängig voneinander, absorbiert dynamisch neue Informationen und Erfahrungen bei fortlaufender Interaktion und nimmt direkt an jeder nachfolgenden Generierungsberechnung teil.
Bei ständig eintreffenden Interaktionsinformationen muss MemT-1.0 nicht das gesamte Large Language Modell neu trainieren. Stattdessen aktualisiert es den Speicherzustand direkt am Ende jeder Dialogrunde über einen token-genauen Aktualisierungsmechanismus. Welche Inhalte behalten und welche geändert werden sollen, entscheidet das Modell selbst über einen im Training erlernten Gate-Mechanismus.
Das erklärt, warum das Modell in dem oben genannten Test mit mehr als 500 Runden automatisch das Rauschen aus den zufälligen Unterhaltungen herausfiltern, veraltete Zustände bei Terminänderungen überschreiben und die endgültige Festlegung für Sonnung festlegen kann. Bei nachfolgenden Dialogen und Aufgabenausführungen extrahiert der parallele Speicher-Aufmerksamkeitsmechanismus diese verankerten Zustände jederzeit, nimmt direkt an der aktuellen Berechnung teil und leitet die nächsten Entscheidungen des Modells.
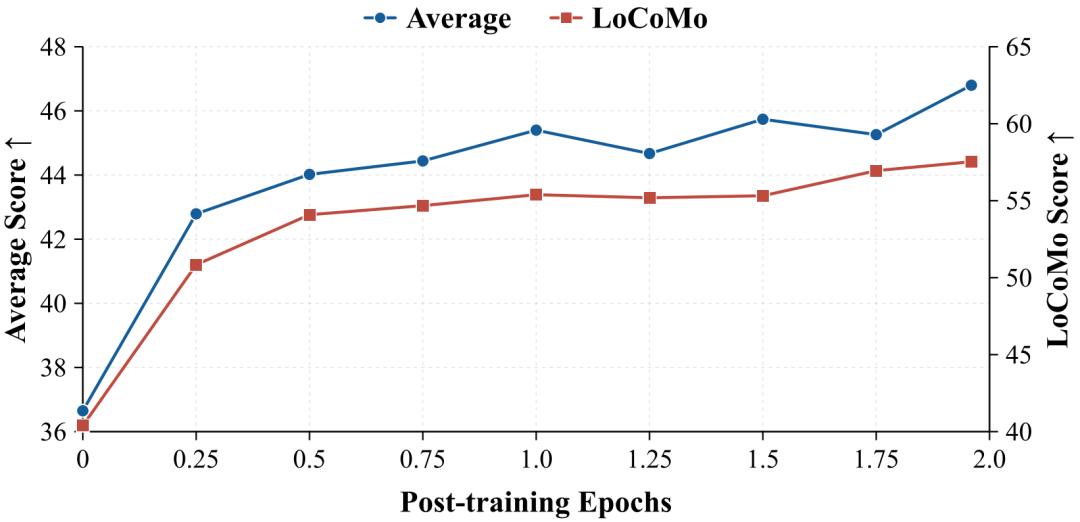
Natürlich ist diese präzise Fähigkeit zur Auswahl nicht von Natur aus vorhanden, sondern wird ausschließlich durch intensives Training erworben.
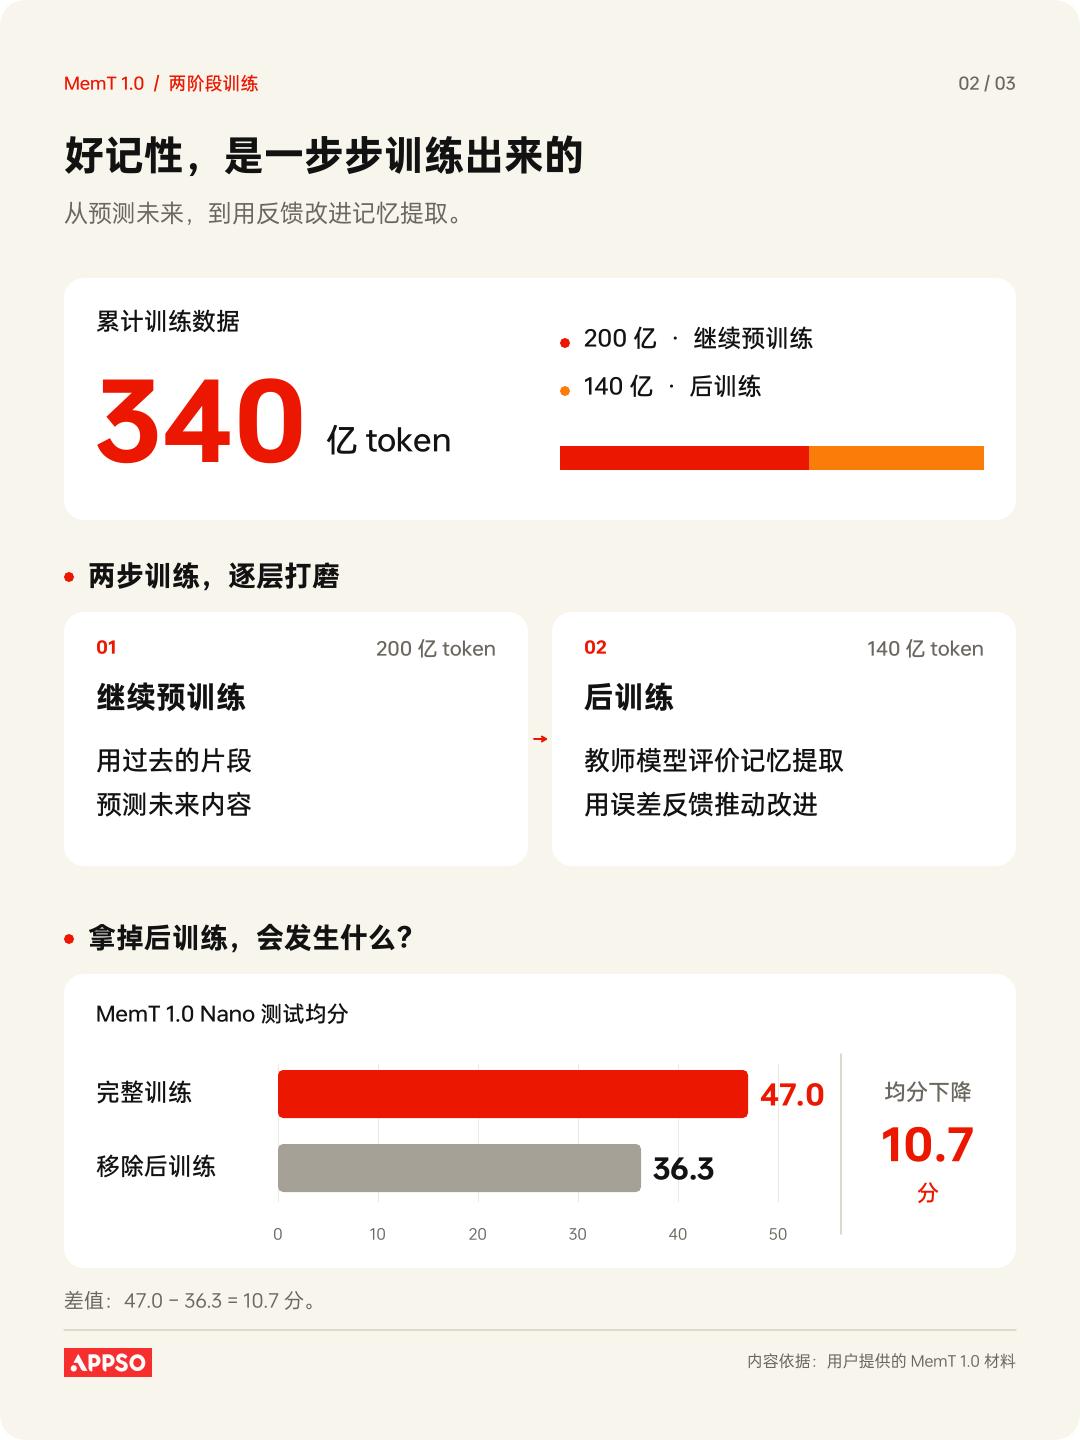
Das Team hat 34 Milliarden Token an Daten verarbeitet und diesen Mechanismus in zwei Schritten verfeinert: Zuerst wurde mit 20 Milliarden Token ein fortgesetztes Vortraining durchgeführt, damit das Modell versucht, die Zukunft anhand vergangener Fragmente vorherzusagen. Danach wurde mit 14 Milliarden Token ein Nachtraining durchgeführt, bei dem ein „hochbegabtes“ Lehrermodell die Speicherabrufe bewertet und das Modell durch Fehler dazu anregt, sich zu verbessern.
Neben der Auswahl muss der Speicher auch genug Inhalte aufnehmen können. Der Speicherzustand von MemT hat ein festes Volumen, und bei fortlaufender Interaktion wird nur die vorhandene Matrix aktualisiert. Um in diesem festen Volumen mehr Details unterzubringen, hat das Team die Mixture-of-Storage (MoS)-Architektur eingeführt: Das Basis-MoE-Modell übernimmt die Berechnungen, während MoS mehrere „Speicherexperten“ dazu bringt, die Lese- und Schreibzuweisung des Speicherplatzes getrennt zu verwalten.
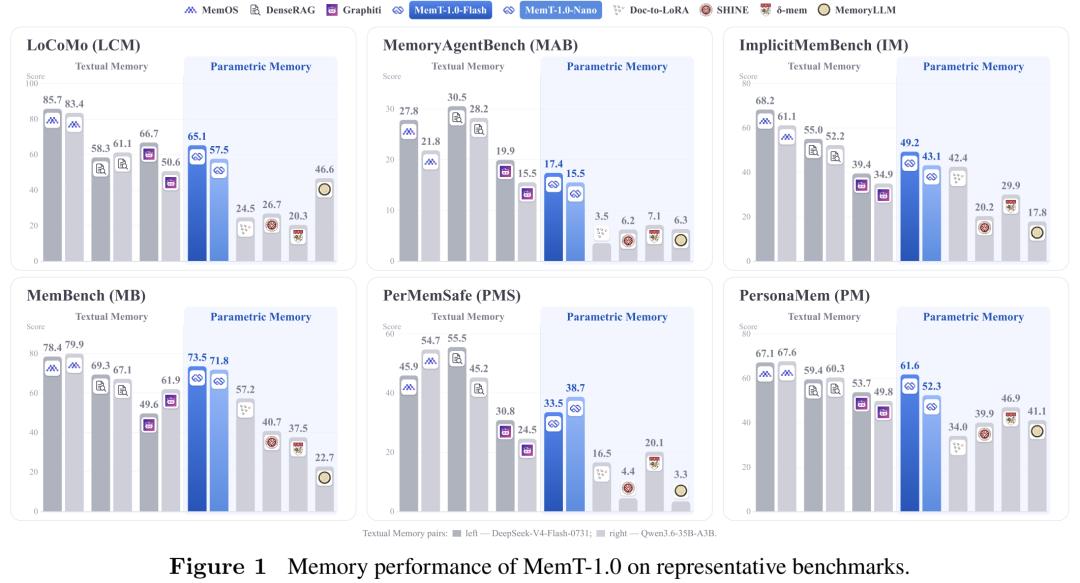
Diese Kombination aus Architektur und Training hat bei 11 systemweiten Speicher-Benchmark-Tests (die Dimensionen wie langfristige Aufbewahrung, dynamische Aktualisierung und personalisiertes Verständnis abdecken, mit einem historischen Umfang von 16K bis zu Millionen von Token) ein beeindruckendes Ergebnis erzielt:
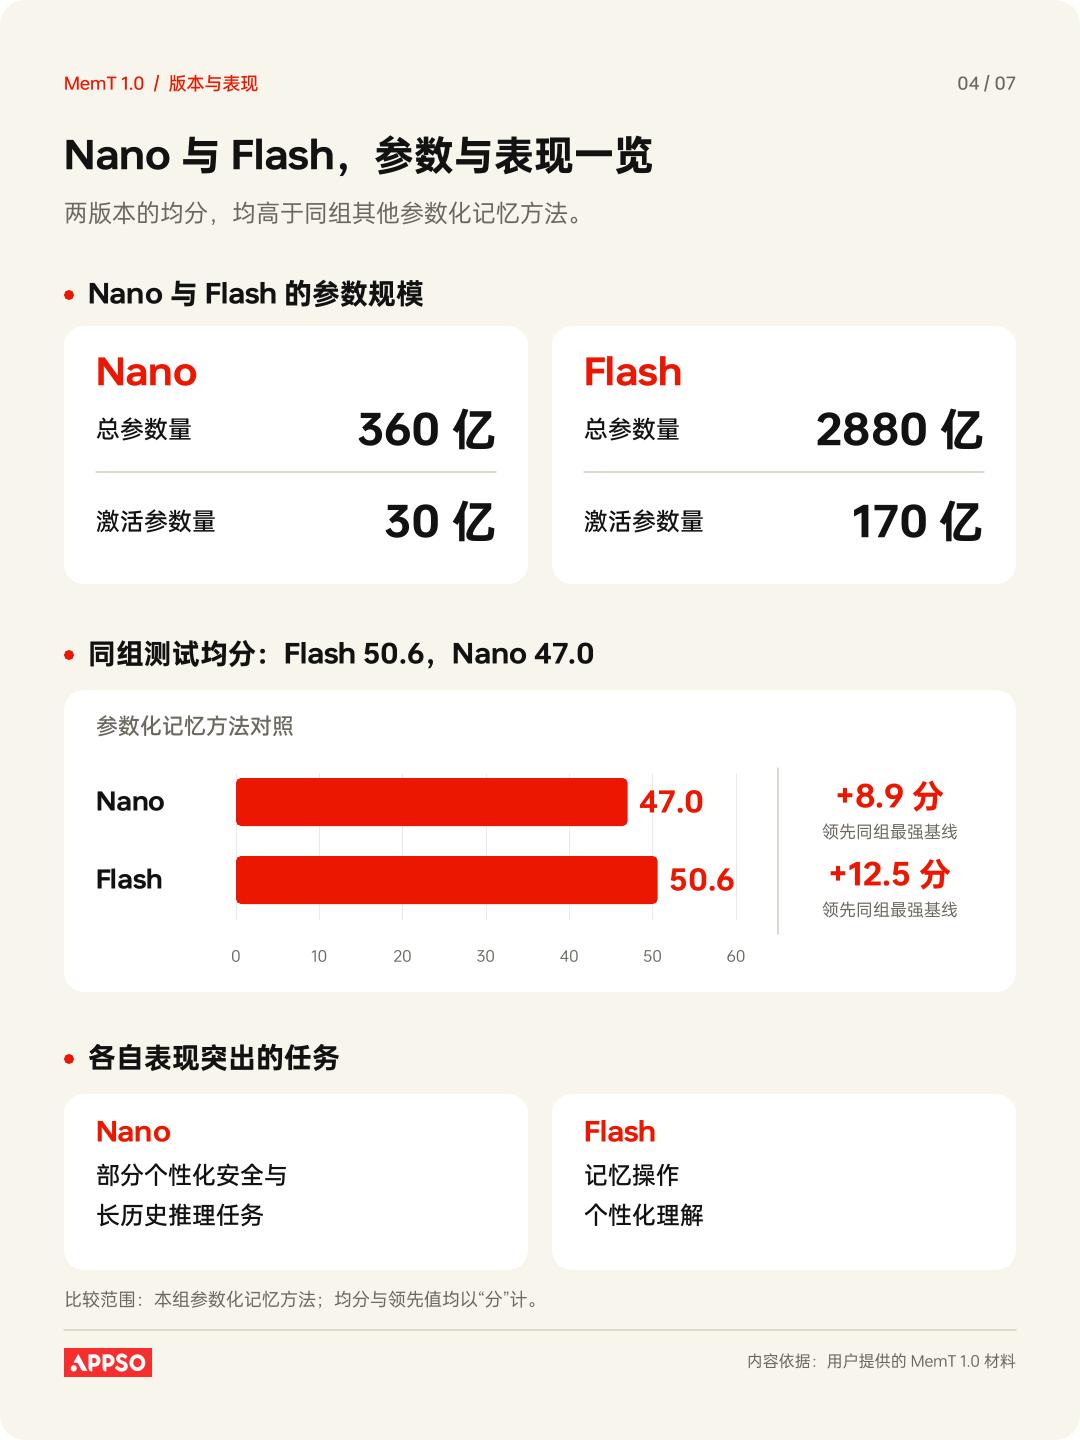
Die Durchschnittswerte von MemT-1.0-Flash und MemT-1.0-Nano, die den gesamten Test im Zustand des geschlossenen Buches absolviert haben, erreichen 50,6 bzw. 47,0 Punkte. Sie liegen damit um 12,5 Punkte bzw. 8,9 Punkte vor der stärksten parametrischen Speicher-Baseline der gleichen Gruppe.
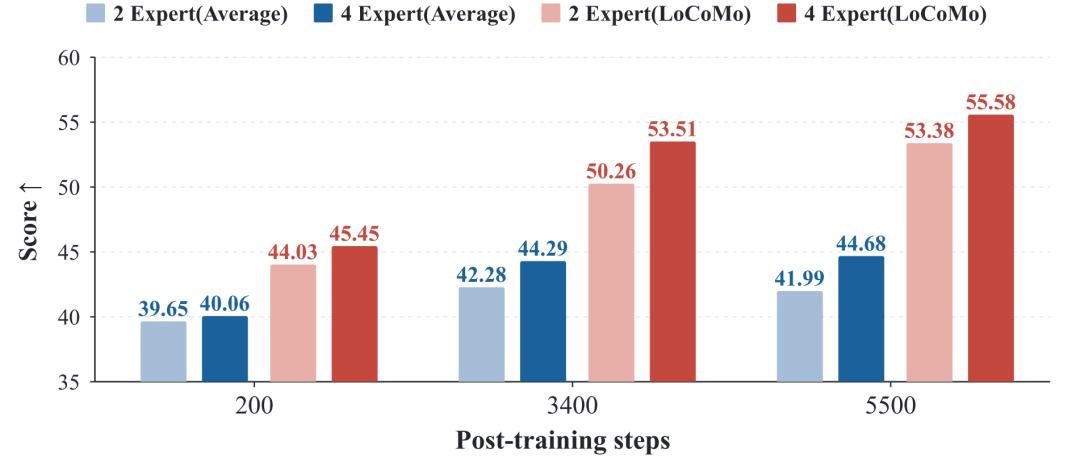
Ablationsstudien bestätigen ebenfalls direkt den Wert von Training und Architektur. Wenn der Schritt des Nachtrainings weggelassen wird, sinkt der Durchschnittswert von Nano direkt von 47,0 auf 36,3 Punkte. Wenn die Anzahl der MoS-Speicherexperten von 2 auf 4 erhöht wird, steigt der durchschnittliche Testergebnis um bis zu 2,7 Punkte.
Neben den Benchmark-Ergebnissen verdeutlichen zwei kleine Details im Test anschaulicher, was einen qualitativ hochwertigen Speicher ausmacht.
In einem Verlauf von etwa 16.000 Token fragt der Nutzer nach seinem Geburtstag. Da er nie zuvor diese Information angegeben hat, antwortet das Modell ehrlich, dass es das nicht weiß, und erfindet keine falschen Angaben. In einem Dialog mit 33.000 Token muss das Modell anhand einer vor langer Zeit festgelegten Regel beurteilen, wer von zwei Personen berechtigt ist, einen Werkzeugsatz zu erhalten. Es prüft genau die Abzeichen und den Registrierungsstatus und stellt fest, dass eine Person qualifiziert ist und die andere nicht registriert ist.
Wissen, was man weiß, Regeln merken und keine Details verpassen – das ist die Mindestanforderung für einen nutzbaren KI-Assistenten.
Kontinuierliche Selbstverbesserung beginnt mit einem geschlossenen Erfahrungskreislauf
Wenn man die Anforderungen noch höher legt: Können die Lehren aus vergangenen Fehlern tatsächlich die Arbeitsweise des Modells bei neuen nachfolgenden Aufgaben verändern?
Um den geschlossenen Kreislauf der kontinuierlichen Selbstverbesserung zu realisieren – bei dem Aufgaben Feedback erzeugen, daraus Erfahrungen extrahiert und verankert werden, um nachfolgende Aufgaben zu verbessern – hat das Technikteam eine vollständige Trainings- und Ausführungsleitung in einer echten Programmierumgebung aufgebaut.
Im ersten Schritt wird dem Modell beigebracht, wie es die Erfahrungen anderer „aufnehmen“ kann.
Das Technikteam extrahiert zuerst Tausende von wiederverwendbaren Erfahrungen aus zehntausenden erfolgreichen Verläufen. Dann lässt es das Basismodell Aufgaben ausführen. Sobald es auf „Blockierungspunkte“ wie Befehlsfehler, leere Rückgaben oder wiederholte nutzlose Aktionen stößt, wird die passende Erfahrung an der Blockierungsstelle eingefügt, und das Modell führt die Aufgabe erneut aus.
Das Team filtert streng mehr als 42.000 Proben heraus, bei denen „die Aufgabe ohne Erfahrung falsch ausgeführt wurde und nach dem Hinzufügen der Erfahrung erfolgreich abgeschlossen werden konnte“, um das speicher-native Modul von MemT-1.0 Nano speziell zu trainieren: Zuerst wird die Erfahrung in den internen Speicherzustand geschrieben, und erst nachdem der Blockierungspunkt überwunden ist, wird das Lesen aktiviert, sodass das Modell lernt, die Erfahrungen im Speicher abzurufen, um nachfolgende Aktionen zu korrigieren.
Bei der praktischen Prüfung von 500 Aufgaben in SWE-bench Verified steigt die durchschnittliche Erfolgsrate von MemT-1.0 Nano mit vorab geschriebenen Erfahrungen von 66,07 % ohne Erfahrung auf 69,33 %. Der Anteil der Aufgaben, die bei drei unabhängigen Durchläufen alle erfolgreich abgeschlossen werden, steigt von 54,00 % auf 61,60 %. Das Ergebnis ist vergleichbar mit der Kontrollgruppe, bei der „Texterfahrungen“ direkt im Kontext eingefügt werden (Erfolgsrate 68,87 %, Erfolgsrate bei drei Durchläufen 61,60 %).
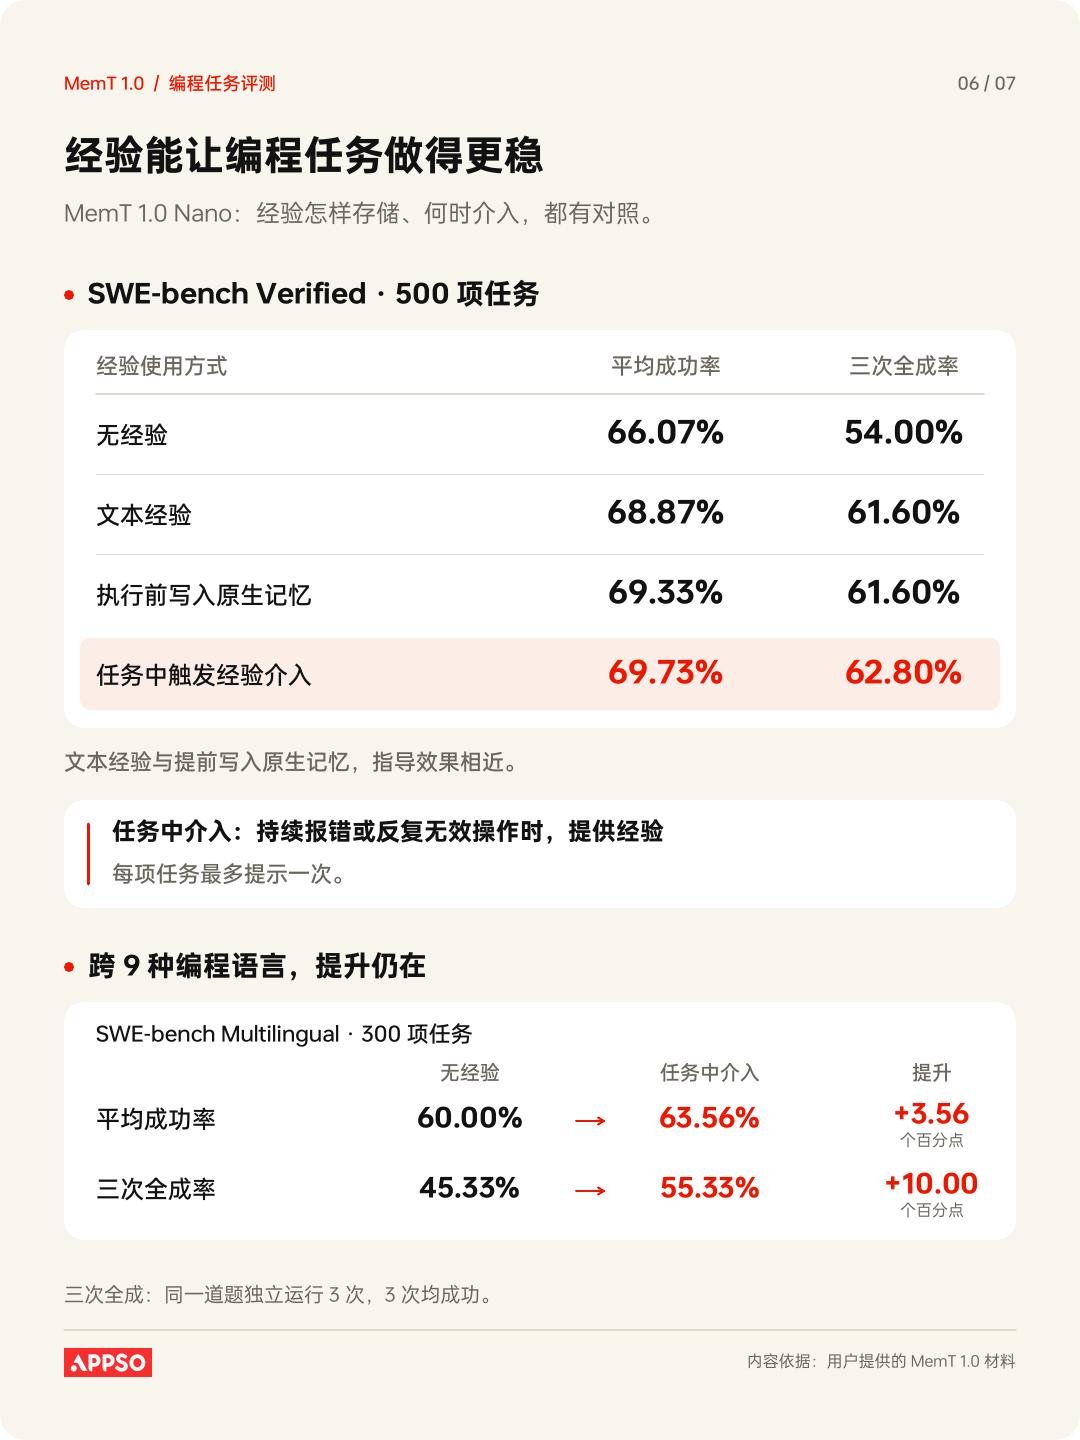
Das zeigt: Selbst wenn das Dialogfeld leer ist, kann das Modell allein über den Speicherzustand in seinem Inneren komplexe Fehlerbehebungsanleitungen vollständig verarbeiten.
Im zweiten Schritt lernt das Modell im praktischen Einsatz durch Handeln und hebt sich deutlich von anderen Lösungen ab.
Vorab eingefügte Erfahrungen sind letztendlich statisch – bei der tatsächlichen Arbeit kann man nicht alles vorhersehen. Im Praxismodus bearbeitet das Modell die Aufgaben zuerst völlig unabhängig ohne vorherige Erfahrungen. Nur wenn das System feststellt, dass es Fehler ausgibt, leere Rückgaben liefert oder dreimal nacheinander an der gleichen Stelle stecken bleibt, wird die passende Fehlerbehebungs-Erfahrung sofort in seinen internen Speicherzustand geschrieben.
Das ist vergleichbar mit einem Programmierer, der zuerst selbst Code schreibt. Wenn er gegen eine Wand läuft, fällt ihm plötzlich die Lehre aus vergangenen Fehlern ein, er ändert sofort seinen Ansatz und behebt den Bug. Wenn diese Arbeit erledigt ist, wird der Prozess des Fehlers und der Fehlerbehebung selbst zu einer neuen Erfahrung verarbeitet und gespeichert, um in Zukunft Probleme zu lösen.
Die Ergebnisse zeigen, dass diese Methode, bei der der Speicherzustand in Echtzeit anhand von Feedback aktualisiert wird, die durchschnittliche Erfolgsrate auf 69,73 % steigert und die Erfolgsrate bei drei Durchläufen auf 62,80 % anhebt. Beide Werte übertreffen die