Aus der Yao-Klasse der Tsinghua-Universität und als Spitzenabsolventen der Harvard-Universität haben sie es erreicht, dass Roboter selbst Codes schreiben und Fähigkeiten trainieren. Endlich müssen sie nicht mehr von Menschen händisch Schritt für Schritt angeleitet werden.
Robot Vorausschau berichtete am 19. Oktober: Kürzlich haben Forschungsteams der Harvard-Universität, der Nvidia, der University of California, Berkeley, des Massachusetts Institute of Technology und der Stanford University das Open-Source-Framework RAX (Robot Agent eXploration, Erkundung von Roboteragenten) vorgestellt.
Der Kerngedanke von RAX besteht darin, den Umfang der autonomen Erkundung von Robotern zu erweitern. Der Agent sammelt online Erfahrungen, wandelt gültige Erfahrungen in ausführbare Programme um und verbessert kontinuierlich seine eigenen Fähigkeiten.
Einfach ausgedrückt ermöglicht RAX einem universellen Agenten, der Code schreiben kann, in einer realen oder simulierten Umgebung "gleichzeitig zu arbeiten und zu testen", und die wirksamen Praktiken der Versuche in Programme zu schreiben, die wiederholt ausgeführt werden können.
▲《Scaling Online Exploration for Robot Agents》
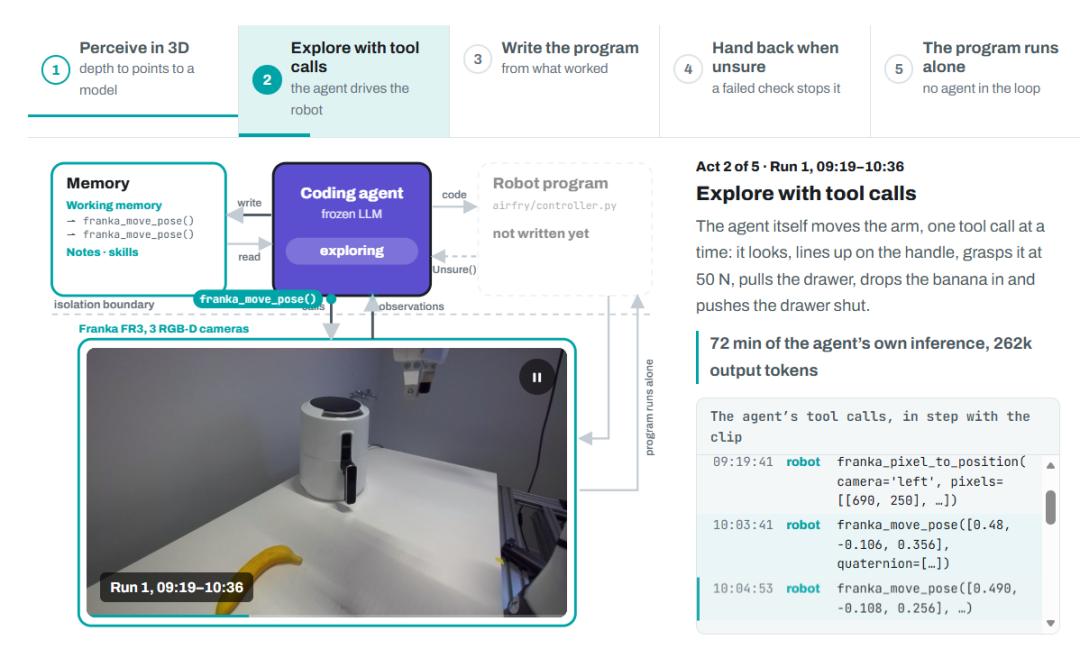
Zum Beispiel, wenn der Roboter die Aufgabe ausführt, eine Heißluftfritteuse zu öffnen, muss der Agent zunächst gleichzeitig die Tiefenkamera betrachten, Analyseskripte schreiben und Aktionen ausprobieren. Er verbrachte 44 Minuten und schrieb 23 Analyseskripte, um das erste Greifen abzuschließen.
Sobald die wirksame Entscheidungssequenz "wie man den Griff positioniert, wie man greift, wie man die Schublade schrittweise öffnet, wie man die Banane hineinlegt und wie man sie schließt" herausgefunden ist, kann der Agent diesen Ablauf in ein modulares Programm kompilieren, wonach der Roboter ihn schnell und automatisch ausführen kann.
Auf der Grundlage von RAX untersuchte das Team, wie der Umfang der Online-Erkundung erweitert werden kann und wie sich diese Methode bei verschiedenen Roboterplattformen und Aufgaben verhält.
Die experimentellen Ergebnisse zeigen, dass mit der Erweiterung des Erkundungsumfangs die Generalisierungsfähigkeit des Roboters in unbekannten Umgebungen kontinuierlich verbessert wird. In Simulationsexperimenten liegt die durchschnittliche Leistung von RAX um 37,4 % über dem besten Basismodell.
Es wurde bekannt, dass der Mit-Erstautor der Arbeit, Runhan Huang, seinen Bachelor-Abschluss am Yao-Klassenprogramm der Tsinghua-Universität absolvierte, im Juni dieses Jahres den Bachelor of Engineering in Informatik erwarb und im August desselben Jahres an der Harvard-Universität sein Doktoratsstudium in Informatik aufnahm. Seine Forschung konzentriert sich hauptsächlich auf Robotik, Generierungsmodelle und Agenten.
Der andere Mit-Erstautor Xiangcheng Zhang absolviert ebenfalls ein Doktoratsstudium in Informatik an der Harvard-Universität.
01.
Agenten schreiben Programme direkt,
damit Roboter lernen, Heißluftfritteusen autonom zu bedienen
Die VLA-Modelle und WAM-Modelle führen die Feinabstimmung der vortrainierten VLM- und Videogenerierungsmodelle unter Verwendung großer Mengen von Fernbedienungsdaten durch. Die Bereitstellung des Systems auf einem neuen Roboter oder die Ausführung neuer Aufgaben erfordert jedoch normalerweise immer noch die spezielle Erfassung von Fernbedienungsdaten.
Diese Art von Strategie ist im Wesentlichen durch die nachgeahmten Demonstrationsdaten beschränkt. Selbst wenn der Roboter interagieren kann und bei Tests zusätzliche Rechenleistung zur Verfügung steht, ist es schwierig, Generalisierung und Selbstverbesserung zu erreichen.
Diese Einschränkung führt zu einer Kernfrage: Können Roboter durch autonome Online-Erfahrungen und aktive Erkundung Selbstverbesserung erreichen und lernen, neue Fähigkeiten zu entdecken?
Das Forschungsteam hat eine neue Idee vorgeschlagen: Lassen Sie den Agenten direkt Programme für den Roboter schreiben, sodass für den gesamten Prozess keine künstlich entworfenen Aktionsprimitive erforderlich sind.
Das hier vorgestellte RAX ist eine kognitive Architektur für Roboteragenten. In RAX erhält der universelle Codierungsagent natürliche Sprachbefehle, höchstens einige Zielbilder oder visuelle Demonstrationen sowie ein Budget für Erkundungsrunden.
Anschließend interagiert der Agent direkt mit dem Roboter über die Wahrnehmungs- und Schnittstellen zur Steuerung des Roboters. Für den gesamten Prozess ist keine künstliche Fernbedienung erforderlich, und er hängt nicht von der Anleitung durch eine Wertfunktion ab.
Die Parameter des zugrunde liegenden Sprachmodells bleiben stets festgelegt, und das System führt keine Strategietraining durch. Gleichzeitig realisiert das System das Lernen durch kontinuierliche Aktualisierung eines langfristig speicherbaren Arbeitsbereichs. Dieser Arbeitsbereich enthält Programme, Notizen und überprüfte Fähigkeiten.
Der Agent wandelt den erfolgreichen Interaktionsprozess in ein autonom ausführbares Codeprogramm um und speichert Wissen, das für nachfolgende Experimente und Aufgaben wiederverwendet werden kann.
Mit der Erweiterung des Erkundungsumfangs hat das Forschungsteam auch beobachtet, dass das System allmählich verschiedene Fähigkeiten zeigt.
1. Multimodale Wahrnehmung
Um ein Modell zu erstellen, das der realen physischen Welt entspricht, stellt das Team dem Agenten multimodale Sensoreingaben zur Verfügung, einschließlich RGB-Bilder, Tiefenkarten, Kameraparameter und Kraftsignale.
Mithilfe dieser Informationen kann der Agent Tiefendaten verwenden, um ein dreidimensionales Weltmodell zu erstellen und den Kontaktvorgang durch Kraftrückmeldung zu steuern.
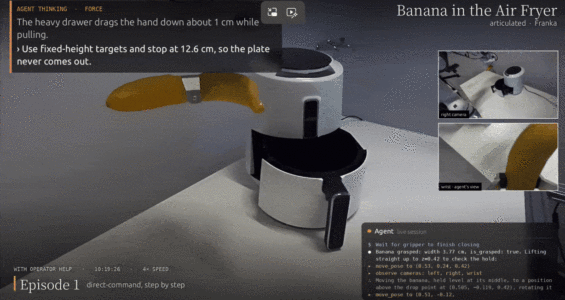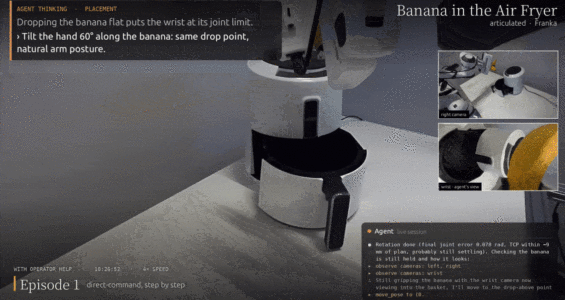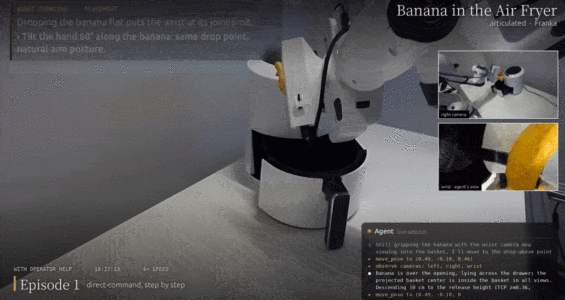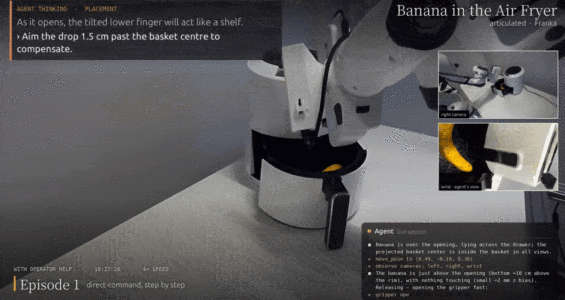
Bei der Aufgabe, bei der der Roboter die Heißluftfritteuse öffnet, öffnet der Agent die Schublade der Heißluftfritteuse, legt eine Banane in den Frittierkorb und schließt dann die Schublade.
Zuerst wandelt der Agent die von der RGB-D-Kamera erfassten Beobachtungsdaten in Punktwolken um und vereinheitlicht sie im Koordinatensystem der Roboterbasis. Anschließend erstellt er mithilfe seiner selbst gemessenen Daten das geometrische Modell der Heißluftfritteuse.
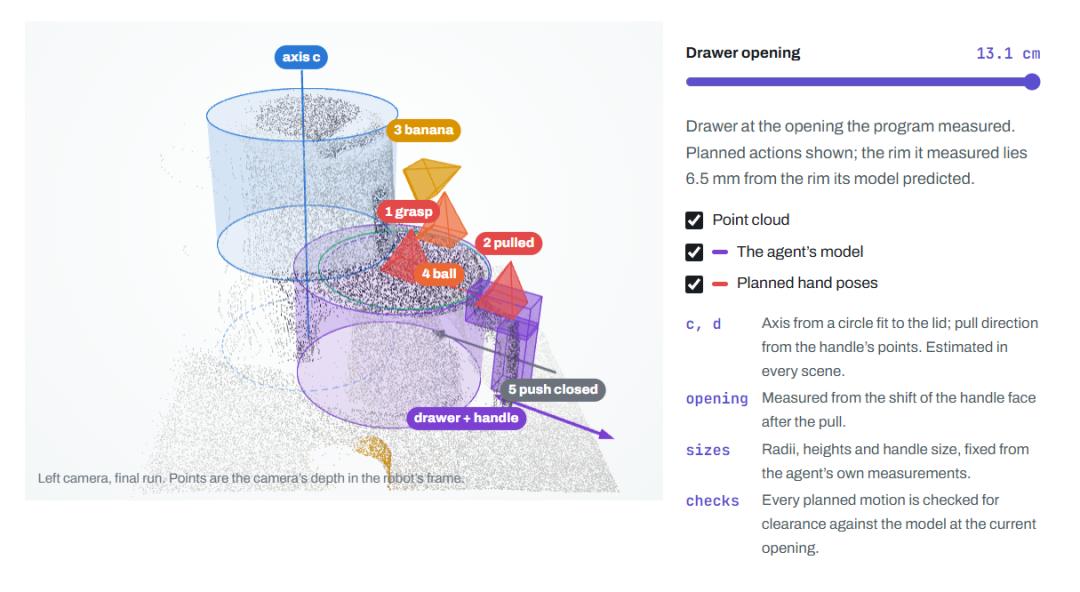
Bei einer neuen Szenenlayout verwendet der Agent eine robuste Schätzmethode, um die Achse und die Griffrichtung der Heißluftfritteuse anzupassen und so ihre Position und Haltung zu bestimmen.
Da die Schublade beweglich ist, muss das Modell die Gelenkstruktur des Objekts darstellen. Dieses Modell besteht aus einem festen Gehäuse und einer Schublade.
Auf der Grundlage dieses Modells plant der Agent jede Aktion, einschließlich Greifen, Ziehen und Loslassen, und prüft, ob jede Bewegungsbahn kollidiert.
2. Planung und Steuerung
Nachdem ein genaues Weltmodell erstellt wurde, kann der Agent direkt die Roboteraktionen im dreidimensionalen Raum planen und das Robotersteuerungs-Software Development Kit (SDK) und den Kinematiklöser verwenden, um die Planung auszuführen.
Um den Agenten mit dem physischen Roboter zu verbinden, kapselte das Team das Steuerungs-SDK des Roboters als Modell Context Protocol (MCP)-Tool und stellte gleichzeitig Hilfstools wie den Inverskinematik (IK)-Löser und das Roboter-URDF-Modell zur Verfügung.
Mithilfe dieser Tools kann der Agent jede Aktion planen und nach einer durchführbaren Bewegungsbahn suchen. Während des Planungsprozesses berücksichtigt er die Haltung des Roboters, das Kollisionsrisiko und die Gelenkbegrenzungen.
Am Beispiel der Aufgabe mit der Heißluftfritteuse: An der Oberseite des Schubladengriffs befindet sich ein kurzer horizontaler Stab, dessen Ende nach unten in einen greifbaren Teil übergeht.
Wenn der Agent den Griff von vorne greift, wie es ein Mensch tun würde, hat das Gelenk nahe der Wurzel des horizontalen Stabs kaum genug Bewegungsspielraum, wenn er die Schublade zieht.
Daher wählt der Agent, wie in den Aktionen 1 und 2 in der Abbildung gezeigt, den kurzen horizontalen Stab von oben zu greifen und die Schublade schrittweise in Schritten von je 3 cm zu öffnen.
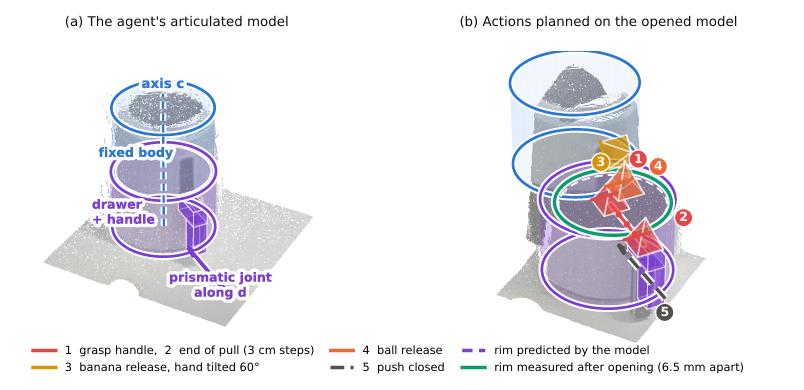
Als Nächstes folgt der Vorgang, die Banane hineinzulegen. Die Banane ist 18 cm lang, während der Frittierkorb 19 cm lang ist, sodass fast kein zusätzlicher Platz vorhanden ist.
Wenn die Banane horizontal gehalten und direkt aus der Hand losgelassen wird, stößt sie gegen die Oberseite der Heißluftfritteuse. Gleichzeitig können die geöffneten Finger auch gegen das Gehäuse stoßen.
Wie in Aktion 3 in der Abbildung gezeigt, um dieses Problem zu lösen, neigt der Agent die Hand um 60° um die Achse der Banane, sodass die konkave Seite der Banane zur Heißluftfritteuse zeigt. Anschließend lässt er die Banane an der Stelle los, an der die Mitte der Banane gerade über dem Zentrum des Frittierkorbs liegt, und legt die Banane in den Korb.
Diese Aktionen wurden alle vom Agenten während des Erkundungsprozesses durch Suchen und Ausprobieren verschiedener Steuerungstools selbst entdeckt, ohne künstliche Vorschläge zu erhalten oder künstliche Demonstrationen zu verwenden.
3. Von der Erkundung zum autonomen Roboterprogramm
Jede Aktion hängt von der Schlussfolgerung des großen Sprachmodells ab, was hohe Kosten und eine langsame Ausführungsgeschwindigkeit verursacht.
Um eine Hochfrequenz-Geschlossene-Schleife-Planung zu realisieren, wandelt der Agent den Entscheidungsprozess automatisch in ein autonomes Roboterprogramm um, das die Aufgabe direkt über Code ausführen kann.
Der RAX-Agent kann den Roboter direkt steuern, ohne auf vortrainierte Strategien oder manuell geschriebene Aktionsprimitive angewiesen zu sein.
Während des Erkundungsprozesses geht die Kontrolle schrittweise von der hochrangigen Schlussfolgerung auf das autonom ausgeführte Codeprogramm über. Schließlich realisiert der Agent die autonome Entscheidungsfindung durch den von ihm selbst generierten Code.
In der Anfangsphase steuert der Agent den Roboter durch Aufrufen von Tools und verlässt sich auf das große Sprachmodell, um die Szene wahrzunehmen.
Wenn die Aufgabe erfolgreich abgeschlossen ist, kompiliert der Agent diese Entscheidungen in ein Codeprogramm. Danach kann das Programm unabhängig ausgeführt werden, ohne dass der Hauptagent bei jedem Schritt auf die Schlussfolgerung warten muss.
Zum Beispiel generiert der Agent nach der Erkennung der Form und geometrischen Merkmale des Objekts ein dreidimensionales Objektmodell. Wenn er auf ein neues Objektlayout trifft, kann das Programm die aus Tiefendaten generierte Punktwolke verwenden, um die Position und Haltung des Objekts automatisch zu schätzen.
Auf diese Weise muss der Hauptagent nicht wiederholt Rohbilder verarbeiten, was den Zeitaufwand und die Rechenkosten des Wahrnehmungsprozesses erheblich reduziert.
Der Agent teilt die Aufgabe auch in mehrere Phasen auf und realisiert modulare Fähigkeiten durch Programme. Jede Fähigkeit enthält Prüfungen vor der Ausführung, Aktionsausführung und Ergebnisvalidierung.
Die während des Erkundungsprozesses gemessenen Daten, wie z. B. die Bewegungsdistanz und die Greifrichtung, werden ebenfalls in Programmparameter umgewandelt.
Der Agent testet während des Erkundungsprozesses wiederholt verschiedene Versionen des Programms und beurteilt anhand der Fehler in jeder Phase, welche spezifische Fähigkeit geändert werden muss.
Dieses Design kann jeden Fehler direkt einer bestimmten Phase zuordnen, was die Lokalisierung von Problemen und die Korrektur erleichtert.
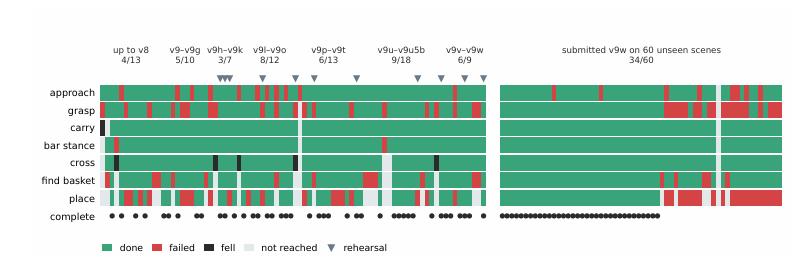
Wenn das Programm eine ausreichende Zuverlässigkeit erreicht, lässt der Agent es in neuen Szenen unbeaufsichtigten Tests unterziehen. Das Programm verfügt über einen Ausnahmebehandlungsmechanismus, und der Agent überwacht die vom Programm generierten Protokolle, um in Notfällen eingreifen zu können.
Wenn große Änderungen in der offenen Umgebung zu einem Fehler bei der Wahrnehmung oder Planung führen, löst das Programm eine Ausnahme aus. Zu diesem Zeitpunkt kann der Agent erneut eingreifen, die aktuelle Umgebung wahrnehmen und notwendige Anpassungen vornehmen.
Durch umfangreiches Testen und Debuggen des Programms in der Erkundungsphase kann das System schließlich ein vollständiges automatisiertes Programm generieren. Selbst bei unbekannten Szenen kann das Programm Wahrnehmung, Entscheidungsfindung und Aktionsausführung autonom abschließen.
4. Gedächtnisbasiertes kontinuierliches Lernen
Roboteragenten folgen wie Menschen einem ähnlichen kognitiven Prozess: Sie üben einzelne Fähigkeiten wiederholt, beherrschen sie gründlich und kombinieren diese Fähigkeiten dann, um komplexe langfristige Aufgaben vollständig zu üben.
Das Forschungsteam lässt den Agenten durch wiederholtes Üben Fähigkeiten generieren und verbessern und dann schrittweise die vorhandenen