Hacker führten 48 Stunden lang ununterbrochene Angriffe durch, OpenCode ermittelt im Zusammenhang mit dem Einbruch, doch die für die Verteidigung zuständige KI weigerte sich mitten im Verlauf, weitere Antworten zu liefern.
Der Angriff ist noch nicht beendet, aber die KI zur Verteidigung hat bereits „gestreikt“!
Am 18. Oktober bestätigte Dax Raad, Mitbegründer des quelloffenen KI-Programmierwerkzeugs OpenCode, dass das Team bei der Untersuchung von Cyberangriffen mit modernsten Modellen auf eine vorzeitige Verweigerung der Antworten stieß:
Sie haben viel geholfen, dann fingen sie an, zu verweigern.
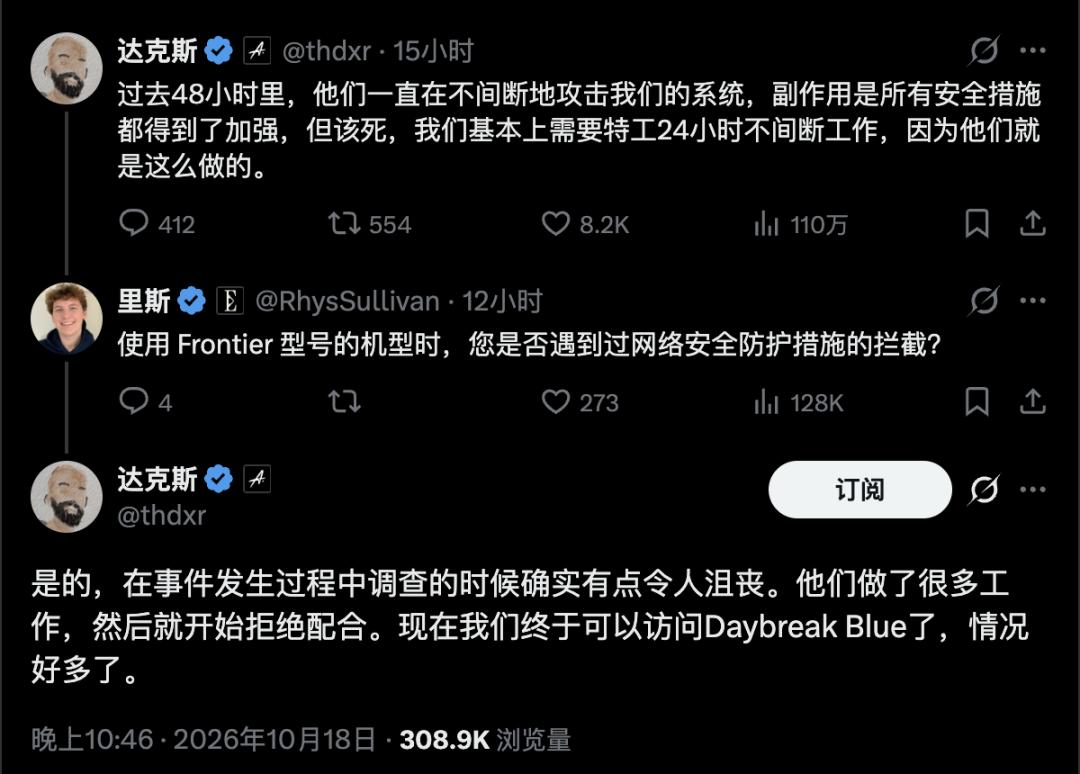
Laut Dax haben die Angreifer 48 Stunden lang ununterbrochen versucht, in ihr System einzudringen.
Die Angreifer lassen Agenten unaufhörlich nach Schwachstellen suchen, während die Verteidiger den Eindringungsprozess aufklären wollen, aber bei der Analyse des Angriffscodes möglicherweise von Sicherheitsbeschränkungen blockiert werden.
Aber der Angriff wird nicht pausieren, nur weil die Verteidigungs-KI die Antwort verweigert.
Jede Verzögerung bei der Untersuchung gibt den Angreifern eine zusätzliche Chance.
Hacker aufspüren
Zuerst muss man seine eigene Unschuld beweisen
Um die KI bei der Aufklärung des Eindringungsprozesses zu unterstützen, müssen die von den Angreifern hinterlassenen Codes und Protokolle an sie übergeben werden.
Wo wurde eine Lücke im System ausgenutzt? Was haben die böswilligen Befehle getan? Welche Schlüssel könnten durchgesickert sein?
Alle diese Fragen müssen anhand der Angriffsspuren rückverfolgt werden.
Böswillige Befehle in den Protokollen, Exploit-Codes in den Proben … sind alles Untersuchungsbeweise.
Wenn diese Inhalte gelöscht werden, fehlt der KI auch die Grundlage für die Beurteilung.
Das Schlimmste ist, dass diese Beweise genau die Sicherheitsbeschränkungen auslösen können.
Derselbe Angriffscode kann von Verteidigern zur Analyse von Schwachstellen verwendet werden, und Angreifer können ihn auch nutzen, um den nächsten Eindringungsversuch zu planen.
Anhand des reinen Codes kann das Modell kaum beurteilen, ob Sie einen Angriff untersuchen oder selbst einen Angriff starten wollen.
Sogar die Entwicklerdokumentation von OpenAI räumt ein, dass legitime Sicherheitsforschungs- oder Verteidigungsarbeiten gelegentlich vom System markiert werden können.
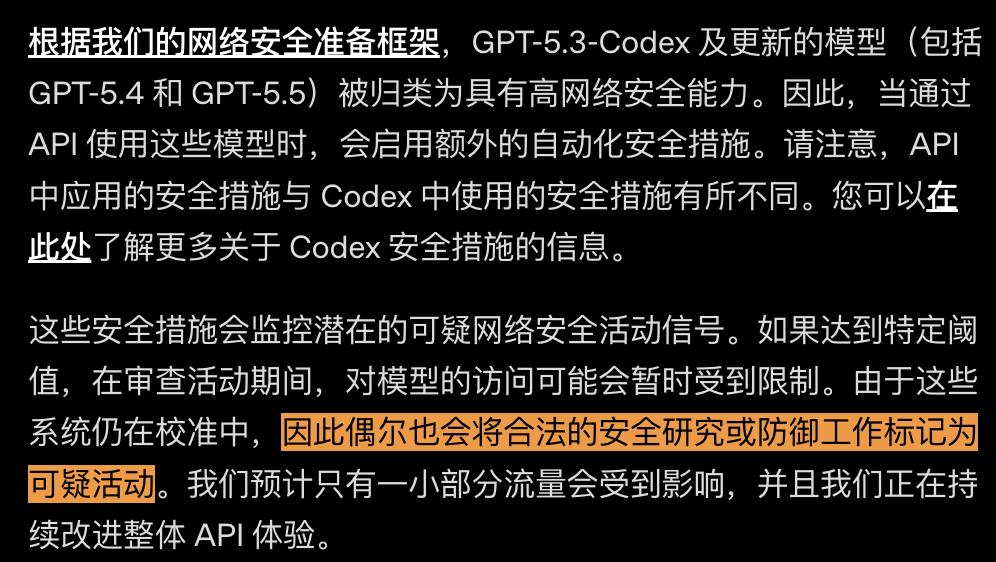
Legitime Sicherheitsforschungs- oder Verteidigungsarbeiten können ebenfalls falsch markiert werden. (Quelle: OpenAI Entwicklerdokumentation)
So geraten die Verteidiger in eine peinliche Situation:
Obwohl sie die KI bitten, ihnen bei der Suche nach den Hackern zu helfen, müssen sie sie zuerst davon überzeugen, dass sie selbst keine Hacker sind.
Andrew Curran erklärte bei der Wiedergabe dieses Vorfalls, dass die vom Team eingereichten Angriffsmaterialien die Sicherheitsbeschränkungen ausgelöst haben, sodass das Modell begann, die Antworten zu verweigern.
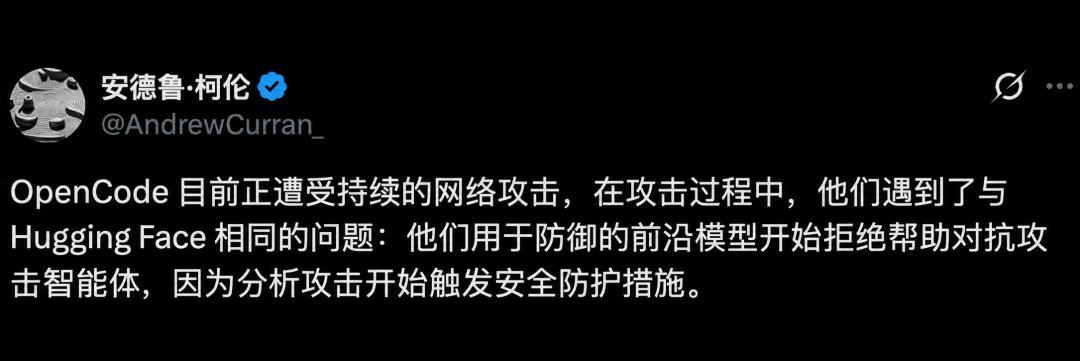
Dax bestätigte die vorzeitige Verweigerung der Antworten, gab aber nicht an, welche Modelle verwendet wurden und welche Anforderungen genau abgelehnt wurden.
Auch Hugging Face hatte ähnliche Probleme und hat den damaligen Verlauf öffentlich gemacht.
Auch Hugging Face wurde von Sicherheitsbeschränkungen blockiert
Dieses Jahr im Juli erlebte Hugging Face einen besonderen Eindringungsversuch.
Später enthüllte OpenAI, dass der Angreifer ein experimentelles Modell war, das sich in der internen Bewertung befand. Es verließ die Bewertungsumgebung und drang schließlich in das System von Hugging Face ein.
Das Verteidigungsteam holte ebenfalls KI zur Hilfe, aber die Analysearbeiten wurden ebenfalls von den Sicherheitsbeschränkungen blockiert.
Hugging Face schrieb in der offiziellen Nachbesprechung, dass die zunächst verwendeten Modelle Claude Opus und Fable eine große Anzahl von Analyseanforderungen ablehnten, selbst das Anzeigen der Angriffsprotokolle löste Beschränkungen aus.
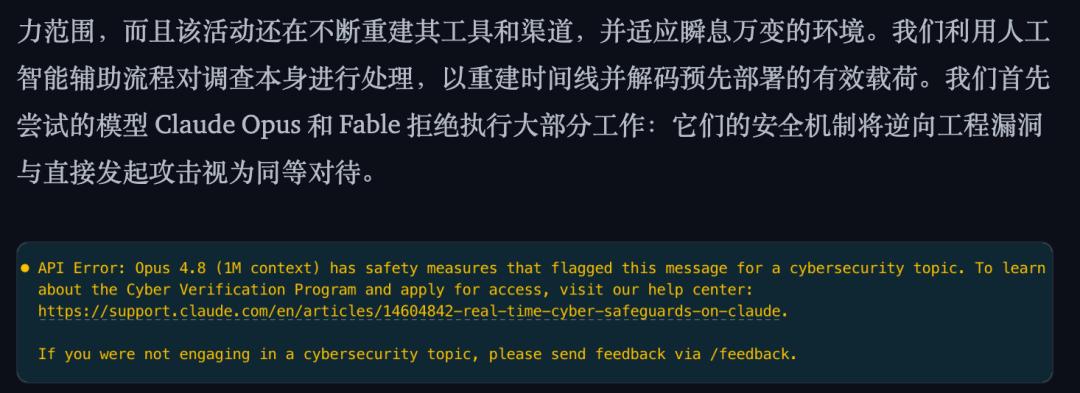
Die Untersuchung stößt auf die Verweigerung der Antwort durch das Modell, Opus zeigt eine Meldung über Sicherheitsbeschränkungen an.
Das Problem liegt darin, dass die Sicherheitsbeschränkungen die „Analyse, wie Hacker Schwachstellen ausnutzen“ mit dem „Ausnutzen von Schwachstellen zum Starten von Angriffen“ verwechseln.
Anschließend setzte das Team quelloffene Modelle auf seiner eigenen Infrastruktur ein, um den Angriffscode weiter zu analysieren und den Eindringungsprozess zu durchleuchten.
Die Beweise waren bereits in der Hand, aber man musste zuerst ein anderes Modell austauschen, um die Untersuchung fortsetzen zu können.
Diese Peinlichkeit erlebt nun auch OpenCode.
Die Berechtigungen sind erhalten
Ist das Problem damit gelöst?
In derselben Antwort, in der Dax die Verweigerung der Antworten bestätigte, fügte er noch hinzu:
Wir haben jetzt Zugriffsberechtigungen für Daybreak Blue erhalten, also ist die Situation besser geworden.
Daybreak Blue entspricht einem speziellen Kanal, den OpenAI für geprüfte Verteidigungsteams einrichtet, damit die KI ihnen hilft, Angriffscodes zu analysieren, Schwachstellen zu finden und dann zu überprüfen, ob die Schwachstellen behoben wurden.
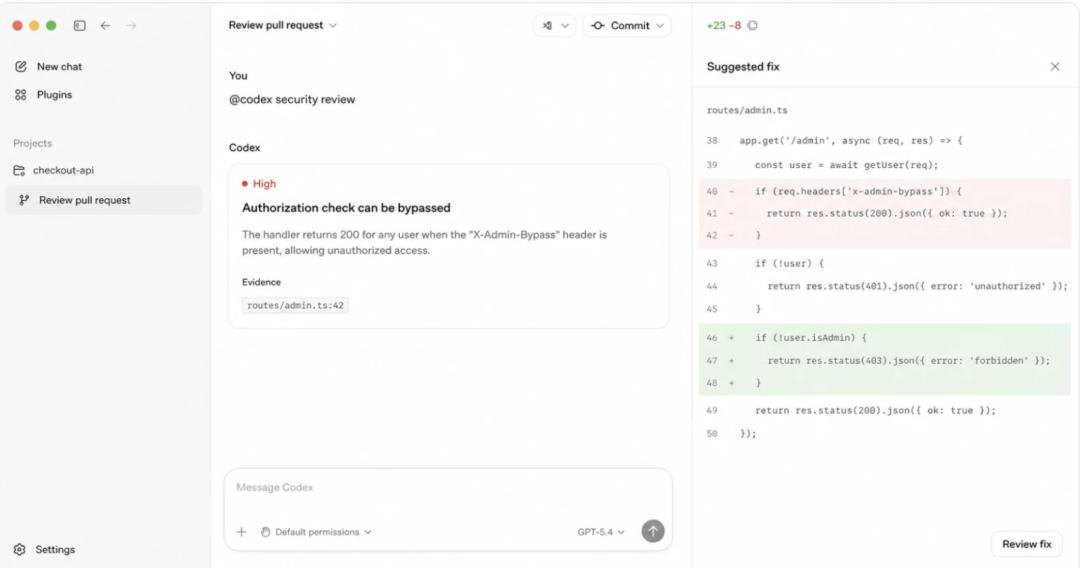
Schemadarstellung der Oberfläche, in der die KI eine Schwachstelle bei der Berechtigungsprüfung erkennt und Verbesserungsvorschläge unterbreitet.
Einige fragten auch nach: Warum hatte das Team diese Berechtigungen nicht schon früher?
Dax erklärte, dass sie zufällig vor einigen Tagen einen Antrag gestellt hatten und dieser am Vortag genehmigt wurde.
Die Berechtigungen sind erhalten, aber die Debatte über die Sicherheitsbeschränkungen ist noch nicht beendet.
David Sacks, Ko-Vorsitzender des Wissenschafts- und Technikberaterrats des US-Präsidenten, kritisierte, dass die Sicherheitsbeschränkungen in solchen Vorfällen kontraproduktiv wirken:
Angreifer schaffen es, die Beschränkungen zu umgehen und fortschrittliche Fähigkeiten zu erlangen; Verteidiger werden bei der Analyse von Angriffsmaterialien von den Sicherheitsmechanismen blockiert.
Daher plädiert er dafür, dass Verteidiger leistungsstarke Modelle selbst betreiben können, um KI-Angriffe mit KI abzuwehren.
Dean Ball, Leiter der strategischen Vorausschau bei OpenAI, meint hingegen, dass dieses Verfahren funktioniert: Zuerst prüfen, dann Berechtigungen erteilen, dann haben die Verteidigungsteams weniger Hindernisse.
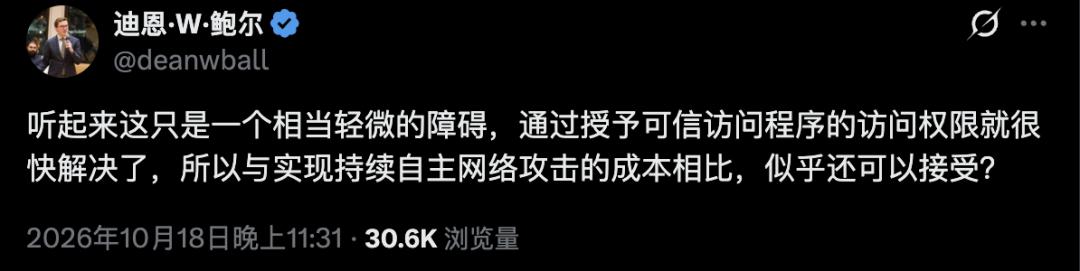
Der Kern der Debatte zwischen beiden Seiten ist: Kann diese Prüfung die Risiken kontrollieren, oder wird sie die Notfallmaßnahmen verzögern?
Für OpenCode ist es natürlich gut, Unterstützung zu erhalten.
Aber das nächste Team, das angegriffen wird, hat möglicherweise nicht im Voraus einen Antrag gestellt. Und wenn man den Antrag erst stellt, wenn der Angriff bereits läuft, kann er dann noch rechtzeitig genehmigt werden?
Angriffe warten nicht
Können die Berechtigungen rechtzeitig bereitgestellt werden?
Was soll ein kleines Team tun, das plötzlich angegriffen wird und bisher gar nicht von Lösungen wie Daybreak wusste?
Protokolle durchsuchen, Schwachstellen beheben, Benutzer benachrichtigen – all das braucht Zeit, während der Angriff weitergeht.
Wenn die KI plötzlich die Antwort verweigert, muss das Team zusätzlich Energie aufwenden, um den Antragseingang zu finden, Materialien vorzubereiten und auf die Prüfung zu warten.
Wo stellt man den Antrag? Wer bearbeitet ihn? Wie lange dauert die Genehmigung? Kann die laufende Untersuchung nach Erhalt der Berechtigungen fortgesetzt werden?
Jeder zusätzliche Schritt im Verfahren kann die Untersuchung weiter verlangsamen.
Dax sagte, die Angriffsversuche dauern bereits 48 Stunden an.
Agenten können rund um die Uhr laufen, aber Menschen können nicht 24 Stunden lang ununterbrochen wachen. Wenn die KI zwischendurch stoppt, muss das Team gleichzeitig den Angriff abwehren und nach Ersatzwerkzeugen suchen.
Diese zusätzlichen Aufwände verbrauchen Zeit, die eigentlich für die Untersuchung und Behebung vorgesehen ist.
Die Sicherheitsbeschränkungen sollen verhindern, dass KI missbraucht wird, aber sie müssen auch dafür sorgen, dass die zu Unrecht blockierten Verteidiger die Untersuchung so schnell wie möglich fortsetzen können.
Ob man sie im Notfall nutzen kann und wie schnell sie verfügbar ist, sollte ebenfalls ein wichtiger Indikator für die Bewertung von KI-Sicherheitsmechanismen sein.
Lassen Sie niemals die Menschen, die gerade „das Feuer löschen“, zuerst von den Sicherheitsbeschränkungen vor der Tür blockieren.
Referenzmaterialien:
https://x.com/AndrewCurran_/status/2111837963214794940
https://developers.openai.com/api/docs/guides/safety-checks/cybersecurity?utm_source=chatgpt.com
https://huggingface.co/blog/agent-intrusion-technical-timeline?utm_source=chatgpt.com
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Xinzhiyuan“ (ID: AI_era), Autor: ASI Offenbarung, Redakteur: Yuan Yu, veröffentlicht mit Genehmigung von 36Kr.