Claude schreibt Code so schnell, dass Git nicht mehr standhalten kann: Anthropic hat mit nur 7 Mitarbeitern innerhalb von 5 Monaten ein Versionskontrollsystem neu entwickelt.
Im Mai dieses Jahres hat Anthropic durchschnittlich etwa 2500 Code-Änderungen pro Tag zusammengeführt. Im September überstieg diese Zahl bereits 30.000. In nur vier Monaten ist die Anzahl der Code-Zusammenführungen um mehr als das 12-fache gestiegen
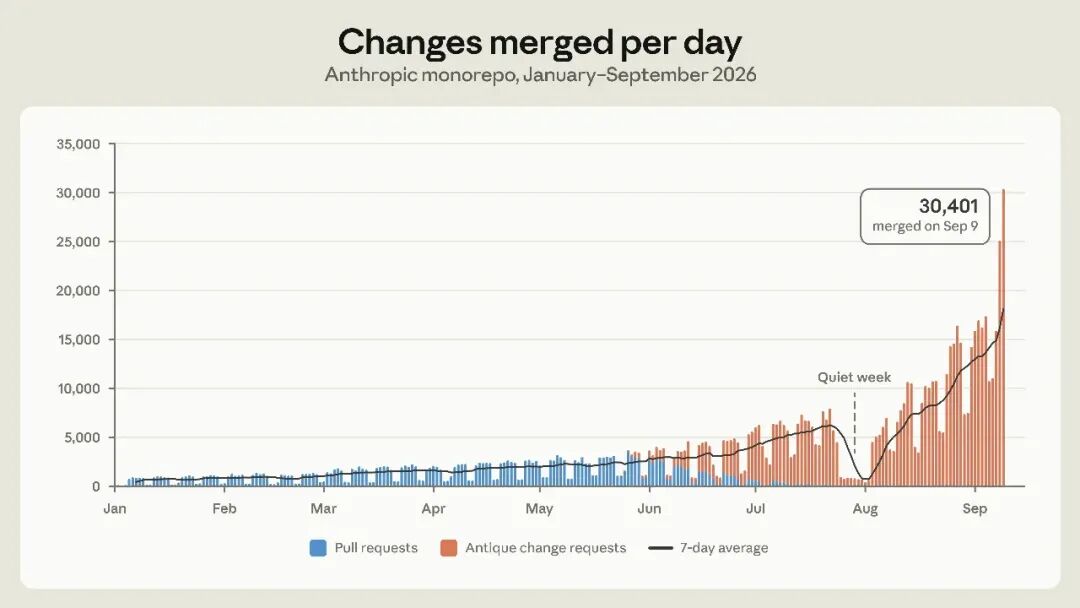
Von Januar bis September 2026 die tägliche Anzahl der zusammengeführten Code-Änderungen im Monorepo (einzelnes Code-Repository) von Anthropic
Dieses Wachstum stammt zu einem großen Teil von Claude. Der AI Coding Agent kann Code selbstständig ändern, Tests ausführen, Programme wiederholt optimieren und sogar Dienste von Grund auf neu erstellen. Mit der steigenden Code-Produktionsgeschwindigkeit kann die Softwareentwicklungsinfrastruktur, die ursprünglich für menschliche Ingenieure ausgelegt war, nicht mehr Schritt halten.
Das erste, was einen schweren Engpass erlitt, war Git. Der Verlauf des Hauptzweigs des Anthropic-Monorepos nähert sich bereits 100 GB an, und die komprimierte Arbeitskopie überschreitet 25 GB. Allein das Continuous-Integration-System (CI) muss täglich etwa 25 Millionen Code-Checkouts durchführen. Bei einer einfachen Methode zum Abrufen von Git-Daten könnte täglich ein Datenübertragungsbedarf von über 600 PB entstehen.
Anthropic hat zuvor verschiedene Optimierungsmaßnahmen wie flaches Klonen von Git, spärliches Checkout, interne Spiegelung und Screenshots von Objektspeichern eingesetzt. In Spitzenzeiten wurden sogar Hunderte von Git-Spiegel-Servern gewartet. Aber mit dem anhaltenden Wachstum der Code-Zusammenführungen wird dieses Schema immer schwerer aufrechtzuerhalten.
Daraufhin traf Anthropic eine ziemlich radikale Entscheidung: Ein neues Versionskontrollsystem neu zu entwickeln.
Am 13. Oktober hat Anthropic dieses Projekt in seinem offiziellen Ingenieur-Blog offengelegt. Ein Team von nur 7 Ingenieuren hat innerhalb von fünf Monaten das neue Versionskontrollsystem namens Scion entwickelt und die Migration des gesamten Monorepos abgeschlossen. Gleichzeitig haben sie auch das Code-Prüftool Antique, das Codesuchsystem, die Berechtigungsverwaltung und andere zugehörige Infrastrukturen entwickelt.
Nach der Migration ist die CPU- und Speicherauslastung der Scion-Infrastruktur auf etwa 1/200 des ursprünglichen Git-Spiegel-Schemas gesunken. Die Code-Checkout-Geschwindigkeit für CI- und Forschungsaufgaben hat sich um etwa zwei Größenordnungen verbessert, und allein bei CI wurden etwa 25 % der CPU-Kapazität eingespart.
Noch interessanter ist, dass Claude nicht nur ein wichtiger Grund für diesen Infrastrukturdruck ist, sondern auch ein wichtiges Werkzeug, das Anthropic bei der Systemumgestaltung unterstützt.
1
30.000 Code-Zusammenführungen pro Tag – wo genau stößt Git an seine Grenzen?
Dass Git zum Standardwerkzeug in der Softwareentwicklungsbranche geworden ist, liegt zu einem großen Teil an seinem verteilten Design. Entwickler können den Repository-Verlauf lokal speichern, Commits erstellen, Unterschiede vergleichen und die meisten Vorgänge auch ohne Netzwerkverbindung abschließen.
Für die überwiegende Mehrheit der Softwareprojekte ist dies ein sehr erfolgreiches Design. Aber es bedeutet auch, dass der Client über eine ziemlich vollständige Versionskontrollfähigkeit verfügen und die Repository-Daten speichern muss, die für die Durchführung der zugehörigen Vorgänge erforderlich sind.
Die Arbeitslast, vor der Anthropic steht, hat sich deutlich verändert.
Erstens wird das Code-Repository selbst immer größer. Der Verlauf des Hauptzweigs von fast 100 GB und die komprimierte Arbeitskopie von über 25 GB machen die häufige Erstellung von Entwicklungsumgebungen, CI-Umgebungen und Agent-Sandboxes teuer. Zweitens ist die Häufigkeit von Code-Checkouts extrem hoch. Die etwa 25 Millionen täglichen Checkouts haben die zusätzlichen Anforderungen, die von Entwicklerumgebungen, Agent-Sandboxes und Forschungsaufgaben erzeugt werden, noch nicht eingerechnet.
Entscheidender ist, dass die Geschwindigkeit der Code-Änderungen die traditioneller Entwicklungsteams bei weitem übertrifft. Anthropic hat in seinem offiziellen Artikel angegeben, dass jedes Mal, wenn ein Entwicklungsengpass beseitigt wird, die Code-Ausgabemenge weiter steigt. Die Entwicklungsinfrastruktur muss diesem Wachstum dauerhaft begegnen.
Um den Betrieb von Git aufrechtzuerhalten, hat Anthropic einst Hunderte von internen Spiegel-Servern bereitgestellt und Repository-Snapshots im Objektspeicher gespeichert. Diese Lösungen können das wiederholte Herunterladen reduzieren, bringen aber auch neue Wartungslasten mit sich. Spiegel müssen ständig synchronisiert werden, Screenshots fallen schnell hinter den Hauptzweig zurück, und die Aufrechterhaltung des normalen Betriebs von Vorgängen wie Diff und Blame, die auf historische Informationen angewiesen sind, in teilweisen Klonumgebungen wird immer komplizierter.
Anthropic hat daraufhin eine lang bestehende Designannahme neu überprüft: Da die meisten Code-Vorgänge von ständig vernetzten Agenten und automatisierten Aufgaben ausgeführt werden, warum muss jeder Client dann wie ein traditioneller Git-Client die Fähigkeit haben, den vollständigen Repository-Verlauf unabhängig zu verarbeiten?
Dies wurde der Ausgangspunkt für das Design von Scion.
Natürlich ist der Konflikt zwischen extrem großen Monorepos und Git nichts Neues. Google hat schon früh das interne zentrale Versionskontrollsystem Piper entwickelt, und Meta hat auch Jahre damit verbracht, Sapling aufzubauen. Die Probleme, auf die Anthropic diesmal stößt, ähneln denen dieser großen Technologieunternehmen, aber die Antriebskräfte sind unterschiedlich: Früher waren es hauptsächlich riesige Ingenieurorganisationen und die Größe von Code-Repositorien, jetzt erzeugen auch eine große Anzahl parallel arbeitender Coding-Agenten einen ähnlichen Druck.
2
Wie ist Scion gestaltet? Die meisten Arbeiten der Versionskontrolle werden auf den Server verlagert
Die wichtigste Designänderung bei Scion besteht darin, die Versionskontrolle von einem arbeitsweisen, das auf lokalen Repositories zentriert ist, zu einer ständig aktiven Client-Server-Architektur zu wandeln.
In Git kann der Client unabhängig Commits erstellen, Rebases durchführen, den Verlauf abfragen und dann die Änderungen an den Remote-Server pushen. Scion hingegen verlagert die Hauptvorgänge wie Commits, Zusammenführungen, Rebases und Verlaufsabfragen auf die Serverseite. Der Client ist hauptsächlich dafür verantwortlich, einen begrenzten lokalen Cache zu pflegen, das Arbeitsverzeichnis zu verwalten und Dateiänderungen zu überwachen.
Da Commits direkt auf der Serverseite erstellt werden, benötigt Scion keinen Push-Schritt mehr, der im traditionellen Git-Arbeitsablauf enthalten ist. Der Client muss auch nicht eine große Menge an Repository-Daten herunterladen, die für die aktuelle Aufgabe irrelevant sind.
Diese Änderung ermöglicht es auch, Versionskontrollfunktionen direkt über APIs für andere Systeme bereitzustellen. Wenn beispielsweise eine CI-Aufgabe nur den Unterschied zwischen einem bestimmten Commit und dem Zusammenführungsbasispunkt berechnen muss, kann sie direkt den Server auffordern, das Ergebnis zurückzugeben, ohne zuerst das gesamte Code-Repository auszuchecken. Tools wie automatisches Rollback und Lokalisieren von problematischen Commits können auch Versionsverläufe über APIs abfragen.
Aus Sicht der technischen Architektur versucht Scion, die Kosten von Versionskontrollvorgängen stärker von der tatsächlichen Menge der geänderten Daten abhängig zu machen, statt von der Größe des gesamten Repositories.
Um dies zu erreichen, hat Scion die zugrunde liegenden Datenstrukturen neu entworfen.
In Git verweist ein Commit auf das entsprechende Verzeichnisbaum. Scion hingegen verwendet Änderungsdatensätze namens Changeset, die in das Write-Ahead-Log (Vorausschreibprotokoll) geschrieben werden. Jeder Changeset-Eintrag zeichnet die Dateien auf, die sich gegenüber dem ersten übergeordneten Commit geändert haben, sowie inhaltsadressierende Verweise, die auf den Inhalt der komprimierten Dateien verweisen.
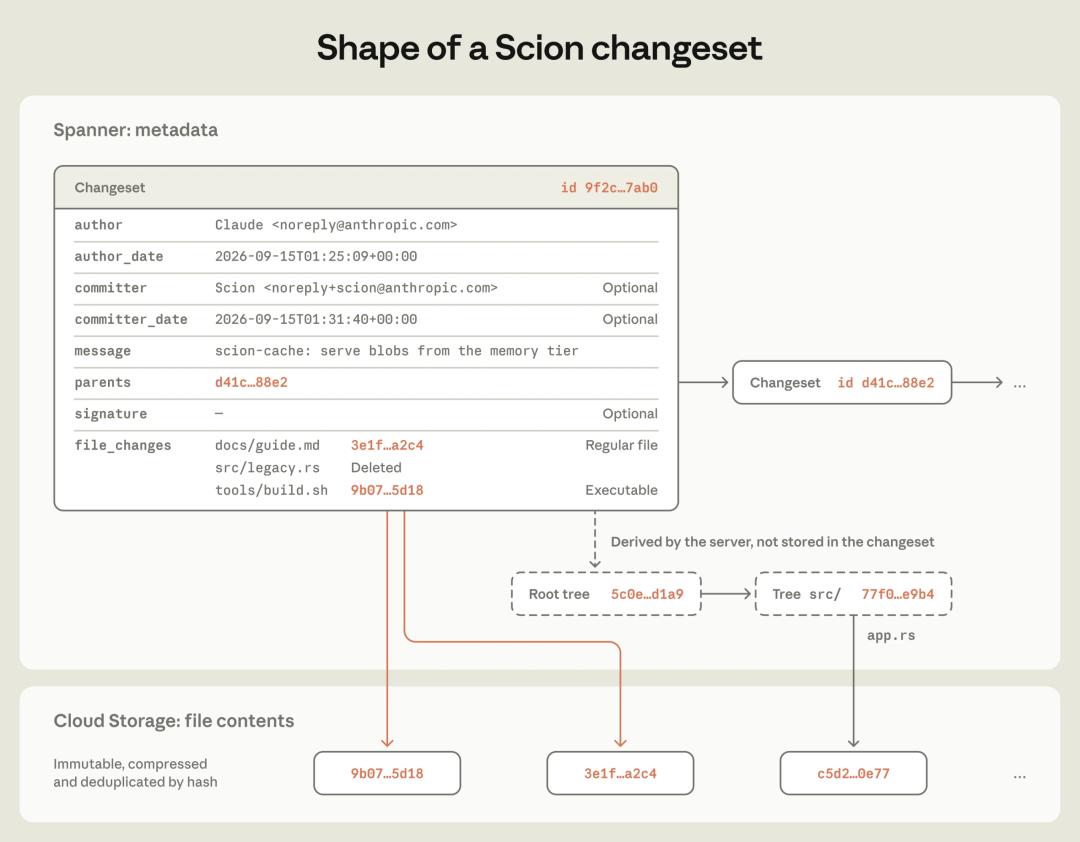
Datenstruktur des Changeset (Änderungssatz) in Scion
Der Dateiinhalt wird im Blob-Speicher gespeichert, und Versionsbeziehungen und zugehörige Metadaten werden vom Backend-System verwaltet. Scion verwendet Spanner, um einen Teil der Metadaten zu speichern, die koordiniert werden müssen, und minimiert die serverübergreifende Synchronisation bei der Erstellung von Commits so weit wie möglich.
Dieses Design ermöglicht es, Commits schnell zu erstellen und zu verteilen, und vermeidet auch einen Teil des Overheads für Verpackung, Verhandlung und Wartung, der durch den Git-Packfile-Mechanismus verursacht wird.
Scion unterstützt weiterhin Referenzen (Refs), die Git-Branches und -Tags ähneln, minimiert aber die Abhängigkeit von ihnen. Anthropic ist der Ansicht, dass wenn eine große Anzahl von Vorgängen den globalen gemeinsam genutzten Zustand aktualisieren muss, leicht neue Koordinationsengpässe entstehen. Daher hängt die reguläre Commit-Erstellung von Scion nicht von der Verschiebung von Refs ab, und nur Szenarien wie der Hauptzweig oder der Veröffentlichungszweig müssen diese Referenzen aktualisieren.
Die Verlagerung von Vorgängen auf den Server bedeutet jedoch nicht, dass die Probleme automatisch gelöst werden. Der Server muss gleichzeitig Anforderungen von einer großen Anzahl von Agenten und CI-Aufgaben verarbeiten. Wenn alle Clients direkt auf den zentralen Speicher zugreifen, kann das System immer noch durch den Datenverkehr überlastet werden.
Anthropic hat daher eine geschichtete Cache-Architektur entworfen.
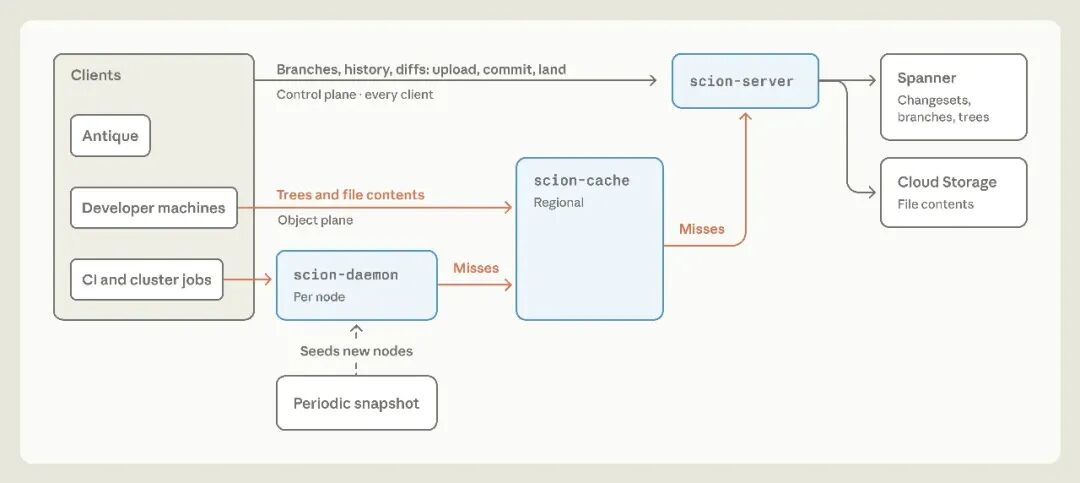
Code-Checkout-Architektur von Scion
Auf den Rechenknoten ist scion-daemon dafür verantwortlich, den Cache von Dateiobjekten für mehrere Aufgaben auf demselben Knoten gemeinsam zu nutzen. Die scion-cache-Server in der Region bieten einen zweiten Cache, der sich nach oben mit dem autoritativen scion-server verbindet. Nur bei einem Cache-Miss muss weiterhin auf Spanner oder den Cloud-Speicher zugegriffen werden.
Der Client fordert spezifische unveränderliche Objekte an. Da Objekte inhaltsadressiert sind, muss der Cache nicht wiederholt bestätigen, ob sich das Objekt geändert hat, und alle Schichten von Diensten können unabhängig horizontal skaliert werden.
Anthropic gibt an, dass die Cache-Trefferquote jeder Schicht dieser Architektur über 99 % beträgt. Es isoliert auch Fehler durch klare Cache-Schichten, um zu vermeiden, dass bei einem Problem mit dem regionalen Cache eine große Anzahl von Anforderungen direkt zu den Upstream-Diensten strömt.
Scion macht gleichzeitig spärliches Checkout und virtualisiertes Checkout zu grundlegenden Fähigkeiten. Der Client ruft nur die benötigten Verzeichnisse und Dateien ab, und einige Dateien werden erst geladen, wenn sie tatsächlich aufgerufen werden. Für Aufgaben, die nur Versionsmetadaten benötigen, kann sogar die Erstellung des Arbeitsverzeichnisses vollständig übersprungen werden.
Schließlich berichtet Anthropic, dass die CPU- und Speicherauslastung der Scion-Infrastruktur im Vergleich zum ursprünglichen Git-Spiegel-Schema um etwa das 200-fache verringert wurde, das Code-Checkout von Minuten auf Sekunden verkürzt wurde und CI etwa 25 % der CPU-Kapazität einspart.
Es ist zu beachten, dass diese Indikatoren unterschiedlichen Optimierungsdimensionen entsprechen. Das 200-fache bezieht sich auf den Unterschied bei der Auslastung von Infrastrukturressourcen, die zwei Größenordnungen beziehen sich auf die Code-Checkout-Geschwindigkeit, und die 25 % beziehen sich auf den Nutzen der CI-Kapazität. Es kann nicht einfach verstanden werden, dass Scion bei allen Vorgängen 200 Mal schneller als Git ist.
3
Sieben Personen, fünf Monate – Claude hat auch die Geschwindigkeit der Neugestaltung der Infrastruktur verbessert
Wenn das Architekturdesign von Scion die Systemänderungen widerspiegelt, die durch die Skalierung von Agenten verursacht werden, dann zeigt sein Entwicklungsprozess einen weiteren Einfluss von Coding-Agenten auf die Organisationsweise des Software-Engineerings.
Anthropic gibt an, dass Scion und das zugehörige Code-Prüftool Antique von einem 7-köpfigen Team entwickelt wurden. Das Team hat innerhalb von fünf Monaten den Systemaufbau und die Migration des gesamten Monorepos abgeschlossen und gleichzeitig mehrere verwandte Systeme wie Codesuche und Berechtigungsverwaltung ausgeliefert.
In diesem Prozess hat Claude eine große Menge an Code-Implementierungs- und Optimierungsarbeiten übernommen.
Der offizielle Artikel stellt einen konkreten Fall vor: Die frühe Git-Datenimport-Pipeline von Scion wurde hauptsächlich von Ingenieuren handgeschrieben, und das Team dachte ursprünglich, die Leistung sei bereits gut. Später ließen sie die interne frühe Version von Claude Mythos Preview die gesamte Pipeline neu implementieren.
Ohne weitere Anweisungen hat die neue Version, die von Claude generiert wurde, den Speicherverbrauch um das 20-fache gesenkt, die Ausführungsgeschwindigkeit um das 4-fache verbessert und gleichzeitig die ursprüngliche Reihenfolge des Datenimports und die Einschränkungen der Datenstruktur beibehalten.
Die Bedeutung dieses Falls liegt darin, dass Agenten bereits an der Leistungsoptimierung komplexer Infrastrukturen teilnehmen können, statt nur lokale Funktionen, Schnittstellen oder Geschäftscode zu schreiben.
Aber Anthropic betont auch, dass dies nicht bedeutet, dass die Rolle der Ingenieure verschwunden ist.
Die Teammitglieder sind der Ansicht, dass Claude beim Schreiben von Code sie selbst übertroffen hat, aber die Systemebenen-Entscheidungen hängen immer noch von den Ingenieuren ab, einschließlich des Verständnisses der Beziehungen zwischen verschiedenen Komponenten, der Beurteilung von Architekturentscheidungen und der Entscheidung, welche Probleme es wert sind, gelöst zu werden.
Es gibt ein sehr interessantes Detail im offiziellen Artikel: Eine wichtige Aufgabe der Ingenieure besteht darin, Claude zu sagen, „tu das nicht“.
Dies hängt mit den tatsächlichen Eigenschaften des Scion-Projekts zusammen. Es gibt eine große Anzahl von Abwägungen zwischen hohem Durchsatz, niedriger Latenz, horizontaler Skalierbarkeit, Fehlerisolation und Datenkonsistenz. Eine bestimmte Implementierung kann, selbst wenn die Code-Qualität sehr gut ist, nicht unbedingt den Anforderungen des langfristigen Systembetriebs entsprechen. Die Ingenieure müssen ausgehend von den Einschränkungen der Gesamtarchitektur und der Produktionsumgebung entscheiden, welche Lösungen akzeptabel sind.
Claude wird auch für den