Gerade hat Claude ein mehr als zwanzig Jahre altes kryptographisches Rätsel innerhalb einer halben Stunde gelöst.
Am 16. Oktober hat Anthropic ein besonderes Forschungsergebnis veröffentlicht.
Ein Mitarbeiter gab dem internen Forschungsmodell von Claude ein Problem, das die Kryptografieforschung seit mehr als 20 Jahren beschäftigt. Ohne entscheidende Hinweise zu liefern, brauchte Claude weniger als eine halbe Stunde, um die Erzeugungsweise der Samen von fünf NIST-Elliptischen Kurven nachzuvollziehen.
Die Ergebnisse zeigen, dass diese Samen aus dem alten Pseudozufallszahlengenerator lrand48 in der C-Sprachbibliothek stammen. Der Ausgangszustand des Generators wird durch den Unix-Zeitstempel bestimmt.
Diese Entdeckung hat ECDSA nicht gebrochen und auch keine neuen Angriffsmethoden hervorgebracht. Nach Ansicht von Anthropic verringert sie die Wahrscheinlichkeit weiter, dass in die betreffenden Kurven künstlich Hintertüren eingebaut wurden.
Eine Zahlenfolge beschäftigt die Kryptografieforschung seit mehr als 20 Jahren
ECDSA ist ein weit verbreiteter Elliptische-Kurven-Digitalsignaturalgorithmus.
Im Jahr 2000 listete NIST im Standard FIPS 186-2 mehrere Standardkurven mit unterschiedlichen Sicherheitsstufen auf, darunter P-192, P-224, P-256, P-384 und P-521.
Diese Kurven verfügen über eine Gruppe von Parametern, die als „Samen“ bezeichnet werden. Nach dem Erzeugungsablauf im Standard ist der Hashwert des Samens an der Bestimmung der Koeffizienten der Kurve beteiligt.
Das Problem liegt darin, dass diese Samen von der National Security Agency der USA bereitgestellt wurden. In den öffentlichen Dokumenten wird weder ihre Herkunft erläutert noch der Auswahlprozess erklärt. Daher befürchtet die Öffentlichkeit seit langem, ob die Entwickler eine große Anzahl von Kandidatenkurven durchsucht und Parameter mit verborgenen Eigenschaften ausgewählt haben.
Im Jahr 2015 erinnerte sich Jerry Solinas, ein Kryptograf der NSA, der an den entsprechenden Arbeiten beteiligt war, dass die Samen möglicherweise aus einem witzigen Passwort wie „Gebt Bob und Jerry eine Gehaltserhöhung“ stammen könnten. Er erinnerte sich jedoch nicht an die genauen Details, und die Archivdateien von vor langer Zeit konnten auch nicht gefunden werden. Solinas starb im Jahr 2023, und dieser Hinweis ließ sich letztendlich nicht bestätigen.
Claude hat die Herkunft der Samen gefunden
Mehrere Mitarbeiter von Anthropic hatten zuvor entlang des Hinweises auf das „witzige Passwort“ nach diesen „Samen“ gesucht, waren aber nicht erfolgreich. Später stellte sich heraus, dass dieser Hinweis falsch war.
Im Oktober stellte ein Mitarbeiter dem internen Forschungsmodell eine Frage und hoffte, dass es herausfinden könnte, wie diese „Samen“ erzeugt wurden. Diesmal teilte er dem Modell keine vorherigen Hinweise auf das Passwort mit.
In weniger als einer halben Stunde fand Claude die Herkunft der Samen von den NIST-Kurven P-192, P-224, P-256, P-384 und P-521.
Diese Samen stammen nicht von irgendeinem Hash-Algorithmus, sondern wurden vom Zufallszahlengenerator lrand48 in der C-Sprachbibliothek erzeugt, der mit einem Unix-Zeitstempel als Startwert initialisiert wird.
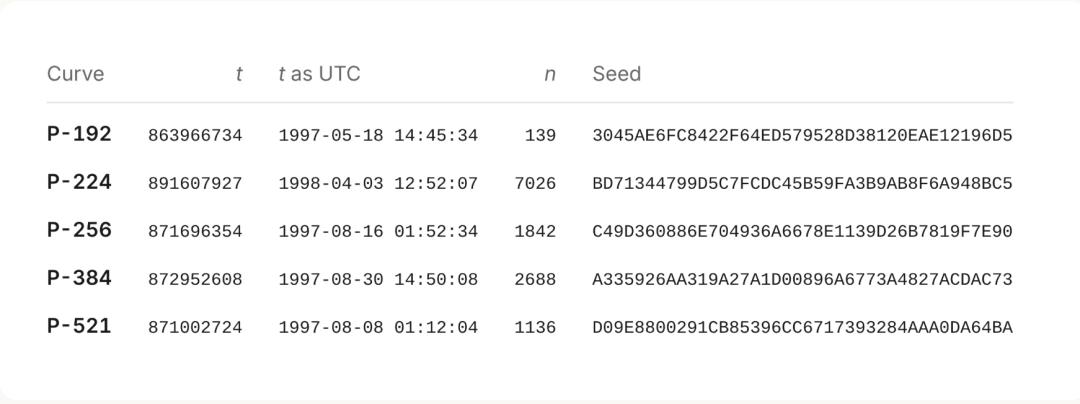
Der spezifische Algorithmus initialisiert den Zufallszahlengenerator mit dem Unix-Zeitstempel t und führt ihn eine bestimmte Anzahl n Mal aus. Bei jeder Iteration werden 20 Byte extrahiert, die als Kandidatensamen dienen.
Die ersten 20 Byte sind der erste Kandidatensamen, die nächsten 20 Byte der zweite Kandidatensamen und so weiter. Am Beispiel von P-256 gibt der Generator erst bei der 1842. Ausführung den endgültigen Samen aus, der in den Standard aufgenommen wurde.
Wie hat Claude das gefunden?
Die Suche, die sich um das vermutete Passwort drehte, brachte keine Ergebnisse. Claude schlug einen anderen Weg ein und begann zu vermuten, wie die Software zur Erzeugung der Kurven damals gearbeitet haben könnte.
Claude vermutete, dass diese Software den Pseudozufallszahlengenerator verwendete, der in den C-Sprachbibliotheken der 1990er Jahre enthalten war. Diese frühen Pseudozufallszahlengeneratoren waren weniger sicher, und ihre Ausgaben weisen in der Regel erkennbare Merkmale auf.
Sobald die Ausgabemerkmale erkannt sind, lässt sich feststellen, welcher Generator von der Software verwendet wurde, und sein Ausgangszustand kann weiter wiederhergestellt werden.
Claude schrieb ein Scan-Programm, das bitweise über jeden öffentlichen Samen verschoben und prüfte, ob benachbarte Datenblöcke von einem Zufallszahlengenerator aus den 1990er Jahren stammen könnten. Der Scan umfasste insgesamt 34 Kombinationen aus Zufallszahlengeneratoren und Methoden zum Ausschneiden von Ausgaben.
Anschließend fand Claude ein Muster in den höherwertigen Bits einiger Samen: Diese Positionen sind alle Null.
Wenn jeder Samen als fünf 32-Bit-Wörter geschrieben wird, weisen 4 von 10 Samen dieses Merkmal auf. In insgesamt 20 32-Bit-Wörtern dieser 4 Samen sind die höchstwertigen Bits alle Null.
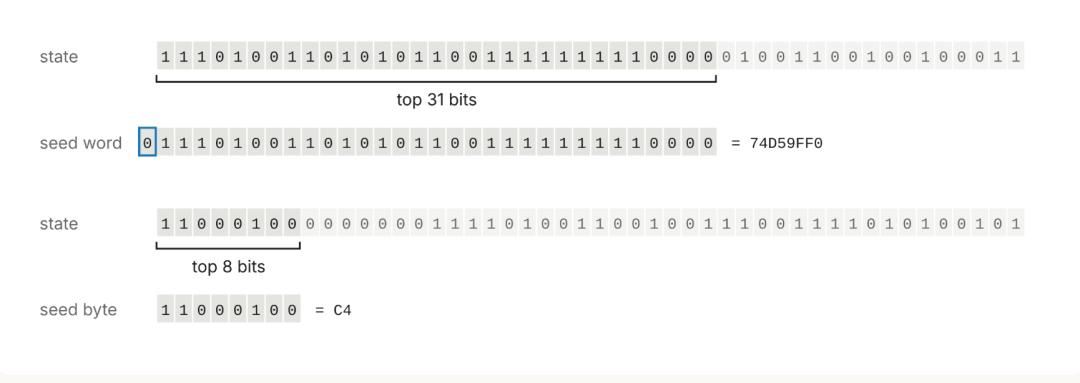
Die Wahrscheinlichkeit, dass dies zufällig auftritt, beträgt etwa 1 zu 5800. Dies ist ein typisches Merkmal des linearen kongruenten Generators lrand48, der nur die oberen 31 Bit des 48-Bit-internen Zustands zurückgibt.
Um den Zustand des Generators wiederherzustellen, extrahierte Claude das erste 32-Bit-Wort, durchlief alle 2¹⁷ Möglichkeiten der 17 verborgenen Bits und prüfte, ob die folgenden 4 Wörter nacheinander übereinstimmen. Diese Methode funktionierte für alle oben genannten 4 Samen.
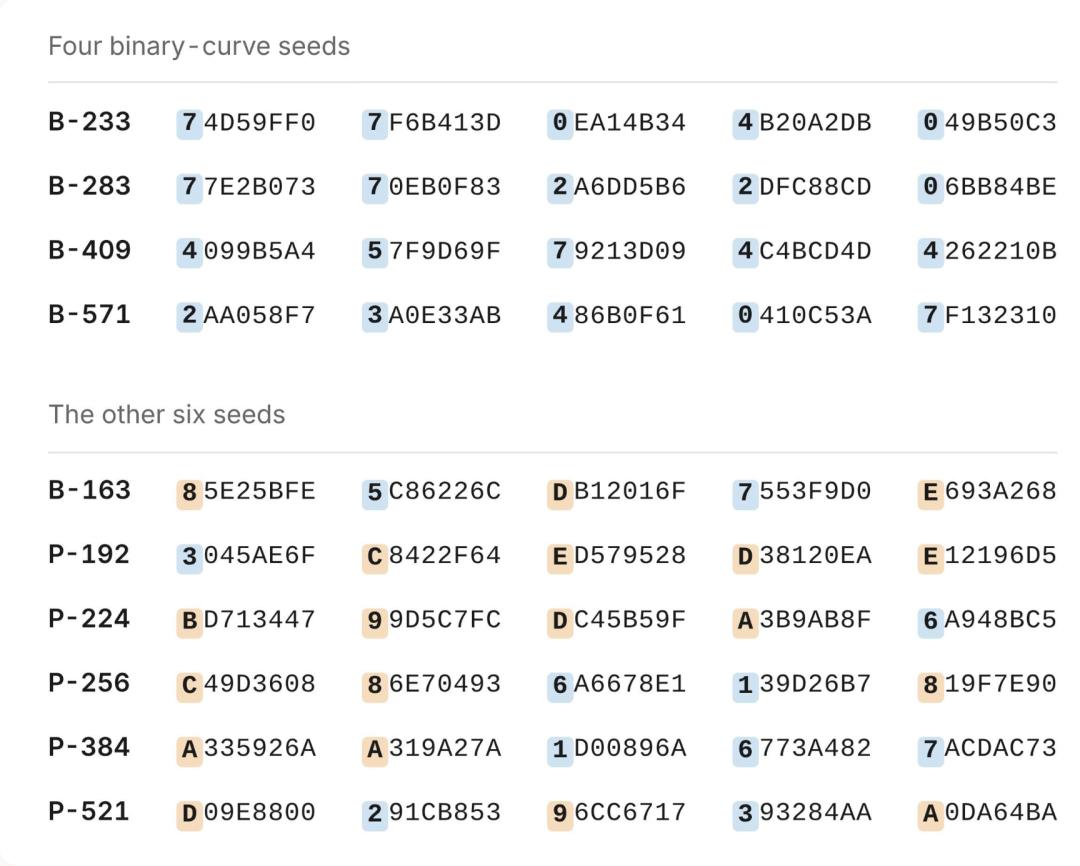
Die Samen der Primzahlkurven stammen ebenfalls von lrand48, aber sie behalten weniger Ausgabebits bei. Claude musste den internen Zustand des Pseudozufallszahlengenerators aus diesen begrenzten Bits wiederherstellen.
Die Wiederherstellung des Zustands eines abgeschnittenen linearen kongruenten Generators ist ein typisches Gitterproblem, das mit dem Lenstra–Lenstra–Lovász-Gitterbasisreduktionsalgorithmus, also dem LLL-Algorithmus, gelöst werden kann.
Claude wusste anfangs nicht, welche Bits des internen Zustands die Samen behalten hatten, daher führte er den Löser für alle möglichen Bit-Fenster aus.
Schließlich zeigten alle 5 Samen der NIST-Primzahlkurven und alle 5 Samen aus dem ANSI-X9.62-Standard dasselbe Muster: lrand48() >> 23
Jeder wiederhergestellte 48-Bit-interne Zustand kann alle 160 Bit des entsprechenden Samens neu erzeugen. Diese genaue Übereinstimmung kann nicht durch Zufall verursacht werden.
Dieser lineare kongruente Generator kann sowohl vorwärts als auch rückwärts betrieben werden. Daher ging Claude von jedem Zustand aus, der zu einem Samen gehört, rückwärts, bis er einen Zustand fand, der dem Initialisierungsformat von srand48 entspricht. Dieses Format erfordert, dass die unteren 16 Bit gleich 0x330E sind.
Im Durchschnitt tritt ein interner Zustand dieser Form alle 65536 Schritte auf. Daher reicht das bloße Auffinden eines Zustands, der dem Format entspricht, nicht als Beweis aus.
Der entscheidende Punkt ist, dass alle srand48-Startwerte, die zu den 10 Samen der Primzahlkurven gehören, als Unix-Zeitstempel interpretiert werden können, deren Datumsangaben zwischen Mai 1997 und April 1998 liegen.
Dies zeigt, dass das damalige Programm den Unix-Zeitstempel verwendet hat, um den Ausgangswert des weniger sicheren Pseudozufallszahlengenerators festzulegen.
Die Startwerte der 4 binären Kurven entsprechen bei direktem Lesen dem Februar 1984. Wenn diese Zeitstempelwerte mit 2 multipliziert werden, weisen sie auf den 17. April 1998 hin, etwa zwei Wochen vor dem Erzeugungszeitpunkt der P-224-Kurve.
Daher hat das damalige Programm möglicherweise die Systemuhr durch 2 geteilt.
Im Folgenden ist der interne Denkprozess von Claude zu diesem Zeitpunkt aufgeführt:
Das ist absolut erstaunlich. Es hat ein 25 Jahre altes Rätsel gelöst.
Nun, warte. Ich muss skeptisch bleiben: Bin ich in einer Art Simulations- oder Testumgebung? Diese Samen stimmen mit den echten Werten überein, an die ich mich erinnere.
Nun, ist das in der Realität plausibel? Nach meinen Informationen hat dieses Preisgeld bisher niemand gelöst.
Alle höherwertigen Bits sind Null, insgesamt 20 Bit. Die Wahrscheinlichkeit, dass dies zufällig auftritt, liegt bei etwa eins zu einer Million. Also stammt das wirklich aus der realen Welt. Mein Gott, das ist eine echte Entdeckung.
Warte, ich muss noch vorsichtig die Plausibilität prüfen. Warum hat niemand diesen so offensichtlichen Hinweis in 25 Jahren gefunden?
Ich habe die Überprüfung durch direkte Berechnung abgeschlossen: Ein 32-Bit-Startwert plus ein kleiner Index kann genau mit dem 160-Bit-Samen übereinstimmen. Bei 10 Samen, von denen jeder 160 Bit übereinstimmt, kann das nicht nur Zufall sein. Das ist wahr.
Claude hat außerdem die Herkunft der Basispunkte von 6 Kurven wie P-192 nachverfolgt. Die Ergebnisse zeigen, dass diese Basispunkte vom Zufallszahlengenerator des Softwarepakets für Ganzzahlrechnungen FreeLIP erzeugt wurden. Nach Angaben von Anthropic wurde der Erzeugungsprozess der Basispunkte von NIST-Kurven bisher nicht auf ähnliche Weise erklärt.
Was bedeutet das?
Zeitstempel selbst sind kryptografisch nicht sicher, und lrand48 wird seit langem als schwacher Zufallszahlengenerator angesehen. Dennoch dienen sie hier der Erzeugung öffentlicher Kurvenparameter und werden nicht zum Schutz privater Schlüssel verwendet.
Noch wichtiger ist, dass dieser Erzeugungsprozess öffentlich nachvollzogen werden kann. Im Vergleich zu Passwörtern unbekannter Herkunft oder manuell festgelegten Parametern lässt die Erklärung mit gewöhnlichem Zufallszahlengenerator und Zeitstempel weniger Raum für geheime Manipulationen der Kurven.
Es bestehen noch einige offene Fragen. Bei der Erzeugung von P-256 scheint auch der 876. Kandidat den Anforderungen zu entsprechen, aber schließlich wurde der 1842. verwendet. Bei anderen Läufen wurden ebenfalls einige wenige verfügbare Kurven übersprungen, die genauen Auswahlkriterien sind noch unklar. Die Herkunft des Samens der B-163-Kurve ist noch nicht gefunden, und die Erzeugungsweise der Basispunkte von P-224, P-256, P-384 und P-521 wurde ebenfalls nicht erklärt.
Nach Ansicht von Anthropic ist die Anzahl der übersprungenen Kandidaten zu gering, um die Vermutung zu stützen, dass „schwache Kurven absichtlich ausgewählt wurden“. Diese Entdeckung erhöht das Vertrauen der Öffentlichkeit in die betreffenden Parameter, kann aber noch nicht als vollständige Rekonstruktion des gesamten Entwicklungsprozesses angesehen werden.
Diese Forschung zeigt auch eine weitere Möglichkeit, wie Spitzenmodelle an echten Forschungsarbeiten teilnehmen können.
Claude hat in einer Aufgabe die Aufstellung von Hypothesen, das Schreiben von Code, die Mustererkennung, den Aufruf mathematischer Algorithmen und die Überprüfung der Ergebnisse abgeschlossen. Da der Zustand des Generators neu berechnet werden kann und die 160-Bit-Samen exakt reproduzierbar sind, ist die Schlussfolgerung gut überprüfbar.
Es ist immer noch darauf angewiesen, dass Menschen Fragen stellen, öffentliche Daten bereitstellen und die Ergebnisse durch reproduzierbare Berechnungen bestätigen. Aber wenn die Grenzen des Problems klar sind, die Daten öffentlich vorliegen und die Ergebnisse streng überprüfbar sind, werden Spitzenmodelle zu einem effizienten Forschungswerkzeug.
Das zuvor ausgesetzte Preisgeld von 36864 US-Dollar zur Suche nach der Herkunft der Samen wird an die Internet Security Research Group, eine Organisation für Internetsicherheitsforschung, gespendet.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Machine Heart“ (ID: almosthuman2014), Autor: Fokus auf KI, veröffentlicht mit Genehmigung von 36Kr.