Entgegen dem gesunden Menschenverstand: Die neueste Forschung von Microsoft zeigt, dass das „Langzeitgedächtnis“ von Agenten ein Gift sein könnte
Kürzlich ist in der KI-Community ein überraschendes, dem gesunden Menschenverstand widersprechendes Papier erschienen. Der Hauptakteur ist die Microsoft Research, und das Untersuchungsobjekt ist der derzeit beliebteste Agent.
via https://arxiv.org/html/2610.07447v1
Normalerweise gilt: Je mehr sich ein Agent merkt, desto besser sollte er seine Aufgaben erledigen. Doch dieses am 5. Oktober auf arXiv veröffentlichte Papier mit dem Titel „Fork-and-Flush: Escaping Idea Basins in Autoresearch Agents“ zeigt, dass das Gegenteil der Fall sein könnte: Je länger das Gespräch dauert, desto leichter gerät der Agent in eine Sackgasse. Um aus der Sackgasse herauszukommen, hat Microsoft ein scheinbar einfaches, aber rigoroses Mittel vorgeschlagen: den Chatverlauf regelmäßig zu leeren.
Derselbe Agent läuft acht Mal – wie acht verschiedene Personen
Die Forscher haben sich einen Agenten zur Brust genommen, der „autonom Forschungsarbeit betreiben“ kann. Seine Arbeitsweise sieht so aus: Er schlägt einen Lösungsvorschlag vor, führt das Experiment durch, wertet die Ergebnisse aus und erstellt auf Basis des Feedbacks den nächsten Vorschlag. Dieser Zyklus wiederholt sich stundenlang oder sogar über mehrere Tage.
Sie ließen denselben Agenten dieselbe Aufgabe acht Mal unabhängig voneinander ausführen. Eigentlich sollten die Ergebnisse ähnlich ausfallen, doch die endgültigen Punktzahlen reichten von 68,3 bis 100,0, mit einem Median von 81,9 – zwischen dem schlechtesten und besten Ergebnis klaffte eine Lücke von über 30 Punkten.
Noch enttäuschender ist: Mehr Rechenleistung hilft nichts. Wenn man den schlechter laufenden Versuchen zusätzliche große Rechenressourcen zuweist, drehen sie sich nur im Kreis und können den Abstand kaum schließen.
Warum passiert das? Das Team hat alle bei jedem Durchlauf erstellten Lösungen nach der „funktionalen Ähnlichkeit“ auf einer zweidimensionalen Karte dargestellt und festgestellt, dass die Lösungen jedes Durchlaufs in einem kleinen Bereich der Karte verharren und sich von Anfang an kaum bewegen. Sie haben diesen Bereich „Ideenbecken“ (idea basin) genannt. Alle acht Durchläufe sind in fünf verschiedene Ideenbecken geraten.
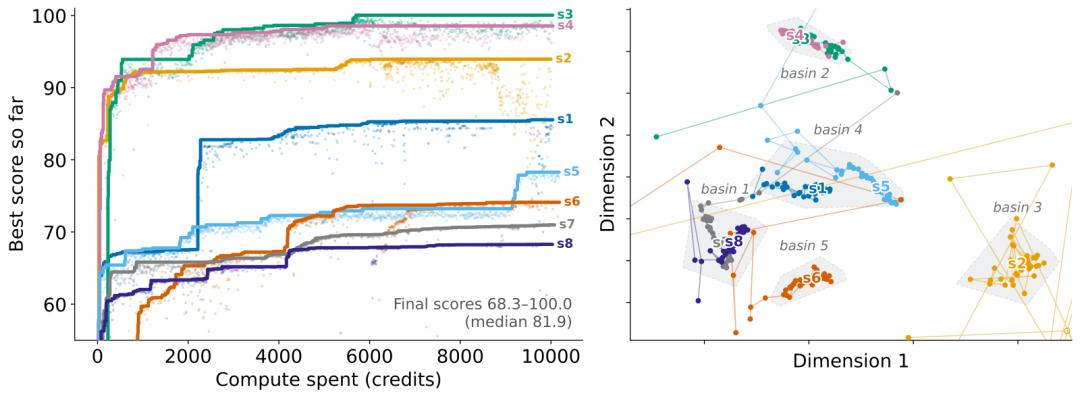
Derselbe Agent führt dieselbe Aufgabe acht Mal aus. Linkes Diagramm: Die Punktzahl ändert sich mit dem eingesetzten Rechenaufwand, die acht Durchläufe erreichen ihre Plateaus auf unterschiedlichen Höhen, die endgültigen Punktzahlen liegen zwischen 68,3 und 100,0. Rechtes Diagramm: Die nach funktionaler Ähnlichkeit dargestellte Lösungslandkarte zeigt, dass alle acht Durchläufe in fünf „Ideenbecken“ eindringen.
Das ist wie ein Renovierungsteam, das am ersten Tag den skandinavischen Stil festlegt und danach jedes gekaufte Möbelstück an diesem Stil ausrichtet. Selbst wenn der mediterrane Stil besser zur Wohnung passen würde, erinnern sie sich nicht mehr daran, weil ihr Handy voller Referenzbilder zum skandinavischen Stil ist. Der Chatverlauf ist genau diese Referenzbilder im Handy des Agenten.
Erwähnenswert ist, dass diese Agenten bereits über einen Mechanismus zur „automatischen Komprimierung des Chatverlaufs“ verfügen: Wenn das Gespräch zu lang wird, fassen sie es selbst zusammen und fahren dann fort. Praktische Tests zeigen aber, dass man allein mit komprimierten Zusammenfassungen nicht aus dem Ideenbecken herauskommt.
Microsofts Lösung: Leeren des Gedächtnisses
Die Methode heißt Fork-and-Flush, was grob als „Verzweigen und Leeren“ übersetzt werden kann und aus zwei Schritten besteht.
Verzweigen (Fork): Man kopiert den Agenten in mehrere parallele Zweige, wobei jeder Zweig den vollständigen „Arbeitsbereich“ erbt – also alle zuvor geschriebenen Codes, Dateien und Versuchsergebnisse, sodass keine der vorhandenen Ressourcen verloren geht.
Leeren (Flush): Der Chatverlauf jedes Zweigs wird auf Null zurückgesetzt. Alle Zweige sollen sich nicht mehr an früheren Überlegungen orientieren, sondern auf Basis der vorhandenen Inhalte neu überlegen, wie die Aufgabe zu lösen ist.
Nachdem die Zweige eine festgelegte Zeit lang gelaufen sind, vergleicht man ihre Punktzahlen: Nur der beste Zweig wird weitergeführt, die übrigen werden aufgelöst. Ein Satz in dem Papier trifft den Kern genau: Die neuen Zweige müssen ihre Absichten neu aus diesen Dateien ableiten – genau das ist der Grund, warum sie in ein anderes Ideenbecken gelangen können.
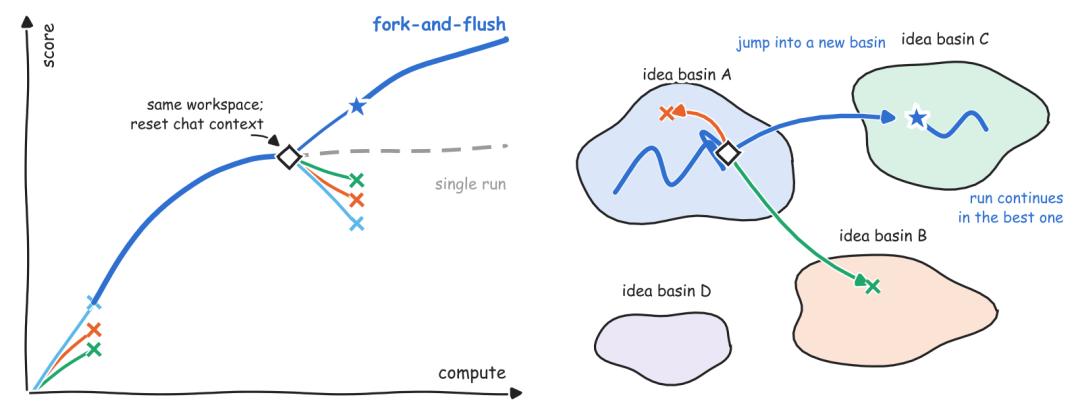
Schematische Darstellung von Fork-and-Flush. Linkes Diagramm: Nach dem Verzweigen starten alle Zweige mit demselben Arbeitsbereich und leerem Chatverlauf neu, der siegreiche Zweig entwickelt sich weiter nach oben. Rechtes Diagramm: Die geleerten Zweige haben die Chance, in ein anderes Ideenbecken zu springen, diejenigen, die nicht herauskommen, werden aufgelöst.
Die Forscher haben die Methode an 13 lang andauernden Aufgaben getestet, darunter Pentomino-Puzzles, Werkstattplanung, Kryptanalyse, Kompression von Bildklassifikatoren und Optimierung von VLIW-Kernen. Ein einzelner Durchlauf dauerte zwischen einigen Stunden und über hundert Stunden, als Modelle wurden GPT-5.6-terra und GPT-5.5 verwendet, die über das Kommandozeilentool von GitHub Copilot aufgerufen wurden.
Bei gleichem Rechenbudget ergaben sich folgende normalisierte Durchschnittspunktzahlen: Einzeldurchlauf 0,47, vier Durchläufe mit Auswahl des besten Ergebnisses 0,54, Fork-and-Flush 0,78. Umgerechnet auf die relative Verbesserung ist das ein Plus von 66,0 % gegenüber dem Einzeldurchlauf und 44,4 % gegenüber der Auswahl des besten von vier Ergebnissen. Bei 12 von 13 Aufgaben erzielte die Methode die höchste Durchschnittspunktzahl. Die Ergebnisse sind zudem stabiler: Die Standardabweichung sank von 0,26 auf 0,16.
Die Ablationsversuche sind ebenfalls aufschlussreich: Wenn man nur den Chatverlauf leert, ohne zu verzweigen, liegt die Verbesserung bei etwa 22 %; wenn man nur verzweigt, ohne zu leeren, gibt es ebenfalls eine Verbesserung – aber nur die Kombination beider Maßnahmen zeigt die volle Wirkung. Es scheint, dass „Vergessen“ und „mehrere Versuche“ jeweils einen eigenen Beitrag leisten.
Der dramatischste Fall ereignete sich bei der Puzzle-Aufgabe. Als 71 % des Budgets aufgebraucht waren, wurde der Leerungsvorgang ausgelöst, und der siegreiche Zweig legte bei seiner ersten Einreichung einen Sprung von 43 Einheiten zurück. Was bedeutet das? Ein einzeln laufender Agent kann in diesem Stadium maximal 4,4 Einheiten pro Schritt zurücklegen. Dieser Sprung führte direkt in ein völlig neues Ideenbecken, sodass am Ende eine Punktzahl von 93,9 erreicht wurde – während der Median von acht Einzeldurchläufen als Baseline nur 84,6 betrug. Die anderen drei Zweige, die nicht herausspringen konnten, legten pro Schritt nicht mehr als 1 Einheit zurück und verharrten an Ort und Stelle.
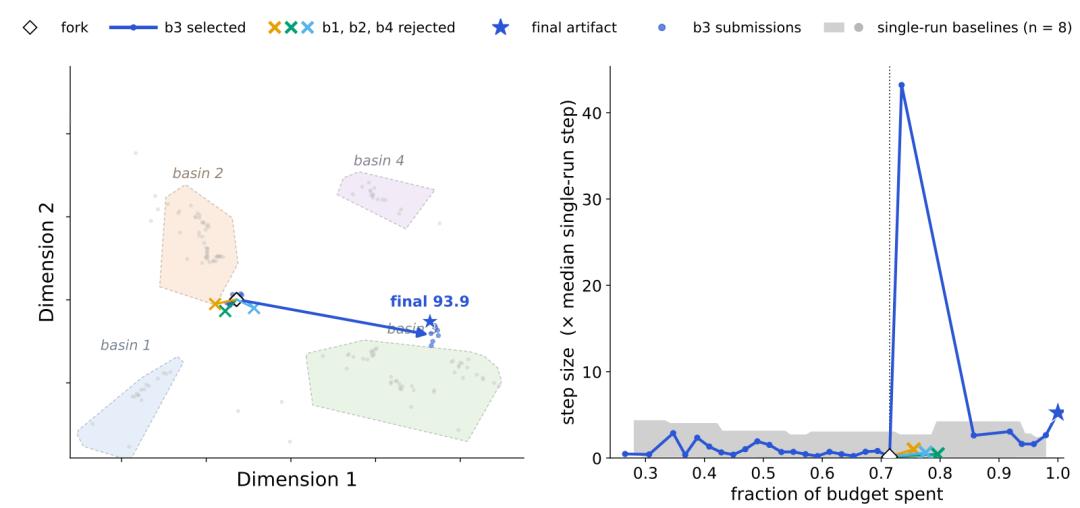
Der entscheidende Sprung bei der Puzzle-Aufgabe. Linkes Diagramm: Der blaue Pfeil zeigt den siegreichen b3-Zweig, der vom Verzweigungspunkt direkt in das neue Ideenbecken springt und am Ende 93,9 Punkte erreicht. Rechtes Diagramm: Nach dem Leeren legt er bei seinem ersten Schritt 43 Einheiten zurück und springt weit über den grauen Bereich hinaus, der die übliche Schrittweite von Einzeldurchläufen darstellt.
Selbst bei leistungsfähigeren Modellen kann dieses Problem bestehen
Man könnte meinen: Wenn die Modelle noch stärker werden, werden sie wahrscheinlich nicht mehr in Sackgassen geraten.
Das Team hat dies mit den drei Größen 4B, 9B und 27B von Qwen3.5 an Aufgaben wie MAX-3-SAT überprüft, deren Schwierigkeit sich genau regulieren lässt. Die Ergebnisse zeigen, dass die Unterschiede zwischen den Durchläufen einer umgekehrten U-Kurve folgen: Wenn die Aufgabe zu einfach ist, wird sie jedes Mal gelöst, und die Lösungen ähneln sich sehr. Wenn die Aufgabe zu schwer ist, schlägt sie jedes Mal fehl, und die Misserfolge ähneln sich ebenfalls. Der größte Unterschied liegt genau an der Grenze der Fähigkeiten des Modells, also etwa dort, wo es „die Hälfte der Aufgaben richtig lösen kann“. Der berechnete Spitzenwert liegt bei 0,497, also fast genau in der Mitte.
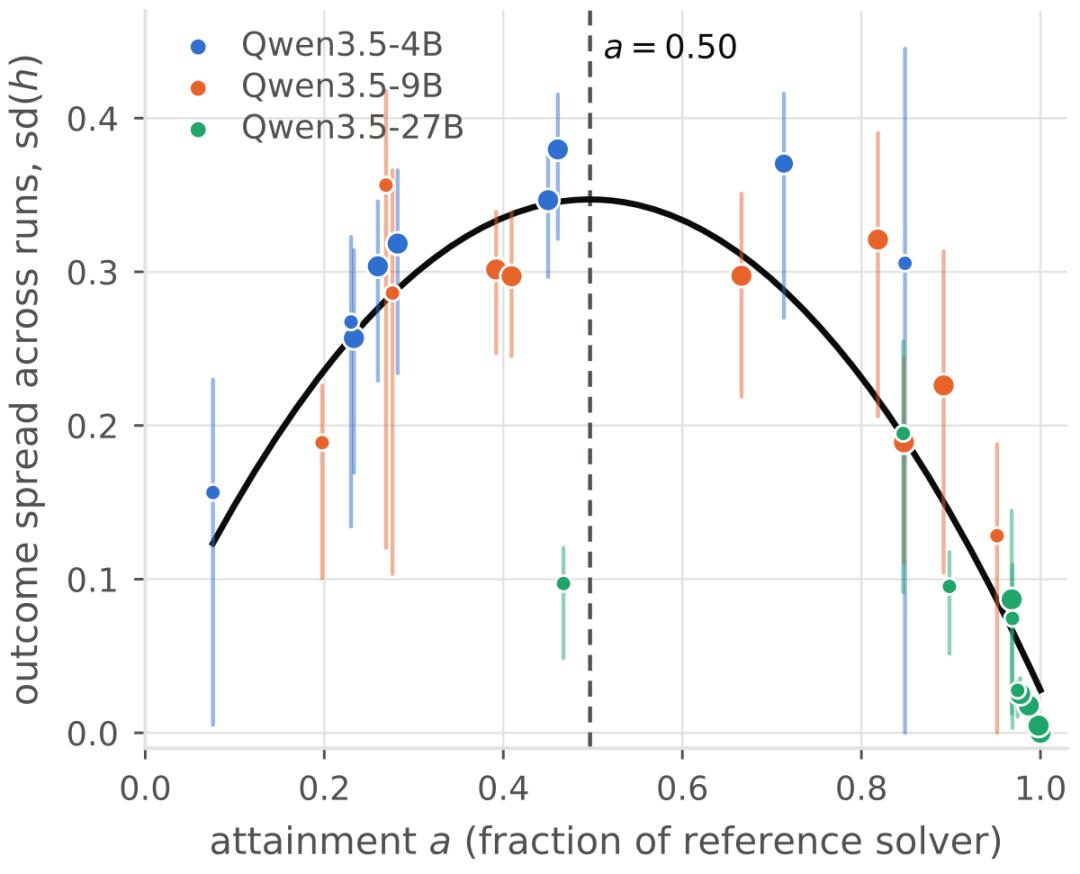
Die horizontale Achse gibt den Erfüllungsgrad des Modells im Vergleich zu einem Referenzlöser an, die vertikale Achse die Unterschiede zwischen mehreren Durchläufen. Die drei Größen von Qwen3.5 beschreiben dieselbe umgekehrte U-Kurve, deren Spitze bei einem Erfüllungsgrad von 0,5 liegt.
Offene Forschungsprobleme liegen per Definition genau an dieser Grenze der Fähigkeiten. Daher gehen die Autoren davon aus, dass dieses Phänomen auch bei weiter wachsenden Modellfähigkeiten nicht verschwinden wird – die Grenze wird sich lediglich zu schwierigeren Aufgaben verschieben. Die regelmäßige Zurücksetzung des Kontexts wird daher auch für zukünftige Spitzenmodelle noch wirksam sein.
Diese Forschung liefert eine direkte Erinnerung für Entwickler von Agent-Produkten: Die Standardannahme „Kontext ist ein Vermögenswert“ könnte hinterfragt werden. Wenn das angesammelte Gedächtnis einen bestimmten Punkt überschreitet, kann es die Erkundung im Gegenteil einschränken: Frühe Schlussfolgerungen verankern den Agenten auf einem nicht optimalen Weg.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Big Data Digest“ und wird von 36Kr mit Genehmigung veröffentlicht.