Der Schöpfer von Linux nutzt mittlerweile auch KI für die Kernel-Entwicklung. Er hatte einst spöttisch behauptet, KI sei „zu 90 % Marketing“, jetzt hat er mit Claude Code 8 Patches erstellt, und die Leistung ist um das Dreifache gestiegen.
„Früher dachte ich, KI sei nicht besonders gut, aber jetzt gefällt es mir wirklich sehr, sie zu nutzen.“ – Diese Aussage stammt nicht von einem jungen Programmierer, der gerade erst in die Branche einsteigt und sich leidenschaftlich für Vibe Coding begeistert, sondern von Linus Torvalds, dem Vater von Linux.
Kürzlich ist im Code-Repository des Linux-Kernels ein ungewöhnlicher Branch aufgetaucht: noref-filemap-read-with-llm.
Für Personen, die mit der Linux-Entwicklung vertraut sind, ist das Erscheinen eines neuen Branches im Code-Repository von Linus Torvalds, dem Vater von Linux, an sich schon bemerkenswert. Diesmal steht aber am Ende des Branchnamens direkt llm – Large Language Model (Großes Sprachmodell).
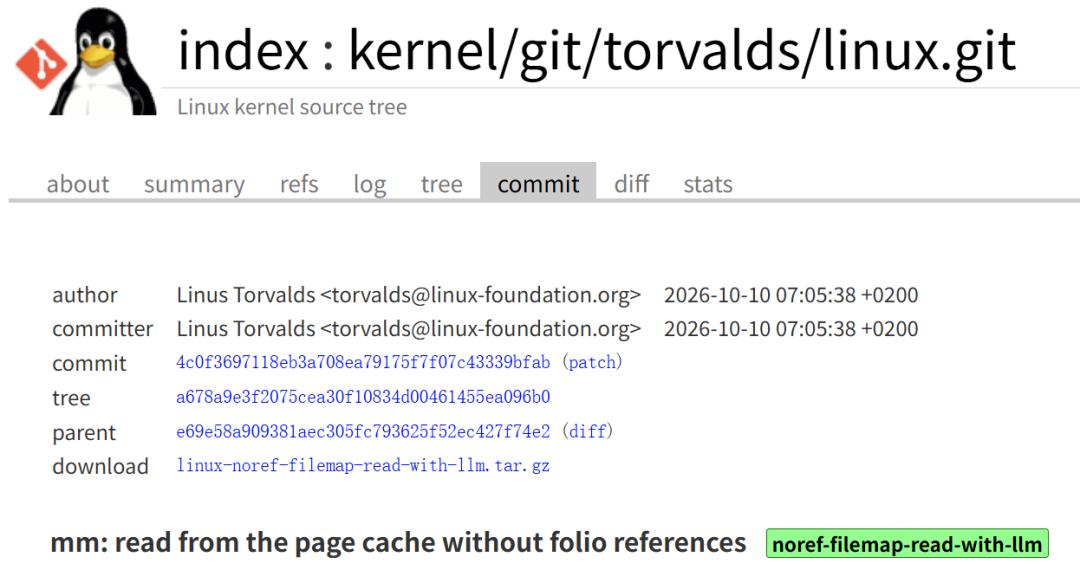
Am 10. Oktober reichte Linus Torvalds in seinem eigenen Linux-Kernel-Repository eine Änderung mit dem Titel „mm: read from the page cache without folio references“ ein. Der zugehörige Patch erregte schnell die Aufmerksamkeit der Entwickler-Community: Dieses experimentelle Paket mit 8 Patches zielt nicht nur auf ein seit langem bestehendes Leistungsengpass im Linux-Kernel ab, sondern macht auch die Beteiligung des KI-Programmierwerkzeugs Claude Code ausdrücklich öffentlich.
Interessanterweise sind die Testergebnisse dieses Patch-Pakets auch sehr beeindruckend: Bei einem spezifischen Dateilesetest mit 8 Threads stieg der Durchsatz von etwa 10 Millionen Lesevorgängen pro Sekunde auf maximal etwa 33 Millionen, was einer Steigerung von mehr als dem Dreifachen entspricht – aber man sollte nicht sofort annehmen, dass KI bereits in der Lage ist, Betriebssysteme selbstständig zu entwickeln. Der Patch befindet sich derzeit noch im experimentellen Stadium, und die Leistungssteigerung hat einen klar definierten Anwendungsbereich.
8 Patches zielen auf ein Problem ab, das Linux seit mehr als zwei Jahren plagt
Diese Optimierung zielt auf den Page Cache (Seitencache) von Linux ab.
Einfach ausgedrückt speichert Linux gelesene Dateidaten im Arbeitsspeicher zwischen. Wenn Programme später erneut auf diese Daten zugreifen, kann das Betriebssystem sie direkt aus dem Arbeitsspeicher lesen, wodurch der Aufwand für den Zugriff auf Speichergeräte reduziert wird. Wenn jedoch mehrere Threads gleichzeitig kleine Datenmengen aus derselben Datei lesen, kann im Seitencache ein unerwarteter Engpass auftreten: die Konkurrenz um Speicher-Referenzzähler.
Um sicherzustellen, dass Daten nicht vor ihrer Verwendung freigegeben werden, muss der Kernel die Speicherobjekte verfolgen, die die Dateidaten tragen – also das sogenannte folio. Der herkömmliche Lesepfad erhöht den Referenzzähler des folio und verringert ihn nach Abschluss des Lesevorgangs wieder. Das Problem liegt darin, dass diese Vorgänge atomare Anweisungen erfordern: Wenn mehrere Threads denselben Zähler wiederholt ändern, müssen die Prozessorkerne ständig die Konsistenz der Cache-Daten koordinieren, was zusätzlichen Aufwand verursacht.
Wenn die bei jedem Lesevorgang gelesene Datenmenge groß ist, ist dieser zusätzliche Aufwand möglicherweise nicht sehr auffällig. Wenn aber nur 16 Byte pro Mal gelesen werden, übersteigt der Aufwand für die Verwaltung des Referenzzählers die Kosten des eigentlichen Lesevorgangs bei weitem.
Dies ist kein kleines Problem, das Linus zufällig entdeckt hat. Bereits 2024 wies der Kernel-Entwickler Matthew Wilcox auf dieses Leistungsengpass hin – nur diesmal beschloss Linus, dieses Problem mit Hilfe von Claude Code zu lösen.
Mit KI-Unterstützung zur Code-Änderung: Die Leistung des Multithread-Lesevorgangs steigt direkt um das Dreifache
Um die Wirkung der Optimierung zu überprüfen, führte Linus Tests mit seinem eigenen Laptop durch:
Das Gerät ist mit einem Intel Core i7-8565U Prozessor ausgestattet, der 4 physische Kerne und 8 Threads hat. Wenn 8 Threads gleichzeitig 16-Byte-pread()-Leseanforderungen für dieselbe Dateiseite stellen, zeigen die Leistungsprofilergebnisse, dass 99,92 % der HITM-Ereignisse (Treffer in Cache-Zeilen im modifizierten Zustand), die mit der lastübergreifenden Auslastung zwischen Kernen zusammenhängen, sich auf die zugehörigen gemeinsam genutzten Cache-Zeilen konzentrieren.
Das bedeutet, dass der große Koordinierungsaufwand zwischen den Kernen im Test mit dieser gemeinsam genutzten Cache-Zeile zusammenhängt.
Für dieses Problem haben Linus und Claude Code einen anderen Ansatz ausprobiert – der Schlüssel der neuen Lösung liegt darin, mit Hilfe des RCU-Mechanismus (Read-Copy-Update, Lesen-Kopieren-Aktualisieren) anzupassen, wann der Kernel den Speicher wiederverwenden darf, der aus dem Seitencache entfernt wurde.
Bisher musste der Lesepfad häufig die Referenz auf das folio abrufen und freigeben. Die neue Lösung erlaubt es, den zugehörigen Speicher verzögert an den Allokator zurückzugeben, bis die RCU-Gnadenfrist abgelaufen ist. Auf diese Weise kann der Lesethread im Codebereich, der durch die RCU-Lesseite geschützt ist, Daten direkt in den Puffer des Benutzerraums kopieren, ohne den gemeinsam genutzten Referenzzähler wiederholt aktualisieren zu müssen.
Im Klartext bedeutet das, dass der Prozess, bei dem mehrere Threads sich wiederholt um denselben Zähler streiten, so weit wie möglich umgangen wird, um unnötigen Koordinierungsaufwand zu reduzieren. Bei dieser Optimierung zeigen die Testdaten deutliche Unterschiede:
Im Szenario mit gleichzeitigem Lesen durch 8 Threads stieg der Durchsatz von etwa 9,9 bis 10,4 Millionen Lesevorgängen pro Sekunde auf etwa 30 bis 33 Millionen Lesevorgänge.
Die Anzahl der Kernel-CPU-Zyklen, die für jeden Lesevorgang benötigt werden, sank von etwa 2950 auf 725.
Im Single-Thread-Szenario ist der Nutzen nicht so ausgeprägt: Die Anzahl der benötigten CPU-Zyklen pro Lesevorgang sank von etwa 452 bis 454 auf 408 bis 409.
Aus diesen Daten geht hervor, dass der Leistungsvorteil hauptsächlich in Szenarien mit gleichzeitigem Lesen durch mehrere Threads liegt. Da der größte ursprüngliche Aufwand aus der Konkurrenz mehrerer Threads um gemeinsam genutzte Cache-Zeilen stammt, ist die Verbesserung im gleichzeitigen Szenario natürlich deutlicher. Linus wies in der Commit-Beschreibung außerdem darauf hin, dass bei Maschinen mit mehr CPU-Kernen oder einer Multi-Socket-Architektur theoretisch noch größere Vorteile erzielt werden können.
Außerdem bedeutet „Leistungssteigerung um das Dreifache“ nicht, dass die Gesamtlaufgeschwindigkeit von Linux um das Dreifache gestiegen ist. Dies ist nur das Testergebnis unter spezifischer Hardware, Dateisystem und Last mit kleinen Leseeinheiten.
Nicht nur Code schreiben – Claude Code ist auch an Tests und Prüfmaterialien beteiligt
Verglichen mit den Leistungswerten interessiert die Entwickler tatsächlich mehr die öffentliche Erklärung von Linus zur Beteiligung von KI an der Entwicklung. Er schrieb im Git-Commit:
„Der oben genannte Code, die Testprogramme, die Prüfungen zu den zugehörigen Inhalten und der erste Entwurf dieser Beschreibung wurden alle unter meiner Anleitung mit Hilfe von Claude Code, einem Programmierassistenten für große Sprachmodelle, erstellt.“
Das bedeutet, dass Claude Code nicht nur an der Generierung einiger weniger Codezeilen beteiligt war, sondern mehrere Phasen abdeckt: Implementierungslösung, Testprogramm, Prüfmaterialien und erster Entwurf der Commit-Dokumentation. Das bedeutet aber nicht, dass Linus die gesamte Entwicklungsaufgabe der KI überlassen und sich dann nicht mehr darum gekümmert hat: Die zugehörigen Tests müssen ausgeführt werden, die Leistungsdaten müssen überprüft werden, und Probleme im Code müssen weiter geprüft werden.
Tatsächlich weist dieses Patch-Paket noch offensichtliche ungelöste Probleme auf:
Erstens bedeutet die verzögerte Wiederverwendung von Speicher, dass einige Speicherseiten warten müssen, bis die RCU-Gnadenfrist abgelaufen ist, bevor sie wiederverwendet werden können, was den Druck auf die Speicherfreigabe erhöhen kann. Linus selbst gibt zu, dass die Speicherfreigabe der am schlechtesten gelöste Teil des gesamten Patch-Pakets ist.
Zweitens löst der neue Pfad einen zusätzlichen fehlgeschlagenen Ausnahmebehandlungsvorgang aus, wenn das Lesenziel eine Seite ist, die noch nicht in den Benutzerraum abgebildet wurde, bevor er auf die ursprüngliche Implementierung zurückfällt. In zugehörigen Tests kann dieser Fall sogar zu einer deutlichen Leistungsabnahme führen.
Daher kann dieses Patch-Paket zwar in bestimmten Szenarien erhebliche Vorteile erzielen, gilt aber noch nicht als abgeschlossene Optimierung. Bislang verbleiben diese Patches im experimentellen Branch und wurden noch nicht in den Linux-Hauptzweig aufgenommen. Ob sie letztendlich akzeptiert werden, erfordert weitere Prüfungen und Validierungen.
Von der Skepsis gegenüber KI („90 % davon ist Marketing“) zum selbstständigen Einsatz von KI zum Schreiben von Kernel-Code
Dass dieser Commit so viel Aufmerksamkeit erregt, liegt auch daran, dass die Person, die Claude Code verwendet hat, Linus Torvalds ist.
Wenn man die letzten Jahre zurückblickt, hat sich Linus' Einstellung zur KI deutlich verändert:
Ende 2024 kritisierte er die KI-Branche scharf und behauptete, „90 % davon sei Marketing“. Zu dieser Zeit war seine Einstellung zur KI relativ vorsichtig, und er konzentrierte sich mehr darauf, ob KI Entwicklern helfen kann, Fehler zu finden, anstatt direkt wichtigen Softwarecode zu schreiben.
Ende 2025 begann er, den Wert von KI bei der Codepflege, der Patch-Prüfung und anderen Aspekten anzuerkennen.
Im Januar dieses Jahres probierte er die KI-gestützte Programmierung in seinem Freizeitprojekt aus und schrieb Code für ein Python-Audio-Visualisierungstool.
Letzte Woche sagte er in einem Gespräch mit seinem Freund Dirk Hohndel auf dem European Open Source Summit, dass er von der früheren Ansicht, KI sei „nicht besonders gut“, zu der Überzeugung gelangt ist, „es wirklich sehr zu genießen, KI zu nutzen“. Er erwähnte außerdem, dass KI Entwicklern helfen kann, Arbeiten zu erledigen, in denen sie nicht besonders gut sind. Er wies aber auch darauf hin, dass man bei wirklich wichtigen Softwareentwicklungen bei der Nutzung von KI besonders vorsichtig sein muss.
Heute verkörpern diese Kernel-Patches Linus' neue Einstellung konkret: KI ist nicht mehr nur ein Werkzeug zur Unterstützung bei der Fehlersuche und Patch-Prüfung, sondern beginnt auch an der Implementierung neuen Codes im Linux-Kernel teilzunehmen.
Darüber hinaus hat Linus vor kurzem auch mit Hilfe von LLM einen weiteren alten, schwer verständlichen Kernel-Code aufgeräumt: Bei der zugehörigen Aufräumarbeit des assoc_array-Codes half ihm die KI dabei, komplexe Funktionen zu zerlegen und Benutzertests vorzubereiten, wobei letztendlich 3 Fehler gefunden wurden, die bis ins Jahr 2013 zurückverfolgt werden können.
Obwohl alte Fehler gefunden oder die Seitencache-Leseleistung optimiert werden, hängt alles letztendlich von Tests und manuellen Prüfungen ab. Denn für grundlegende Software wie Linux ist die Funktionsfähigkeit des Codes nur der erste Schritt. Ob er korrekt ist, keine Regressionen einführt und für unterschiedliche Hardware und Arbeitslasten geeignet ist, muss alles validiert werden.
Referenzlinks:
https://www.zdnet.com/innovation/linus-torvalds-uses-ai-to-write-linux-kernel-patch/
https://www.zdnet.com/tech/linus-torvalds-ai-coding-programming/
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „CSDN“, Autor: ZHENG Liyuan, veröffentlicht mit Genehmigung von 36Kr.