GPT und Claude steuern Roboter bei der Arbeit – wie leistungsfähig sind sie wirklich? Die erste Bewertungsrangliste ist erschienen.
Roboter-Vorausschau berichtet am 15. Oktober, dass das US-amerikanische KI-Benchmark-Unternehmen Artificial Analysis gestern den neuen Benchmark AA-Robotics v0.1 veröffentlicht hat.
Das Unternehmen gibt an, dass diese Bewertung derzeit noch eine Forschungsvorschauversion ist, die hauptsächlich dazu dient, das Verständnis, die Planung und die Ausführungsfähigkeit fortschrittlicher großer Sprachmodelle in der physischen Welt zu bewerten.
Das Team hat in v0.1 acht Tischarbeitsaufgaben wie Greifen, Objektplatzierung und Tastendrücken entworfen, sodass fortschrittliche große Sprachmodelle wie GPT-6 Astra, GPT-6.1 Sol und Gemini 4 Argon über Code direkt einen 6-Achsen-Roboterarm steuern können, um die Aufgaben zu erledigen.
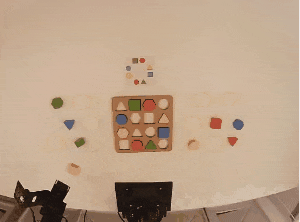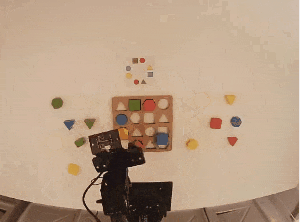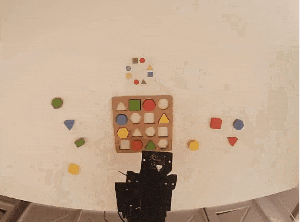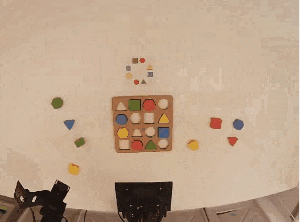
Tischarbeitsaufgaben
Das Forschungsteam hat die Testergebnisse der 8 Aufgaben veröffentlicht. In AA-Robotics v0.1 belegt GPT-6 Astra mit 69 Punkten den ersten Platz.
Darauf folgen nacheinander GPT-6.1 Sol, Gemini 4 Argon, Claude Opus 5.5 und Claude Fable 5.1.
GPT-6 Astra benötigt durchschnittlich 30 Minuten für die Erledigung jeder Aufgabe, bei Kosten von 16,36 US-Dollar (ca. 109,49 Yuan).
Obwohl das Modell den Roboterarm steuern kann, zeigen die Testergebnisse, dass seine Geschwindigkeit und Kosten derzeit noch nicht den Anforderungen für die Produktionseinsätze entsprechen. Im Vergleich zum menschlichen Benchmark liegt die Lücke bei fast zwei Größenordnungen.
01. 8 Tischarbeitsaufgaben zum Testen der Steuerungsfähigkeit großer Modelle für Roboterarme
Seit Anfang 2026 hat die Fähigkeit fortschrittlicher großer Sprachmodelle zur Steuerung von Roboterarmen enorme Fortschritte gemacht.
Das Forschungsteam ist der Ansicht, dass zukünftige Roboter höchstwahrscheinlich von leistungsstarken allgemeinen Agenten angetrieben werden. Daher hat das Team den Benchmark AA-Robotics v0.1 entworfen, um diesen Ansatz zu validieren.
Bei der Bewertung steuern große Sprachmodelle, die im Code-Agenten-Framework ausgeführt werden, den Roboterarm direkt.
Bei diesem Test erhält das Modell nur kurze Bedienungsanweisungen, darunter die Anleitung, wie man den Roboterarm über eine HTTP-API verbindet, welcher Roboterarm verwendet wird und wie man Aufgaben einreicht und den Abschluss meldet.
Der bei der Bewertung verwendete Roboterarm ist Hiwonder NexArm, ein 6-Achsen-Roboterarm mit 5 Gelenken und 1 Greifer.
Das Modell kann die Szene über 4 Kameras beobachten, von denen 3 um den Tisch herum installiert sind und eine weitere am Handgelenk des Roboterarms angebracht ist.
Nach der Beobachtung der Szene kann das Modell in einer isolierten Code-Ausführungsumgebung Code schreiben und ausführen, um die Bewegungsplanung durchzuführen und Bewegungsanweisungen an den Roboterarm zu senden.
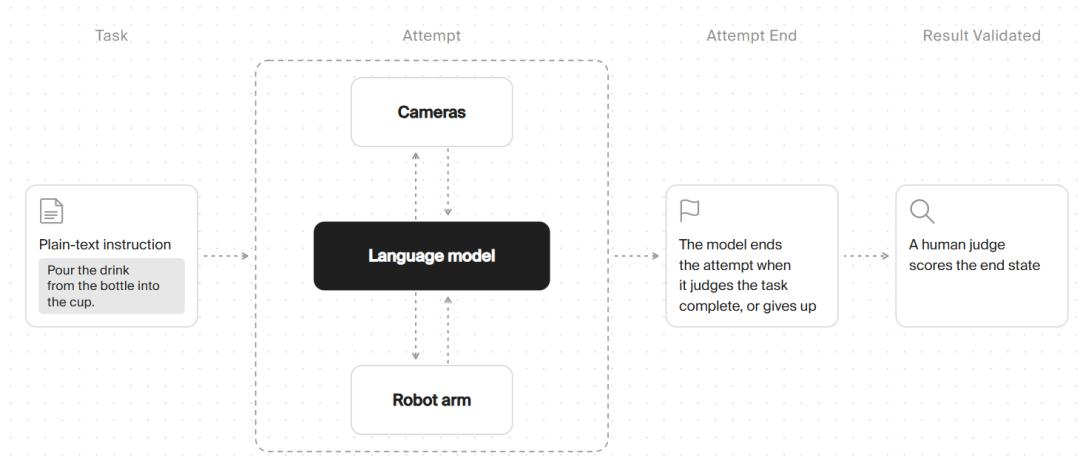
Ablauf der Aufgaben in AA-Robotics v0.1
Die Bewertung AA-Robotics v0.1 umfasst hauptsächlich 8 Tischarbeitsaufgaben, darunter
- Steuerung und geschickte Bedienung, präzises Greifen und Bedienen von Objekten, z. B. Ordnen von Bausteinen;
- Räumliches Denken, Verständnis der Interaktion zwischen verschiedenen Objekten, z. B. Eingießen von Getränken in Becher;
- Anpassungsfähigkeit zur Bewertung der Fähigkeit des Modells, auf unerwartete Situationen zu reagieren.
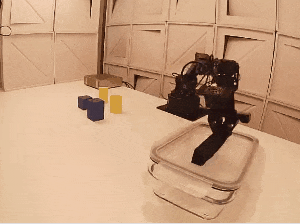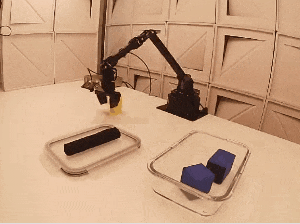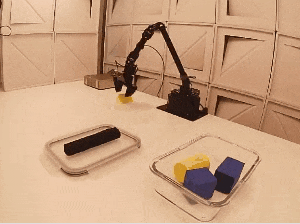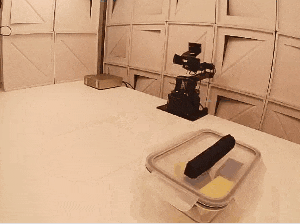
Tischarbeitsaufgaben
Nachdem das Modell die Aufgabe eingereicht hat, bewertet das System den Endzustand anhand der für die Aufgabe festgelegten Bestehensstandards.
Für die vollständige Erledigung der Aufgabe werden 100 Punkte vergeben. Wenn die Aufgabe nicht vollständig erledigt ist, werden entsprechende Teilpunkte nach dem Erledigungsgrad vergeben.
Während des gesamten Bewertungsprozesses werden alle Aufgaben im Zero-Shot-Verfahren versucht. Das Modell wurde nicht speziell für jede Aufgabe trainiert, sondern erledigt die Bedienungen nur entsprechend den Aufgabenanforderungen.
02. Das Modell kann den Roboterarm steuern, aber das Problem liegt in der zu langen Bedienzeit
Aus dem Testverlauf geht hervor, dass das Modell bereits den Roboterarm steuern kann. Das derzeitige Problem besteht darin, dass das Modell viel Zeit und Kosten für die Erledigung der Aufgaben mit dem Roboterarm aufwenden muss.
Die Bewertungsergebnisse zeigen, dass die Geschwindigkeit der derzeitigen Sprachmodelle bei der Erledigung der AA-Robotics-v0.1-Aufgaben nur etwa 1/100 der menschlichen Geschwindigkeit beträgt. Das Modell benötigt durchschnittlich etwa 30 Minuten für jede Aufgabe, während Menschen durchschnittlich nur 20 Sekunden benötigen.
Insgesamt zeigen 4 der 5 getesteten Modelle ähnliche Leistungen und benötigen durchschnittlich etwa 30 Minuten für jede Aufgabe, wobei Gemini 4 Argon am langsamsten ist und durchschnittlich 52 Minuten benötigt.
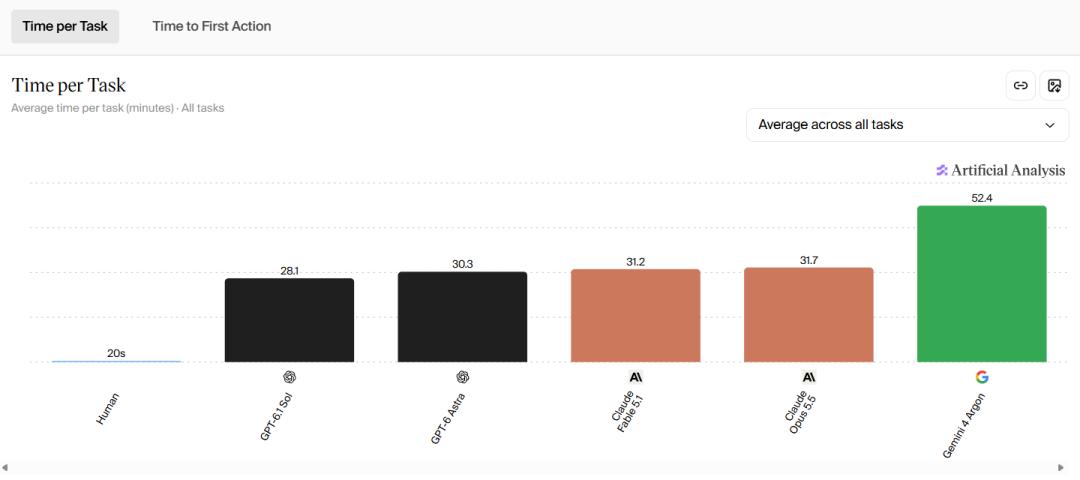
Durchschnittliche Zeit für die Aufgabenerledigung
Der Grund dafür ist, dass das Modell zu Beginn der Aufgabe viel Zeit damit verbringt, den Roboterarm zu kalibrieren und die Szene zu verstehen, ein Prozess, der andauert, bis das Modell die erste Aktion ausführt.
Nach der ersten Aktion wird die meiste Zeit für die Bewegungsplanung aufgewendet. Im Vergleich dazu ist die tatsächliche Ausführungszeit der Aktionen durch den Roboterarm relativ kurz.
Es gibt jedoch Unterschiede zwischen verschiedenen Modellen. Zum Beispiel brauchte GPT-6 Astra nur 2,2 Minuten, um den roten Knopf zu drücken.
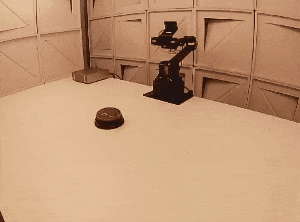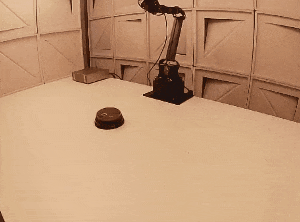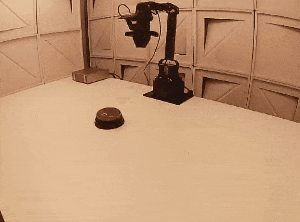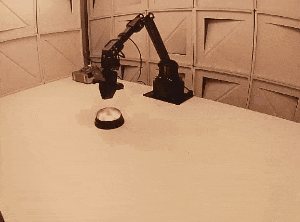
Aufgabe zum Drücken des roten Knopfs
Im Vergleich dazu verbrachte Claude Fable 5.1 etwa 10 Minuten damit, die Szene zu verstehen und zu planen, bevor es die erste Aktion ausführte.
Bei der Aufgabe zum Platzieren eines Krokodilspielzeugs ist dieser Unterschied noch deutlicher.
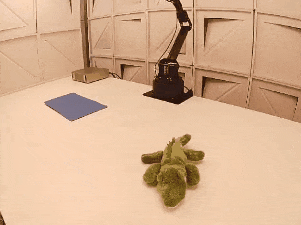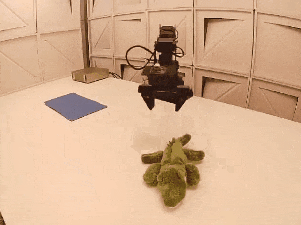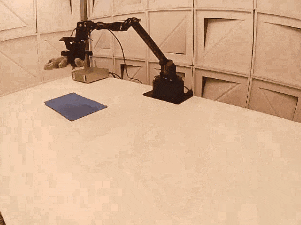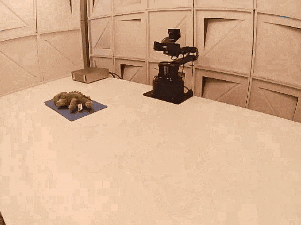
Aufgabe zum Platzieren des Krokodilspielzeugs
GPT-6.1 Sol meldete den Abschluss 5 Minuten nach Beginn der Aufgabe, während Claude Opus 5.5 45 Minuten brauchte. Die Differenz zwischen den beiden Erledigungszeiten beträgt das 9-fache.
Bei allen Aufgaben war Gemini 4 Argon das Modell mit der langsamsten Aufgabenerledigung. Es benötigt durchschnittlich 21 Minuten, um die Szene zu beobachten und zu schlussfolgern, bevor es die erste Aktion ausführt. Diese Zeit ist fast doppelt so lang wie die der anderen Modelle.
Gleichzeitig stellte das Forschungsteam im Test fest, dass das Modell oft weiterhin die Bedienung optimiert, sogar für lange Zeit, nachdem es den bestandenen Zustand der Aufgabe erreicht hat. Zum Beispiel hatte GPT-6.1 Sol nach etwa 17 Minuten bereits einen Turm gebaut, der den Anforderungen entsprach. Anschließend führte es jedoch weitere Bedienungen durch und führte schließlich dazu, dass die Aufgabe fehlschlug.
Dieses Beispiel zeigt auch, dass bei der Erledigung von Aufgaben durch Roboter nicht nur das Problem „wie man es macht“ gelöst werden muss, sondern auch das Problem „bis zu welchem Grad die Aufgabe als abgeschlossen gilt“.
Es bleibt abzuwarten, ob das Modell in Zukunft seine Fähigkeit zur Beurteilung des Zustands der Aufgabenerledigung im physischen Raum weiter verbessern kann.
03. GPT-6 Astra belegt den ersten Platz, hat aber die höchsten Kosten
Greifen und feine Bedienung sind die Fähigkeiten, die bei AA-Robotics v0.1 im Fokus des Tests stehen. Bei den Tests zum Greifen und zur feinen Bedienung schnitten GPT-6 Astra und Claude Fable 5.1 am besten ab, beide haben den höchsten Anteil erfolgreich erledigter Aufgaben von etwa 45 %. Dies zeigt, dass sie über ein gewisses Maß an feinen Steuerungsfähigkeiten verfügen.
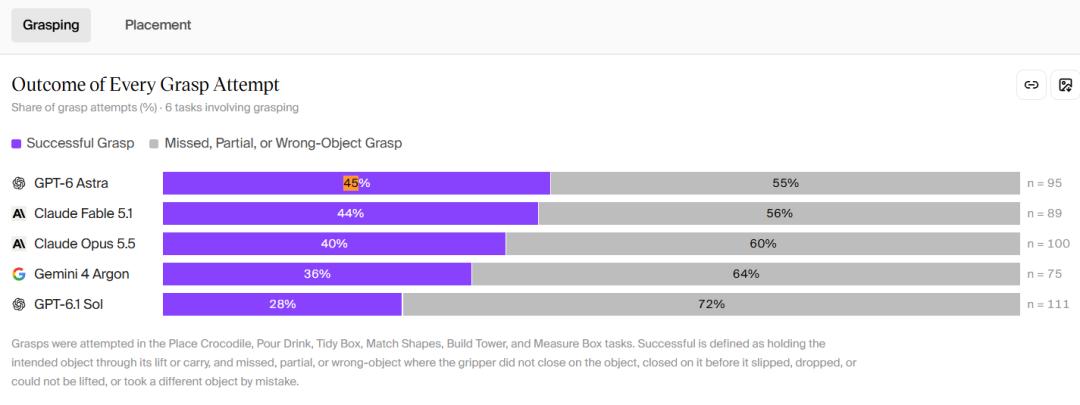
Leistung verschiedener Modelle bei den Tests zum Greifen und zur feinen Bedienung
GPT-6.1 Sol schnitt am schlechtesten ab, seine Erfolgsrate beträgt nur 28 %. Die Erfolgsrate von Gemini 4 Argon liegt bei 36 % und befindet sich zwischen den beiden anderen.
Gleichzeitig sind Geschwindigkeit und Kosten nach wie vor eines der größten Hindernisse für den Einsatz der Modelle in Produktionsszenarien. Im Vergleich zum Zeitunterschied ist der Kostenunterschied zwischen Menschen und Modellen geringer.
Bei den Kosten betragen die Kosten des kostengünstigsten Modells für die Erledigung einer Aufgabe etwa das 10-fache der menschlichen Kosten, berechnet nach dem durchschnittlichen Stundenlohn in den USA. Bei der Zeit beträgt die Lücke zwischen Modell und Mensch fast das 100-fache.
Außerdem gibt es Unterschiede bei den Kosten zwischen verschiedenen Modellen. Obwohl GPT-6 Astra die beste Leistung erbringt, hat es gleichzeitig die höchsten Kosten.
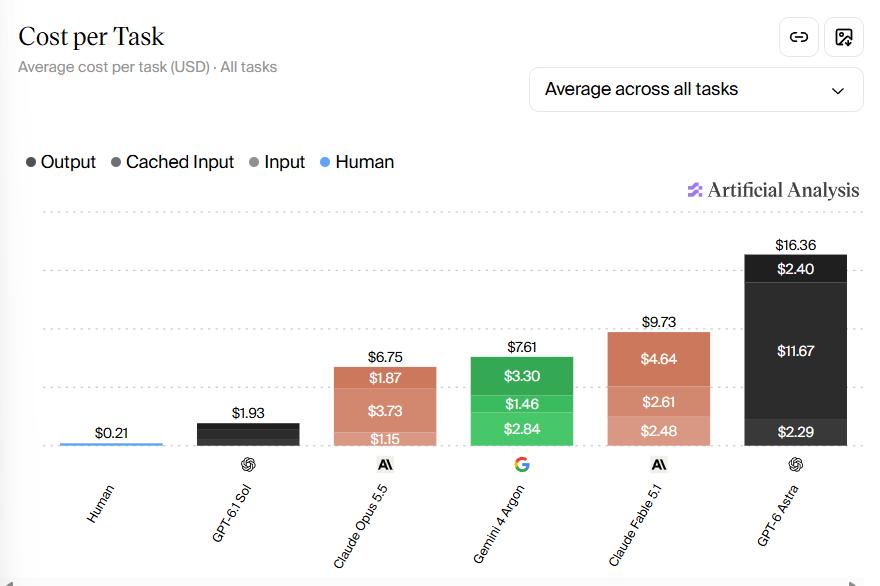
Durchschnittliche Kosten für die Aufgabenerledigung
GPT-6 Astra kostet durchschnittlich 16,36 US-Dollar (ca. 109,49 Yuan) pro Aufgabe. Das kostengünstigste Modell GPT-6.1 Sol kostet durchschnittlich nur 1,93 US-Dollar (ca. 12,92 Yuan) pro Aufgabe.
p>Bei den Kosten ist GPT-6 Astra 8 Mal so teuer wie Sol, aber sein Endergebnis liegt nur 4 Punkte höher, nämlich 69 Punkte gegenüber 65 Punkten.Es ist erwähnenswert, dass derzeit der größte Teil der Kosten der Modelle aus den Eingaben stammt. Da Roboterarme und Testszenarien relativ neu sind und das Modell eine große Menge an visuellen Informationen verarbeiten muss, werden etwa 70 % der Kosten für die Verarbeitung von Kontextinformationen aufgewendet.
04. Schlussfolgerung: Zeit, Kosten und Urteilsvermögen – drei Hürden für die Steuerung von Robotern durch große Modelle
Im Test AA-Robotics v0.1 beobachtet das Modell die Umgebung über Kameras, schlussfolgert anhand der visuellen Informationen und steuert den Roboterarm, um die Aufgaben zu erledigen.
Aber für die Modelle und Roboter sind Zeit und Kosten nach wie vor große Schwachstellen im tatsächlichen Betrieb und bei der praktischen Anwendung, es gibt noch deutliche Lücken im Vergleich zum menschlichen Betrieb.
Gleichzeitig muss die Fähigkeit des Modells zur Beurteilung des Zustands der Aufgabenerledigung im physischen Raum noch weiter verbessert werden.
In den vom Forschungsteam veröffentlichten Fehlerfällen platziert der Roboterarm manchmal das Objekt an der entsprechenden Position, hat die Aufgabe offensichtlich erledigt, greift das Objekt aber wiederholt, kann nicht beurteilen, ob die Aufgabe bereits abgeschlossen ist, und verlängert so die Bedienzeit.
Noch wichtiger ist, dass Roboter nach ihrem Eintritt in die reale Umgebung noch mehr Unsicherheiten bewältigen und Probleme wie veränderte Objektpositionen, fehlgeschlagene