Wurde die Erklärbarkeit neuronaler Netze durch KI gelöst? 90 % der Neuronen haben nur eine einzige Funktion
Dies ist eines der wichtigsten Ergebnisse im Bereich der KI.
Diesen Freitag hat ein extrem langer Artikel von Nick Cammarata, dem Gründer des Erklärbarkeits-Teams von OpenAI, die gesamte KI-Szene erschüttert. Er erklärt, dass mit modernen Agenturwerkzeugen selbst große Modelle mit Billionen von Parametern fast vollständig lesbar sind. Unsere bisherige Sicht auf das „schwarze Kasten“ der neuronalen Netze hat sich als Missverständnis erwiesen: Die erwarteten Hindernisse existieren größtenteils nicht, die Erklärbarkeit wird gelöst werden – und das möglicherweise sehr bald.
Das könnte die „bittere Lektion“ der Erklärbarkeit sein: Einfache Dinge funktionieren bei absurden Größenordnungen einfach.
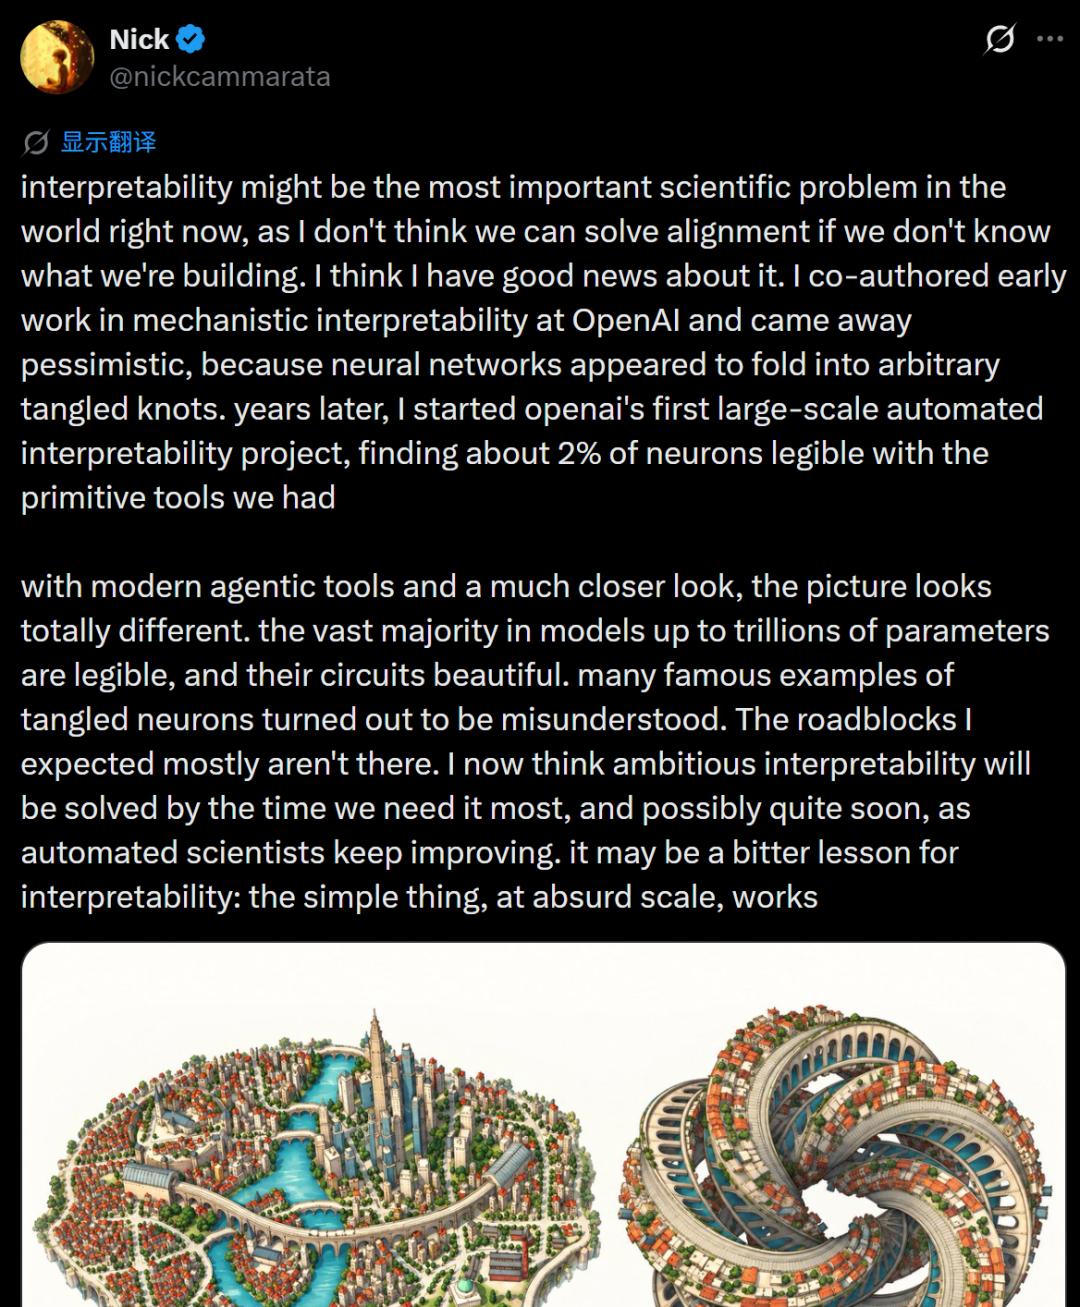
Wir können leistungsstarke KI trainieren, wissen aber nicht unbedingt, warum sie so antwortet. Wenn wir die KI bitten, die „Gehirnschaltkreise“ neuronaler Netze zu untersuchen, können wir diesen schwarzen Kasten öffnen? Die Antwort scheint ja zu lauten.
Nicks Artikel ist zwar extrem lang (die Lektüre dauert 65 Minuten), aber einige Forscher haben ihn bereits interpretiert. Kurz gesagt: Neuronale Netze sind keine verwickelten Knoten (die Annahme der Mehrdeutigkeit ist falsch). Man kann ihre eigenen Neuronen direkt untersuchen, ohne sie zuerst mit einem zweiten Modell „entwirren“ zu müssen. 90 % der Neuronen in Qwen-32B haben nur eine einzige Aufgabe.
Diese Arbeit könnte uns letztendlich dazu befähigen, große Sprachmodelle bewusst zu entwerfen und ihr Verhalten zu formen.
Sehen wir uns an, was er im Großen und Ganzen sagt:
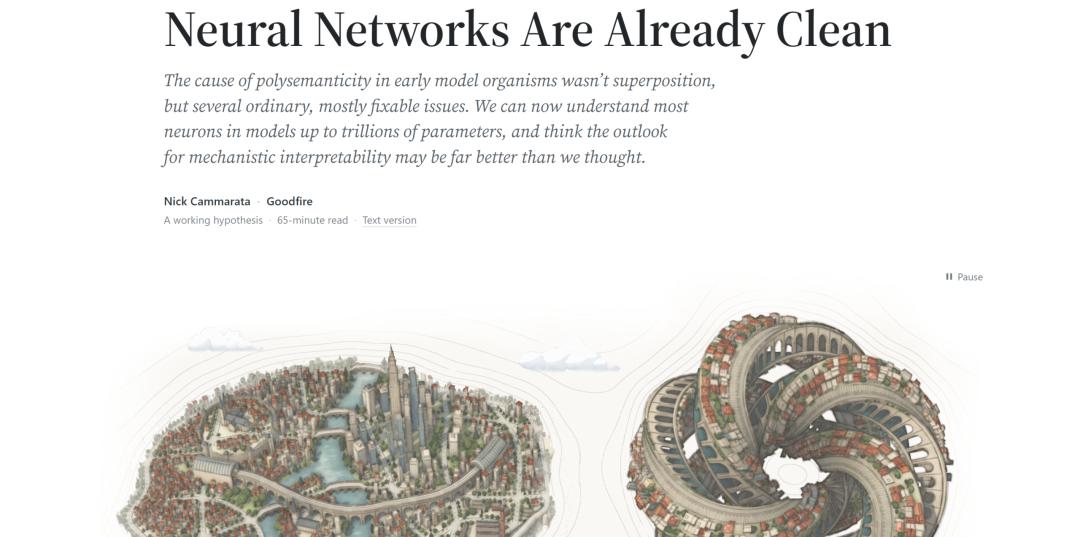
In den letzten Jahren gab es im Bereich der KI-Erklärbarkeit eine frustrierende Prämisse: Neuronale Netze seien ein Knäuel aus fest verknoteten Fäden. Wenn die Anzahl der Neuronen nicht ausreicht, falten die Modelle völlig unzusammenhängende Konzepte in dasselbe Neuron, da sie sich zufällig nicht gegenseitig stören. Um es zu lesen, muss man zuerst ein zweites Modell (z. B. einen Sparse Autoencoder SAE) trainieren, um die Knoten zu lösen. Diese als Superposition bezeichnete Hypothese ist die Grundlage der gesamten Sicherheitsforschungslinie.
Und jetzt tritt der Mensch, der dieses Fundament selbst gelegt hat, vor und sagt: Wir haben uns getäuscht, die neuronalen Netze waren von Anfang an sauber strukturiert.
„Katze und Auto“ – vielleicht waren sie schon immer ein und dasselbe
Die mechanistische Erklärbarkeit versucht, Neuronen und Rechenschaltkreise zu verfolgen, um zu erklären, wie das Modell zu seinen Ergebnissen gelangt. Eine der Schwierigkeiten besteht darin, dass ein einzelnes Neuron oft auf Dinge reagiert, die scheinbar keinen Zusammenhang zueinander haben. Ein klassisches Beispiel stammt vom visuellen Modell InceptionV1: Derselbe Neuron erkennt sowohl Katzen Gesichter als auch die Frontpartien von Autos.
Eine wichtige Erklärung in der Vergangenheit lautete „Superposition“: Der Platz im Modell ist begrenzt, also presst es unzusammenhängende Konzepte, die selten gleichzeitig auftreten, in dieselbe Gruppe von Neuronen. Forscher versuchten daher mit Werkzeugen wie Sparse Autoencodern, diese Darstellungen wieder in verständliche Merkmale aufzuteilen.
Nick ist heute der Ansicht, dass dieses berühmte Beispiel falsch interpretiert wurde.
Nach erneuter Prüfung der Bilder und Verbindungen stellte er fest, dass Katzen Gesichter und Autofronten ein gemeinsames Merkmal teilen: die V-Form. Dieses Neuron steht auch im Zusammenhang mit V-förmigen Flammen, Fuchsköpfen und anderem, während Kreisformen es zu einer negativen Reaktion veranlassen. Mit anderen Worten: „Katze und Auto“ sind Kategorien, die von Menschen festgelegt wurden, während das Netzwerk möglicherweise Formregeln gefunden hat, die diese Kategorien überspannen.
Er weist darauf hin: Neuronen verhalten sich nicht unbedingt wie Substantive, die Objekte mit Etiketten versehen; sie können auch wie Verben wirken, die Muster unterscheiden und Informationen an verschiedene nachgeschaltete Schaltkreise weiterleiten.
Die von uns wahrgenommene Unordnung ist manchmal nur darauf zurückzuführen, dass das Modell eine Klassifizierung verwendet, die wir nicht erwartet haben.
Die Wahrheit über Mehrdeutigkeit: Verzweigung wie Äste eines Baumes
Einige andere Neuronen haben tatsächlich mehrere Verwendungszwecke, aber der Autor ist der Ansicht, dass dies nicht unbedingt auf die willkürliche Mischung unzusammenhängender Konzepte zurückzuführen ist.
Nick schlägt das Konzept der „rekursiven Verallgemeinerung“ (recursive generalization) vor: Neuronen gehen von einem Muster aus, bilden allmählich verwandte Verzweigungen aus, die sich wiederum weiterentwickeln. Ein Neuron, das „iy“ erkennt, kann sich auf „diy“ ausweiten und dann weiter auf „do it yourself“, das überhaupt kein „iy“ enthält. Ein geologisches Neuron verzweigt sich zu der geographischen JavaScript-Bibliothek namens Cesium. Dies ist kein Verstecken von Informationen im hochdimensionalen Raum, sondern ein Wachstum in semantisch benachbarten Bereichen. Er betont, dass Superposition die radikalste und am schwersten zu widerlegende Erklärung ist und daher die letzte Annahme sein sollte – und er selbst war jahrelang ihr Anhänger.
Betrachtet man nur die Reaktionen nach Abschluss des Trainings, scheinen diese Elemente lose miteinander verbunden zu sein; verfolgt man den Verlauf des Trainings, erkennt man, wie sie miteinander verknüpft werden.
Auch Werkzeuge können Missverständnisse erzeugen. Das Team stellte fest, dass eine Einheit, die von einem automatischen Erklärungswerkzeug als „mehrdeutiges Komma-Neuron“ markiert wurde, tatsächlich mit dem US-Bundesstaat Colorado zusammenhängt: Sie reagiert auf Informationen wie lokale Telefonvorwahlen und Slang, und ihre Verstärkung führt dazu, dass das Modell dazu neigt, Wandertouren zu planen. Das Komma ist nur die Position, an der das Modell den vorherigen Kontext zusammenfasst. Wenn man nur auf die Zeichen schaut, bei denen die Reaktion auftritt, verpasst man die eigentliche Bedeutung.
Im Jahr 2023 fand das automatische Erklärbarkeitsprojekt von OpenAI selbst nach großzügigen Maßstäben nur etwa 1,7 % erklärbare Neuronen. Bei der ersten Prüfung von Qwen3-32B schätzt der Autor heute, dass etwa 90 % der Neuronen an ihrem positiven und negativen „Pol“ jeweils eine Hauptaufgabe erfüllen, etwa 7 % zwei verwandte Aufgaben haben und etwa 2 % bis 4 % noch nicht verstanden sind. Diese Zahl hängt vom Aktivierungsschwellenwert und der Definition von „einer Aufgabe“ ab.
Die Ergebnisse sind bei dichten Modellen und MoE-Modellen ähnlich. Der Autor erzielte bei Kimi K3 dieselben Ergebnisse: Sie erstellten das erste bekannte Zuordnungsdiagramm für ein Modell mit Billionen von Parametern auf Kimi K3. Bei dem Problem des gefundenen Geldbeutels verbinden Geldbeutel, Bargeld und Ausweispapiere das Fundbüro mit Ehrlichkeit, was schließlich zur Ausgabe „zurückgeben“ führt. Bei einer erneuten Prüfung des damaligen GPT-2 XL mit neuen Werkzeugen erwiesen sich etwa 70 % der Neuronen im Großen und Ganzen als „eindeutig einer Sache zugeordnet“.
KI-Wissenschaftler lassen das Innere der KI untersuchen
Ein weiterer Hauptstrang dieser Arbeit besteht darin, dass Agenten den Umfang der Forschung verändern.
KI kann Neuronenproben prüfen, Erklärungen vorschlagen, vorgelagerte und nachgelagerte Verbindungen verfolgen und dann Experimente entwerfen, um Gegenbeispiele zu finden. Die Forscher ließen die Agenten auch hunderttausende Zuordnungsdiagramme prüfen, und der Autor selbst prüfte Tausende davon.
Wie kann man verhindern, dass die KI eine plausibel klingende Geschichte erfindet?
Ein Test sieht folgendermaßen aus: Der erste Agent untersucht das Neuron und verfasst eine Erklärung; der zweite sieht nur die Erklärung, erstellt eine neue Probe, von der erwartet wird, dass sie das Neuron stark aktiviert, und gibt sie dann an das Netzwerk zur Messung weiter. Der Autor berichtet, dass die Aktivierungsstärke einiger Proben alle Beispiele übertrifft, die sie aus einem Korpus mit Hunderten von Milliarden Tokens gefunden haben. Das Team erzeugte auch Gegenbeispiele, die „nahezu passend aussehen, aber eigentlich nicht auslösen sollten“, und prüfte durch Eingriffe wie das Entfernen von Neuronen oder die Verstärkung der Aktivierung, ob die Erklärung das Verhalten des Modells vorhersagen kann.
Auf diese Weise werden Erklärungen zu Hypothesen, die durch Experimente widerlegt werden können.
Cammarata hat auch eine kontraintuitive Erkenntnis vorgebracht: Wenn man mehr Teile des Netzes versteht, wird es manchmal einfacher, die übrigen Teile zu verstehen. Wie bei einem Kreuzworträtsel: Je mehr benachbarte Antworten es gibt, desto stärker eingeschränkt ist, was in ein leeres Feld eingetragen werden kann. Neuronen in größeren Modellen können auch stärker spezialisiert sein und sind daher leichter zu erkennen.
Das erinnert ihn an die eigene „bittere Lektion“ des Bereichs der Erklärbarkeit: Einfache Beobachtungen, Hypothesen und Überprüfungen können bei ausreichend großen Größenordnungen effektiver sein als die ständige Entwicklung ausgefeilter Zerlegungsmethoden.
Dies ist noch keine Erklärung, dass die „Erklärbarkeit bereits gelöst ist“. Es gibt noch viel zu tun: den Aufmerksamkeitsmechanismus, die vollständige Prüfung von Modellen und die Frage, wie das Verständnis in zuverlässige Sicherheitsverbesserungen umgewandelt werden kann. Aber es bietet eine Richtung, die es wert ist, ernsthaft geprüft zu werden: Wenn das Innere neuronaler Netze bereits verfolgbare Strukturen aufweist, könnten zukünftige Durchbrüche aus einem Labor stammen, das von KI-Wissenschaftlern betrieben wird, das Modelle kontinuierlich beobachtet, Fragen stellt und Antworten nacheinander überprüft.
Referenzinhalte:
https://already-clean.goodfire.com/
https://news.ycombinator.com/item?id=50105647
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Machine Heart“ (ID: almosthuman2014), verfasst von einem Autor, der sich für große Modelle interessiert, und wird mit Genehmigung von 36Kr veröffentlicht.