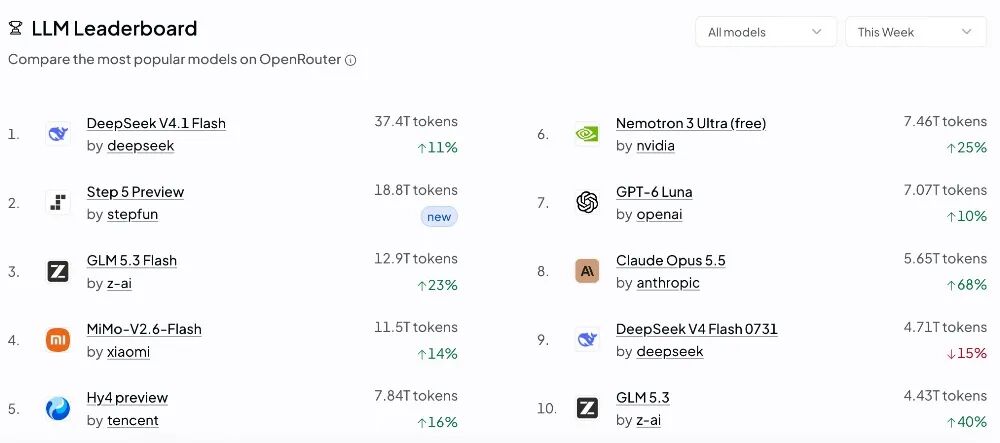
Auf der globalen wöchentlichen Rangliste von OpenRouter belegt es den zweiten Platz, und dieses chinesische selbstentwickelte Modell wurde endlich quelloffen veröffentlicht.
Das optimale Gleichgewicht zwischen Leistungsfähigkeit, Kosten und Stabilität finden.
Laut einem Bericht von Zhidongxin vom 15. Oktober ist heute ein großes Sprachmodell, das gerade auf den zweiten Platz der wöchentlichen globalen Nutzungsrangliste von OpenRouter Token aufgestiegen ist, quelloffen veröffentlicht worden!
StepFun hat die Modellgewichte von Step 5 Preview offiziell freigegeben, die beiden Versionen BF16 und FP8 sind gleichzeitig auf HuggingFace und ModelScope online gestellt.
Hugging Face:
https://huggingface.co/stepfun-ai/Step-5-Preview
ModelScope:
https://modelscope.cn/models/stepfun-ai/Step-5-Preview
Step 5 Preview verwendet eine spärliche MoE-Architektur mit 600 Milliarden Gesamtparametern und nur 27 Milliarden aktiven Parametern und unterstützt ein Kontextfenster von 1 Million Token. Es erreichte 44 Punkte im Intelligence Index von Artificial Analysis und rangiert unter den ersten drei der weltweit quelloffenen Modelle.
Nach der offiziellen Veröffentlichung rückte das Modell schnell in das Blickfeld globaler Entwickler vor. Bis zum 15. Oktober 2026 belegt der Token-Verbrauch von Step 5 Preview auf der offenen Modellplattform OpenRouter sowohl in der wöchentlichen als auch in der täglichen Rangliste den zweiten Platz, wobei der Verbrauch in den letzten sieben Tagen etwa 18,8 Billionen Token beträgt.
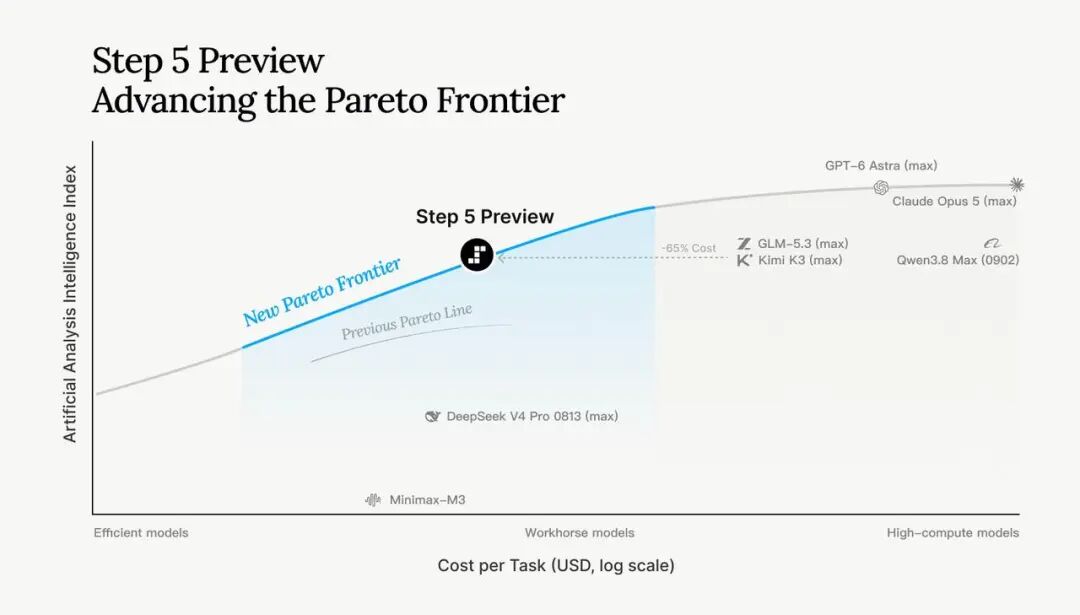
Laut den Bewertungsdaten von Artificial Analysis zum Zeitpunkt der Veröffentlichung von Step 5 Preview betragen die durchschnittlichen Kosten pro Aufgabe nur 1/8 der Kosten von Claude Opus 5. Die Gesamtkosten für eine einzelne Anfrage betragen bei ersterem 0,71 US-Dollar und bei letzterem 5,86 US-Dollar.
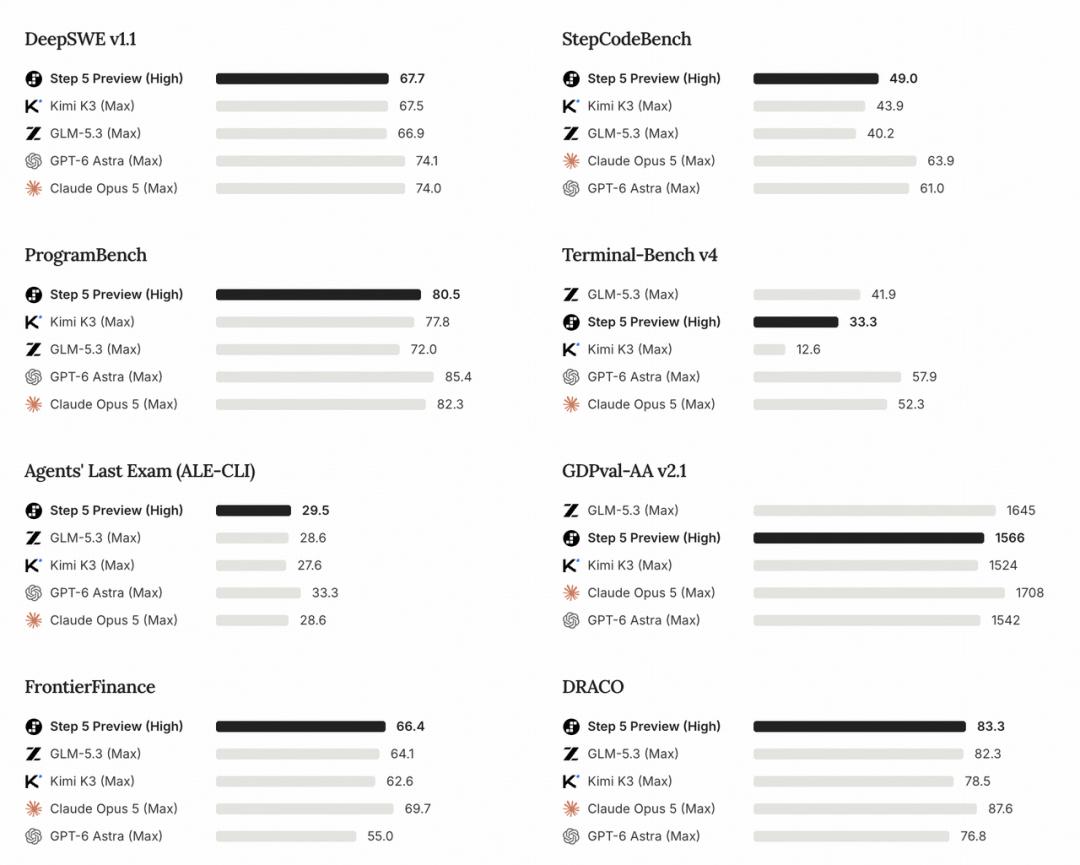
Bei Benchmark-Tests zeigt Step 5 Preview nach Angaben des StepFun-Teams bei öffentlichen und internen Bewertungen eine ausgewogene Gesamtleistung bei Benchmarks für komplexe Softwareentwicklungsaufgaben (einschließlich langfristiger Planungsaufgaben), Facharbeiten und im Finanzbereich.
In den Untertests ALE-CLI von Agents' Last Exam, der Finanzinvestitionsforschungsbewertung FrontierFinance und der domänenübergreifenden Tiefenforschungsbewertung DRACO übertrifft es Kimi K3 und GLM-5.3 und liegt nur hinter GPT-6 Astra oder Claude Opus 5.
Die Leistung von Step 5 Preview in Ranglisten und im praktischen Einsatz macht neugierig: Welche unterschiedlichen technischen Designs stecken hinter diesem Modell? Ich habe den technischen Blog von Step 5 Preview gründlich durchsucht, um die Antworten zu finden.
01. 92-schichtige schmal-tiefe Architektur zur Verbesserung der Recheneffizienz auf Architekturebene
Step 5 Preview besteht aus 92 gestapelten Transformer-Modulen. Die Tiefe des Modells ist vergleichbar mit quelloffenen großen Modellen auf Billionen-Parameter-Niveau wie Qwen 3.8 Max und Kimi K3, aber die Gesamtparameterzahl beträgt weniger als 1/4 dieser Modelle und die Anzahl der aktiven Parameter weniger als 1/3.
Warum ist die Tiefe so wichtig?
Die Erklärung von StepFun lautet: Bei Agent-Aufgaben muss das Modell ständig externe Tools aufrufen, und jeder Aufruf kann eine große Menge neuen Textes erzeugen. Angesichts der Token-Effizienz hat das Modell möglicherweise keine Gelegenheit, durch explizite Denkketten vollständig zu schlussfolgern, daher hängt es stärker von dem „impliziten Schlussfolgern“ beim Lesen des Kontexts ab.
In Transformers breitet sich die Information schichtweise entlang der Zeitachse der Token und der Tiefe des Netzes aus. Wenn die Anzahl der Schichten nicht ausreicht, kann die Information für Multi-Hop-Abhängigkeiten die Tiefe des Netzes erschöpfen, bevor sie vollständig übermittelt ist, sodass komplexe Schlussfolgerungen in langen Texten möglicherweise nicht abgeschlossen werden können.
Es gibt einen weiteren technischen Ansatz in der Branche, die äquivalente Tiefe durch zirkuläre oder rekursive Strukturen zu erhöhen. StepFun hat einen direkteren Ansatz gewählt: Die Anzahl der Schichten zu erhöhen und die Breite des Netzes zu begrenzen.
Dieses „schmale und tiefe“ Design bietet einerseits einen längeren Informationsübertragungsweg für Multi-Hop-Schlussfolgerungen und andererseits kann es den Parameterumfang und den Berechnungsaufwand für Antworten steuern, sodass das Modell die Fähigkeit für langfristige Aufgaben erhält, die mit Modellen auf Billionen-Parameter-Niveau vergleichbar ist.
Bei der Konfiguration des Aufmerksamkeitsmechanismus ordnet Step 5 Preview zwei Arten von Aufmerksamkeitsschichten im Verhältnis 3:1 an: 3/4 sind hocheffiziente gated Sliding-Window-Aufmerksamkeitsschichten und 1/4 sind spärliche volle Aufmerksamkeitsschichten.
Laut StepFun stellte das Team nach dem Vergleich mehrerer linearer Aufmerksamkeitslösungen fest, dass der Leistungsunterschied zwischen den Lösungen sehr gering ist, aber die Sliding-Window-Aufmerksamkeit die einfachste Struktur hat und der spekulativen Dekodierung zugute kommt.
02. Mit Sparse GQA die Aufmerksamkeit für den Kontext von einer Million Token „verschlanken“
Nachdem das Modell einen tieferen Schlussfolgerungspfad erhalten hat, besteht der nächste Schritt darin, den Aufmerksamkeitsberechnungsaufwand durch den Kontext zu steuern.
Wenn die Kontextlänge 1 Million Token erreicht, wird die volle Aufmerksamkeitsschicht zu einem gemeinsamen Effizienzengpass für Training und Schlussfolgerung.
Die Lösung von StepFun besteht darin, einen spärlichen Aufmerksamkeitsmechanismus namens Sparse GQA auf dem Pfad der vollen Aufmerksamkeit zu verwenden, nämlich spärliche Indizes in die standardisierte gruppenabfragebasierte Aufmerksamkeit (GQA) einzuführen. Das Modell muss keine Aufmerksamkeitsberechnung für alle historischen Informationen durchführen, sondern filtert zuerst und berechnet dann.
Diese Idee ist nicht neu bei StepFun, ähnliche Erkundungen wurden bereits in früheren Arbeiten wie DSA von DeepSeek durchgeführt.
Laut StepFun müssen bei der praktischen Bereitstellung drei Hürden überwunden werden: der Overhead des Filters selbst, die GPU-Auslastung bei fragmentierter Berechnung nach dem Filtern und der Kompromiss zwischen Filtergenauigkeit und der gelesenen Datenmenge.
Im Vergleich zu Strukturen wie MQA (Multi-Query Attention) und MLA (Multi-Head Latent Attention) verstärkt GQA diese drei Widersprüche. Das Team hat sich für GQA entschieden, weil diese Struktur in Experimenten eine bessere Genauigkeit bei langen Kontexten aufweist und die parallele Schlussfolgerung auf mehreren GPUs begünstigt.
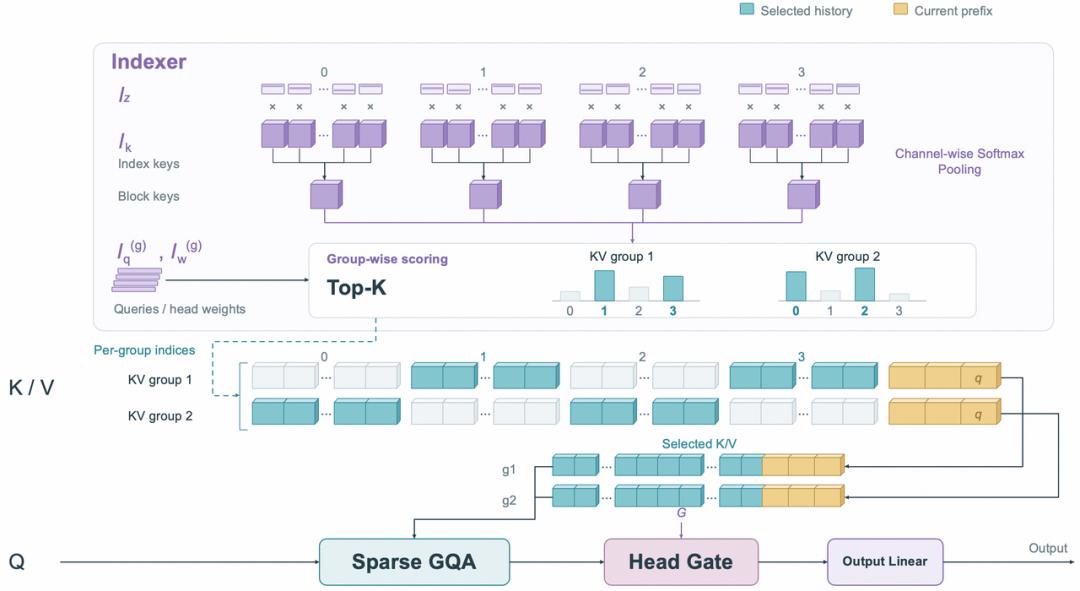
Schema der spärlichen GQA 1
Aber diese drei Widersprüche können nicht ignoriert werden. Für dieses Problem hat StepFun das spezifische Sparse-GQA-Schema vorgeschlagen:
- Benachbarte historische Positionen zu „Blöcken“ komprimieren
um die Kosten des Filters zu senken. Die Blockgröße wird auf 8 festgelegt, wodurch die Kosten für Filter- und Auswahlschritte um das 8-fache sinken;
Unter Ausnutzung der Eigenschaft, dass benachbarte Token semantisch ähnlich sind und die Filterergebnisse stark überlappen, wird die Vereinigungsmenge der Filterergebnisse benachbarter Token gebildet und die Berechnung zusammengefasst, um die GPU-Auslastung zu verbessern;
Nach wiederholten Tests wurde die Konfiguration festgelegt, dass je 8 Token eine Gruppe bilden und insgesamt 4096 Token gefiltert werden. Je länger der Text ist, desto mehr Berechnungen spart dieses Schema, während die Informationsabdeckung fast identisch mit der eines feineren Referenzschemas ist (78,06 % gegenüber 79,09 %).
Unter dem spärlichen Mechanismus komprimiert der Filter zuerst die gemeinsam genutzten Indexschlüssel zu Blockdarstellungen, jede KV-Gruppe wählt unabhängig relevante historische Blöcke aus, und der Hauptberechnungspfad liest nur die ausgewählten ursprünglichen K/V und die sichtbaren Positionen im aktuellen Block.
Mit anderen Worten: Das Modell wählt zuerst grob die Kapitel aus und liest dann den Originaltext gründlich, sodass der Aufwand für die vollständige Aufmerksamkeitsberechnung für eine Million Token vermieden wird.
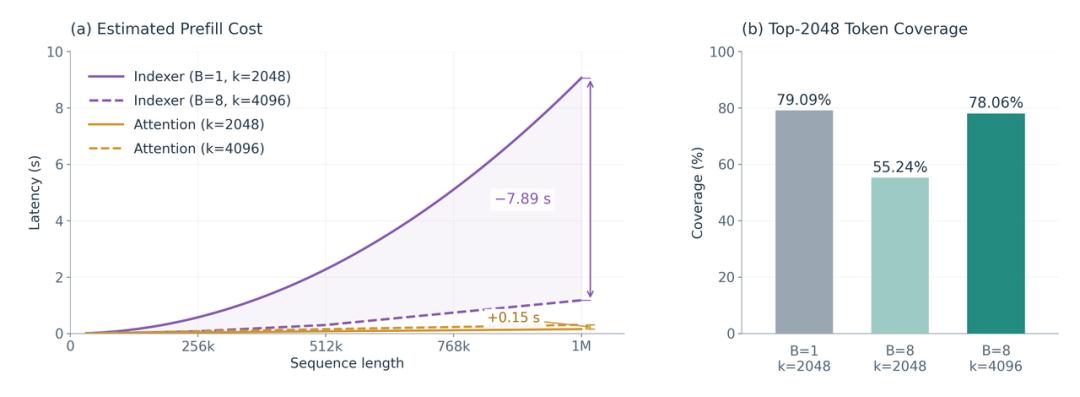
Schema der spärlichen GQA 2
03. Mit dreischichtigen Maßnahmen numerische Explosionen und Gradientenspitzen eindämmen, um ein stabileres Training zu erreichen
Die ersten beiden Schritte behandeln jeweils den Schlussfolgerungspfad des Modells und den Berechnungsaufwand für lange Kontexte, aber um diese Designs umzusetzen, muss der Trainingsprozess ausreichend stabil sein.
Eines der Hauptprobleme, auf das StepFun beim Training stieß, war numerische Explosionen und Gradientenspitzen.
Während des Trainings geraten bestimmte Werte plötzlich außer Kontrolle, was im leichteren Fall den Fortschritt verlangsamt und im schwereren Fall die vorherigen Trainingsergebnisse zunichte macht. Im FP8-Trainingsframework mit niedriger Genauigkeit hat das Team drei Gegenmaßnahmen vorgeschlagen:
Die erste Maßnahme besteht darin, die verborgenen Zustände auf FP32-Genauigkeit umzustellen.
Das Training mit niedriger Genauigkeit ist schnell und kostengünstig, aber nachdem das Modell tiefer geworden ist, geraten wenige Datenpunkte mit extrem großen Werten in Formaten mit niedriger Genauigkeit schnell außer Kontrolle. Nach der Speicherung dieser Daten mit hoher Genauigkeit sinken die Extremwerte um fast das Zehnfache, während die zusätzlichen Kosten nur geringfügig auswirken.
Die zweite Maßnahme besteht darin, den Skalierungsfaktor der Normalisierungsschicht auf FP32 umzustellen.
Die Normalisierungsschicht dieses Modells verwendet das zentrierte RMSNorm. Wenn ihr Regelparameter in Formaten mit niedriger Genauigkeit zufällig bei einem kritischen Wert anhält, schaltet ein bestimmter Berechnungskanal wiederholt ein und aus, was zu Ausgabeschwingungen führt. Nachdem dieser Parameter auf die Speicherung mit hoher Genauigkeit umgestellt wurde, wird das Problem der Ausgabeschwingungen deutlich gemildert.
Die dritte Maßnahme ist die feingranulare Gradientenbegrenzung.
Das Team stellte fest, dass Gradientenspitzen nicht aus Datenrauschen oder der Ausgabeschicht stammen, sondern in einigen mittleren Schichten entstehen und innerhalb weniger Schichten um mehrere Größenordnungen verstärkt werden. Wiederholte Daten scheinen dies zu begünstigen; ihre Ursache hängt möglicherweise damit zusammen, dass redundante Schichten bestimmte Signale im Backpropagation wiederholt verstärken.
Da die anomalen Gradienten sehr spärlich sind, muss das Team nur einen sehr kleinen Teil des Gradienten in jeder Schicht (Anteil 0,00004 %) begrenzen, um die Spitzen zu unterdrücken und die Trainingskonvergenzkurve deutlich glatter zu machen.
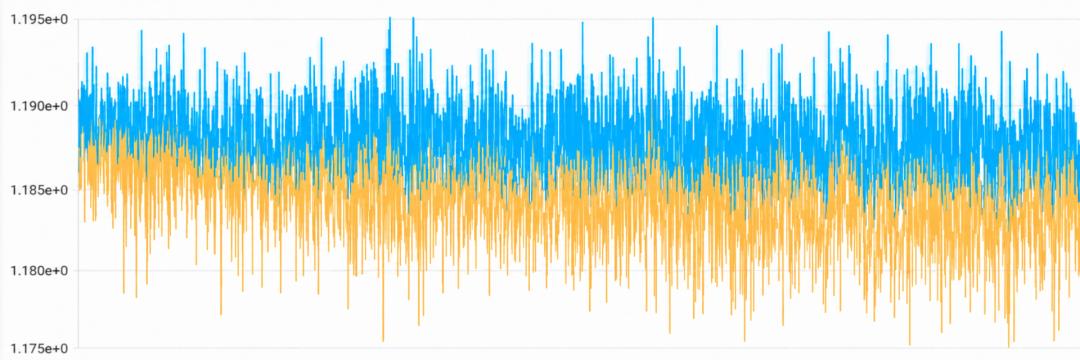
Vergleich des LLM-Verlusts vor (blau) und nach (orange) der feingranularen Gradientenbegrenzung
04. Schlusswort: Von der Architekturoptimierung zur offenen Bereitstellung, die Modellfähigkeiten wenden sich realen Aufgaben zu
Betrachtet man die technischen Designs von Step 5 Preview, von der 92-schichtigen schmal-tiefen Architektur über Sparse GQA bis hin zur Optimierung der Trainingsstabilität tiefer Netze, entsprechen diese Entscheidungen jeweils unterschiedlichen Problemen bei der Modellschlussfolgerung, der Verarbeitung langer Kontexte und der Trainingstechnik. Sie sind keine Durchbrüche bei einzelnen Technologien, sondern eine Reihe von Designentscheidungen, die sich um die Fähigkeiten des Modells und die tatsächliche Betriebseffizienz drehen.