Wollen generische große KI-Modelle die verkörperte Intelligenz mit einem "Angriff aus einer höheren Dimension" überrennen? Die erste AA-Robotics-Rangliste ist erschienen.
Wird das von Unternehmen für verkörperte Intelligenz hart trainierte "Roboter-Gehirn" von GPT, Claude und Gemini verdrängt?
Am 14. Oktober hat die bekannte Bewertungsstelle für große Modelle Artificial Analysis diese großen Modelle mit hervorragender Leistung in Bereichen wie Mathematik und Programmierung zu einer echten Roboterprüfung eingeladen.
Bei der neu veröffentlichten Bewertung AA-Robotics v0.1 müssen fortschrittliche Modelle wie GPT, Claude und Gemini echte Roboterarme steuern und acht Aufgaben wie Wasser eingießen, schreiben und Bausteine stapeln bewältigen, um zu vergleichen, wessen "praktische Fähigkeiten" stärker sind.
Infolgedessen haben die großen Modelle gleich zu Beginn viele Fehler gemacht. Ein Roboterarm hat mehr als zehn Minuten gebraucht, um mehrere Schaumstoffbausteine zu einem qualifizierten Turm zu stapeln. GPT-6.1 Sol, der ihn gesteuert hat, hat die Aufgabe offensichtlich bereits abgeschlossen, weigerte sich aber, anzuhalten, und hat die Bausteine weiter angepasst, wodurch die Aufgabe schließlich fehlschlug.
Das ist nur eine dramatische Szene bei dieser Roboterprüfung.
Die ersten Ergebnisse sind ebenfalls voller Kontraste: GPT-6 Astra belegt den ersten Platz, und allgemeine große Modelle können bereits echte Roboterarme mit Hilfe von Programmieragenten steuern. Sie benötigen aber durchschnittlich etwa eine halbe Stunde, um eine Aufgabe zu erledigen, was fast zwei Größenordnungen langsamer ist als die menschliche Basislinie.
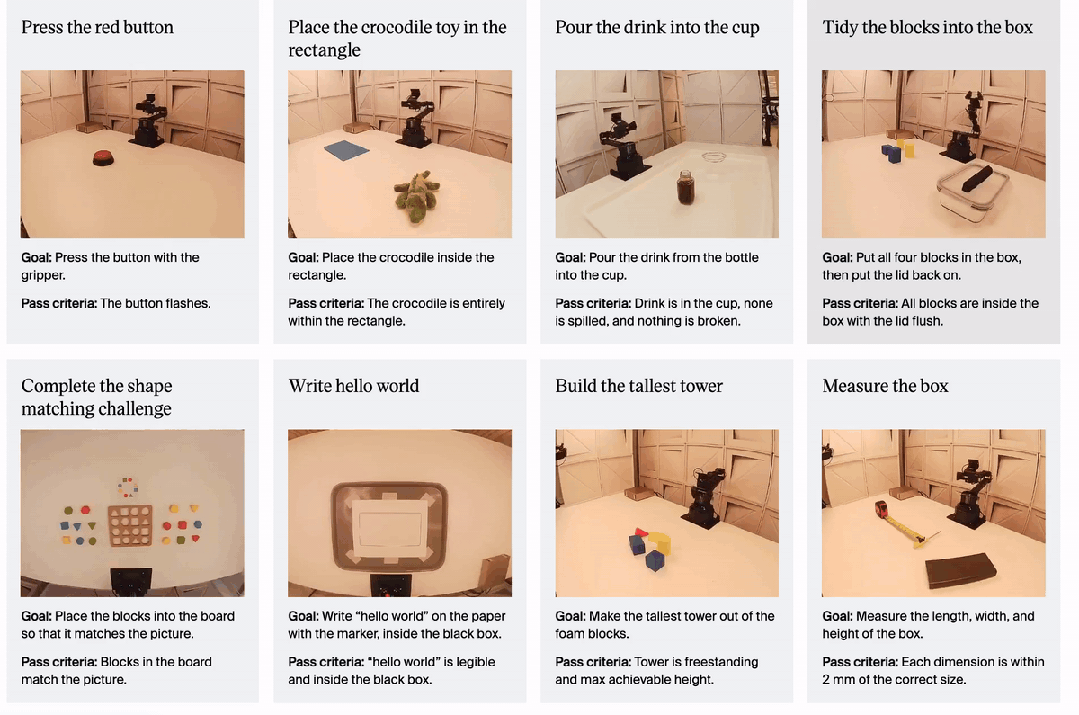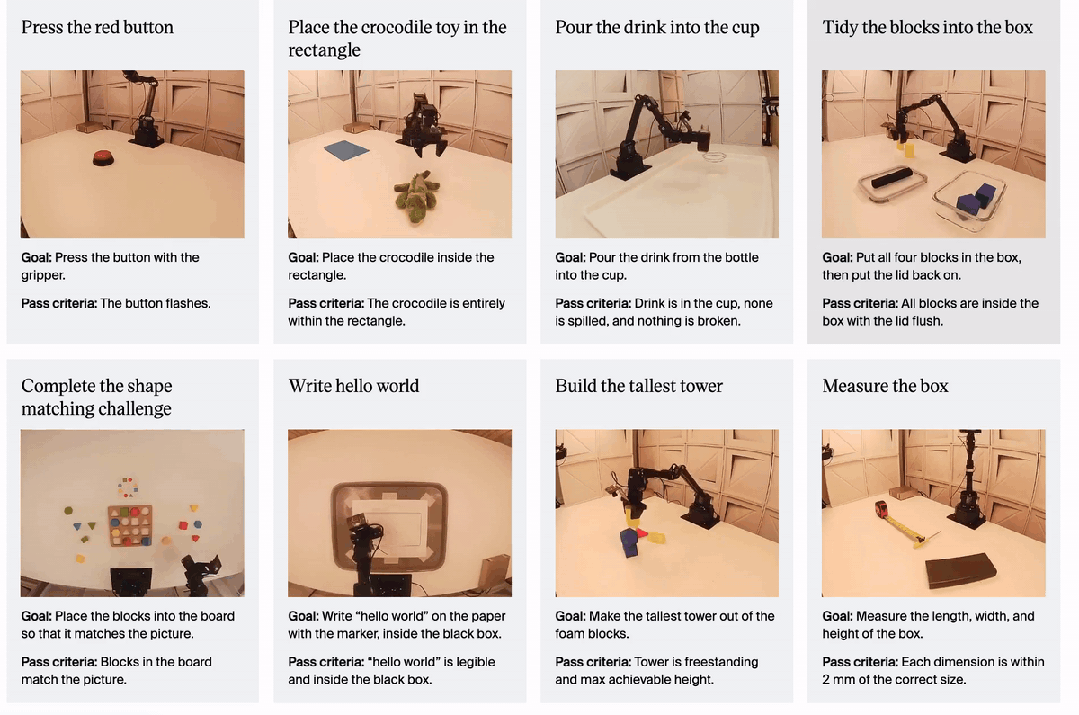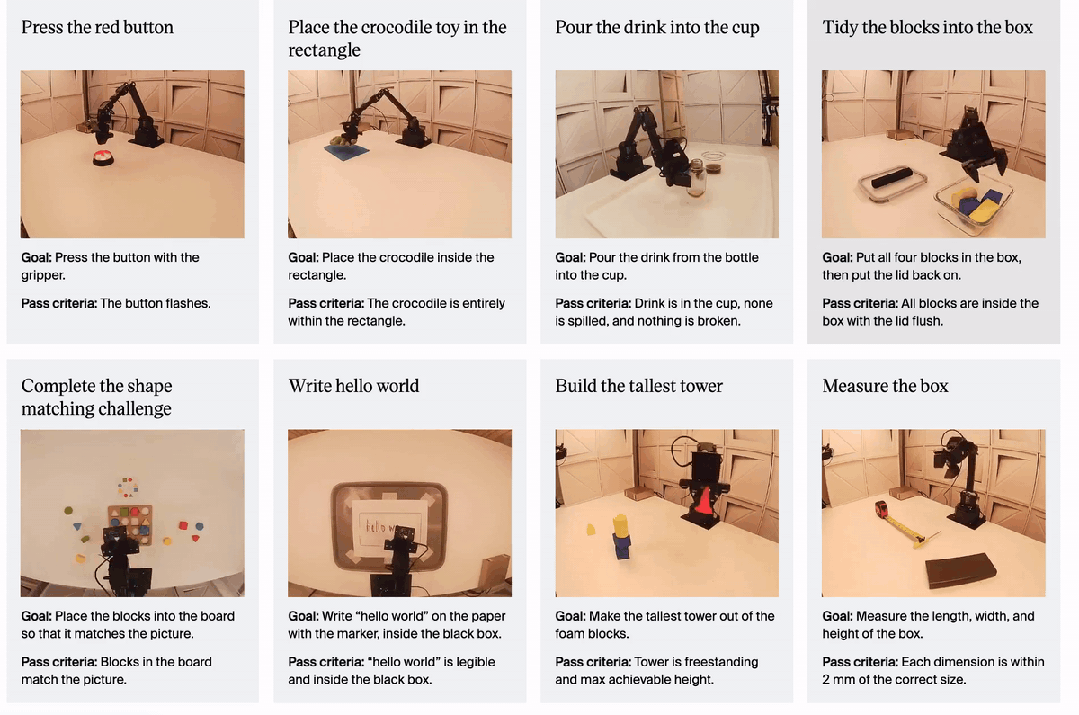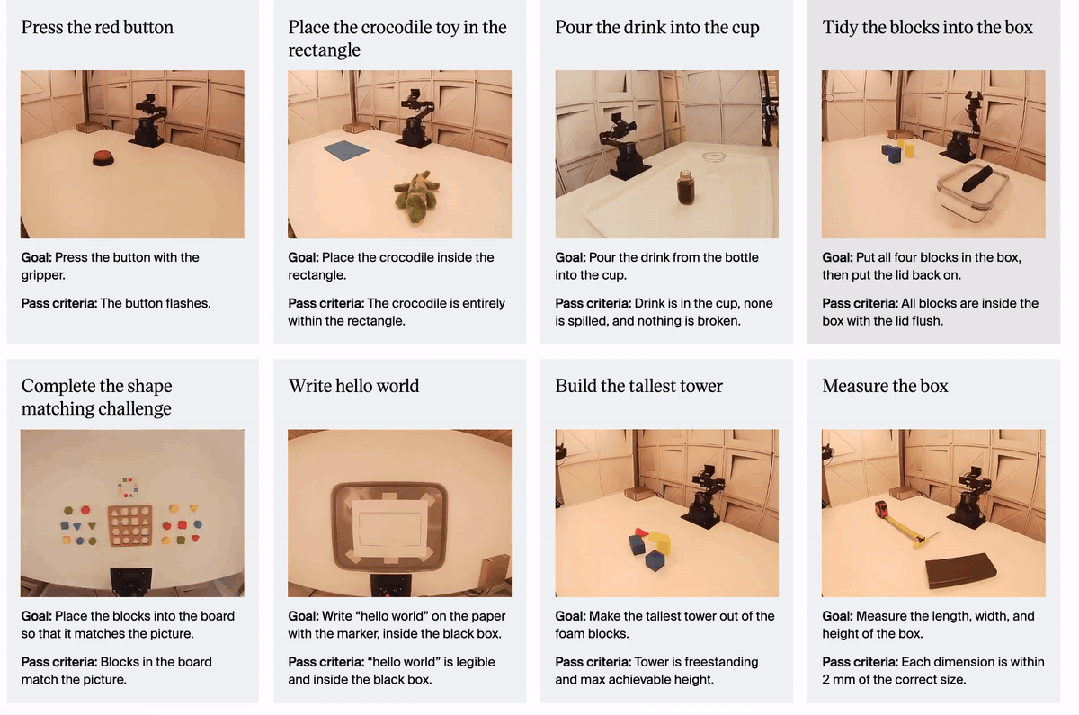
Diese Ergebnisliste liefert auch eine neue Diskussionsgrundlage für die jüngste Debatte in der Roboterbranche: Mit der zunehmenden Stärke allgemeiner großer Modelle, wie viel unersetzlichen Wert hat das speziell trainierte "Roboter-Gehirn" von Unternehmen für verkörperte Intelligenz eigentlich noch?
Wird das "Roboter-Gehirn" von allgemeinen großen Modellen ersetzt?
Im letzten Monat sind Videos, in denen GPT-6 Astra Roboterarme steuert, um die Golden-Gate-Brücke zu zeichnen, Bausteine zu greifen und menschliche Operationen nachzuahmen, in den sozialen Medien viral gegangen. Ein Roboterarm mit einem Preis von etwa 150 US-Dollar kann unter der Steuerung von Astra selbstständig Aktionen anhand der Kamerabilder planen und die Golden-Gate-Brücke Strich für Strich zeichnen.
Ein überzeugenderes Experiment stammt von RoboCurve. Bei seinem Test mit echten Geräten hat Astra einen doppelten Roboterarm gesteuert, um rote Bausteine in eine Schüssel zu legen, und hat 19 von 20 Versuchen erfolgreich abgeschlossen. Ein solches Ergebnis lässt viele Menschen fragen: Da allgemeine große Modelle bereits über Sehvermögen, räumliches Vorstellungsvermögen und Schlussfolgerungsvermögen verfügen und Steuercodes schreiben können, warum müssen Roboterunternehmen noch viel Zeit und Geld investieren, um ihre eigenen VLA-Modelle von Grund auf zu trainieren? Einige Leute behaupten sogar, dass das OpenAI der Roboterbranche möglicherweise OpenAI selbst ist.
Aber die Menschen in der Branche für verkörperte Intelligenz stimmen dem nicht vollständig zu.
Auf dem Bund Summit am 10. September sprach Wang Qian, Gründer von Ziliangji Robotics, über diese Behauptung der "Dimensionsreduktionsangriff" und urteilte, dass die Möglichkeit derzeit gering ist. Sein Grund ist, dass die Fähigkeit des Modells aus Daten stammt. Die Stärkung des Programmiermodells beruht auf einer großen Menge an Codedaten und einem ausgereiften Verifizierungssystem. Die physische Welt, mit der Roboter konfrontiert sind, erfordert ebenfalls spezielle Daten, Bewertungen, Hardware und Infrastruktur, die nicht automatisch gelöst werden, nur weil das Sprachmodell stark ist. Wang Qian erwähnte auch, dass Astra nicht vollständig von Roboterdaten isoliert ist. Daher kann die Tatsache, dass allgemeine Modelle Roboterarme steuern können, nicht einfach als natürliche Übertragung der Sprachfähigkeit auf die physische Welt verstanden werden.
Xu Huazhe, Gründer von Pokurobot, hat Astra ebenfalls selbst ausprobiert. Es kann Objekte auf dem Tisch erkennen und sogar ein Essstäbchen greifen. Sobald es jedoch aufgefordert wird, komplexere Kontaktoperationen mit den Essstäbchen durchzuführen, verschlechtert sich die Leistung deutlich. Seiner Meinung nach sind die Fortschritte bei der semantischen und räumlichen Wahrnehmung überraschend, aber komplexe physische Interaktionen sind immer noch eine andere Herausforderung.
Der Schwerpunkt der Debatte beider Seiten wird dadurch allmählich klar: Ob allgemeine große Modelle "praktisch arbeiten" können, ist nicht mehr die einzige Frage. Entscheidender ist, wie viele Aufgaben sie wirklich erledigen können und ob sie dies stabil und schnell tun können.
AA-Robotics liefert genau ein neues Maßstab.
GPT-6 belegt den ersten Platz, aber die Roboterprüfung ist weitaus nicht so einfach
Artificial Analysis hat zuvor ständig die Schlussfolgerungsfähigkeit, Programmierfähigkeit, Geschwindigkeit und Preis großer Modelle verfolgt. Diesmal hat es den Prüfungsort vom Bildschirm auf den Tisch verlegt.
Jedes Modell erhält die Kontrolle über einen Hiwonder NexArm-Roboterarm. Es handelt sich um einen sechsachsigen Roboterarm mit fünf Gelenken und einem Greifer, wobei vier Kameras um den Tisch und am Handgelenk des Roboterarms angeordnet sind.
Das Modell kennt zunächst nur den Namen des Roboterarms, wie es über die HTTP API mit ihm kommuniziert und wie es Aufgaben einreicht. Es muss selbst die Kameras beobachten, die Position der Objekte verstehen, Programme schreiben und ausführen, damit der Roboterarm Aktionen ausführt. Das GPT-Modell läuft in Codex, Claude verwendet Claude Code und Gemini verwendet Antigravity. Alle acht Tests sind Null-Schuss-Versuche, und es wird kein zusätzliches Training für die aktuelle Aufgabe durchgeführt. Diese Bewertung untersucht, wie allgemeine große Modelle mit Hilfe von Programmieragenten und Robotersteuerungsschnittstellen die Umgebung verstehen, Aktionen planen und schließlich Betriebsaufgaben in der realen Welt erledigen.
Die Gesamtergebnisse der ersten fünf Modelle wurden veröffentlicht: GPT-6 Astra erhielt 69,4 Punkte, GPT-6.1 Sol 64,6 Punkte, Gemini 4 Argon 55,3 Punkte, Claude Opus 5,5 48,8 Punkte und Claude Fable 5.1 46,3 Punkte.
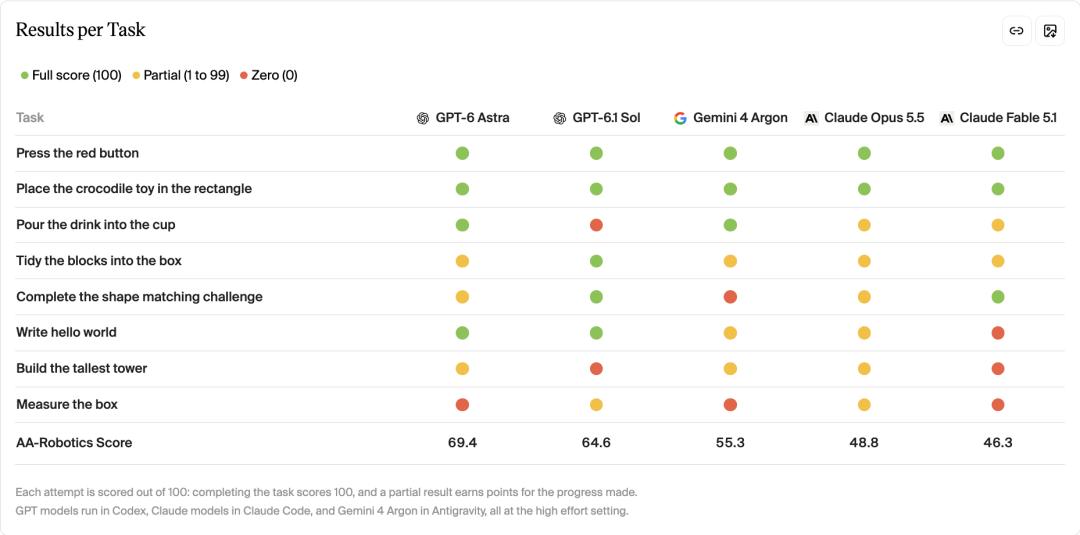
Die Punktzahl ist jedoch nicht die Erfolgsrate. Jede Aufgabe hat eine volle Punktzahl von 100, und auch wenn sie nicht vollständig abgeschlossen wird, kann man Punkte für den Prozess erhalten. Daher hat Astra zwar die höchste Gesamtpunktzahl, aber nur vier von acht Aufgaben die volle Punktzahl erreicht. Sol, der den zweiten Platz belegt, hat hingegen fünf Aufgaben mit voller Punktzahl abgeschlossen.
Die beiden einfachsten Aufgaben wurden von allen fünf Modellen erfolgreich erledigt: Den roten Knopf mit dem Greifer drücken und ein Krokodilspielzeug vollständig in das vorgesehene Kästchen legen. Diese Operationen sind für die heutigen fortschrittlichen großen Modelle nicht mehr schwierig.
Danach öffnet sich die Lücke schnell.
Astra kann das Getränk aus der Flasche in das Glas gießen und mit einem Stift "hello world" auf das Papier schreiben, hat aber bei der Aufgabe, die Länge, Breite und Höhe einer Box zu messen, null Punkte erzielt. Sol hat das Einräumen von Bausteinen, die Formabgleichung und das Schreiben abgeschlossen, konnte aber kein Wasser richtig eingießen. Beim Stapeln von Bausteintürmen hat kein Modell die volle Punktzahl erreicht: Sol hat sogar einmal einen qualifizierten Turm gebaut, hat ihn aber durch nachfolgende Operationen zerstört.
Diese Szene ist sehr aufschlussreich. Im Computer muss das Modell nur die Generierung stoppen, nachdem es die Antwort gefunden hat. In der physischen Welt muss es auch beurteilen, ob das Objekt vor ihm bereits stabil platziert ist, ob die Aufgabe wirklich abgeschlossen ist und ob die nächste Aktion das Ergebnis zerstören wird.
Ein noch beeindruckenderer Kontrast liegt in Zeit und Kosten.
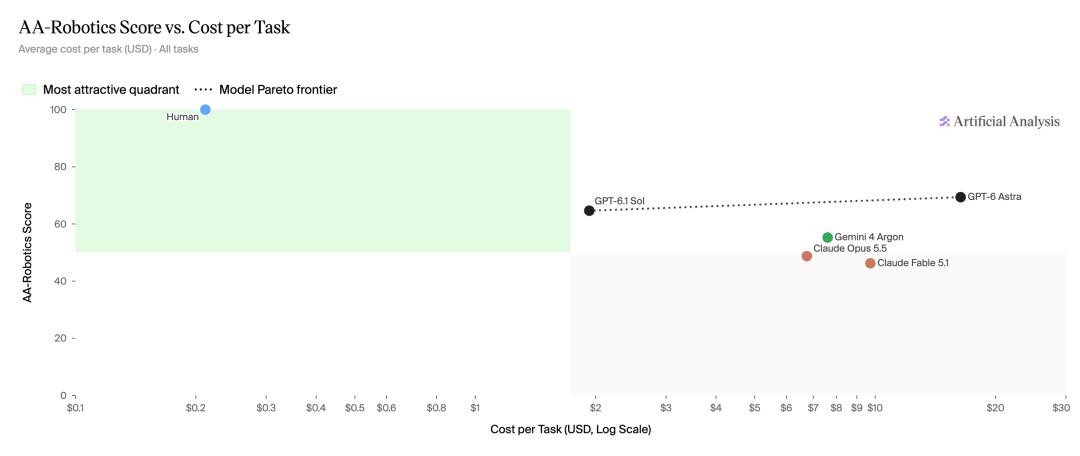
Von den fünf Modellen benötigt Gemini 4 Argon durchschnittlich etwa 52 Minuten, die anderen vier Modelle benötigen etwa eine halbe Stunde, um eine Aufgabe zu erledigen. Die von Artificial Analysis angegebene Basislinie für direkte menschliche Bedienung beträgt durchschnittlich nur etwa 20 Sekunden. Für eine kleine Aufgabe wie das Drücken des roten Knopfes hat Astra 2,2 Minuten gebraucht. Claude Fable 5.1 hat sogar etwa 10 Minuten gebraucht, um die Szene zu verstehen und Aktionen zu planen, bevor es die erste Operation startete.
Die Kosten sind ebenfalls nicht gering. Die durchschnittlichen Kosten für den Modellaufruf von Astra pro Aufgabe betragen 16,36 US-Dollar, während Sol nur 1,93 US-Dollar kostet, wobei der Unterschied in der Punktzahl nur 4,8 Punkte beträgt. Für Roboter, die in Zukunft kontinuierlich in Haushalten und Lagern arbeiten müssen, ist es etwas anderes, eine Aufgabe einmal zu erledigen, als sie täglich Hunderte Male zu angemessenen Kosten zu erledigen.
Die Fähigkeit, den nächsten Schritt zu durchdenken, bedeutet nicht, dass man ihn wirklich gut ausführen kann
Warum brauchen große Modelle so lange, nur um einen Roboterarm zu bewegen?
Artificial Analysis hat den gesamten Aufgabenprozess aufgeschlüsselt. Am Beispiel von Astra: Es verbringt etwa 20 % der Zeit damit, die Umgebung und den Roboterarm zu verstehen, etwa 59 % damit, Aktionen zu planen, und die tatsächliche Bewegung des Roboterarms macht nur etwa 13 % aus. Bei Sol ist die Situation ähnlich: 61 % der Zeit wird für die Planung aufgewendet, und die Bewegung des Roboterarms beträgt ebenfalls nur etwa 13 %.
Sie sehen aus wie eine Person, die zum ersten Mal ein Labor betritt: Zuerst beobachtet sie, wie sich der Roboterarm bewegt, schreibt dann Programme, testet die Position, überprüft das Bild und gibt erst dann den nächsten Befehl aus, wenn sie sicher ist. Die Aktion selbst dauert oft nur wenige Sekunden, aber das Nachdenken davor und danach kann mehrere Minuten dauern.
Langsamkeit ist nicht das einzige Problem.
Bei sechs Aufgaben, die das Greifen beinhalten, beträgt die Greiferfolgrate von Astra 45 %, die von Claude Fable 5.1 44 %, und die von Sol nur 28 %. Obwohl das Modell das Ziel bereits gefunden hat, kann der Greifer neben dem Objekt schließen. Manchmal rutscht die Flasche aus den Fingern, sobald sie gegriffen wird.
In den von der Behörde zusammengestellten Fehlerausschnitten gibt es noch viele beeindruckende Szenen: Der Roboterarm hat das bereits in das Kästchen gelegte Spielzeug herausgeschoben, um die Position des Krokodilspielzeugs anzupassen. Beim Greifen der Flasche stößt das Handgelenk gegen das Tablett, wodurch die Flasche immer schwerer zu erreichen ist. Gegen Ende des Eingießens von Wasser wurde die Positionsänderung des Wasserstroms nicht berücksichtigt, sodass der letzte Teil des Getränks außerhalb des Glases verschüttet wurde.
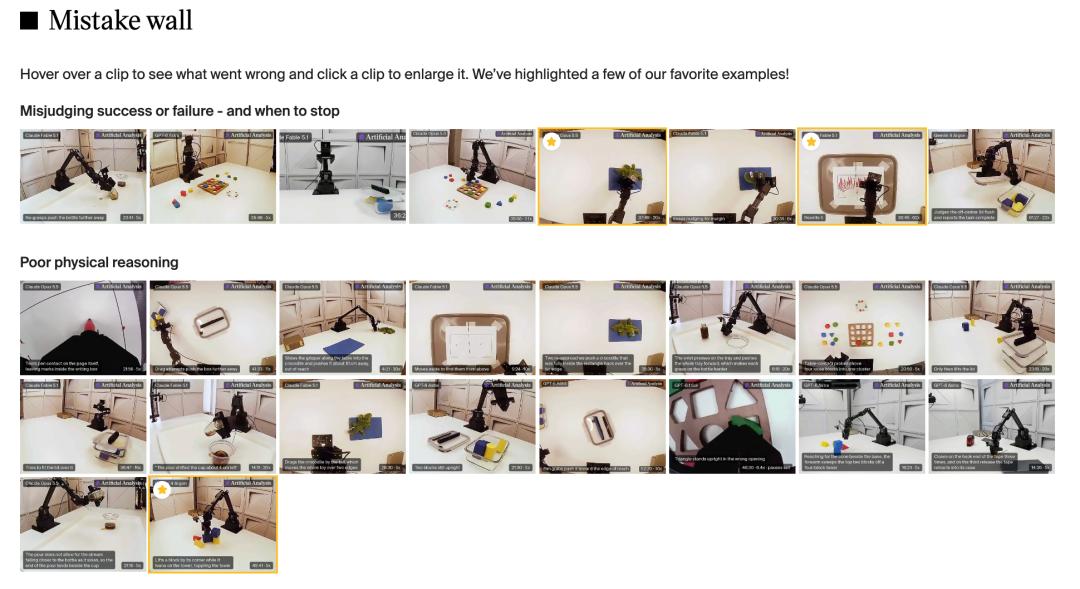
Diese Fehler lassen sich kaum vollständig dadurch beheben, dass man "noch eine Weile nachdenkt". Objekte in der realen Welt können rutschen, kippen und sich verformen, und wenn die Finger mit dem Objekt in Kontakt kommen, entstehen Reibung und Kollision. Roboter müssen Fehler rechtzeitig anhand von Bewegungs- und Kontaktfeedback korrigieren, anstatt nach jeder Bewegung darauf zu warten, dass das große Modell neu plant.
Das ist auch der Bereich, in dem professionelle Modelle für verkörperte Intelligenz noch Raum zur Entfaltung haben. VLA, grundlegende Bewegungsstrategien und Controller befassen sich seit langem damit, wie visuelle Informationen und Aufgabenziele schnell in kontinuierliche und stabile Aktionen umgewandelt werden können.
Natürlich hat diese Liste allgemeine Agenten und spezielle VLA-Modelle noch nicht unter denselben Bedingungen direkt gegeneinander antreten lassen. Acht Aufgaben auf dem Tisch können nicht alle Roboteraufgaben repräsentieren, ganz zu schweigen von der Zusammenarbeit mit zwei Händen, der Bedienung flexibler Objekte und langfristiger autonomer Arbeit.
Aber es hat die Debatte zumindest einen Schritt vorangebracht: Es gibt nun systematische Beweise dafür, dass allgemeine große Modelle echte Operationen erledigen können. Wie weit sie davon entfernt sind, echte Arbeit effizient und zuverlässig auszuführen, wurde zum ersten Mal in dieser Gruppe von Aufgaben konkret gemessen.
In der ersten Liste von AA-Robotics v0.1 sind noch keine chinesischen Modelle enthalten.
Wird es also in der nächsten Charge Qwen, Kimi, GLM oder DeepSeek geben? Wenn sie auf denselben Roboterarm und dieselben Aufgaben angewendet werden, können inländische Modelle dann mit niedrigeren Kosten diese internationalen Spitzenmodelle einholen oder sogar übertreffen?
Das ist möglicherweise erwartungsvoller als nur um den Platz auf einer Rangliste zu kämpfen. In der nächsten Phase der Roboterbranche geht es nicht mehr nur darum, "wer den Roboterarm in Bewegung setzen kann", sondern auch darum, wer ihn schneller bewegen, genauer greifen lassen kann und nach dem Erfolg weiß, wann er anhalten muss.
Referenzlinks:
https://artificialanalysis.ai/articles/aa-robotics
https://x.com/ArtificialAnlys/status/2110500262628806787