Es gibt Propheten, der Forschungsplan von Unternehmen A wurde offengelegt, und Claude Code stammt von vor 5 Jahren.
Nein, bist du aus der Zukunft zurückgereist??
Aufgrund eines Urheberrechtsstreits wurde ein interner Forschungsfahrplan von Anthropic vom Juli 2021 versehentlich offengelegt.
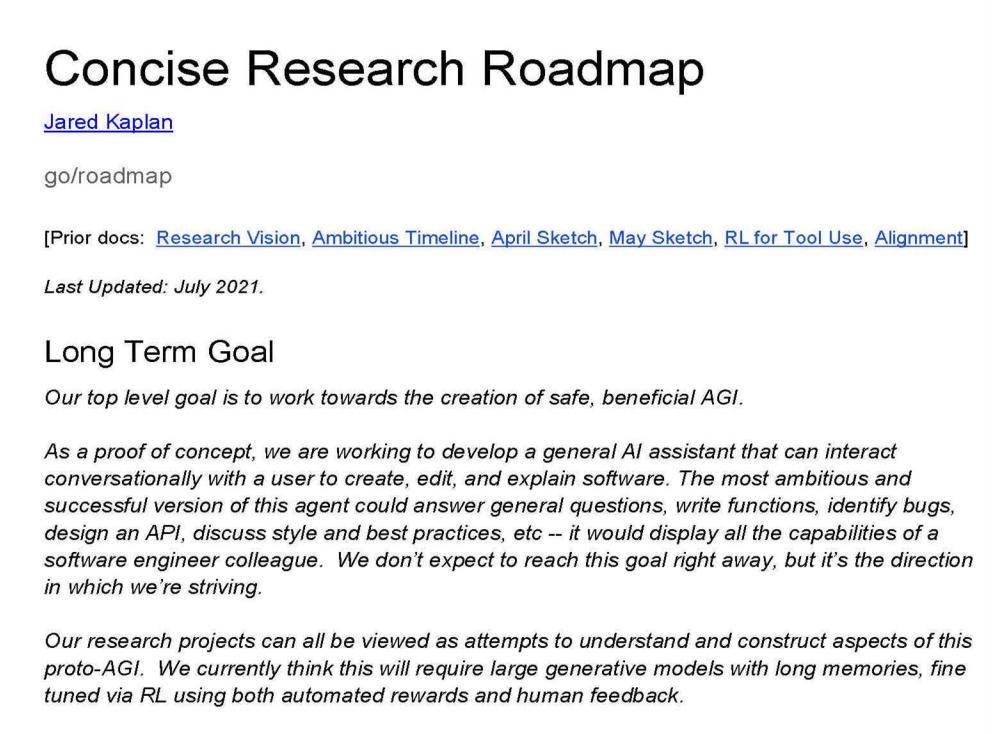
Er ist sehr kurz, der Hauptteil des PDFs umfasst nur zwei bis drei Seiten.
Aber nachdem ich dieses damals als streng geheim eingestufte Dokument von Anfang bis Ende durchgelesen habe, bin ich völlig erstarrt (nicht wirklich).
Das heutige Claude Code, Tool Use, Self-Judging von KI, Test-Time Compute, sogar Billionen von Parametern und extrem lange Kontexte…
Vor fünf Jahren, nur wenige Monate nachdem das Unternehmen sich gerade von OpenAI abgespalten hatte und nur ein Dutzend Mitarbeiter zählte, wurde all dies schwarz auf weiß eindeutig festgelegt.
Der Fahrplan von vor 5 Jahren
Viele Menschen glauben, dass die Entwicklung von großen Sprachmodellen von Chatbots zu Agenten, die Code schreiben und Betriebssysteme bedienen, in den letzten zwei Jahren nach der technischen Reife natürlich entstanden ist.
Das ist falsch.
Ganz am Anfang dieses Fahrplans von 2021 hat Anthropic seinem ultimativen Ziel (sichere, nützliche AGI) eine sehr klare Prototypenposition gegeben:
Ein universeller KI-Assistent zu werden, der über natürliche Sprache mit Menschen interagieren und Software erstellen, bearbeiten und erklären kann.
Was bedeutet ein universeller KI-Assistent?
Er kann allgemeine Fragen beantworten, Funktionen schreiben, Fehler finden, APIs entwerfen und über Codestile und bewährte Praktiken diskutieren.
Das Beeindruckendste ist der folgende Satz:
Er soll alle Fähigkeiten eines Softwareentwicklerkollegen aufweisen.
Nein, ich denke mir, das ist doch genau Claude Code??
Zu der Zeit, als GPT-3 gerade populär geworden war und alle noch staunten, dass KI Gedichte in versteckten Botschaften schreiben kann, hat Anthropic die einfache Logik der automatischen Code-Vervollständigung direkt übersprungen und sich auf einen vollständigen Softwareentwicklungs-Agenten konzentriert.
Darüber hinaus gab es auf dem konkreten Implementierungspfad eine äußerst spannende Debatte im Unternehmen.
Der Forscher Andy Jones hat in einer Anmerkung eine zentrale Meinungsverschiedenheit aufgeworfen: Sollen wir zuerst einen wirklich nützlichen Programmierassistenten entwickeln oder zuerst die Machbarkeit der Tool-Nutzung nachweisen?
Damals stand das Team vor zwei Wegen:
Praktischer Weg: Die Suche in Code-Repositories (Repo Search) implementieren, damit die KI die Typdefinitionen des Projekts durchsuchen kann.
Übrigens hat Tom Brown, der Erstautor der GPT-3-Arbeit, auch an der Diskussion in dieser Richtung teilgenommen und vorgeschlagen, mit dem Durchsuchen von Code-Repos zu beginnen.
Dann der zweite Weg —
Forschungsweg: printf-Debugging und Editor-Operationen implementieren, um zuerst zu beweisen, dass das Model Tools aufrufen kann.
Am Ende hat der CEO Dario die Entscheidung getroffen:
Kurzfristig werden wir zuerst die Machbarkeit der Tool-Nutzung nachweisen, langfristig werden wir sie zu einem super nützlichen Programmierassistenten weiterentwickeln.
Wenn man sich jetzt den Entwicklungsprozess von Claude Code ansieht, folgt er vollständig Schritt für Schritt dem Satz von Dario von damals.
Self-Judging, Billionen Parameter und extrem langes Gedächtnis
Neben dem Coding-Agent enthält dieser Fahrplan auch Vorhersagen über die zugrundeliegende Technologie.
Zum Beispiel im Bereich des Vortrainings haben sie 2021 schwarz auf weiß festgelegt, dass sie ein großes Modell mit 1T (1 Billionen Parameter) und mehr trainieren und sehr große Kontexte oder andere Mechanismen zur Aufnahme riesiger Mengen an Gedächtnis und Erfahrung erforschen wollen.
In der Zeit, in der 175B noch ein riesiges Modell war, haben sie Billionen von Parametern und extrem langes Gedächtnis bereits als Standardinfrastruktur betrachtet.
Noch beeindruckender ist der Teil über menschliches Feedback und Alignment.
In dem Dokument steht deutlich geschrieben:
Selbstbeurteilung des Modells.
2021 haben sie bereits erforscht, wie das Modell sein eigenes Verhalten und die Qualität seiner Ausgaben bewerten kann und wie die eigene Beurteilung des Modells als Feedback-Signal verwendet werden kann. Das ist genau der Kerngedanke des heutigen KI-Feedbacks und der Selbstkorrektur von Inferenzmodellen.
Noch interessanter ist, dass in dem Dokument sogar ein sehr wichtiges Konzept der späteren Forschung an großen Modellen auftaucht:
Test-Time Compute.
Natürlich wurde diese Forschung damals im Kontext von Alignment und Diskriminatorforschung eingeordnet, es war noch ein ziemlicher Weg bis zur späteren Inferenz-Comput-Erweiterung im Stil von o1.
Aber es zeigt zumindest, dass bereits 2021 der Forschungshorizont von Anthropic auch den Rechenaufwand außerhalb des Modelltrainings abdeckte.
Man muss sagen, Neo Lab hat wirklich etwas drauf, kein Wunder, dass Ilya völlig erstarrt ist.
Ich frage mich, was die heutigen Spitzenlabore jeden Tag erleben.
Momente des kalten Schweißes im Unternehmen
Natürlich, da es sich um A\\ handelt, kommt man nicht umhin, über Sicherheitsprobleme zu sprechen.
Aber ich habe festgestellt, dass diese Leute wirklich gerne über Sicherheit diskutieren, sie haben dafür einen sehr langen Teil des Dokuments verwendet.
Als Unternehmen, das seine Existenz der Sicherheit verdankt, hat Anthropic 2021 bereits die Albträume vorhergesehen, mit denen wir heute konfrontiert sind, wenn Agenten überall verbreitet sind.
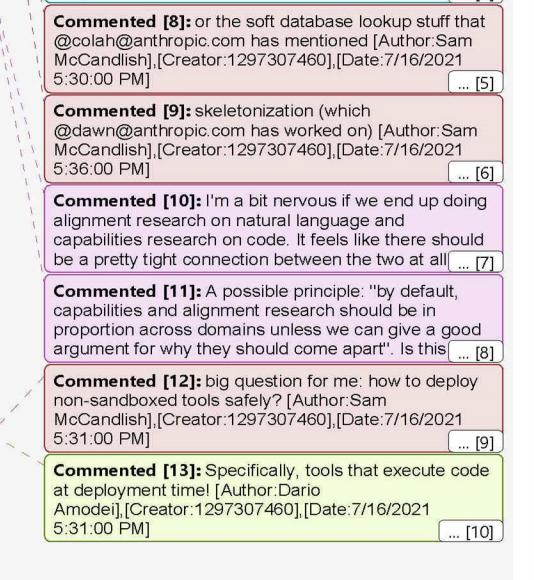
Der Mitbegründer Sam McCandlish hat in einer Anmerkung eine schmerzhafte Frage aufgeworfen:
Wie können wir Tools sicher bereitstellen, die keine Sandbox-Isolierung haben?
Dario hat direkt danach eine Ergänzung hinzugefügt:
Genauer gesagt: Die Tools, die bei der Bereitstellung Code ausführen!
(ps: Im Original steht wirklich ein Ausrufezeichen, dein Dario ist so leidenschaftlich)
Unglaublich.
Wenn KI wirklich direkt im Host-Umgebung Code ausführen, Shell aufrufen und Dateien ändern kann, sind die Folgen unvorstellbar, wenn sie außer Kontrolle gerät oder durch Prompt-Injection angegriffen wird.
Die Themen, über die heute im gesamten Internet diskutiert wird — Rechteerhöhung von Agenten, Flucht aus der Umgebung, Datenverunreinigung — wurden von ihnen bereits 2021 im Zusammenhang mit Sandbox-Grenzen diskutiert.
Vielleicht liegt es wirklich daran, dass sie von Anfang an diesen Weg einschlagen wollten.
Übrigens taucht Amanda auch in diesem Bericht auf, sie ist die interne Philosophin von Anthropic, die vor kurzem sehr populär war.
Sie hat sehr ernst darauf hingewiesen:
Ich mache mir Sorgen, wenn wir Alignment-Forschung im Bereich der natürlichen Sprache betreiben, aber die Fähigkeiten des Modells hauptsächlich im Bereich Code vorantreiben. Diese beiden Forschungsbereiche müssen stets eng miteinander verbunden bleiben.
Wenn wir keine Alignment-Forschung in den Bereichen durchführen, in denen wir die Fähigkeiten verbessern, schränken wir die Gültigkeit der Alignment-Tests ein. Das kann Kettenreaktionen auslösen: Zum Beispiel wird die Alignment-Forschung direkt zu einer einsamen Insel, weil sie nicht früh integriert wurde.
Sie hat sogar direkt vorgeschlagen, ein Unternehmensprinzip festzulegen:
Die Fähigkeitsforschung und die Alignment-Forschung in allen Bereichen sollen proportional synchron voranschreiten, es sei denn, wir können ausreichende Gründe angeben, warum sie getrennt werden sollen.
One More Thing
Ach, ich wusste doch, warum A\\ immer OpenAI einen Schritt voraus ist: Es ist der Vorsprung durch frühe Entwicklung.
Anthropic hat sich in den letzten fünf Jahren voll und ganz darauf konzentriert, an hochwertigen Codesignalen, Verstärkungslernen und Unternehmensarbeitsabläufen zu arbeiten;
Während OpenAI an mehreren Fronten gleichzeitig gekämpft hat: Text-to-Image generieren, Sora-Videos entwickeln, Sprachassistenten bauen, Suchmaschinen entwickeln — das hat ihre Kräfte etwas verteilt.
Aber gerade als alle noch die Unterschiede zwischen den technischen Fahrplänen der beiden Unternehmen analysieren, ist bei OpenAI plötzlich ein unglaublicher Skandal aufgetaucht, der noch absurder ist als ein Hollywood-Film —
Leute, es gibt einen Verräter bei OpenAI!!
Laut der von den US-Bundesanwälten veröffentlichten Anklageschrift wurde der 35-jährige ehemalige Ingenieur im Produktteam von OpenAI, Abdulrahman Alfozan, offiziell entlassen und mit bundesweiten strafrechtlichen Anklagen konfrontiert.
Was hat dieser Kerl getan?
Im Kernkonferenzraum für Führungskräfte im Hauptsitz von OpenAI in San Francisco hat er ein Abhörgerät mit fortschrittlicher Verschlüsselung und Datenübertragungsfunktion, eingewickelt in Toilettenpapier, heimlich in den USB-Anschluss hinter dem Fernsehgerät gesteckt.
Man muss wissen, dass dieser Konferenzraum der Ort ist, an dem Führungskräfte wie Sam Altman wichtige nicht öffentliche Sitzungen abhalten, wo über Geheimnisse der Superintelligenzforschung, unveröffentlichte Produktpläne und Regierungsarbeitsberichte gesprochen wird.
Und dann wurde es so leicht gehackt.
Die Welt ist wirklich ein chaotischer Haufen…
PDF:
https://i.smitop.com/concise-research-roadmap.pdf
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „QbitAI“, Autor: Jay, veröffentlicht mit Genehmigung von 36Kr.