Innerhalb eines halben Jahres wurde die Geschwindigkeit um das Zehnfache gesteigert, Nvidias DLSS 5 zeigt seine überlegene Leistung – wird die Welt des „neurale Renderings“ komplett auf den Kopf gestellt?
Anfang dieses Jahres, als NVIDIA DLSS 5 veröffentlichte, hätten nur wenige Menschen erwartet, dass diese umstrittene Technologie so schnell iterieren und sich weiterentwickeln könnte.
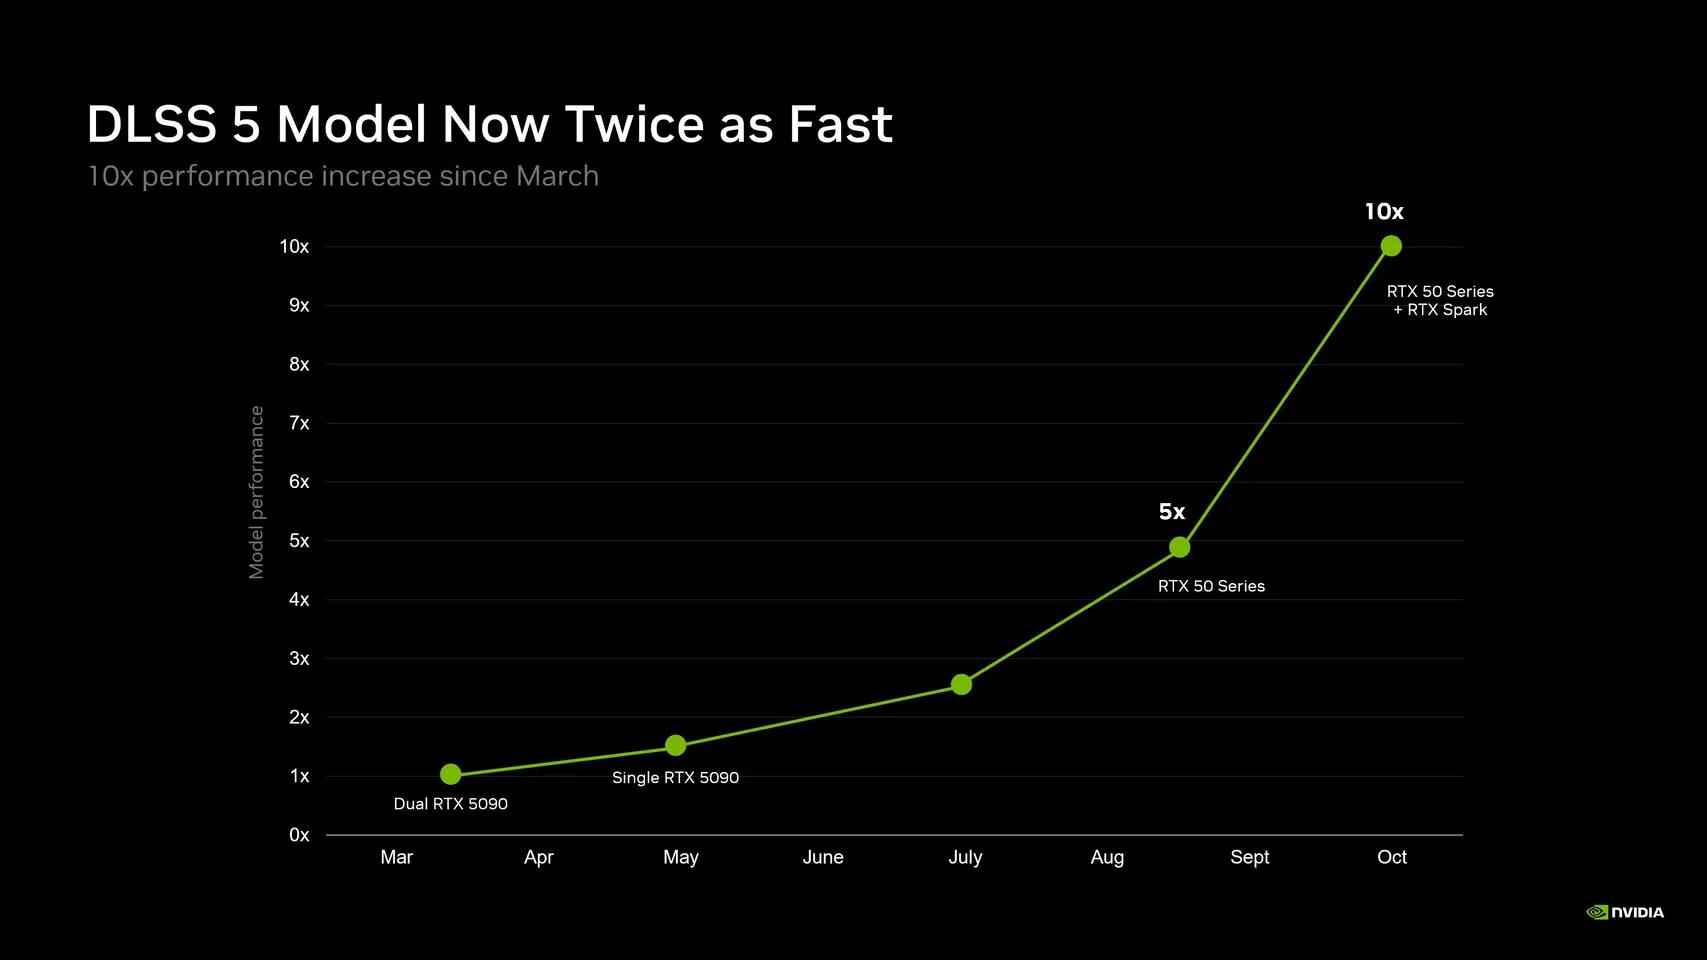
Am 13. Oktober kündigte NVIDIA ein neues Modell-Upgrade für DLSS 5 an: Die Anzahl der Modellparameter wurde um 24 % reduziert, der Videospeicherbedarf sank um 20 %, während die Ausführungsgeschwindigkeit gegenüber der Version vom September erneut verdoppelt wurde. Zusammen mit den vorherigen Optimierungen hat sich die Ausführungsgeschwindigkeit des DLSS 5-Modells in den letzten mehr als einem halben Jahr bereits um Folgendes erhöht:
Ganze 10-fach.
Bildquelle: NVIDIA
Sogar zwei RTX 5090, die bei der ersten Vorstellung erforderlich waren, sind nicht mehr nötig – eine einzige Grafikkarte der RTX 50-Serie reicht aus, um DLSS 5 auszuführen. Ein solches Update geht weit über eine herkömmliche Leistungsoptimierung hinaus.
Man muss bedenken, dass die Verbesserung der Spielgrafik in den letzten Jahrzehnten weitgehend davon abhing, dass die GPU ihre herkömmliche Grafikberechnungsleistung stetig steigerte – von der Rasterisierung bis zum Raytracing war das überall der Fall. Aber von DLSS 4 zu DLSS 5 wird die neuronale (Netzwerk-)Rendering-Technologie zweifellos zu einem Schlüsselfaktor, und dieses Mal wurde die neueste 3D-gesteuerte neuronale Rendering-Technologie eingeführt.
Einfach ausgedrückt bedeutet „neuronales (Netzwerk-)Rendering“, dass neuronale Netze direkt an der Grafikdarstellung beteiligt sind und sogar KI nutzen, um realistischere visuelle Details wie Beleuchtung und Materialien zu erzeugen, anstatt sich vollständig auf die Berechnung durch herkömmliche Grafikalgotithmen zu verlassen.
Nicht nur NVIDIA, nicht nur auf dem PC. Apple hat bereits auf der WWDC im letzten Jahr über Metal 4 die Möglichkeit bereitgestellt, maschinelles Lernen in die Echtzeit-Rendering-Pipeline zu integrieren, und seit der A19-Serie und den M5-Chips des letzten Jahres einen neuronalen Netzwerkbeschleuniger in die GPU aufgenommen; Qualcomm und MediaTek haben ebenfalls erstmals neuronale Rendering-Technologie in ihre neuen Flaggschiff-Chips integriert.
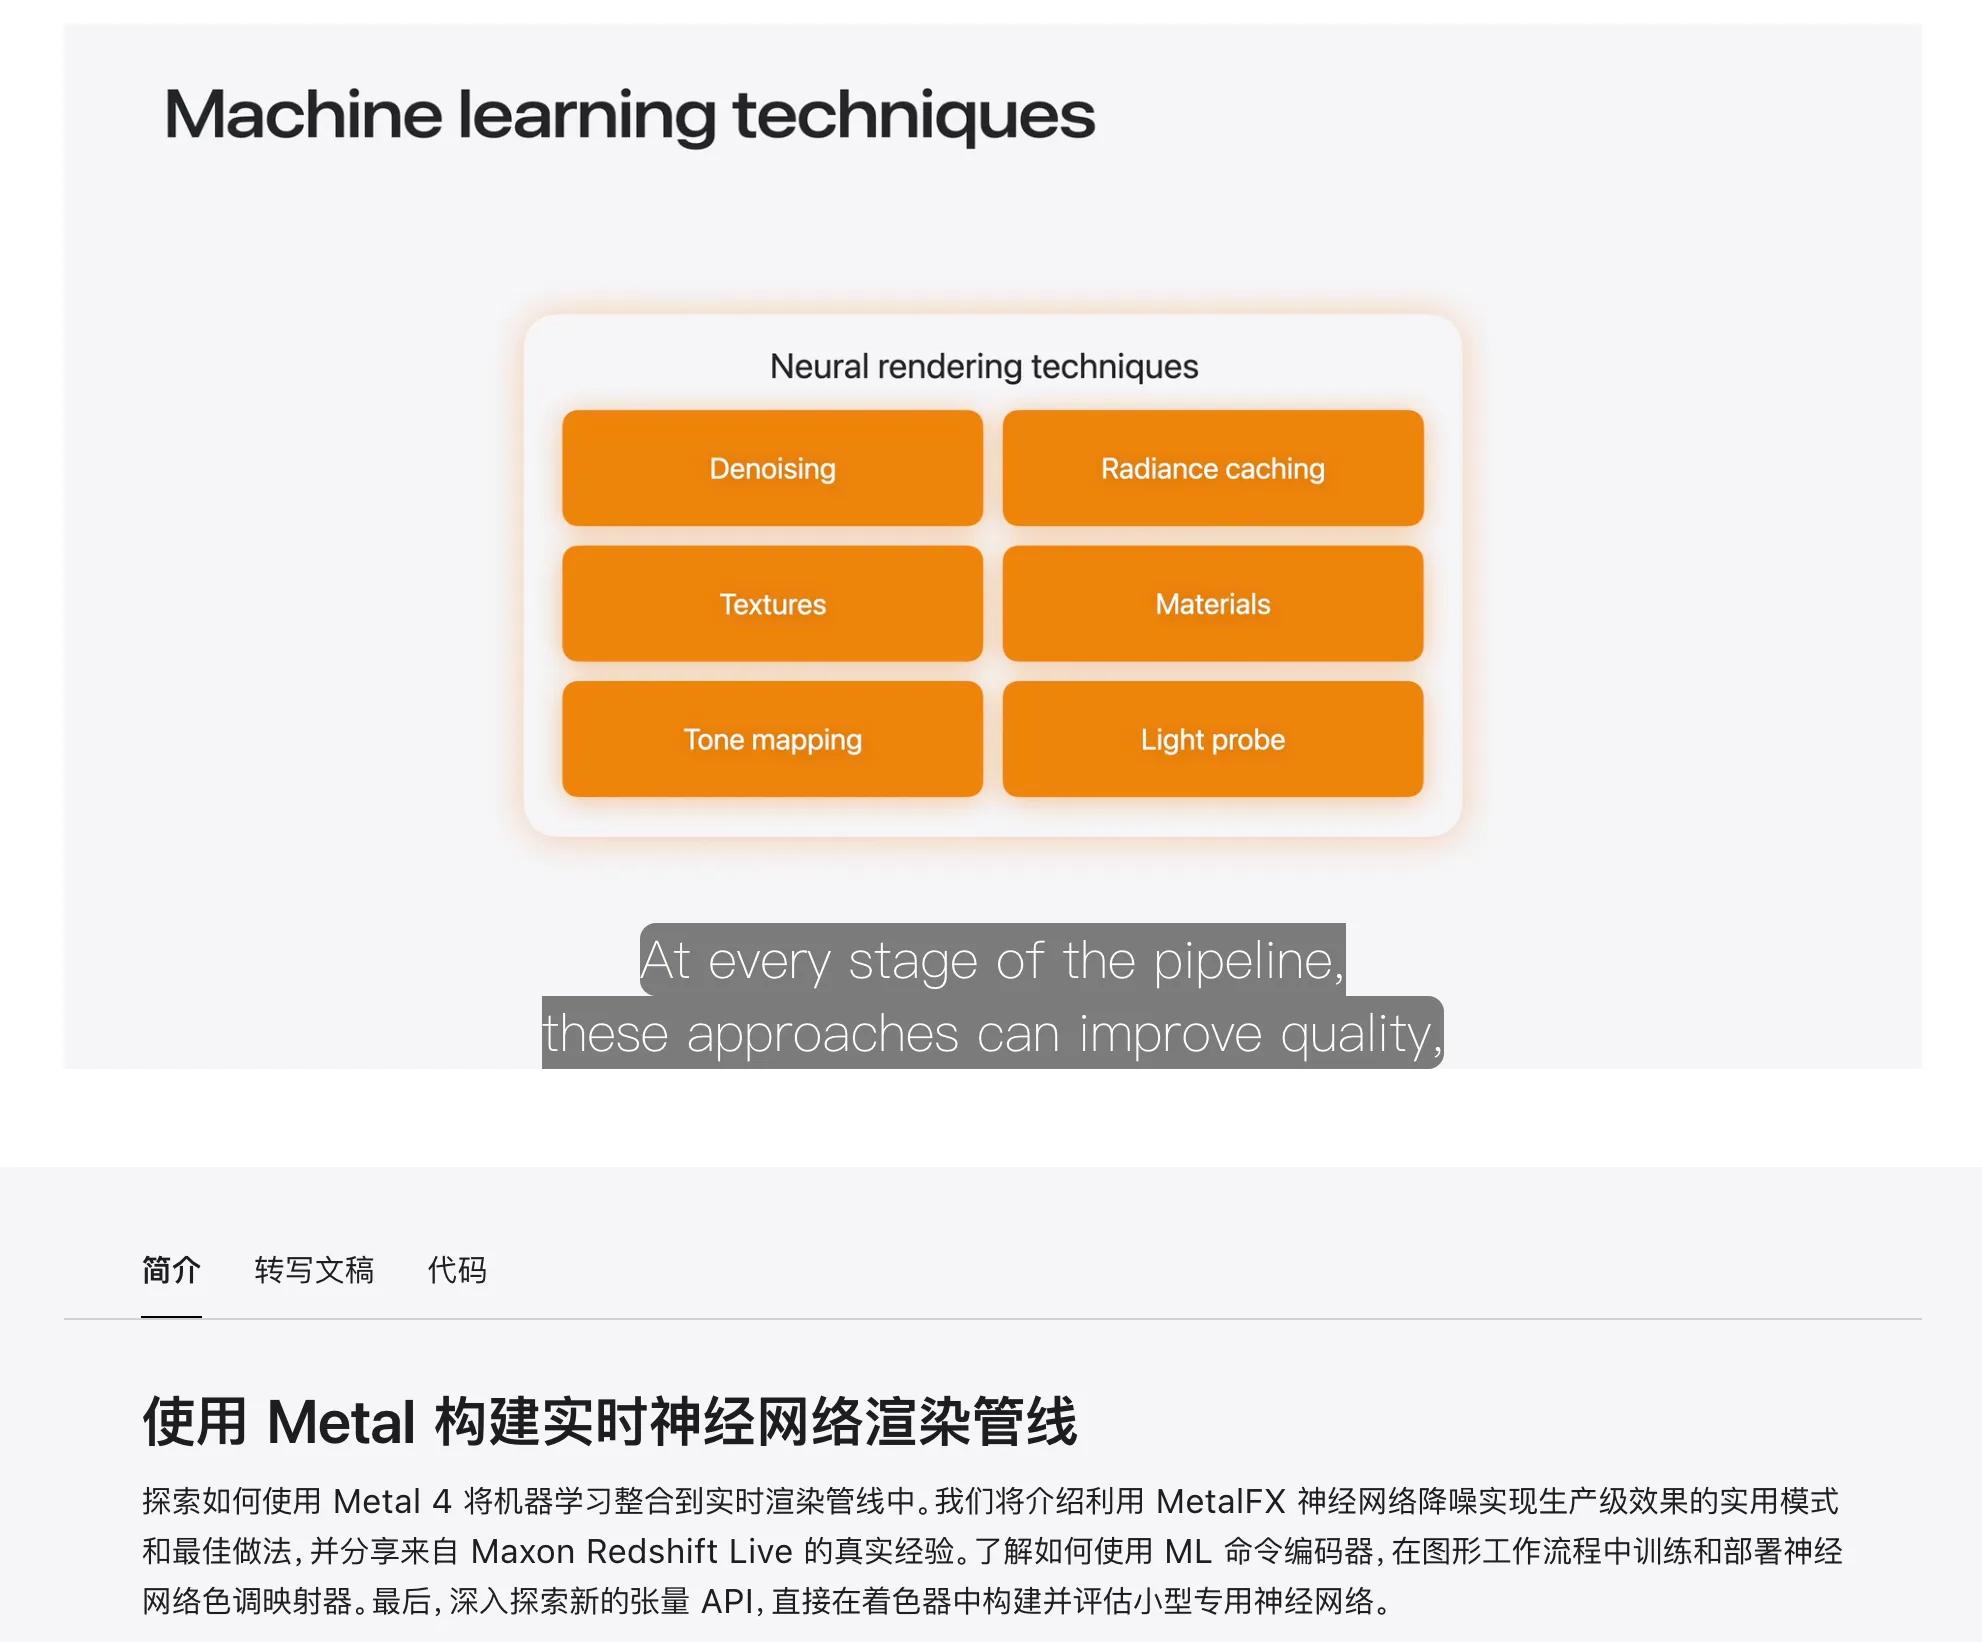
Bildquelle: Apple
Die Implementierungsmethoden und der Umsetzungsstand der einzelnen Unternehmen sind unterschiedlich, aber alle gehen in die Richtung, dass neuronale Netze bzw. KI wirklich in den Kern der Rendering-Pipeline eindringen.
Für die seit Jahrzehnten entwickelte Computergrafiktechnologie bedeutet dies möglicherweise eine tiefgreifendere Veränderung als die bloße Steigerung der GPU-Leistung.
10-fache Geschwindigkeitssteigerung in einem halben Jahr – was verändert neuronales Rendering eigentlich?
Zuerst ist zu klären: Der Schwerpunkt des neuesten DLSS 5-Upgrades liegt auf der Effizienz.
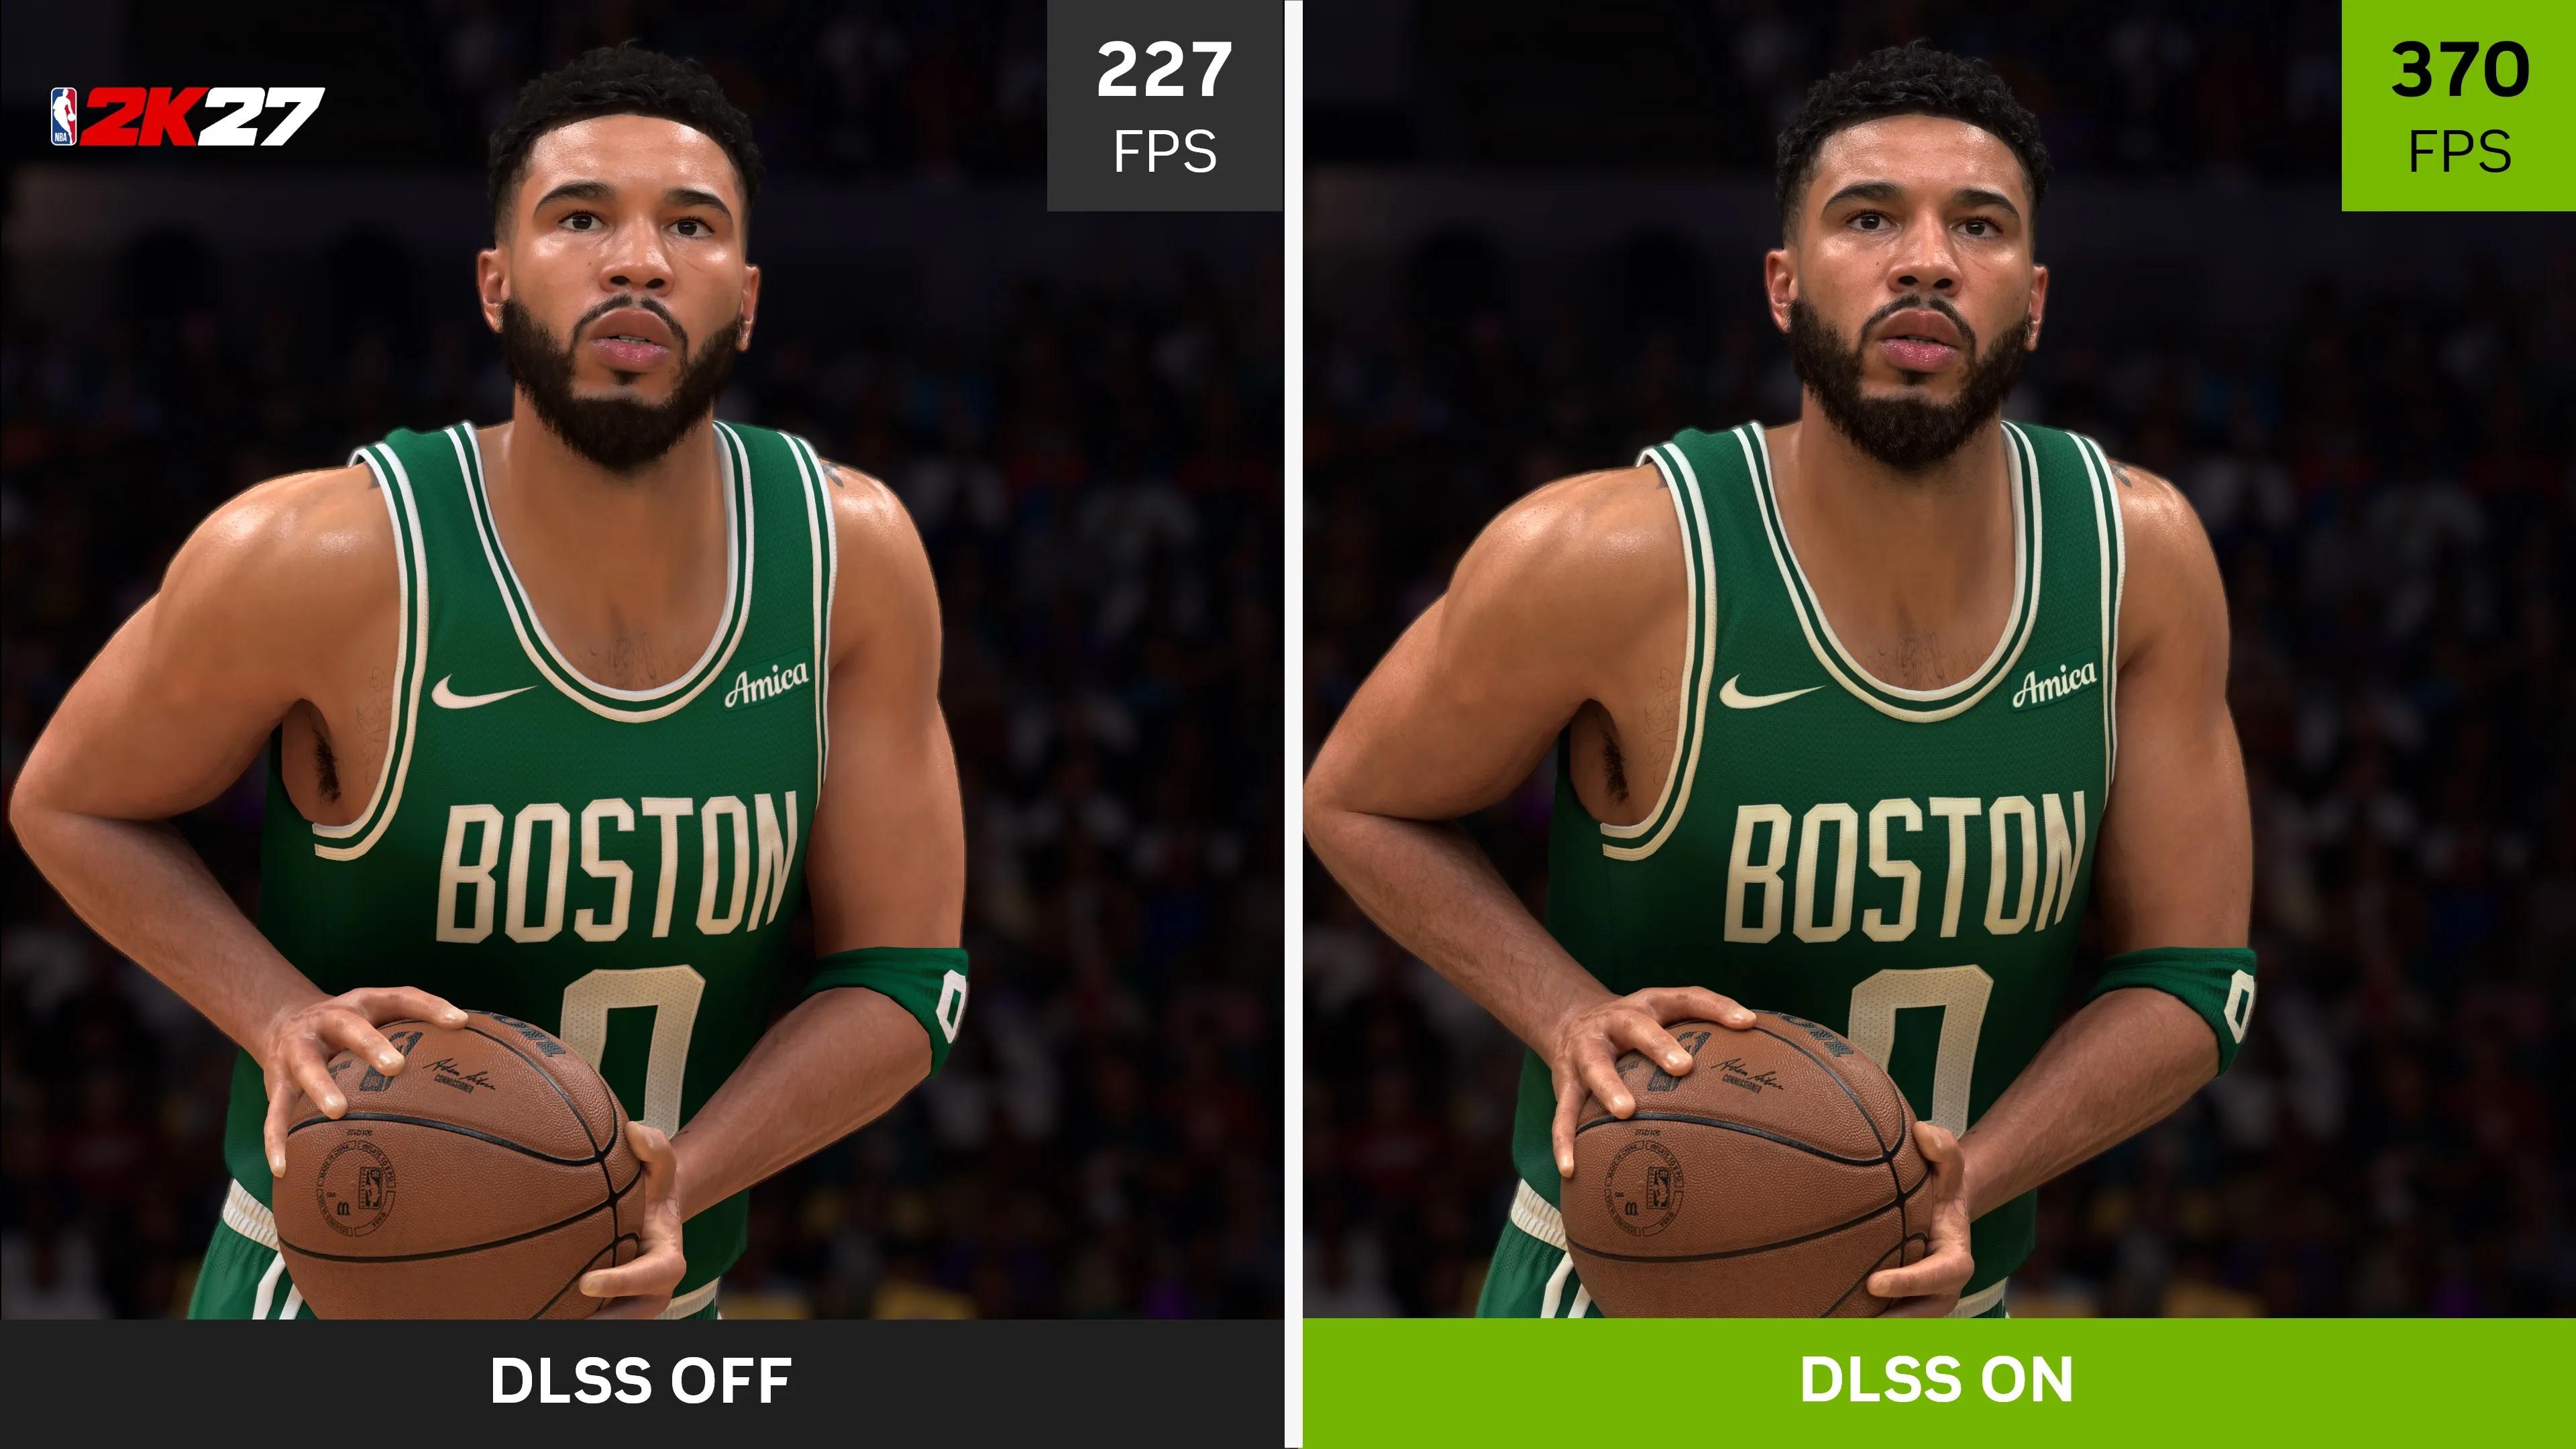
Nach Angaben von NVIDIA wurde durch die gemeinsame Optimierung des neuronalen Netzwerkmodells und der Rendering-Pipeline die Anzahl der Parameter des neuen Modells auf etwa 118 Millionen reduziert, während der GPU-Ausführungsaufwand halbiert wurde, wobei die ursprüngliche visuelle Wirkung im Wesentlichen beibehalten wurde. Nach Testergebnissen kann das neue Modell die Bildrate von *NBA 2K27* um bis zu 40 % steigern.
Bildquelle: NVIDIA
DLSS 5 wird auch zunehmend in mehr Spielen eingesetzt. Neben *NBA 2K27*, das am 16. Oktober erscheint, wird das neue Modell nach und nach auch in *Hogwarts Legacy* und *Where Winds Meet* integriert, und am 23. Oktober wird es an RTX Remix angebunden, sodass auch mehr Remaster-Projekte klassischer Spiele die Möglichkeit erhalten, diese Technologie zu nutzen.
Die 10-fache Geschwindigkeitssteigerung in etwas mehr als einem halben Jahr reicht aus, um zu zeigen, welche großen Fortschritte NVIDIA bei der Modelloptimierung erzielt hat. Natürlich bezieht sich die hier genannte 10-fache Steigerung auf die Ausführungsgeschwindigkeit des neuronalen Rendering-Modells, nicht auf die Gesamtbildrate des Spiels.
Rückblickend auf die letzten Jahre hat NVIDIA von DLSS Super Resolution über Frame Generation bis hin zu Ray Reconstruction stetig versucht, neuronale Netze dazu zu bringen, die GPU bei der Grafikberechnung zu entlasten. Bei der Super Resolution muss die GPU beispielsweise nicht direkt ein vollständiges Bild mit hoher Auflösung rendern, sondern rendert zuerst mit niedrigerer Auflösung und rekonstruiert dann die Details über das neuronale Netz; die Ray Reconstruction nutzt KI, um unvollständige, verrauschte Abtastergebnisse beim Raytracing zu verarbeiten.
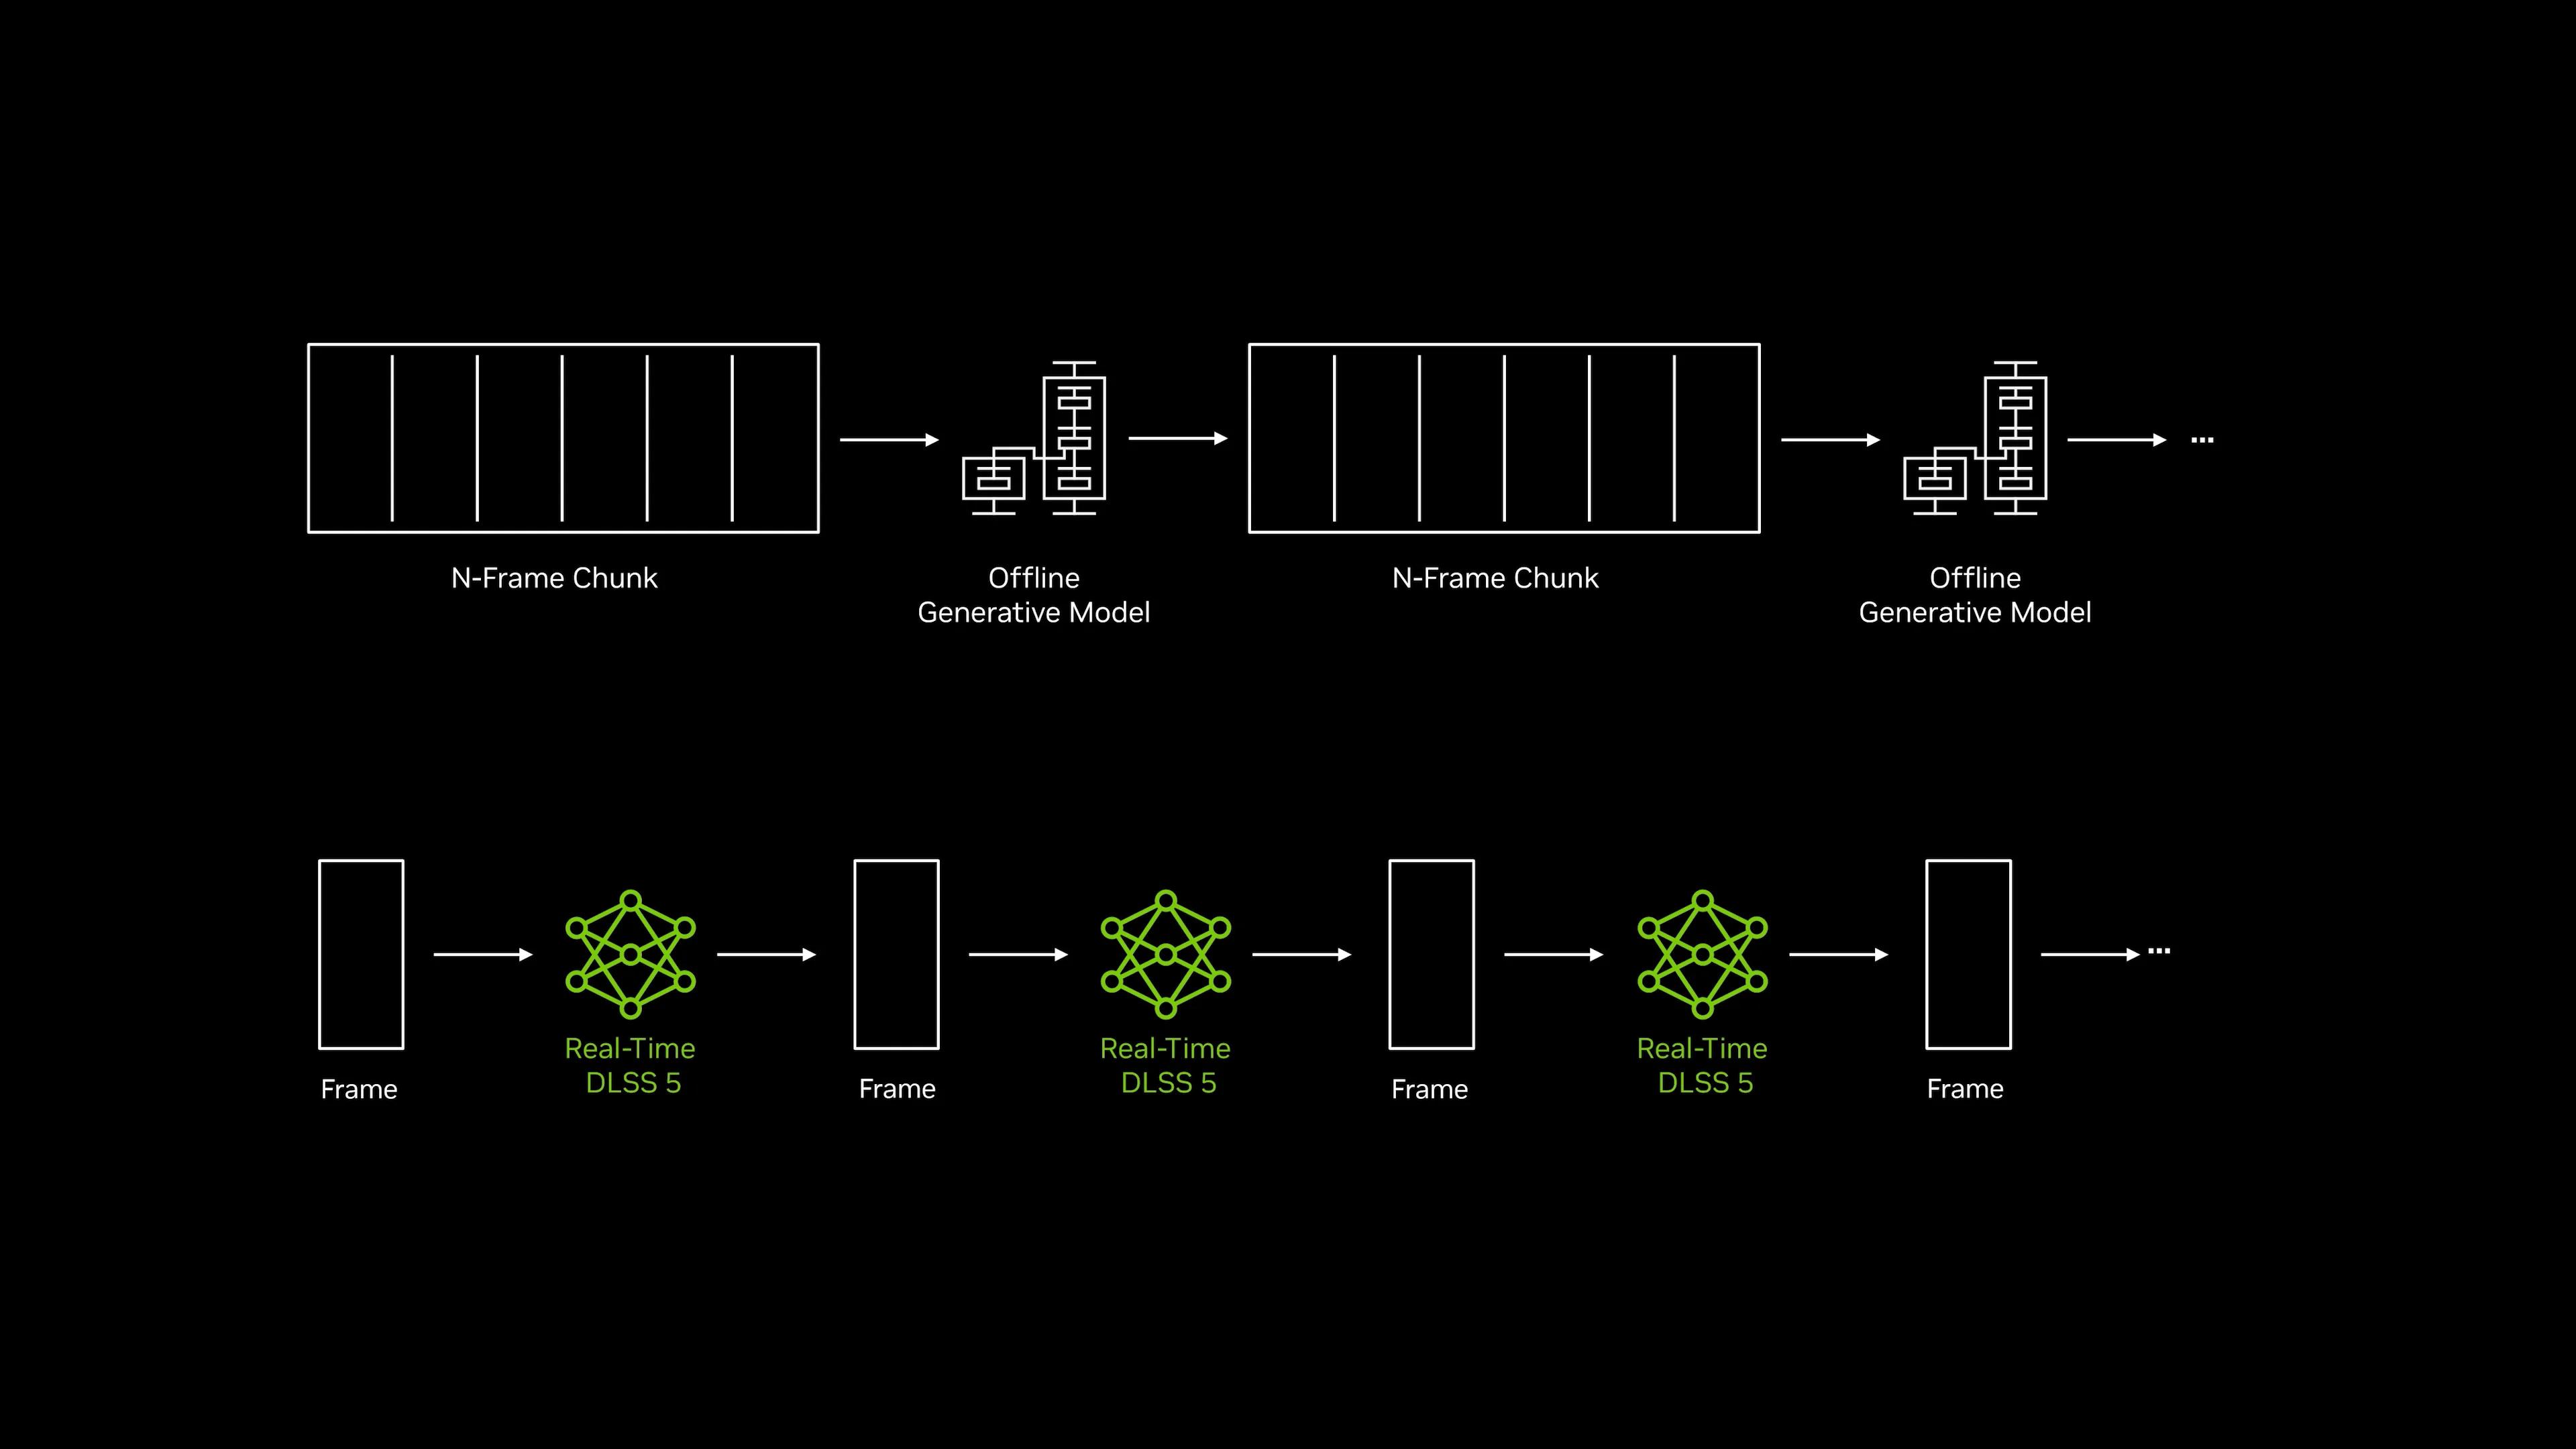
Diese Technologien haben die Berechnungsweise des herkömmlichen Grafikrenderings bereits in gewissem Maße verändert, aber sie dienen hauptsächlich dazu, bereits vorhandene Rendering-Ergebnisse zu rekonstruieren, zu verbessern oder Zwischenbilder zu ergänzen. DLSS 5 geht einen Schritt weiter und nutzt neuronale Netze, um die visuelle Darstellung des Bildes zu erzeugen.
Nehmen wir als Beispiel ein ausreichend realistisches menschliches Gesicht im Spiel: Beim herkömmlichen Grafikrendering sind feine Geometriemodelle, Materialtexturen sowie Berechnungen von Beleuchtung und suboberflächlicher Streuung der Haut erforderlich, um gemeinsam die visuelle Wirkung echter Haut zu simulieren. Theoretisch kann man durch den Einsatz von mehr Modellierungs- und Berechnungsressourcen ein realistischeres Ergebnis erzielen, aber die Kosten steigen entsprechend immer weiter an.
DLSS 5 bietet einen anderen Ansatz. Es erfordert zwar immer noch, dass die Spielengine grundlegende 3D-Strukturen, Materialien und Beleuchtungsinformationen bereitstellt, aber der herkömmliche Renderer muss nicht alle visuellen Details alleine erledigen. Stattdessen ergänzt ein generatives neuronales Netz komplexe Effekte wie Haut, Beleuchtung und Materialien mithilfe des Wissens, das es aus Bildern der realen Welt gelernt hat.
Bildquelle: NVIDIA
Aus dieser Perspektive versucht DLSS 5, die Grenzen des herkömmlichen Echtzeit-Renderings in Bezug auf den Bildrealismus zu durchbrechen. Natürlich erfordert dieses neuronale Rendering selbst zusätzliche Berechnungen, und die diesmal durchgeführte Optimierung senkt genau diesen eigenen Ausführungsaufwand.
Kurz gesagt, was neuronales Rendering wirklich verändert, ist, dass die GPU nicht mehr vollständig auf vorab geschriebene Grafikalgotithmen angewiesen ist, um alle Effekte im Bild schrittweise zu berechnen. Bei einigen komplexen visuellen Problemen können neuronale Netze diese Aufgabe auch durch Lernen, Vorhersagen und sogar Generieren erledigen.
Das bedeutet nicht, dass zukünftige Spielbilder vollständig von KI erzeugt werden. Die geometrische Struktur der Spielwelt, die Position von Objekten, die Bewegungen von Charakteren und viele weitere visuelle Informationen, die streng den Spielregeln folgen müssen, sind nach wie vor auf das herkömmliche Grafikrendering angewiesen. Die wahrscheinlichere Zukunft ist eine allmähliche Verschmelzung von herkömmlichen Grafikalgotithmen und neuronalen Netzberechnungen:
Ersterer übernimmt die Teile, die präzise berechnet werden müssen und klaren Einschränkungen unterliegen, während Letztere einige Aufgaben übernimmt, die näherungsweise gelöst werden können und deren Berechnungskosten sonst sehr hoch wären.
Das erklärt auch, warum neuronales Rendering nicht nur von NVIDIA, Intel und AMD Beachtung findet, sondern auch zu einem neuen Schwerpunkt für Hersteller von Smartphone-Chips wird.
Smartphones umarmen das „neuronale Rendering“ – Qualcomm und MediaTek beschleunigen die Entwicklung
Im Vergleich zu PCs benötigen Smartphones neuronales Rendering sogar noch dringender.
Der Grund ist leicht verständlich: Obwohl die Leistung von Smartphone-GPUs in den letzten zehn Jahren stetig gestiegen ist, können sie aufgrund von Einschränkungen bei Stromverbrauch, Wärmeabfuhr und Speicherbandbreite nicht wie Desktop-Grafikkarten durch stetige Erhöhung der Berechnungsressourcen eine bessere Spielgrafik erzielen.
Insbesondere seit der Veröffentlichung von *Genshin Impact* haben große mobile Spiele wie *Honkai: Star Rail* und *Wuthering Waves* sowie immer mehr PC- und Konsolenspiele, die auf mobile Plattformen portiert werden, die Anforderungen der Spieler an Grafik und Bildrate von Handyspielen erhöht. Die Einführung von Technologien wie Raytracing belastet die GPU zusätzlich.
Das Problem ist, dass das Leistungsbudget, das der Smartphone-GPU zugewiesen werden kann, letztlich begrenzt ist. Hersteller können die Energieeffizienz durch fortschrittlichere Fertigungsverfahren und effizientere Architekturen verbessern, aber sie können die grundlegenden Einschränkungen des dünnen, leichten Gehäuses und der passiven Wärmeabfuhr von Smartphones kaum ändern.
Neuronales Rendering bietet eine andere Möglichkeit.
Da einige komplexe Grafikberechnungen von neuronalen Netzen näherungsweise gelöst werden können, muss die GPU nicht mehr alle Berechnungen mit herkömmlichen Methoden durchführen. Insbesondere Super Resolution, Ray-Denoising und zukünftig komplexere Material- und Beleuchtungsberechnungen haben die Chance, die Berechnungskosten durch neuronale Netze zu senken und bei begrenztem Stromverbrauch eine bessere Grafik zu erzielen.
In gewisser Hinsicht benötigen Smartphones diese Fähigkeit, „Leistung durch Algorithmen zu erzeugen“, dringender als PCs. Dennoch ist es schwieriger, neuronales Rendering auf Smartphones gut umzusetzen.
Die Berechnung durch neuronale Netze selbst verbraucht Rechenleistung, Speicherbandbreite und Strom, und Echtzeitspiele reagieren sehr empfindlich auf Latenz. Bei einer Bildrate von 60 fps steht pro Frame nur ein Gesamtzeitbudget von etwa 16,7 Millisekunden zur Verfügung. Wenn nach der Einführung neuronaler Netze der zusätzliche Aufwand für Modellinferenz und Datenübertragung die Einsparungen beim herkömmlichen Rendering aufhebt, könnte das Endergebnis im schlimmsten Fall sogar nachteilig sein.
Noch problematischer ist, dass in Smartphone-SoCs zwar schon lange NPUs integriert sind, aber die von der GPU beim Rendering erzeugten Daten wie Farbe, Tiefe und Bewegungsvektoren rechtzeitig zur Verarbeitung an das neuronale Netz übergeben werden müssen. GPU und NPU können sich den Systemspeicher teilen, aber die Zusammenarbeit der beiden Recheneinheiten kann immer noch zusätzlichen Speicherzugriff, Datenformatumwandlungen und Aufgabensynchronisation erfordern. Wenn dieser Aufwand nicht gut gehandhabt wird, kann er nicht nur die Latenz erhöhen, sondern auch zusätzlichen Druck auf Bandbreite und Stromverbrauch erzeugen.
Daher müssen die Hersteller von Smartphone-Chips jetzt nicht nur die KI-Rechenleistung der GPU verbessern, sondern vor allem dafür sorgen, dass die neuronale Netzberechnung ausreichend effizient in die Rendering-Pipeline integriert wird.
Die neuen Flaggschiff-Plattformen von Qualcomm und MediaTek in diesem Jahr liefern dafür jeweils unterschiedlich ausgerichtete Lösungsansätze.
Qualcomm hat auf der 6. Generation des Snapdragon 8 Elite die Adreno Neural Fusion-Technologie für neuronales Rendering eingeführt und erstmals spezielle Matrix Cores für Matrixberechnungen innerhalb der Adreno-GPU integriert. Die GPU kann spezielle Hardware für Matrixberechnungen nutzen, um neuronale Netzaufgaben effizienter zu bearbeiten.
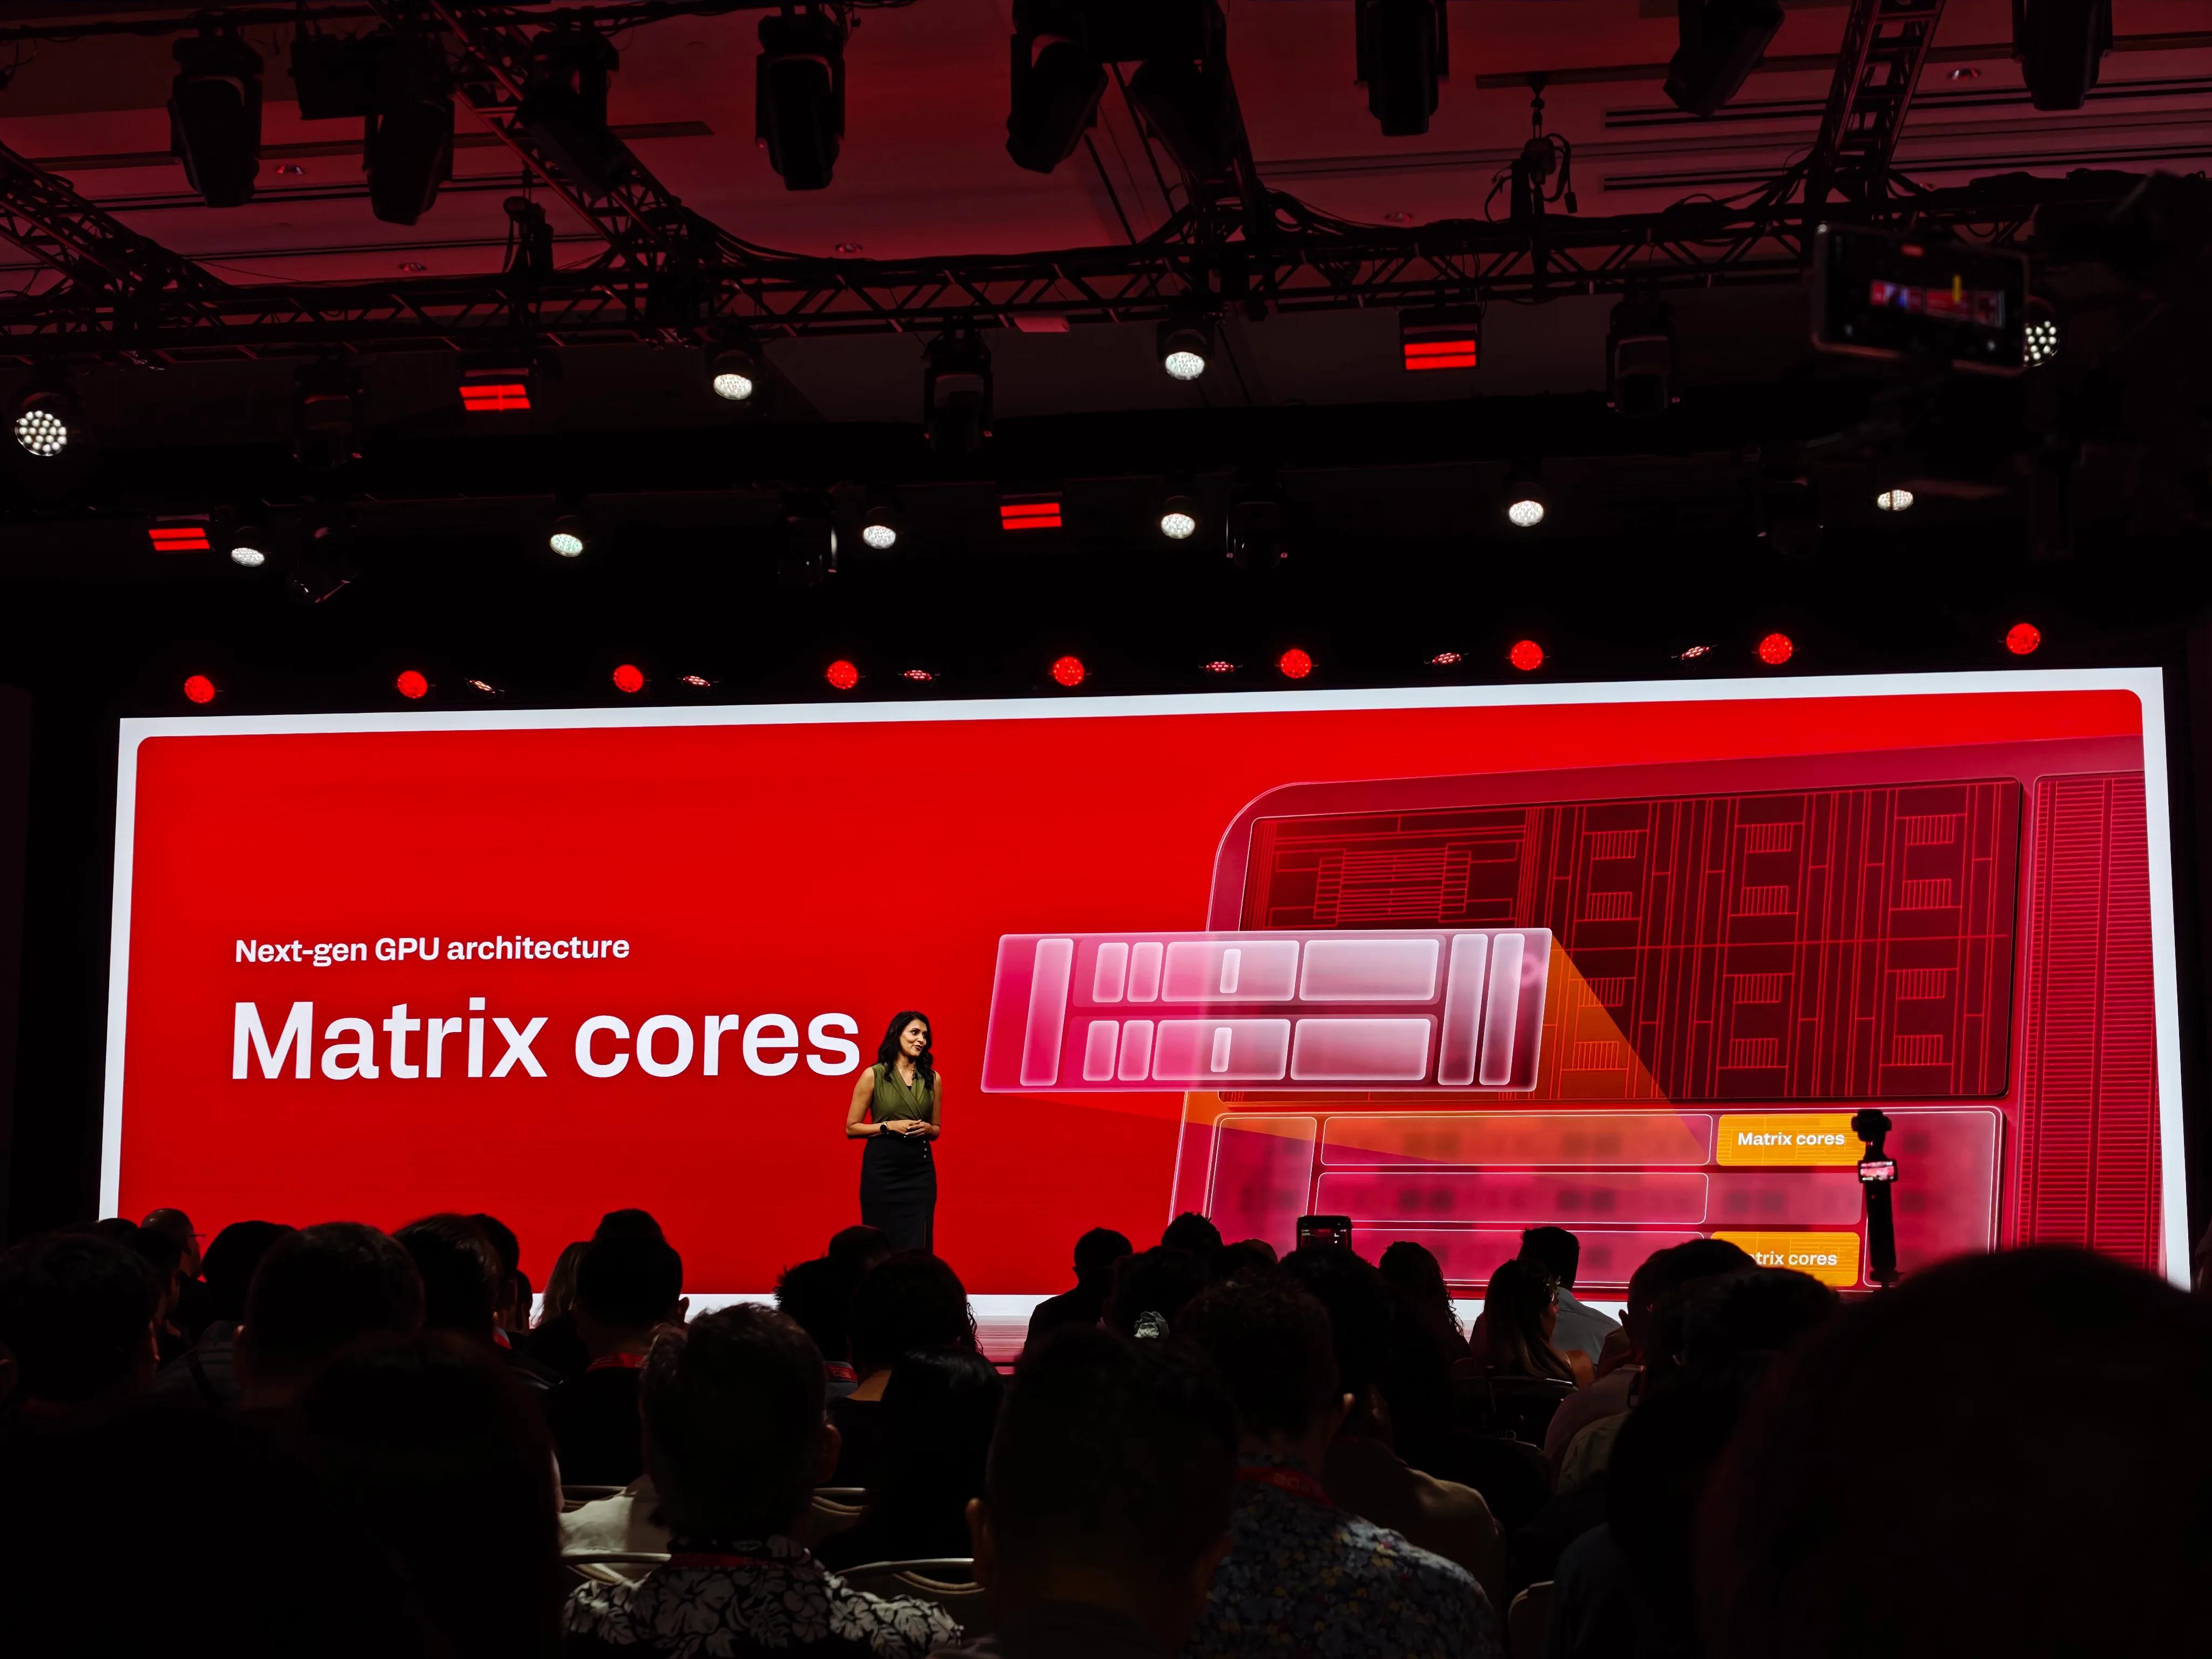
6. Generation Snapdragon 8 Elite, Bildquelle: Leikeji
Beispielsweise befinden sich die für neuronale Super Resolution erforderlichen Daten zu Farbe, Tiefe und Bewegungsvektoren bereits im Grafikrendering-Prozess. Die GPU kann direkt die Matrix Cores für die Inferenz aufrufen, ohne die Daten extra an eine andere Verarbeitungseinheit übergeben zu müssen.
Qualcomm hat dafür zudem einen 18 MB großen On-Chip-Hochgeschwindigkeits-Cache namens Adreno HPM vorgesehen, um die für die Ausführung des Modells erforderlichen Zwischendaten möglichst innerhalb der GPU zu behalten und den Zugriff auf den externen Speicher zu reduzieren.
MediaTek hat auf dem Dimensity 9600 Pro erstmals die Dimensity-Neuronales-Rendering-Architektur eingeführt, deren Kern auf der sofortigen synchronen Verbindung zwischen GPU und NPU basiert, sodass die beiden ursprünglich relativ unabhängigen Recheneinheiten effizienter zusammenarbeiten können.
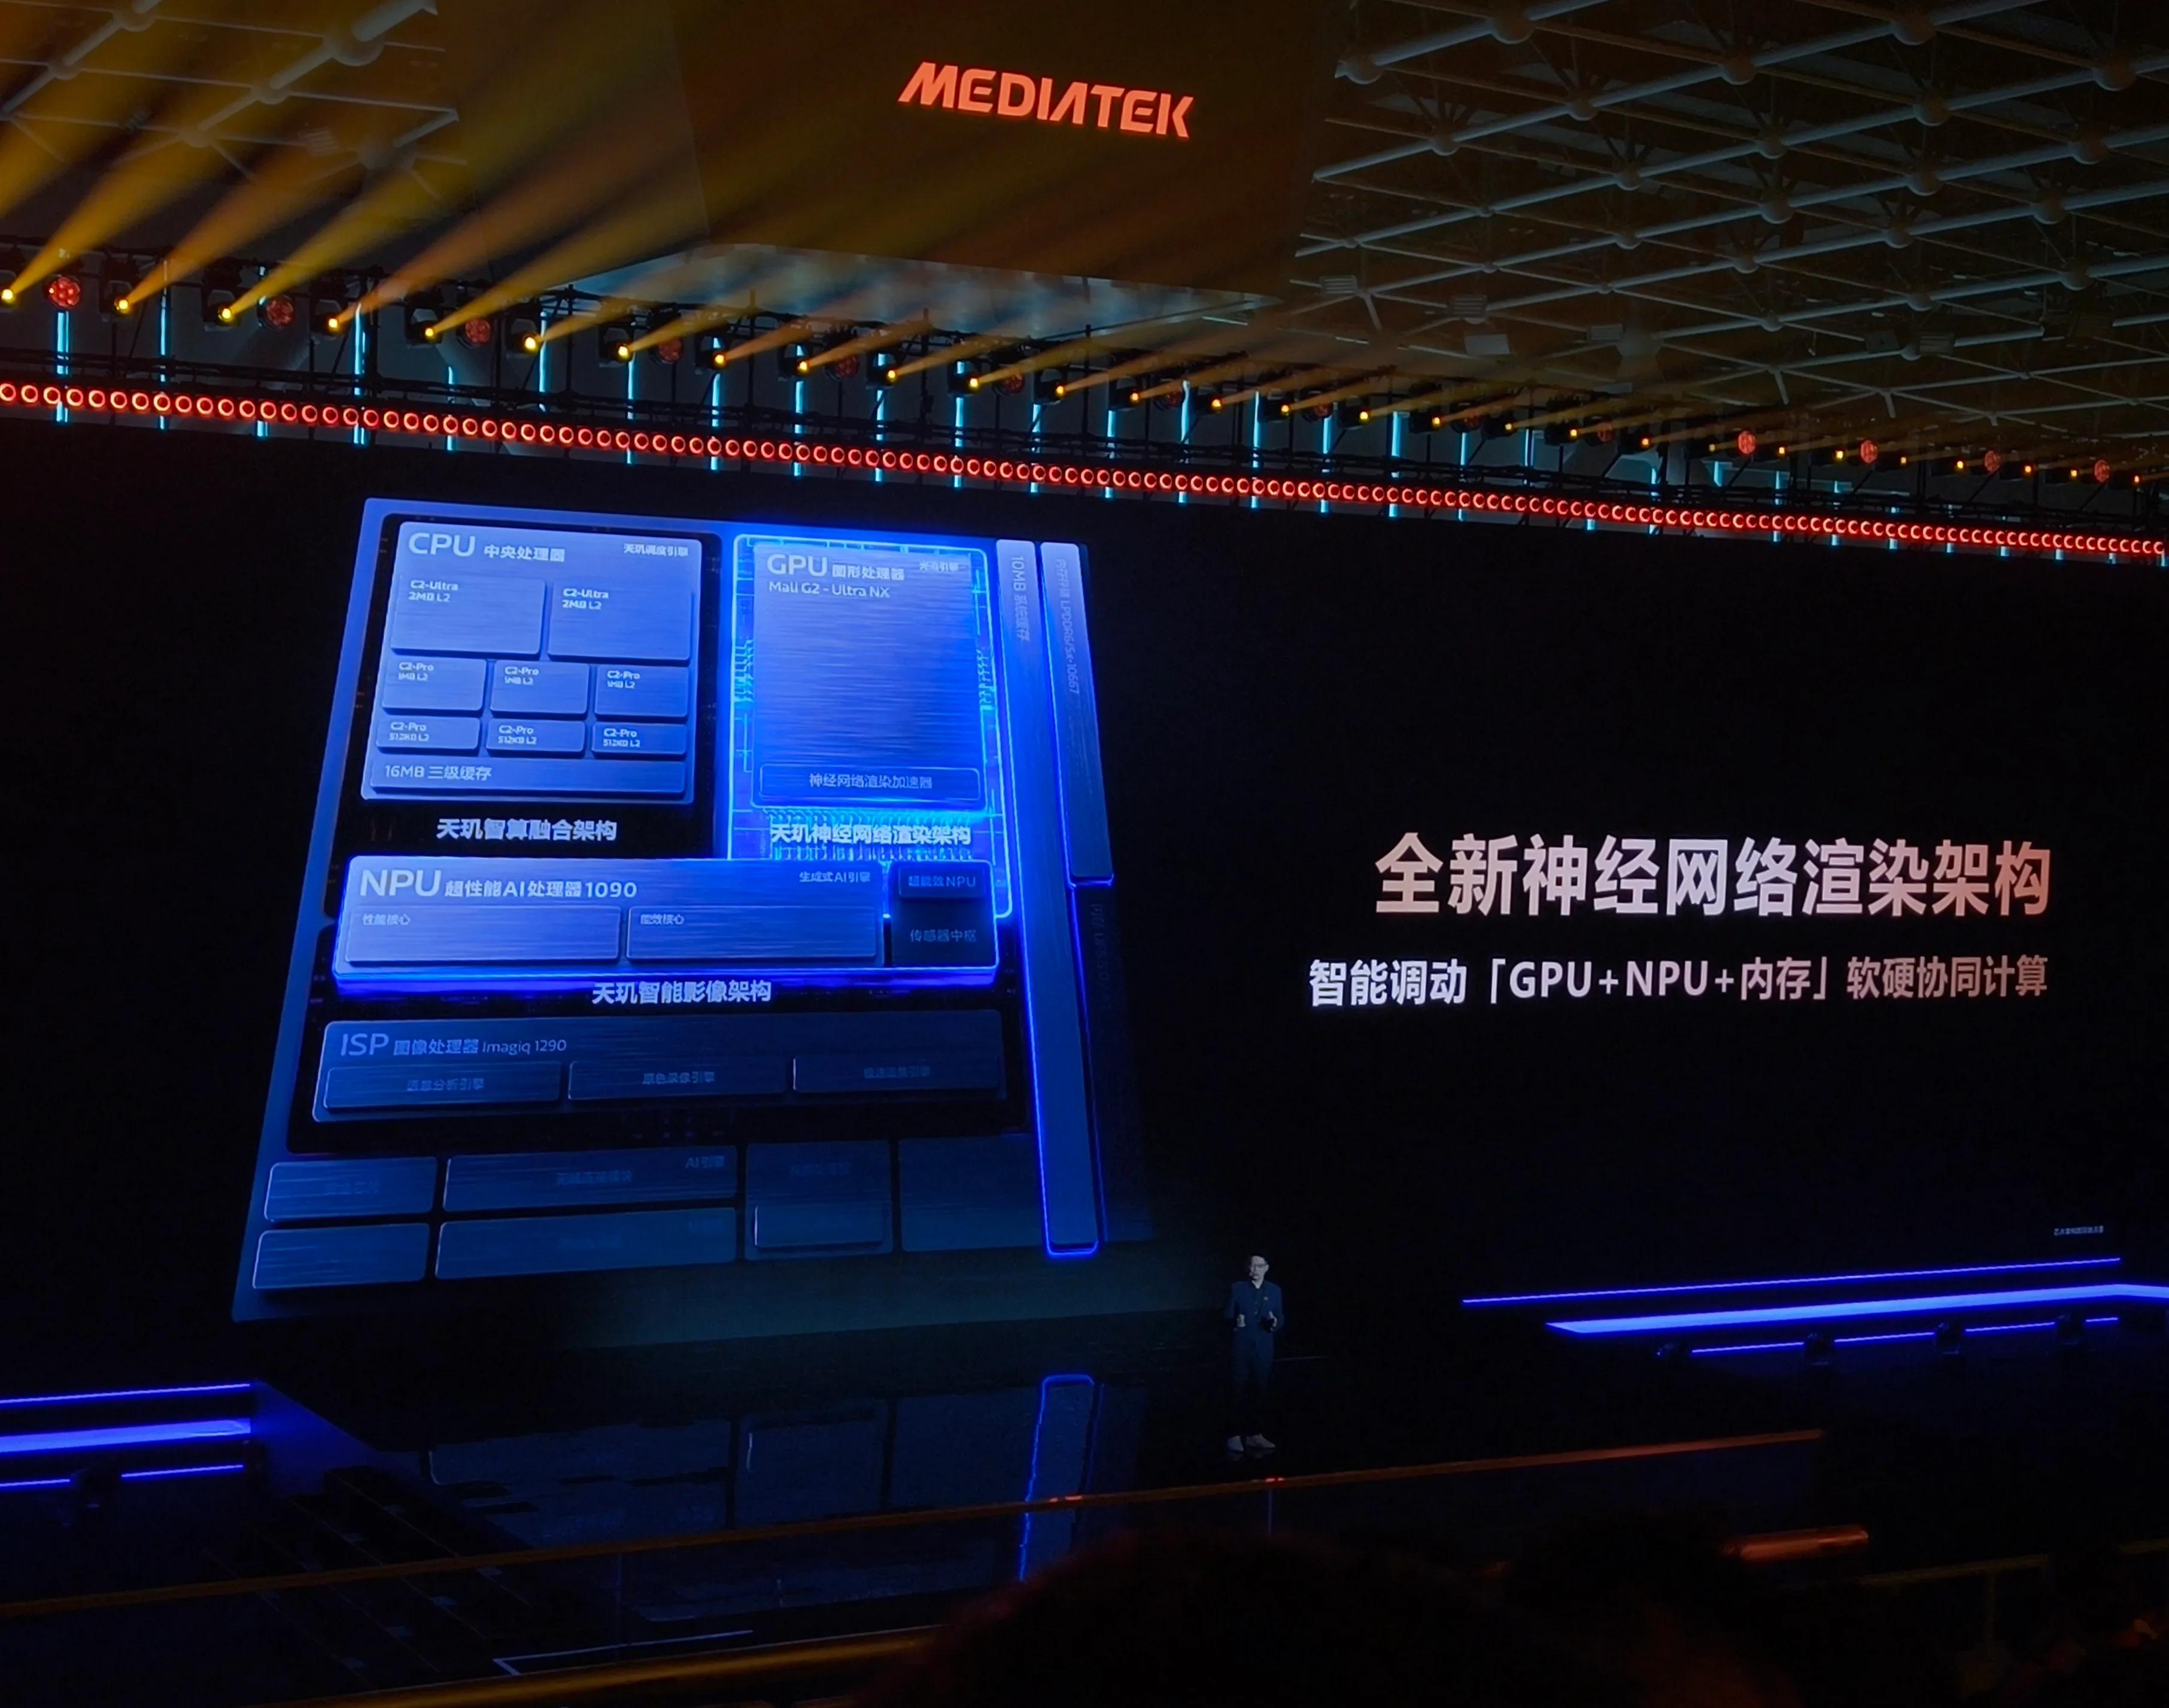
Dimensity 9600 Pro, Bildquelle: Leikeji
Einfach ausgedrückt: Qualcomm legt mehr Wert darauf, die neuronale Netzberechnung direkt in die GPU zu integrieren, während MediaTek darauf abzielt, die Verbindung zwischen