Welche unternehmerischen Chancen können für KI-Anwendungen entstehen, wenn Weltmodelle die Echtzeit-Inferenz realisieren?
In den letzten zwei Jahren haben Video- und Weltmodelle eine rasante Entwicklung erlebt, eine große Anzahl herausragender Startups ist entstanden, und die Evolution der Modelle selbst verläuft extrem schnell. Der Fortschritt der Modelle treibt die Entwicklung von Anwendungen voran – beispielsweise Seedance von ByteDance ist bereits zu seiner Haupteinnahmequelle im KI-Bereich geworden.
Der Fortschritt der Anwendungen stellt wiederum neue strenge Anforderungen an die Infrastruktur. Beispielsweise erfordern Live-Übertragungen mit digitalen Avataren sowie Anwendungen von Weltmodellen im Simulationsbereich nicht nur die einfache Generierung von Inhalten, sondern vor allem die Interaktion mit Nutzern und der „Umgebung“.
Dies führt zu einem grundlegenden Wandel der KI: KI ist nicht mehr nur ein Werkzeug, das durch Prompts gesteuert wird, sondern entwickelt sich zu einem Erlebnis, in das Nutzer eintauchen und mit dem sie in Echtzeit interagieren können.
Echtzeitfähigkeit ist zu einer neuen Anforderung geworden, die KI-Modelle und -Anwendungen an die Infrastruktur stellen. Derzeit fehlt auf dem Markt jedoch eine Plattform, die multimodale Modelle in Produktivumgebungen in Echtzeit ausführen kann.
Dennoch versucht ein Startup namens Reactor, diese Infrastrukturebene aufzubauen. Es möchte Entwicklern mithilfe von SDKs und APIs die Erstellung von echtzeitfähigen interaktiven Anwendungen mit nur wenigen Codezeilen ermöglichen. Seine Plattform unterstützt den Echtzeitbetrieb von Modellen mit über 60 FPS und einer Latenz von unter 40 Millisekunden.
Dies könnte Unternehmer dazu anregen, neue Generationen interaktiver KI-Anwendungen in Bereichen wie Medienunterhaltung, physische KI und Robotik zu entwickeln.
Reactor hat zuvor eine Seed- und Serie-A-Finanzierung in Höhe von 59 Millionen US-Dollar erhalten, die von Lightspeed Venture Partners angeführt wurde, an der sich WndrCo, Amplify Partners, Sky9 Capital, FPV Ventures und weitere Investoren beteiligten. Kürzlich erhielt es eine zusätzliche Serie-A-Finanzierung von NVIDIA und Sapphire Ventures, sodass sich die gesamte Finanzierungssumme auf 74 Millionen US-Dollar beläuft.
Welt-/Videomodelle entwickeln sich zu Echtzeit-Interaktivität und stellen neue Anforderungen an die Infrastruktur
Der technologische Wandel vollzieht sich zuerst auf der Modellebene: Genie 3 von Google DeepMind kann interaktive Welten in 720p mit einer Bildrate von 24 FPS generieren; StreamDiT erreicht eine textgesteuerte Videogenerierung mit 16 FPS auf einer einzelnen H100. Alibaba, Tencent und auch NVIDIA haben bereits interaktive Videomodelle oder Weltmodelle veröffentlicht.
In der frühen Phase der Entwicklung generativer multimodaler Modelle erzeugen diese einmalige, passive Inhalte – fast jeder hat die Erfahrung, mit Prompts massenhaft Inhalte zu erzeugen wie beim zufälligen Ziehen von Karten.
Nach dem Aufkommen interaktiver Videomodelle, insbesondere interaktionsfähiger Weltmodelle, hat sich die Form der Modelle verändert. Diese Modelle sind im Wesentlichen erlernte physikalische Engines. Indem sie Milliarden von Beispielen beobachten, verinnerlichen sie die zugrundeliegenden physikalischen Gesetze und „verstehen“ so, dass Feuer sich ausbreitet, Wasser spritzt und Metall bei Schlag sich verformt. Nutzer agieren in der Umgebung, und das Modell gibt in Echtzeit Rückmeldung bild für bild.
Die neuartigen Modelle haben auch neuartige Anwendungen hervorgebracht: Im Bereich Echtzeitvideo, Spiele und digitale Avatare sind zahlreiche neue Interaktionsformen entstanden.
Die Anforderungen der Modelle an die Infrastruktur haben sich verändert, aber die Infrastruktur, die den Betrieb dieser Modelle in Produktivumgebungen unterstützt, hat nicht Schritt gehalten. Die herkömmliche Infrastruktur wurde für Batch-Anforderungen aufgebaut, und ihre zugrundeliegende Architektur unterscheidet sich grundlegend von der Infrastruktur, die für Echtzeit-Inferenz benötigt wird.
Die für die Echtzeit-Inferenz erforderliche Infrastruktur muss die Zustandspersistenz bei mehreren Interaktionen gewährleisten, über bidirektionale Streaming-Funktionen mit einer Latenz von unter 50 Millisekunden verfügen (der branchenweite durchschnittliche Latenz lag zuvor allgemein über 400 Millisekunden), die Verarbeitung von Echtzeit-Steuereingaben unterstützen und über eine Sitzungsorchestrierungsfunktion verfügen, die Konsistenz bei Tausenden von generierten Bildern aufrechterhält.
Der Bedarf an Rechenleistung steigt damit exponentiell an. Früher lief ein Modell, das mit Prompts Inhalte erzeugt, pro Inhaltsgenerierung nur einmal, während interaktive Welt- und Videomodelle jede Sekunde einer Sitzung ununterbrochen laufen.
Daher hängt das Wachstum des Inferenzbedarfs nicht mehr von der Anzahl der Anfragen ab, sondern ist direkt an die Beteiligungsdauer der Nutzer gebunden. Jede Minute, die ein Nutzer in einem Weltmodell verbringt, entspricht einer Minute Echtzeit-Rechenzeit auf der GPU. Das bedeutet: Egal welches Modell oder welches Anwendungsszenario sich am Ende durchsetzt, die untere Dienstleistungsebene wird direkt von dem Wachstum dieses Sektors profitieren.
Der Aufbau einer Plattform für die Echtzeit-Inferenz von generativen Videos ist der Einstiegspunkt von Reactor, und dieser Bedarf ergibt sich aus dem scharfen Einblick des Gründerteams von Reactor in den Paradigmenwechsel.
Reactor wurde von Alberto Taiuti (CEO) und Bryce Schmidtchen (CTO) gemeinsam gegründet, die beide zuvor als technische Leiter für Apple Vision Pro tätig waren. Taiuti war zuvor Mitbegründer und CTO von Luma AI und hat die unterliegende Infrastruktur für dieses 3D- und Videogenerierungs-Einhorn aufgebaut. Bryce Schmidtchen arbeitete 7 bis 8 Jahre bei Apple und war an der Entwicklung der visionOS-Software beteiligt.
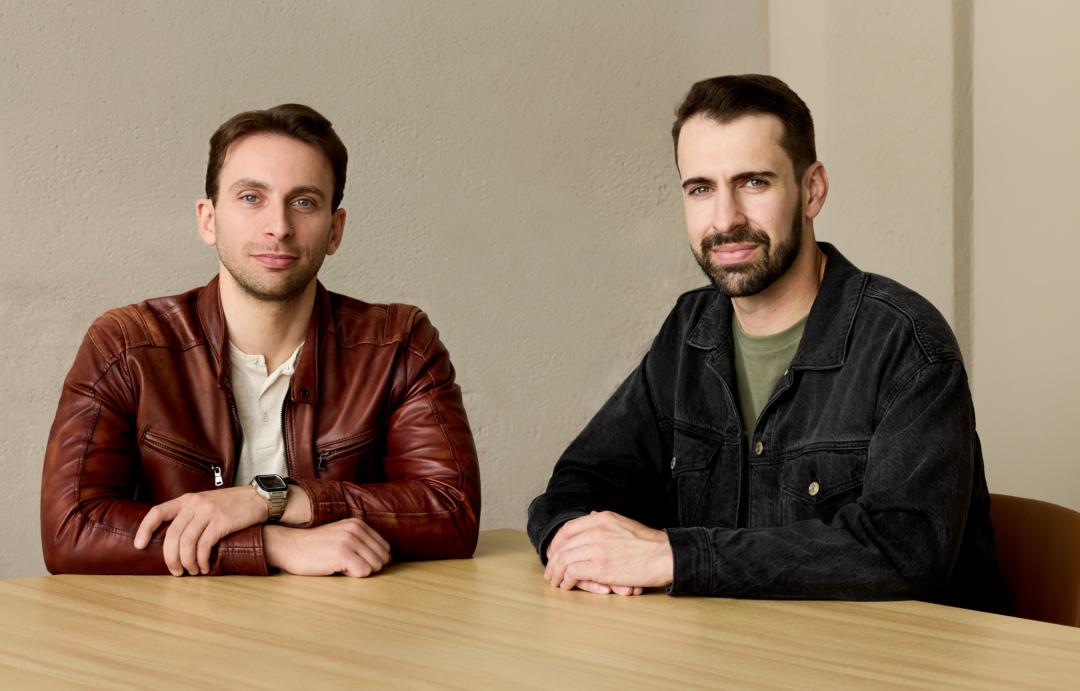
Reactor wurde von Alberto Taiuti und Bryce Schmidtchen gemeinsam gegründet, Bildquelle: Reactor
Ihr Team bringt Ingenieure und Forscher von Apple, Netflix, Meta, Google, Adobe, Replicate und Microsoft zusammen, die über umfassende Erfahrung in Grafiksystemen, Echtzeitsystemen, interaktiven Medien und der Erweiterung von KI-Infrastrukturen verfügen.
Seine Erfahrungen bei Luma AI ließen Alberto Taiuti die Kluft zwischen der Modellentwicklung und dem produktiven Einsatz von Modellen erkennen: Die Forschungsteams konzentrieren sich voll und ganz auf das Modelltraining, sodass ihnen keine Ressourcen und Zeit bleiben, um darüber nachzudenken, wie diese Modelle in großem Maßstab ausgeführt und Inferenz durchgeführt werden kann.
Als die beiden Gründer im Apple Vision Pro Team Produkte entwickelten, dachten sie darüber nach, wie Modelle unter der extremen Leistungsaufnahmebegrenzung auf Endgeräten optimiert werden können und wie sichergestellt werden kann, dass sie mit interaktiven Bildraten bei einer Latenz von unter 10 Millisekunden laufen. Sie sind darauf spezialisiert, die extremen technischen Bedingungen zu optimieren, „ein riesiges System in einen sehr kleinen Raum zu packen“.
Aus ihren vergangenen Erfahrungen erkannten sie, dass mit dem explosionsartigen Anstieg des Bedarfs an multimodalen Modellen und Anwendungen eine Plattform benötigt wird, um die Kluft zwischen Modellentwicklung und produktivem Einsatz zu überbrücken.
Als sie mit der praktischen Umsetzung begannen, stellten sie fest, dass jeder Schritt der multimodalen Modellinferenz – von der unteren Inferenzschicht, der GPU-Cloud-Architektur, dem Streaming- und Netzwerkbereich bis hin zur Entwicklererfahrung, dem API-Design und dem gesamten Architekturmuster des Systems – sich grundlegend von der Inferenz großer Sprachmodelle unterscheidet.
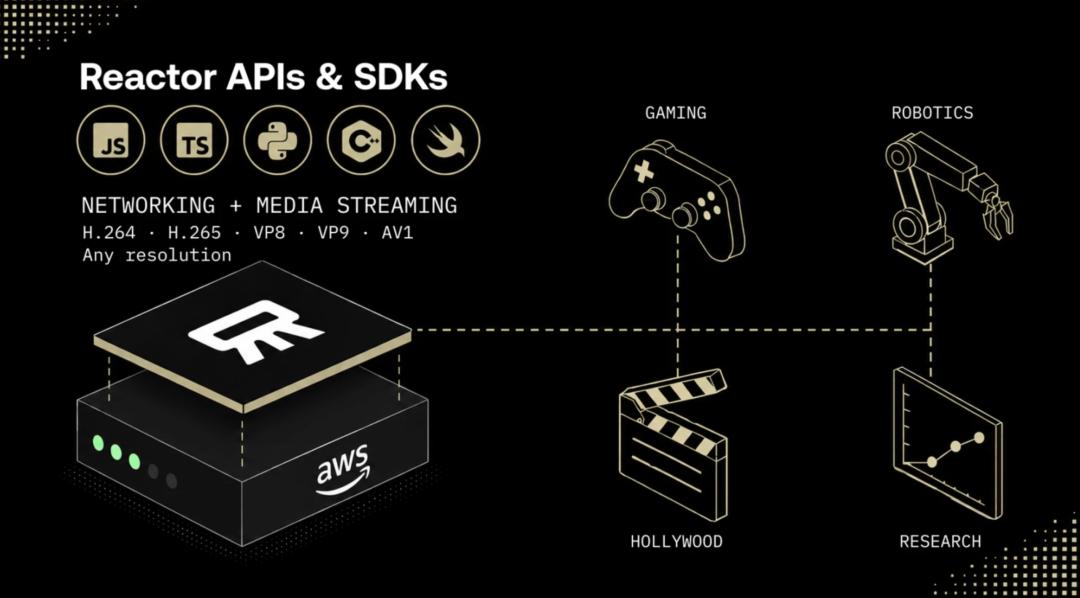
Die von Reactor aufgebaute Plattform basiert auf einer globalen GPU-Cloud, die nach Bedarf zugewiesen werden kann. In der Mitte befindet sich eine selbst entwickelte Inferenz-Engine, die für die latenzarme Inferenz von Video- und Weltmodellen optimiert ist. Die obere Schicht ist mit latenzarmem Streaming ausgestattet, das die Modellausgabe als Echtzeit-Videostream an die Anwendungen zurückgibt.
Diese Plattform ermöglicht es Entwicklern und Unternehmen, Modelle mit einer Bildrate von über 60 FPS und einer Latenz von unter 40 Millisekunden auszuführen. All dies kann über ein einheitliches SDK und API realisiert werden, wodurch die Komplexität der großflächigen Bereitstellung und Skalierung dieser Systeme verborgen wird.
Um diese Leistung zu erreichen, muss das Team von Reactor zahlreiche Details von maschinellen Lernsystemen neu überdenken: wie Kernel-Level-Optimierungen durchgeführt werden und wie die Cloud-Steuerungsebene gestaltet wird. Sogar das Modell muss auf Ebene des maschinellen Lernens verbessert werden, mit angepasstem CUDA-Code und Torch-Optimierungen, um es zu einem Modell zu machen, das den Standards der Produktionsreife entspricht.
Ein praktisches Beispiel ist die Zusammenarbeit von Reactor mit dem AWS Neuron Science Team, um ein Echtzeit-autoregressives Diffusions-Videomodell auf dem AWS-eigenen KI-Chip Trainium zu implementieren.
Im Gegensatz zur gewöhnlichen Videogenerierung liegen die Engpässe von Systemen, die echtzeitinteraktive Video-/Weltmodelle ausführen, nicht nur in der Rechenleistung selbst, sondern auch in Schritten wie der Berechnung der Position von Videobildern, der Aufmerksamkeitsberechnung, dem Kopieren von Caches, dem Speicherverbrauch der Grafikkarte und der Dekodierung.
Die beiden Seiten haben die untere Berechnung über die Neuron Kernel Interface neu geschrieben und fusioniert: Beispielsweise wurde die Berechnung der 3D-RoPE-Positionsverschlüsselung, die ursprünglich etwa 5 Sekunden dauerte, auf 1,8 Millisekunden komprimiert, das Caching-Kopieren von etwa 23 Millisekunden pro Schicht auf 1,9 Millisekunden reduziert und der Prozess, der ursprünglich leicht den Grafikspeicher überlastet, so gesteuert, dass er mit 11 GB HBM auskommt. Am Ende hat das Team die Echtzeit-Videogenerierung auf einem einzelnen Trainium2-Chip erfolgreich ausgeführt.
Auf der Plattform von Reactor sind bereits eine Reihe von Videomodellen und Weltmodellen zusammengefasst, die in Echtzeit ausgeführt werden können. Dazu gehören sowohl Echtzeit-Weltmodelle als auch Weltgenerierungsmodelle mit Aktionssteuerung, Echtzeit-Videomodelle mit synchronisiertem Ton sowie Modelle für Videobearbeitung, digitale Avatare, Generierung von Live-Übertragungen und unbegrenzte Videoströme. Ein großer Teil davon sind chinesische Open-Source-Modelle.
Wenn die Infrastrukturplattform die Echtzeit-Inferenz realisiert, werden neue unternehmerische Chancen im Anwendungsbereich freigesetzt
Reactor wird bereits in der Medien- und Unterhaltungsbranche eingesetzt: Große Hollywood-Studios, Werbeplattformen und Videostreaming-Dienste betreiben aktive Projekte auf der Reactor-Plattform.
Bildquelle: Reactor
Die Gründer haben in einem Blog-Interview Beispiele dafür geteilt, wie ihre Nutzer interaktive Videos zum Erstellen von Anwendungen nutzen. Beispielsweise ist im Bildungsbereich eine Echtzeit-Videodemonstration offensichtlich eine bessere Möglichkeit, als einen Textabschnitt zu lesen, wenn man etwas über ein Thema von der KI erfahren möchte. Zahlreiche Startups nutzen Reactor bereits, um Bildungsanwendungen zu erstellen.
KI-Videobearbeitungsanwendungen werden Prosumer-Anwendungen freisetzen. Nutzer können bei der Bearbeitung von Videos das Ergebnis sofort sehen, statt 5 Minuten auf das Ergebnis einer Änderung warten zu müssen – wenn man in Photoshop eine Änderung vornimmt und dann 5 Minuten warten muss, würde es niemand mehr nutzen.
Interaktive Film- und Spielprodukte bieten filmreife Bildqualität, während Nutzer gleichzeitig Echtzeitsteuerung und Lenkung durchführen können. Sie eröffnen ein neues Medium, eine Mischung aus Film und Spiel.
Schließlich der Bereich Werbung und Marketing: Wenn Nutzer Filme oder andere Inhalte ansehen, kann das System sehr geschickt eine personalisierte Werbung einfügen, die speziell für den jeweiligen Nutzer generiert wurde.
Physische KI und Robotertechnik sind ein weiteres natürliches Anwendungsgebiet von Reactor. Da Roboterstrategien und Weltmodelle immer leistungsfähiger werden, übersteigt der Rechenleistungsbedarf vieler Modelle längst die Grenzen, die Roboter oder autonome Systeme selbst tragen können. Reactor kann diese Modelle in der Cloud ausführen und gleichzeitig Beobachtungsergebnisse und Aktionsanweisungen in Echtzeit zwischen Modell und physischem System übertragen.
Reactor kann Weltmodelle auch als geschlossene Simulationsumgebung betreiben, sodass Roboterstrategien in realistischen und reaktionsfähigen generierten Welten trainiert und bewertet werden können, ohne vollständig auf physische Roboter oder manuell aufgebaute Simulatoren angewiesen zu sein. Sowohl für Open-Source-Modelle als auch für kundenspezifische private Systeme kann das Team Reactor nutzen, um Roboterstrategien und Weltmodelle bereitzustellen, zu bewerten und zu trainieren, ohne selbst eine latenzarme Inferenzinfrastruktur aufbauen zu müssen.
Die Voraussetzung für die Funktionsfähigkeit all dieser Anwendungen sind zwei Faktoren: Die allmähliche Reife von interaktiver Videogenerierung und Weltmodellen sowie eine stabile Plattform, die diese Modelle in Echtzeit ableiten kann. Der gemeinsame Wandel von Modellen und Infrastruktur eröffnet neue Möglichkeiten auf der Anwendungsebene.
Der Aufbau dieser neuartigen Infrastruktur stellt hohe Anforderungen an die Gründer: Sie müssen sowohl die Anforderungen auf Anwendungs- und Modellebene verstehen als auch Erfahrung mit dem Aufbau und der Lösung von Infrastrukturproblemen haben. Solche Gründer sind eher in der Lage, neue Probleme zu entdecken und zu lösen.
Für die Gründung von Unternehmen in diesem NeoCloud-Bereich sind der Fortschritt der Modelle, technologische Durchbrüche bei Chips und neuartige Anwendungen vorteilhaft. Denn dieser Bereich liegt auf der Basisschicht des gesamten Ökosystems, und die Entwicklung des Ökosystems fördert sein Wachstum.
Seine Wettbewerbsvorteile bestehen möglicherweise nicht nur aus Größe, Rechenleistungsreserven und Technologie, sondern vor allem aus dem extremen Erlebnis, das Entwicklern und Kunden geboten wird. Es handelt sich um eine umfassende Fähigkeit, die Kerntechnologien umfasst. Gründer müssen es als Produkt entwickeln, nicht nur als Technologie.