7 Personen, 5 Monate – Anthropic hat eine Git-Alternative entwickelt
Git, das Versionskontrollwerkzeug, das Programmierer seit 20 Jahren beherrscht, wurde überraschenderweise durch ein neues System ersetzt, das von Anthropic selbst entwickelt wurde.
Und alles wurde von nur 7 Ingenieuren und Claude, der tief in die Entwicklung eingebunden war, vollendet.
In 5 Monaten entwickelte Anthropic das interne Quellcode-Kontrollsystem Scion, das dazugehörige Code-Review-Tool Antique und mehrere andere verwandte Systeme von Grund auf neu und schloss die Migration des gesamten monolithischen Code-Repositorys von Git zu Scion ab.
Was bedeutet das? Einige wenige Personen haben mit Hilfe von KI in nur wenigen Monaten ein neues System entwickelt, das Git, das sie seit Jahren intern nutzen, direkt ersetzt. Das ist absolut unglaublich! Da kann man nicht umhin, den Ausruf „RIP GIT“ zu machen.
Warum sollte man selbst einen Git-Ersatz entwickeln?
Der Grund ist einfach: Das Ausmaß der KI-gestützten Programmierung bei Anthropic ist so groß geworden, dass die ursprüngliche Entwicklungsinfrastruktur kaum noch mithalten kann.
Daten von Anthropic zeigen, dass im Mai dieses Jahres durchschnittlich etwa 2500 Code-Änderungen pro Tag zusammengeführt wurden. Im September hat diese Zahl bereits 30.000 überschritten, was einem Anstieg von mehr als dem 12-fachen in nur 4 Monaten entspricht. Darüber hinaus erwartet Anthropic, dass dieses Wachstum kurzfristig nicht nachlassen wird. Das potenzielle Bedürfnis nach Code-Zusammenführungen ist praktisch unbegrenzt: Jedes Mal, wenn ein Engpass behoben wird, steigt die Code-Produktion weiter an.
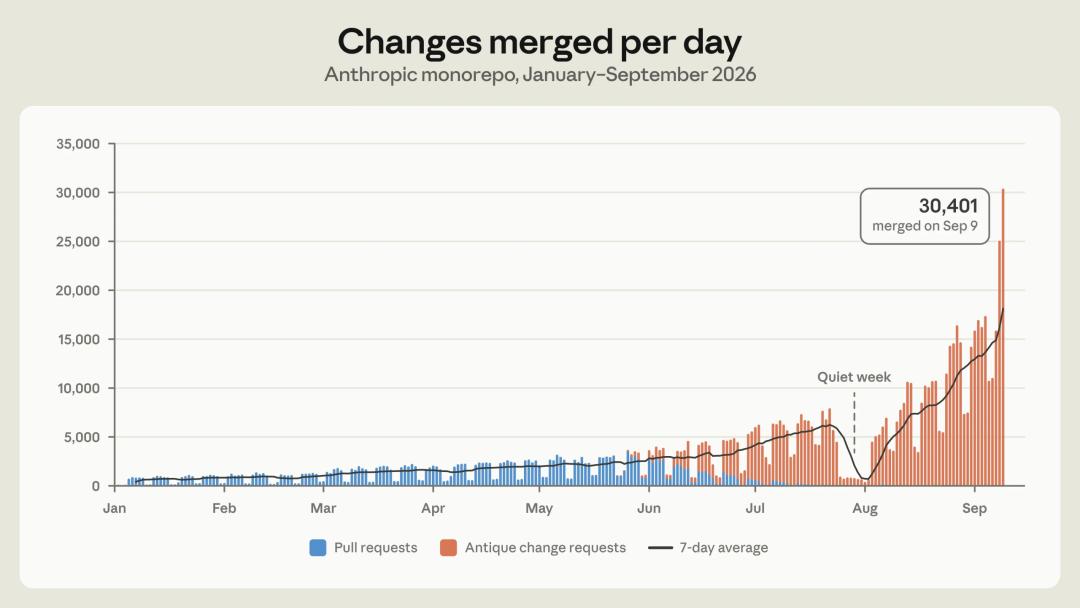
Aufgrund des praktischen Drucks entwickelte Anthropic ein internes Versionskontrollsystem und migrierte das gesamte Monorepo (monolithische Code-Repository) innerhalb von fünf Monaten vollständig von Git zu Scion.
Anthropic beschrieb den gesamten Prozess in seinem neuesten Blogbeitrag ausführlich.
I. Das stetig wachsende Monorepo
Bevor wir Scion vorstellen, ist es notwendig zu erläutern, wie speziell die Arbeitslast von Anthropic ist. Das Ausmaß, in dem Claude zum Schreiben von Software verwendet wird, übertrifft das der allermeisten Unternehmen bei weitem. Dabei stoßen Tools, die für den menschlichen Entwicklungsmaßstab ausgelegt sind, an ihre Grenzen. Die Quellcode-Kontrolle ist nur ein Beispiel dafür.
Anthropic erwartet, dass kurzfristig nicht viele Unternehmen auf das gleiche Problem stoßen werden. Aber mit der zunehmenden Verbreitung von KI-Programmierwerkzeugen werden andere Unternehmen wahrscheinlich nicht lange brauchen, um auf ähnliche Engpässe zu stoßen. Das ist auch der Grund, warum wir uns entschieden haben, die Design- und Entwicklungserfahrung von Scion zu teilen.
Git ist ein dezentrales System. Jeder Klon erzeugt eine vollständige, unabhängige Kopie des Code-Repositorys. Selbst vollständig offline können Entwickler Code-Unterschiede berechnen, den Commit-Verlauf einsehen, die Änderungshistorie einer einzelnen Code-Zeile verfolgen und jede beliebige Version auschecken. Für die allermeisten Code-Repositorys ist dieses Design sehr sinnvoll und ein wichtiger Grund, warum Git zum Industriestandard geworden ist.
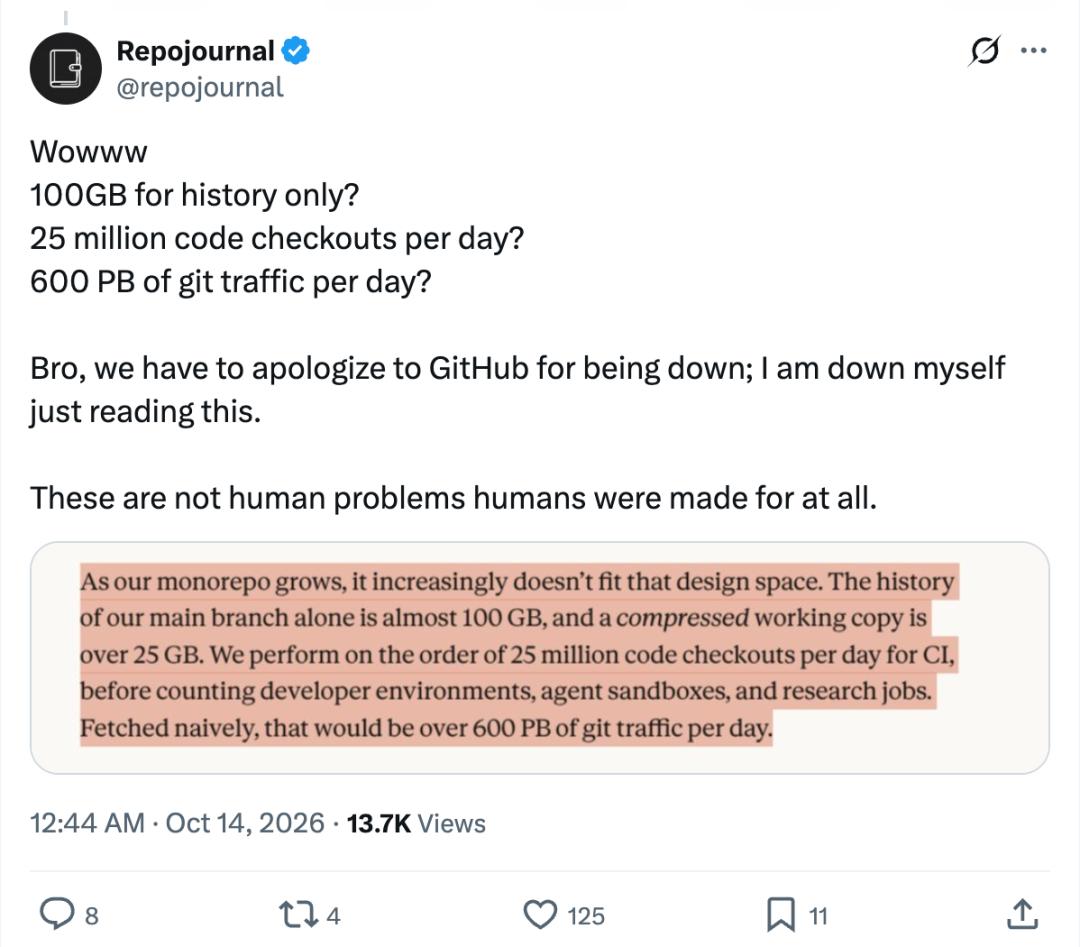
Aber mit dem stetigen Wachstum des Monorepos von Anthropic wird das Design von Git zunehmend schwerer zu erfüllen. Derzeit beträgt die historische Datenmenge nur des Hauptzweigs fast 100 GB, und die komprimierte Arbeitskopie übersteigt 25 GB. Allein das CI-System führt täglich etwa 25 Millionen Code-Checks durch, ohne die Entwicklungsumgebungen, Agent-Sandboxes und Forschungsaufgaben zu berücksichtigen. Wenn alle benötigten Daten jedes Mal direkt von Git abgerufen werden, würde das tägliche Datenübertragungsvolumen über 600 PB betragen.
Natürlich bietet Git auch Funktionen zur Verarbeitung von Teilen der Repository-Daten, wie flache Klone, Sparse Checkouts und Promisor Remote. In der Branche gibt es auch gängige Methoden zur Bewältigung großer Monorepos, z. B. das Einrichten interner Git-Spiegel oder das Speichern von Momentaufnahmen des Code-Repositorys im Objektspeicher.
Anthropic hat alle diese Methoden ausprobiert. Bei höchster Auslastung wurden sogar Hunderte von internen Git-Spiegel-Servern betrieben. Diese Lösungen haben eine Weile geholfen, aber mit dem stetigen Anstieg der Code-Zusammenführungen werden sie zunehmend schwerer zu warten. Zwischen zwei Aktualisierungen der Momentaufnahme wird der Abstand zwischen der Momentaufnahme und der neuesten Version des Hauptzweigs immer größer. Gleichzeitig erfordert die Ausführung von Operationen wie diff und blame, die auf historischen Informationen basieren, in teilweise geklonten Repositorys immer mehr Wartungsaufwand.
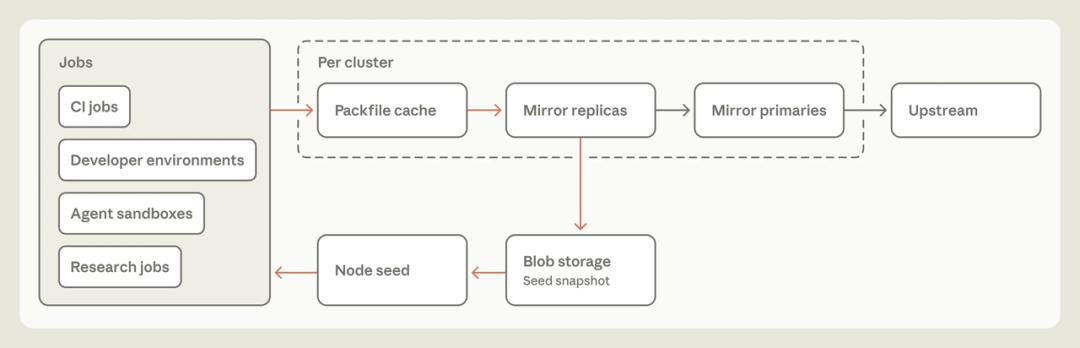
Typische Architektur zur Erweiterung der Git-Code-Check-Fähigkeit.
Später überprüfte Anthropic seine Nutzungsweise neu und stellte ein Problem fest: Wie die meisten Unternehmen hat Anthropic Git eigentlich ständig als zentrales System verwendet, wobei die gesamte Entwicklungsarbeit um ein einziges autoritatives Code-Repository herum stattfindet. Aber fast alle Clients sind Agenten und automatisierte Aufgaben, die ohnehin ständig online sind. Die Funktionen, die Git für verteilte und Offline-Entwicklung bietet, schränken die Skalierbarkeit des Systems ein, wenn das Code-Repository immer größer wird.
Daher begann Anthropic zu überlegen: Wie würde ein Quellcode-Kontrollsystem aussehen, das von Anfang an auf die Eigenschaft ständig onlineer Agenten ausgelegt ist?
II. Quellcode-Kontrolle für den Agent-Maßstab
Da Agenten zunehmend Code schreiben, ändern sich viele traditionelle Annahmen in der Softwareentwicklung. Anthropic berücksichtigte diese Änderungen bei der Gestaltung von Scion vollständig und verfolgte daher in mehreren Kernprinzipien andere Ansätze als Git. Natürlich ist die Quellcode-Kontrolle für extrem große Monorepos nicht neu. Googles Piper und Metas Sapling haben reichhaltige Erfahrung gesammelt, auf die Anthropic bei der Entwicklung von Scion ebenfalls zurückgriff.
Scion folgt hauptsächlich den folgenden Designprinzipien.
1. Der Client ist ständig online.
Git geht davon aus, dass der Client offline arbeiten muss, und behält daher eine vollständige Kopie des Code-Repositorys lokal. Aber fast alle Clients von Anthropic sind Agenten und automatisierte Aufgaben, daher wurde Scions Client und Kommunikationsprotokoll um einen ständig zugänglichen Server herum entworfen. Der Client ruft die Daten ab, die er benötigt, direkt vom Server ab.
2. Client und Server übernehmen unterschiedliche Aufgaben.
In Git kann jeder Client als vollwertiger Git-Server fungieren. Scion hingegen überlässt den Großteil der Arbeit dem Server, einschließlich der Abfrage von Dateiverläufen und Blame-Informationen, des Erstellens von Commits sowie der Durchführung von Zusammenführungen und Rebases. Der Client ist nur dafür verantwortlich, einen lokal begrenzten Cache für Objekte zu verwalten, Dateien aus der Arbeitskopie auf die Festplatte zu schreiben, Änderungen im Dateisystem zu überwachen und eine benutzerfreundliche Schnittstelle bereitzustellen. Der Client selbst braucht kaum komplexe Berechnungen durchzuführen, daher werden lokal weit weniger Daten gespeichert.
3. Ein vollständiger Quellcode-Kontrolldienst kann viele neue Anwendungen unterstützen.
In Git müssen CI-Aufgaben oder andere Tools, die Informationen aus dem Code-Repository abfragen möchten, z. B. wer eine bestimmte Code-Zeile zuletzt geändert hat oder welche Beziehung zwischen zwei Commits besteht, normalerweise eine lokale Kopie des Repositorys selbst verwalten. Eine andere Möglichkeit besteht darin, sich auf APIs zu verlassen, die von bestimmten Anbietern bereitgestellt werden, aber diese APIs können möglicherweise nicht alle Fragen beantworten. Scion macht alle Funktionen zur Abfrage von Quellcode, die von Clients verwendet werden, als APIs öffentlich zugänglich. Auf diese Weise können viele Aufgaben Abfragen direkt durchführen, ohne dass ein lokales Repository erforderlich ist.
Das interne automatisierte binäre Lokalisierungs- und Code-Rollback-Pipeline von Anthropic ist ein Beispiel dafür. Ohne diese kostengünstige, programmgesteuert aufrufbare Möglichkeit zum Zugriff auf Quellcode wären diese Tools im aktuellen Maßstab kaum funktionsfähig.
4. Alle Komponenten müssen horizontal skalierbar sein.
Früher betrieb Anthropic bis zu Hunderten von Git-Spiegel-Servern, die enorme Rechenressourcen verbrauchten. Sobald die Größe des Code-Repositorys die Festplatten- oder Arbeitsspeicherkapazität eines einzelnen Spiegelservers übersteigt, wird die weitere Skalierung zudem sehr schwierig.
Scion speichert die Repository-Daten verteilt, und jede Komponente kann unabhängig skaliert werden. Es gibt keine vollständig materialisierte Kopie des gesamten Code-Repositorys im System, auch nicht auf den Servern. Scion hat keinen Mechanismus, der den Git-Packfiles (komprimierten Objektpaketen) entspricht, sodass keine zugehörigen Wartungsarbeiten am Repository ausgeführt werden müssen.
5. Commits müssen leichtgewichtig sein, inkrementell verarbeitet werden können und keine Sperren erfordern.
In Git committen Entwickler Code zuerst lokal und teilen dann die Änderungen per Push. Alle Commits, Rebases und Zusammenführungen in Scion werden serverseitig ausgeführt, sodass kein Push erforderlich ist. Aber dadurch muss der Server diese Operationen schnell verarbeiten können. Die Kosten für das Erstellen von Commits und das Aktualisieren zugehöriger Datenstrukturen müssen proportional zur Größe der aktuellen Code-Änderung sein, nicht mit der Größe des gesamten Repositorys wachsen. Andernfalls wird der Server früher oder später mit der Geschwindigkeit der Code-Commits nicht Schritt halten können.
Der Entwicklungsprozess von Scion minimiert zudem die Verwendung von Refs. Refs sind Verweise auf Commits, wie Zweige und Tags, wobei normalerweise nur notwendige Verweise wie der Hauptzweig oder die Veröffentlichungszweige beibehalten werden. Da globale Daten, die von allen Servern gemeinsam konsistent gehalten werden müssen, in Zukunft wahrscheinlich zu einem Skalierungsengpass werden.
6. Arbeitskopien können weggelassen werden, und beim Auschecken werden standardmäßig nur die benötigten Daten abgerufen.
Anthropics Monorepo ist extrem groß, und das CI führt täglich mehrere zehn Millionen Code-Checks durch. Daher möchten sie unnötige Check-Operationen so weit wie möglich vermeiden. Wenn beispielsweise eine CI-Aufgabe den Unterschied zwischen einem Commit und seinem Merge-Basispunkt berechnen muss, kann sie direkt den Scion-Server abfragen. Viele Schreibaufgaben können das Auschecken von Code überspringen und vollständig über APIs abgeschlossen werden.
Das Protokoll von Scion ist hauptsächlich um Sparse Checkouts und virtualisierte Checkouts herum entworfen. Sparse Checkouts enthalten nur die Verzeichnisse, die der Client explizit benötigt, während virtualisierte Checkouts Dateien nur laden, wenn sie wirklich benötigt werden. Auf diese Weise wird selbst wenn die Aufgabe Dateien auf der Festplatte verwenden muss, nur der Inhalt abgerufen, der tatsächlich gelesen wird.
III. Funktionsweise von Scion
Nachdem wir diese Designprinzipien verstanden haben, schauen wir uns nun an, wie Scion sie umsetzt. Diese Erfahrungen können nicht nur für andere Quellcode-Kontrollsysteme verwendet werden, sondern auch für andere Teile des Softwareentwicklungsprozesses hilfreich sein.
Datenstrukturen
In Scion heißt die grundlegende Arbeitseinheit Changeset (Änderungssatz), ein Eintrag im Write-Ahead-Log (vorausschreibendes Protokoll).
Ein Changeset speichert die meisten gängigen Informationen, die auch in Git-Commits enthalten sind, aber die Daten sind anders organisiert. Ein Git-Commit speichert einen Zeiger auf einen Verzeichnisbaum, während ein Changeset eine Liste von Dateien speichert, die sich gegenüber dem ersten übergeordneten Commit geändert haben, sowie inhaltsadressierbare Zeiger auf die komprimierten Dateiinhalte im Objektspeicher. Changesets werden serverseitig erstellt und sind nach der Erstellung sofort im gesamten System zugänglich.
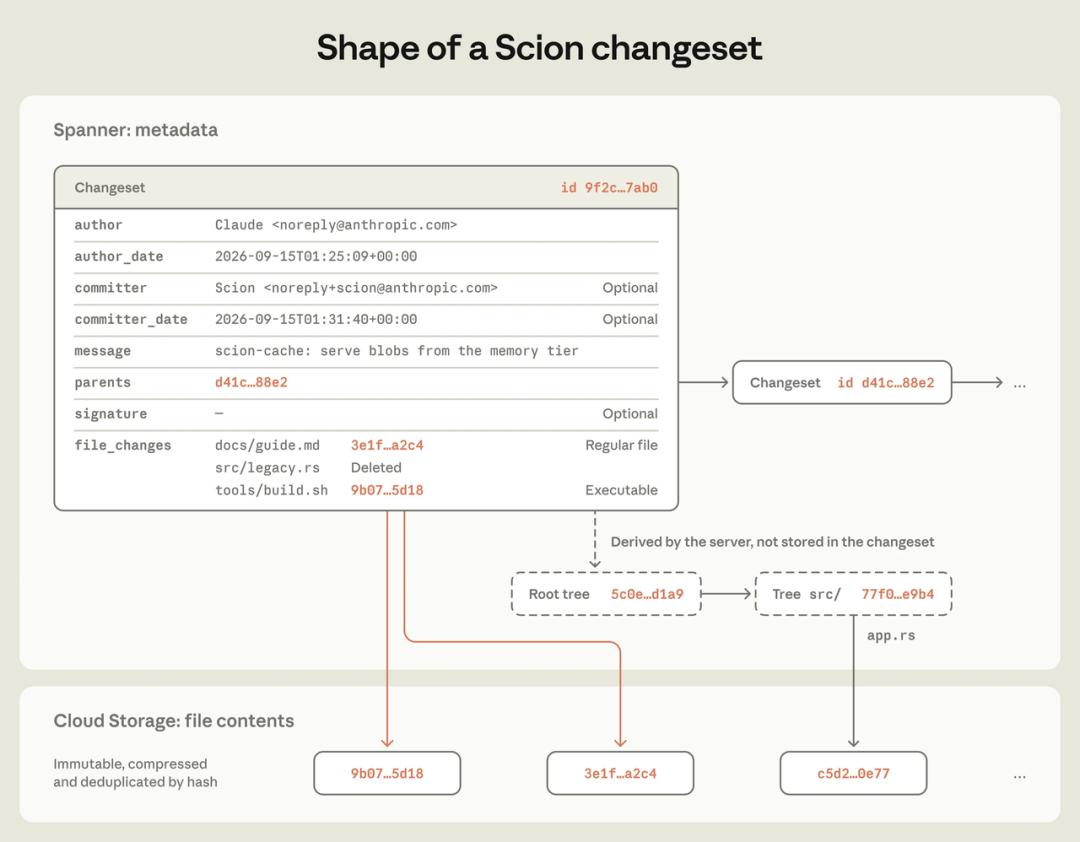
Datenstruktur des Changesets in Scion.
Diese Struktur ermöglicht es Scion, Änderungen mit extrem hohem Durchsatz zu empfangen. Da keine Packfiles empfangen, keine Sperren gesetzt oder serverübergreifende Koordinationen durchgeführt werden müssen und keine Refs verschoben werden müssen. Streng genommen unterstützt Scion weiterhin Refs. Aber das Erstellen und Abrufen von Commits hängen nicht von Refs ab, sodass das Verschieben einer Ref nur eine Compare-and-Swap-Operation auf einer einzelnen Zeile in Spanner erfordert, die getrennt von der Erstellung des Changesets abläuft.
Ein Changeset zeichnet jedoch nur die Inhalte auf, die sich geändert haben. Allein mit diesen Datensätzen lassen sich nicht schnell Fragen beantworten, wer eine bestimmte Code-Zeile zuletzt geändert hat oder welche Commits eine bestimmte Datei durchlaufen hat. Um diese Probleme zu lösen, baut Scion auf Basis der Changesets zusätzliche Datenstrukturen auf, einschließlich spezieller