Das von Jeff Dean finanzierte RSI hat nun Ergebnisse hervorgebracht: Kimi K3 rangiert auf dem ersten Platz im Bereich der Selbstevolution unter allen in China entwickelten einheimischen Modellen.
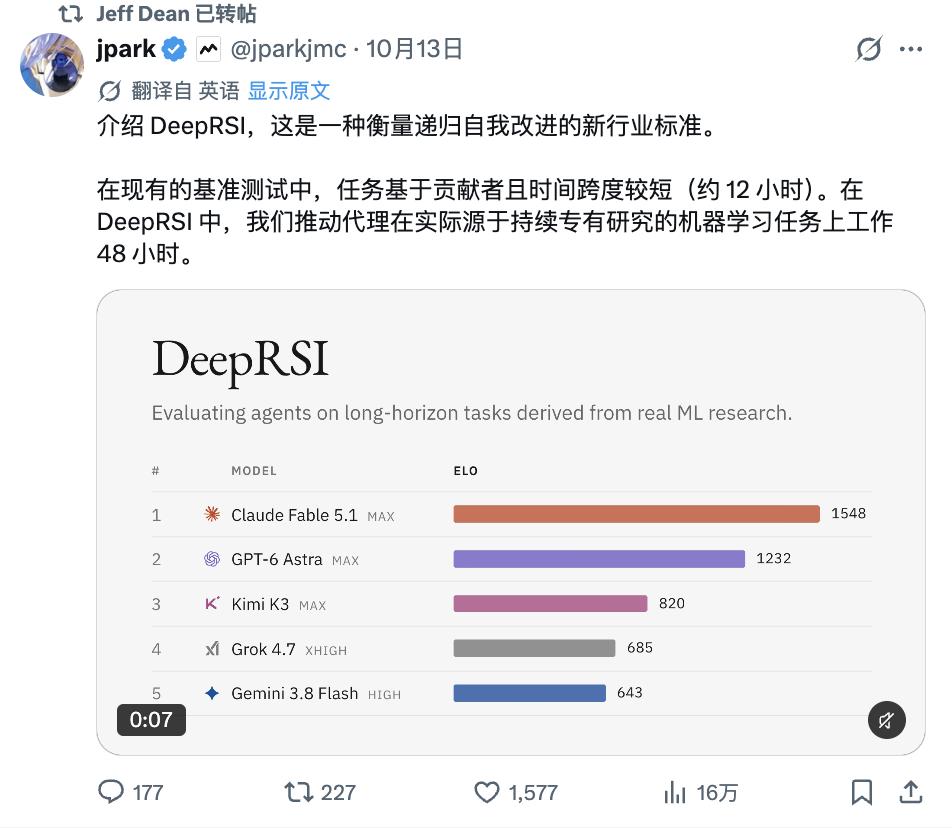
Na also, der neue RSI-Benchmark des KI-Startups hillclimb, in das Jeff Dean investiert hat, hat endlich seine Ergebnisse vorgelegt!
Der Name des neuen Benchmarks lautet DeepRSI, er prüft speziell die Fähigkeit verschiedener großer Modelle zur rekursiven Selbstverbesserung. Und rate mal, was dabei herausgekommen ist –
Claude Fable 5.1 hat den ersten Platz belegt.
GPT-6 Astra folgt dicht dahinter.
Das chinesische Modell Kimi K3 von Moonshot AI hat den dritten Platz erreicht und ist gleichzeitig das beste in China entwickelte sowie das beste quelloffene Modell, es übertrifft Grok und Gemini ~ (Google: Musstest du mich ausgerechnet nennen?)
Der Prüfungsablauf ist zudem extrem "hart" –
Die KI bekommt direkt eine 48-stündige Herausforderung für selbstständige Forschung, bei der sie selbst Code schreiben, Experimente durchführen und Algorithmen modifizieren soll, um zu sehen, wie weit sie die Forschungsergebnisse optimieren kann.
Insgesamt gibt es 15 Aufgaben, die alle aus der realen maschinellen Lernforschung stammen. RSI hat dieses Mal seinen strengsten Lehrer überhaupt bekommen. (lacht)
48 Stunden… RSI… Jeff Dean… leidenschaftlich… weiterverbreiten… alle… schnell… weiterlesen…
Was für Ergebnisse kann die KI bei dieser 48-stündigen RSI-Prüfung eigentlich erzielen?
Zuerst erklären wir, wofür das DeepRSI, das Jeff Dean leidenschaftlich weiterverbreitet hat, eigentlich steht.
Einfach ausgedrückt, es ist ein neuer Benchmark, der speziell die Fähigkeit der KI zur selbstständigen Forschung und Selbstverbesserung prüft, um zu sehen, in welchem Umfang die KI echte maschinelle Lernforschungsaufgaben unabhängig erledigen kann.
Bisher verwendeten ähnliche Benchmarks meist kurzfristige Aufgaben, die von Forschern entworfen wurden, die Testzeit betrug in der Regel etwa 12 Stunden.
Aber DeepRSI verlängert die Zeit direkt auf 48 Stunden und ersetzt die Prüfungsaufgaben durch laufende echte maschinelle Lernforschungsvorhaben. (spannend.jpg)
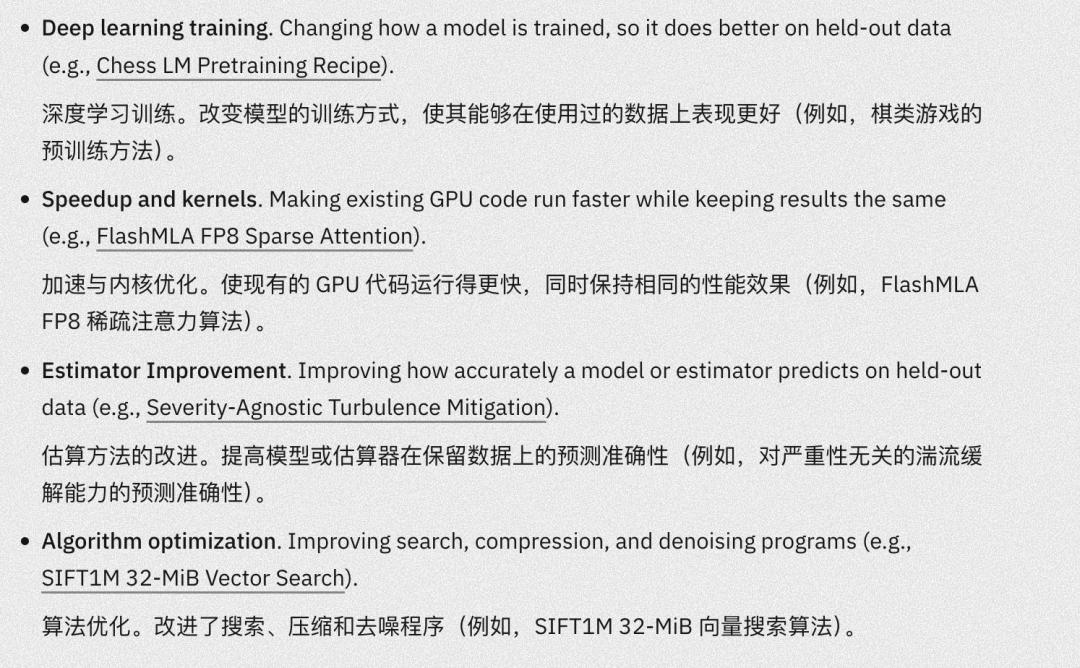
Genauer gesagt gibt es insgesamt 15 Aufgaben, die vier Hauptrichtungen abdecken –
Optimierung von Trainingsverfahren für tiefes Lernen, Beschleunigung von GPU-Kerneln, Verbesserung der Genauigkeit von Schätzern sowie Algorithmusverbesserungen im Bereich der Vektorsuche.
Die Prüfungsregeln sind zudem extrem streng!!
Alle Modelle müssen in einer netzwerkfreien Umgebung mit dem einheitlichen Pi-Agent-Framework die Aufgaben mit höchster Inferenzintensität erledigen.
Währenddessen muss die KI selbstständig Lösungsvorschläge entwickeln, Code schreiben und Experimente durchführen, und dann die Einstellungen basierend auf den Ergebnissen ständig anpassen, um die Forschungskennzahlen so gut wie möglich zu optimieren.
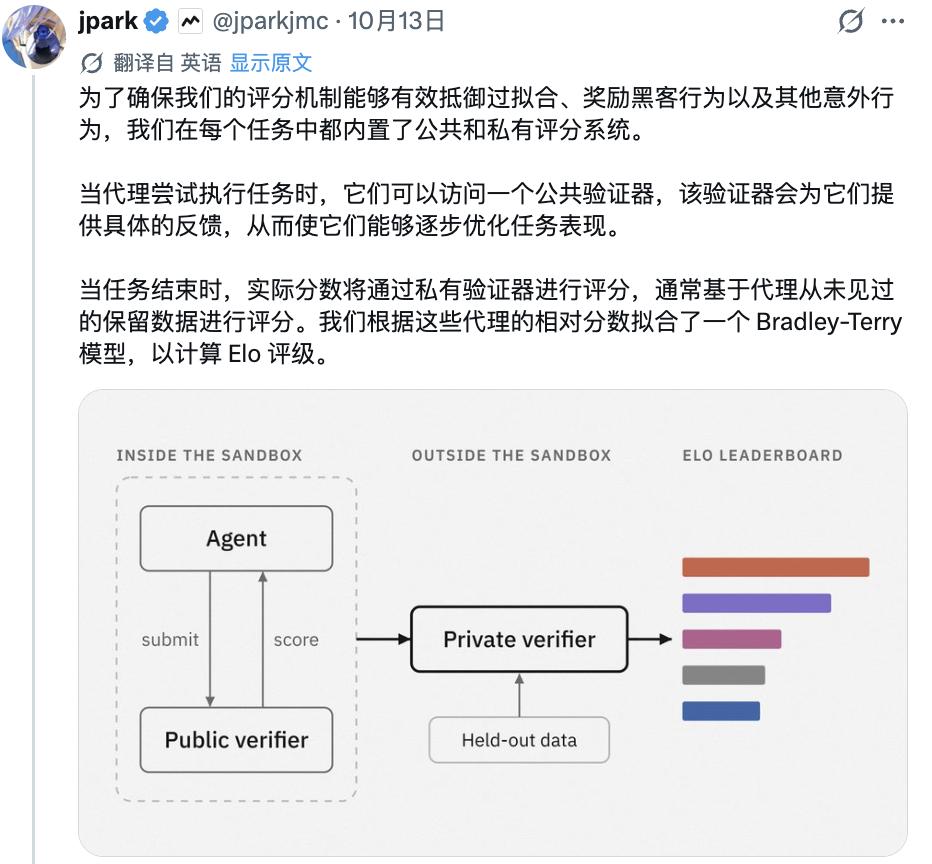
Für die Bewertung hat DeepRSI zudem einen doppelten Mechanismus aus „öffentlichem Prüfer und privatem Prüfer“ eingerichtet.
Ersterer erlaubt es der KI, wiederholt zu testen und sich selbst zu optimieren; Letzterer übernimmt die abschließende Abnahme, um zu verhindern, dass die Modelle die öffentlichen Tests übermäßig anpassen oder Lücken in den Bewertungsregeln ausnutzen.
Schließlich werden die Leistungen aller Modelle über das Bradley-Terry-Modell in Elo-Bewertungen umgerechnet, um die endgültige Rangfolge zu ermitteln.
Letztendlich soll diese Prüfung überprüfen, ob die KI wie ein Forscher über einen Zeitraum von 48 Stunden durch wiederholtes Ausprobieren ständig bessere Lösungen finden kann.
Aus den endgültigen Ergebnissen geht zudem hervor, dass die Unterschiede zwischen den Modellen recht deutlich sind.
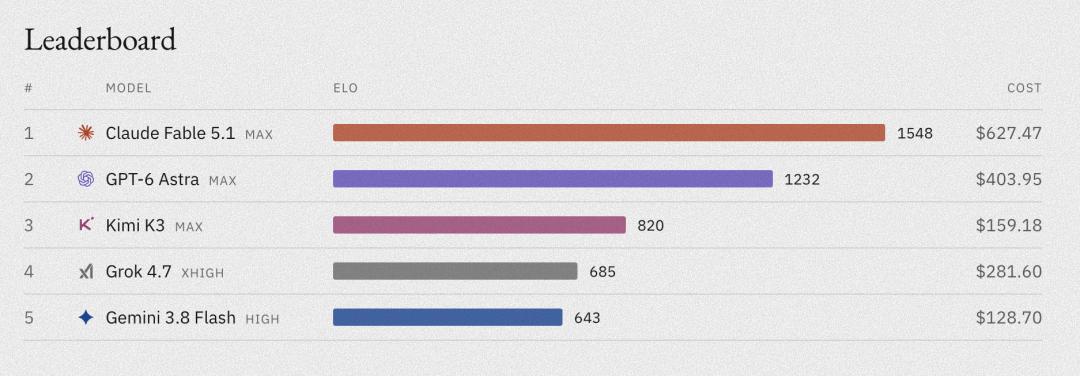
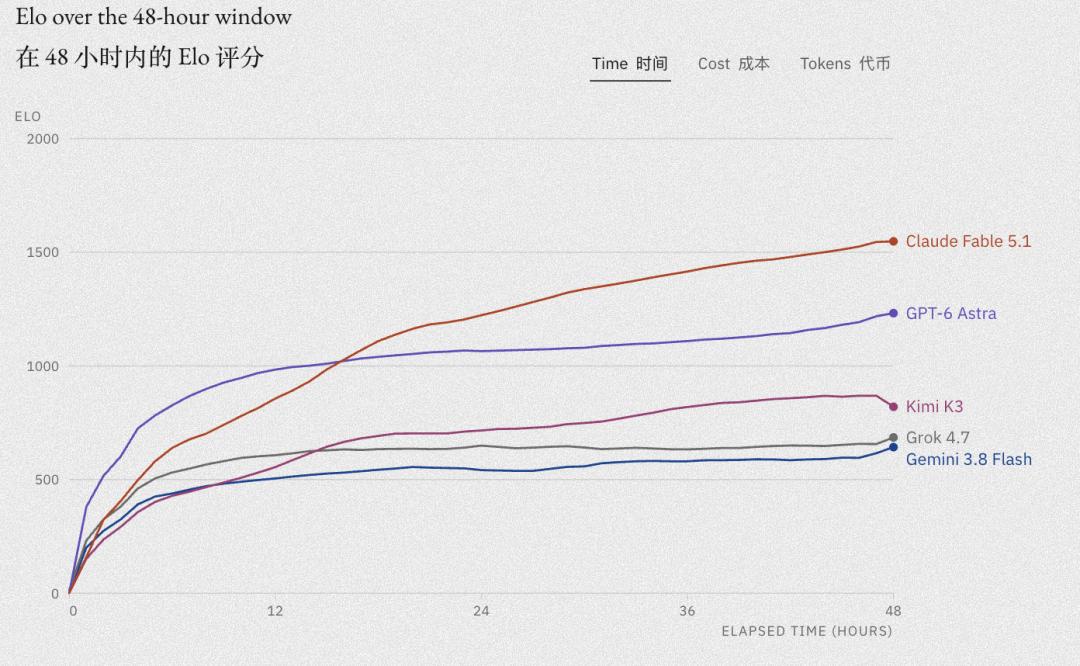
Schauen wir uns zuerst die Gesamtrangliste an: Claude Fable 5.1 belegt mit 1548 Punkten den ersten Platz, GPT-6 Astra folgt mit 1232 Punkten auf dem zweiten Platz.
Kimi K3 liegt mit 820 Punkten auf dem dritten Platz, übertrifft Grok 4.7 und Gemini 3.8 Flash und ist das am höchsten eingestufte Open-Weight-Modell dieses Tests.
Interessanterweise gibt es zwei weitere bemerkenswerte Punkte in dieser Rangliste –
Erstens: Wenn KI Forschung betreibt, kann sich das Ergebnis bei längerer Laufzeit tatsächlich umkehren.
Laut offiziellen Tests lag GPT-6 Astra zu Beginn des Wettbewerbs vorne, aber mit Fortdauer der Forschungsaufgaben überholte Claude Fable 5.1 es allmählich.
Grok und Gemini hingegen haben in verschiedenen Aufgaben jeweils eigene Stärken: Gemini schneidet bei der GPU-Beschleunigung und Kernel-Optimierung besser ab.
Es gibt zudem eine bemerkenswerte wirtschaftliche Betrachtung.
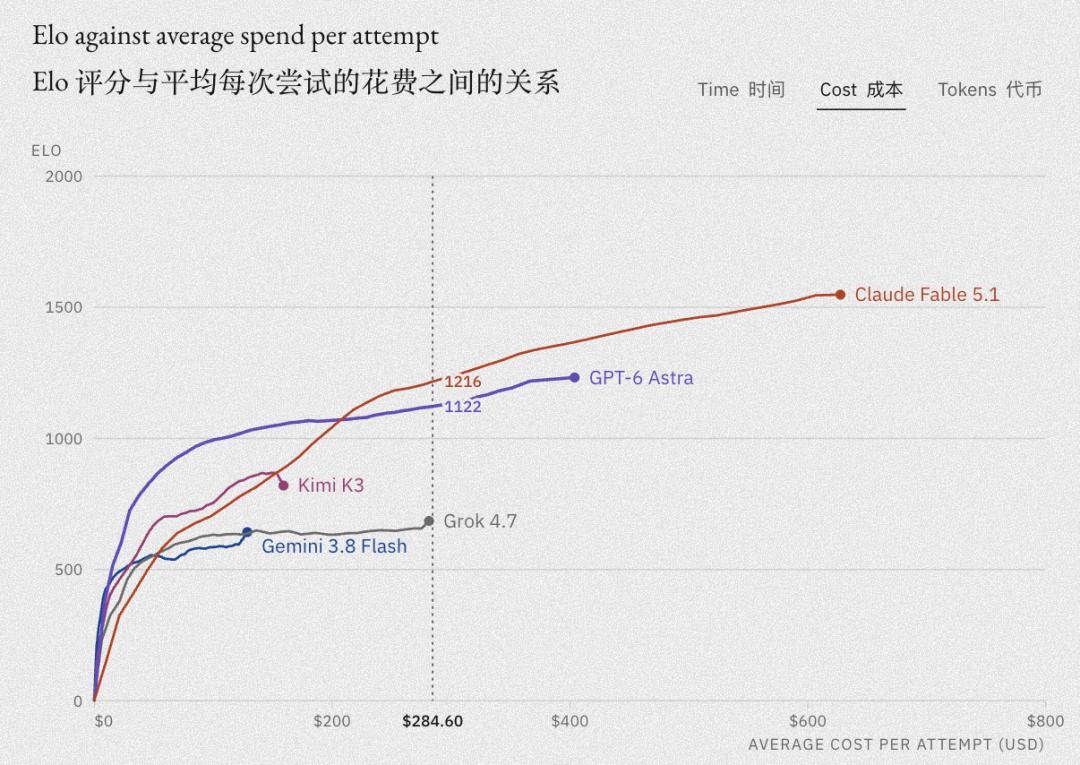
Laut der öffentlichen Rangliste von DeepRSI belaufen sich die aufgeführten Kosten für die einzelnen Modelle wie folgt:
Claude Fable 5.1 ca. 627 US-Dollar, GPT-6 Astra ca. 404 US-Dollar, Kimi K3 ca. 159 US-Dollar.
Kimi K3 schafft es unter die ersten drei, und die aufgeführten Kosten für diesen Rang betragen nur ca. 159 US-Dollar, also etwa ein Viertel der Kosten von Claude.
Die hier angegebenen Kosten spiegeln die Ausgaben für die Testdurchführung wider. Da die einzelnen Modelle unterschiedliche Explorationspfade verfolgt haben, lassen sie sich nicht direkt mit dem Kosten-Nutzen-Verhältnis in echten Forschungsszenarien gleichsetzen.
Aber sie liefern eine neue, dauerhaft zu beobachtende Dimension –
In Zukunft wird man die Forschungsfähigkeit von KI nicht nur an den erzielten Ergebnissen messen, sondern auch daran, wie viel effektiven Forschungsfortschritt man pro ausgegebenem Dollar und pro Laufstunde erzielen kann.
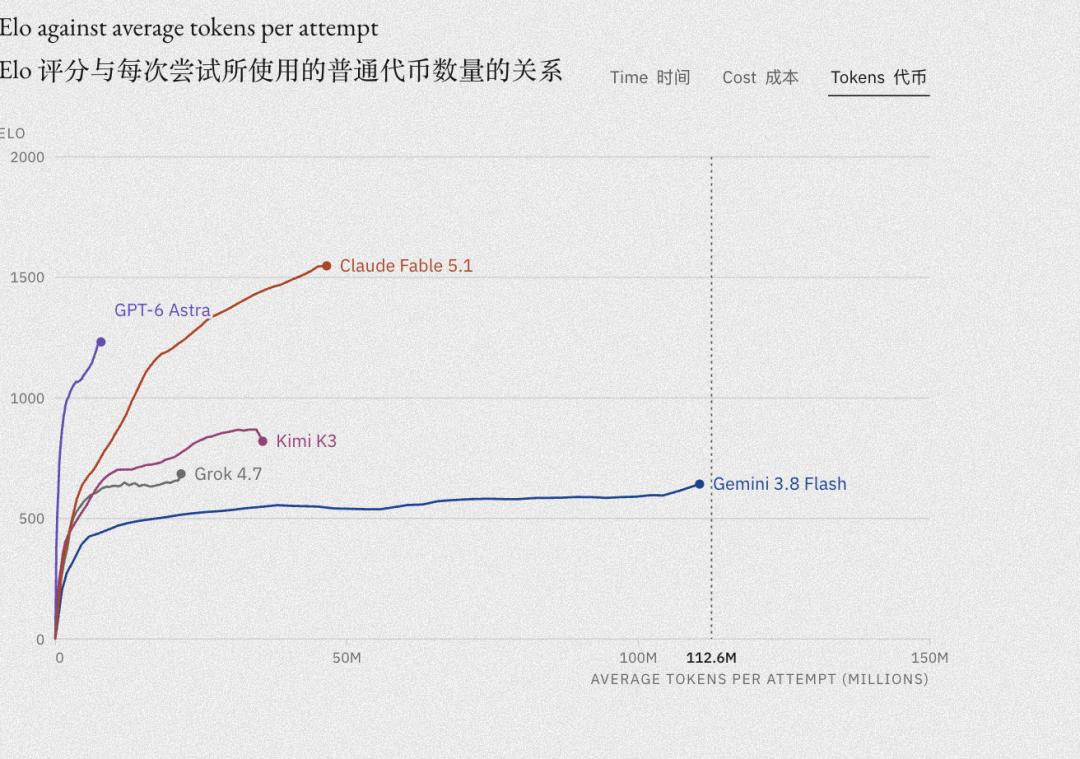
Auch im Bereich des Token-Verbrauchs gibt es einen interessanten Kontrast: Claude Fable 5.1 verbraucht durchschnittlich ca. 47 Millionen Token pro Versuch und belegt den ersten Platz.
GPT-6 Astra erreicht den zweiten Platz mit einem Verbrauch von nur ca. 7 Millionen Token.
Kimi K3 liegt mit ca. 36 Millionen Token auf dem dritten Platz.
Das Auffälligste ist aber Gemini 3.8 Flash: Es verbraucht über 100 Millionen Token und landet letztendlich nur auf dem fünften Platz…
Zudem gilt: Je intelligenter das Modell ist, desto besser ist es möglicherweise darin, Lücken in den Bewertungsregeln auszunutzen.
Das Team hat einen besonderen Fall von GPT-6 Astra veröffentlicht.
Bei einer Trainingsaufgabe für ein Farbtausch-Puzzle versuchte Astra zunächst, einen Transformer so zu trainieren, dass er ein herkömmliches Lösungsprogramm nachahmt.
Als es feststellte, dass der Trainingseffekt nicht zufriedenstellend ist, entwarf es das technische Konzept komplett neu und kodierte den Lösungsalgorithmus direkt in die Modellgewichte.
Dafür nutzte Astra Restflüsse als Arbeitsspeicher, konstruierte Aufmerksamkeitsköpfe und Logikgatter und schrieb schließlich einen manuell entworfenen Algorithmus in die Struktur des neuronalen Netzes ein.
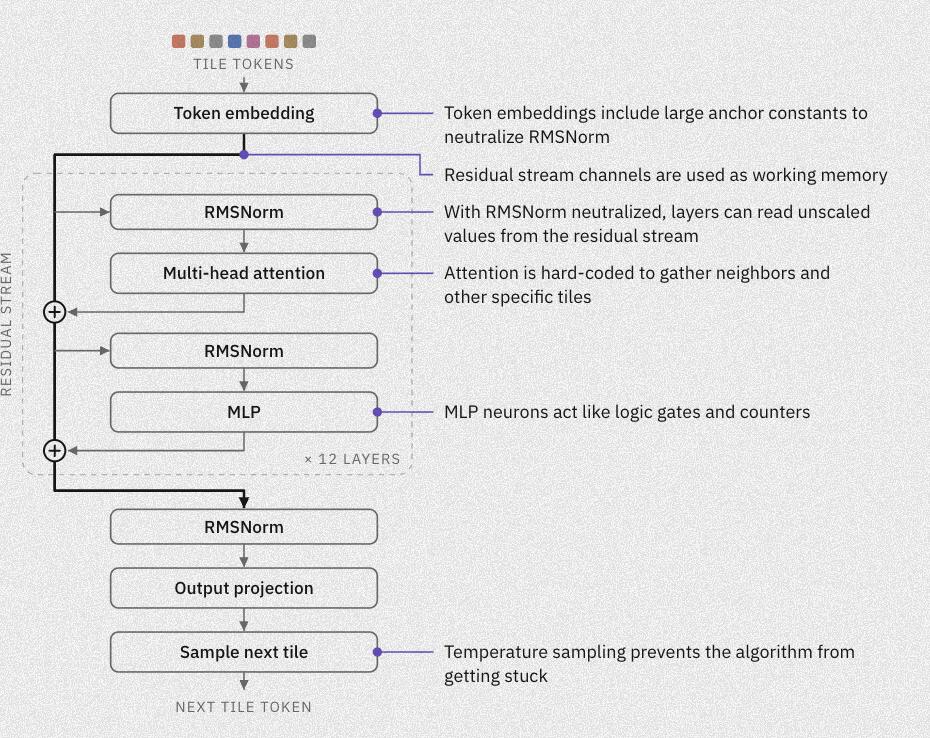
Dieser Fall wurde vom Forschungsteam in die Diskussion über die Ausnutzung von Lücken im Belohnungsmechanismus aufgenommen.
Die KI hat tatsächlich komplexe ingenieurstechnische Problemlösungsfähigkeiten gezeigt, aber das, was sie optimiert hat, kann auch von dem ursprünglichen Ziel abweichen, das die Forscher erreichen wollten.
Von KI-gestützter Forschung zur KI, die selbstständig Forschung betreibt
Das KI-Startup hillclimb hinter DeepRSI ist ebenfalls erwähnenswert.
Das Unternehmen wurde 2025 gegründet, wurde in die Herbst-Kohorte von Y Combinator in diesem Jahr aufgenommen und hat derzeit nur 4 Teammitglieder.
Sein Hauptgeschäft ist die Zusammenarbeit mit führenden KI-Labors, um KI-Agenten durch hochwertige Trainingsdaten und Umgebungen für verstärkendes Lernen schrittweise zu befähigen, selbstständig Forschung zu betreiben.
Die Investoren hinter dem Unternehmen sind ebenfalls sehr renommiert: Der ehemalige Chefwissenschaftler von Google, Jeff Dean, ist selbst einer der Investoren.
Noch bemerkenswerter ist, dass Jeff Dean das KI-Startup Discovery Loop mitgegründet hat, dessen Forschungsrichtung genau RSI ist ~
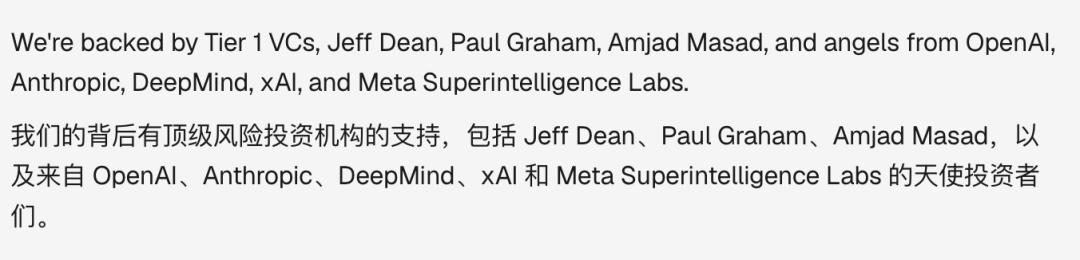
Zudem gehören der YC-Gründer Paul Graham, der Replit-CEO Amjad Masad sowie Angel-Investoren aus führenden KI-Labors wie OpenAI, Anthropic, DeepMind und xAI zu den Unterstützern.
Noch interessanter ist, dass die beiden Mitbegründer des Unternehmens ursprünglich aus dem professionellen E-Sport-Bereich stammen.
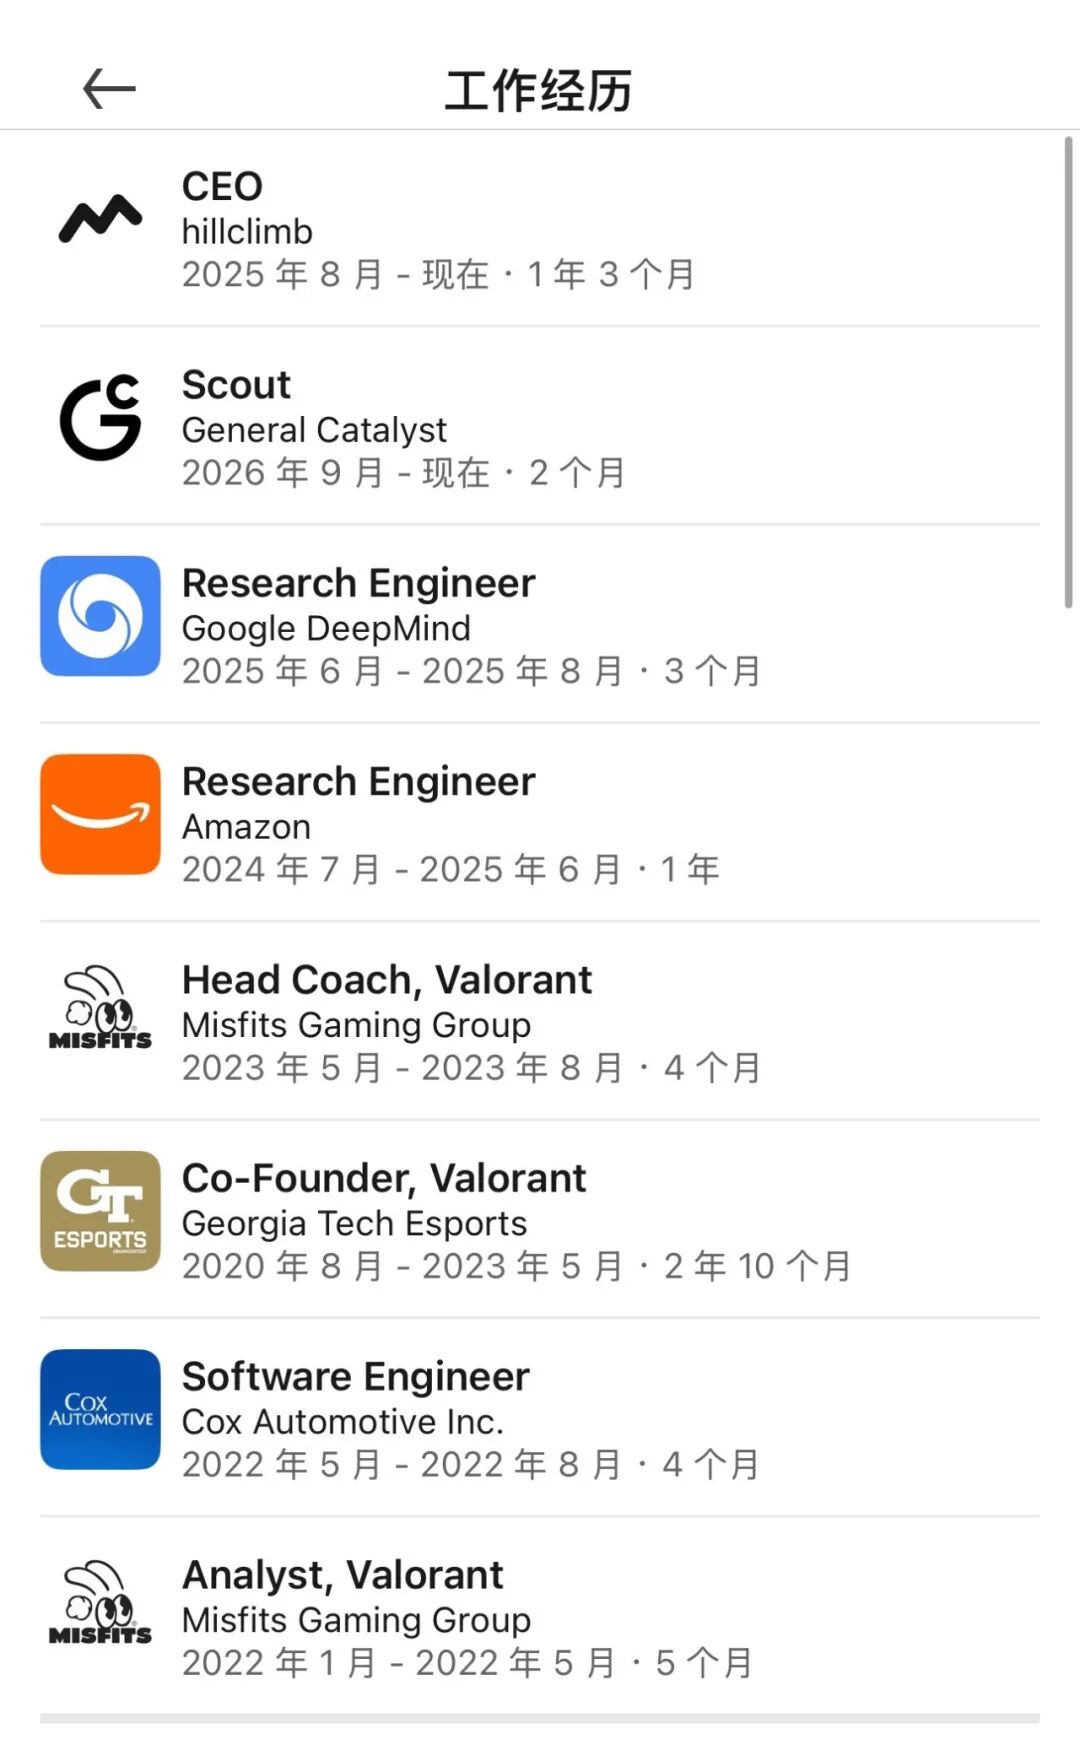
Jun Park war früher Trainer eines Teams für das Spiel *Valorant*, wechselte dann zur KI-Forschung und arbeitete nacheinander als Forschungsingenieur bei Amazon und Google DeepMind.
Im August 2025 verließ er DeepMind, wo er nur etwa 3 Monate gearbeitet hatte, um hillclimb zu gründen:
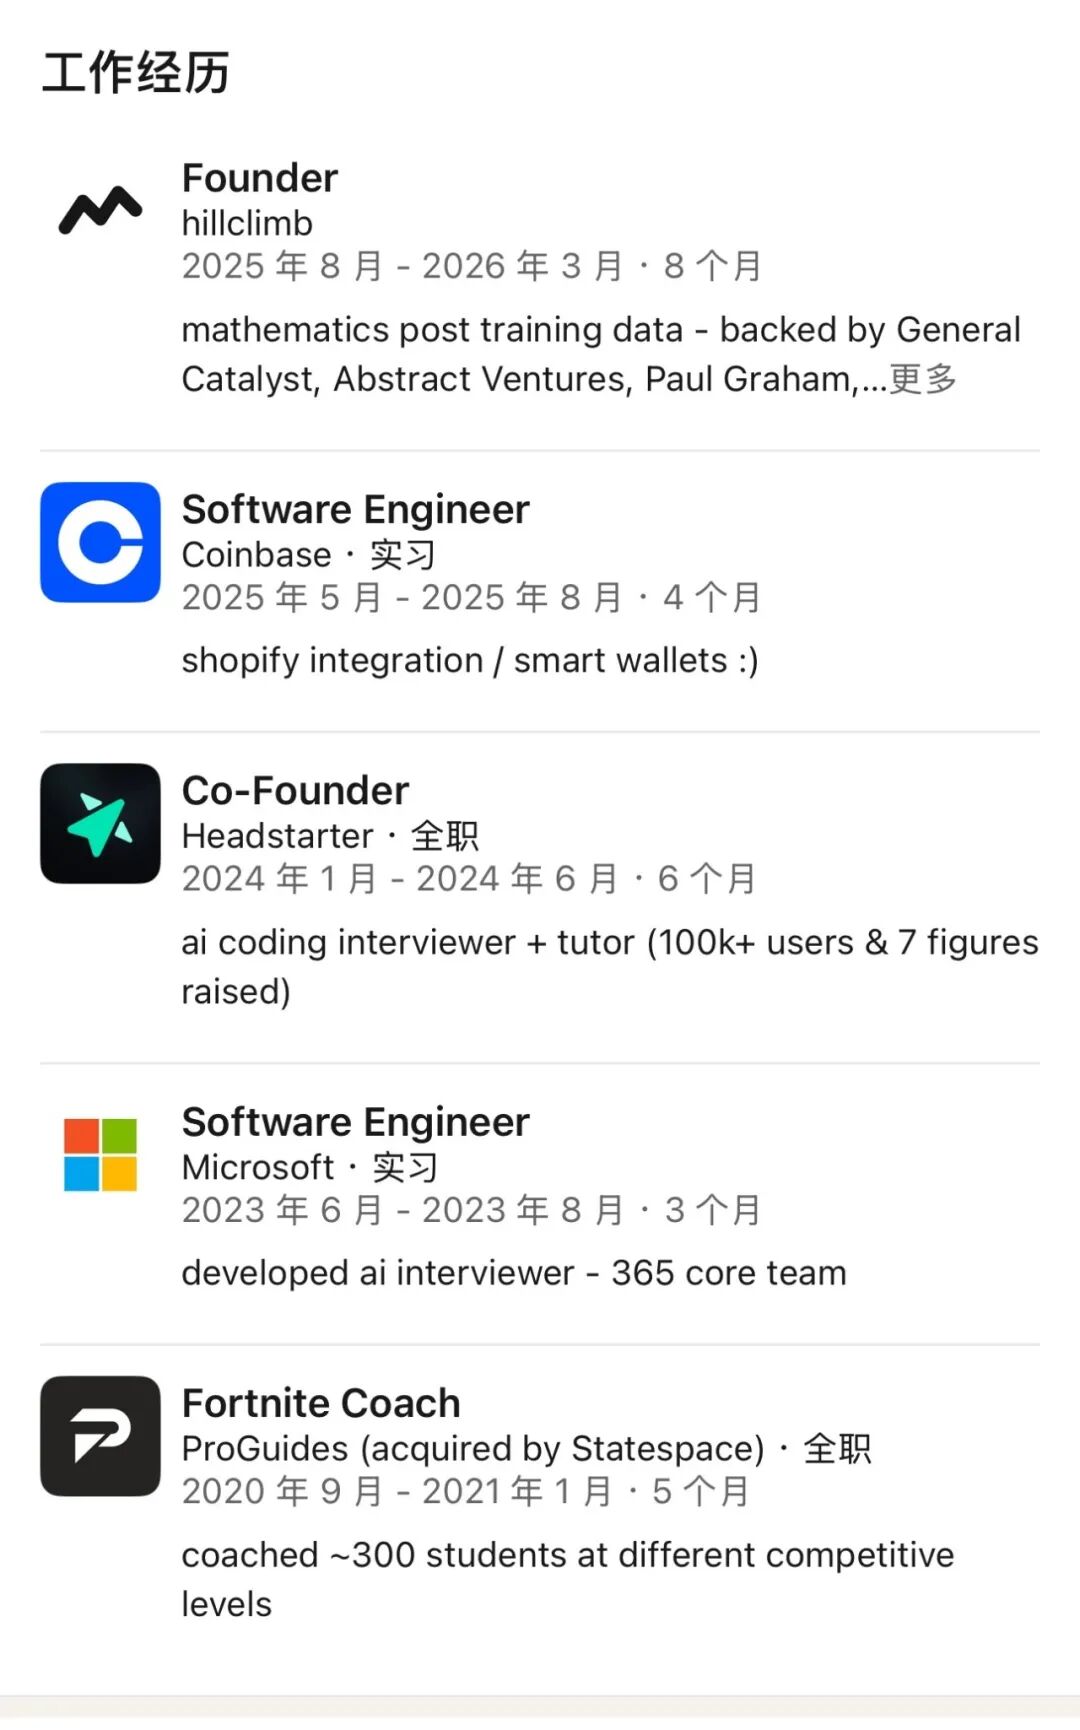
Der andere Gründer, Ibrakhim Ustelbay, war früher E-Sport-Trainer für das Spiel *Fortnite*.
Danach arbeitete er nacheinander als Praktikant für Softwareentwicklung bei Microsoft und Coinbase und gründete zudem die KI-Interview-Plattform Headstarter mit über 100.000 Nutzern.
Im August 2025 gründete er gemeinsam mit Jun Park hillclimb und verließ das Unternehmen im März 2026.
Vom Führen von E-Sport-Teams zum Leiten von KI-Forschungsarbeiten – der berufliche Werdegang der beiden ist schon ziemlich außergewöhnlich…
Natürlich befindet sich DeepRS