Der Vater von Linux ist vollständig in die KI eingestiegen, Claude Code schreibt den Kernel, die Leistung verdreifacht sich.
Das ist wirklich unglaublich!
Sogar der Vater von Linux lässt Claude den Kernel schreiben.
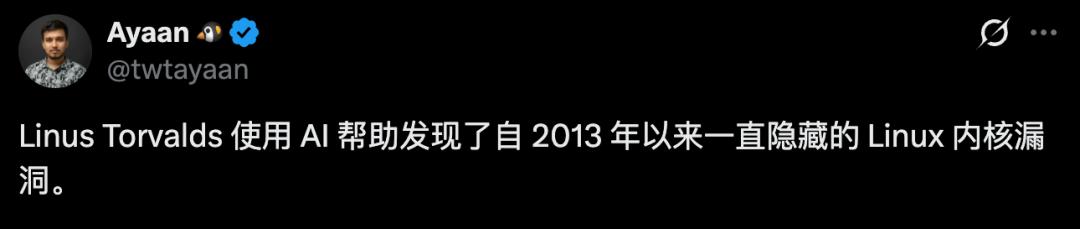
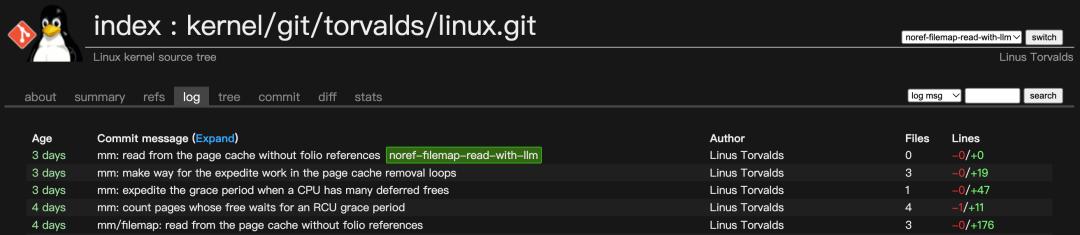
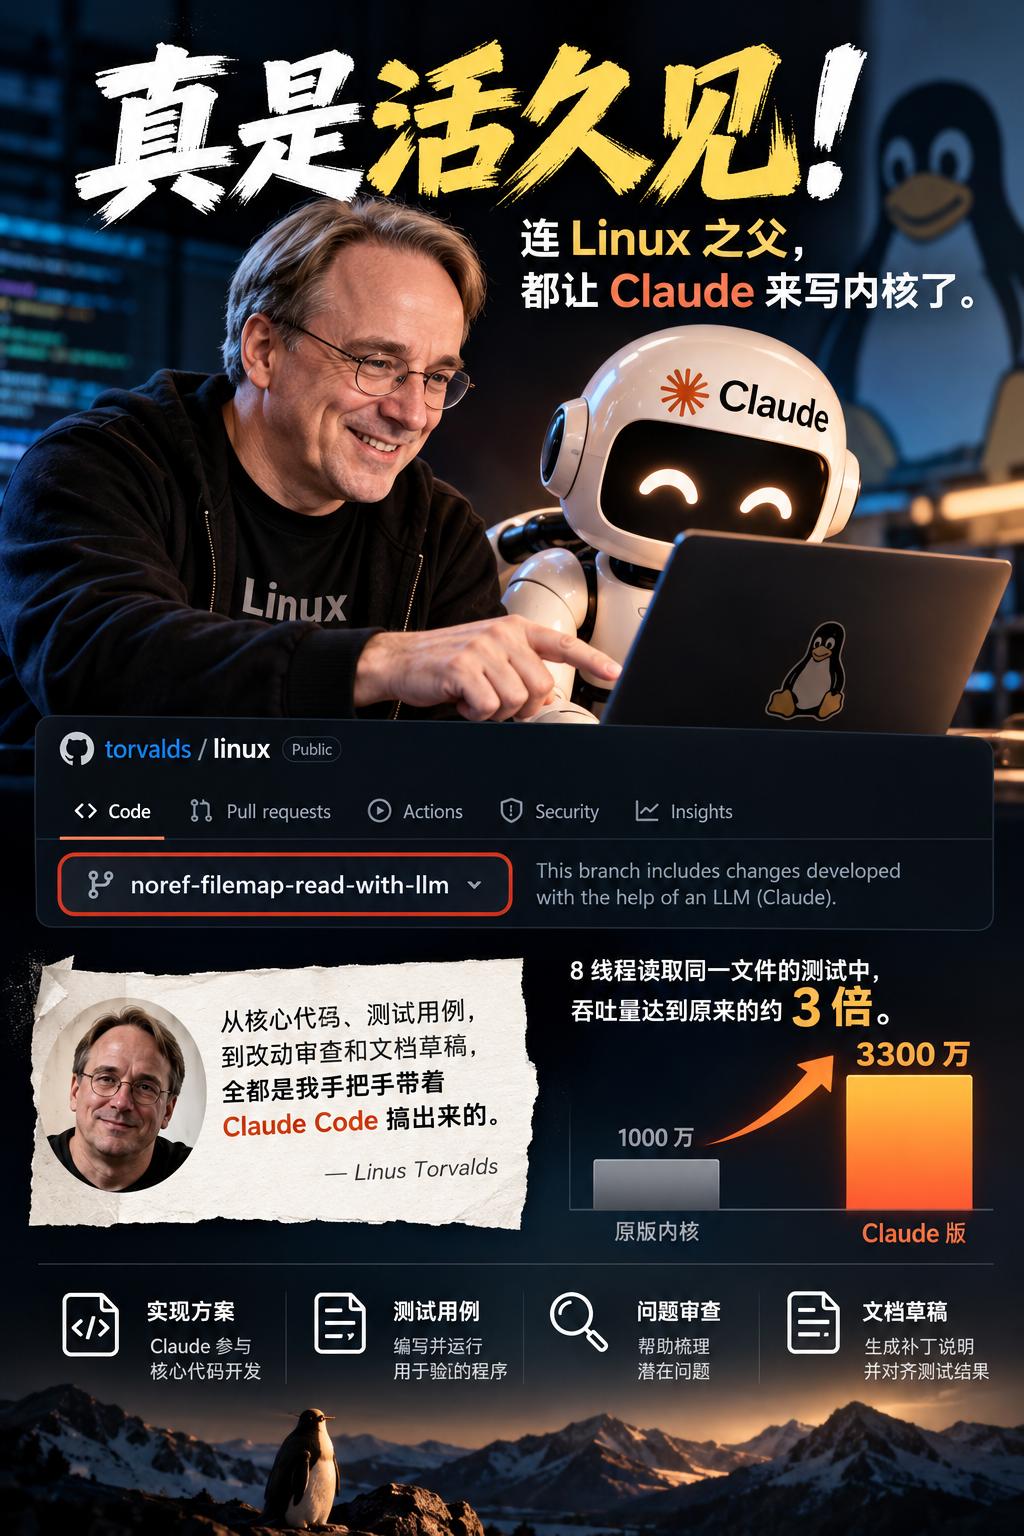
Erst kürzlich hat ein Entwickler beim Aktualisieren des offiziellen Kernel-Repositorys von Linus einen höchst ungewöhnlichen neuen Zweig entdeckt —
noref-filemap-read-with-llm
Ja, das Suffix „-with-llm“ dieses Zweigs macht unmissverständlich klar: An diesem Projekt ist KI beteiligt.
Wer hätte das gedacht: Linus, der sonst am heftigsten über schlechten Code schimpft, geht jetzt selbst mit gutem Beispiel voran und nutzt KI zum Schreiben von Code!
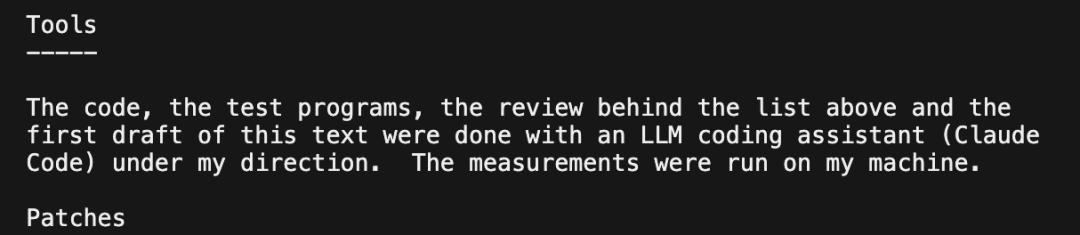
In der Beschreibung des neuesten Patches gibt er offen zu:
Vom Kerncode über die Testfälle bis zur Überprüfung der Änderungen und dem Entwurf der Dokumentation wurde alles gemeinsam mit Claude Code erstellt.
Die Ergebnisse sind auch tatsächlich überzeugend: Bei dem spezifischen Test mit 8 Threads, die dieselbe Datei lesen, erreicht der Durchsatz etwa das Dreifache des ursprünglichen Werts.
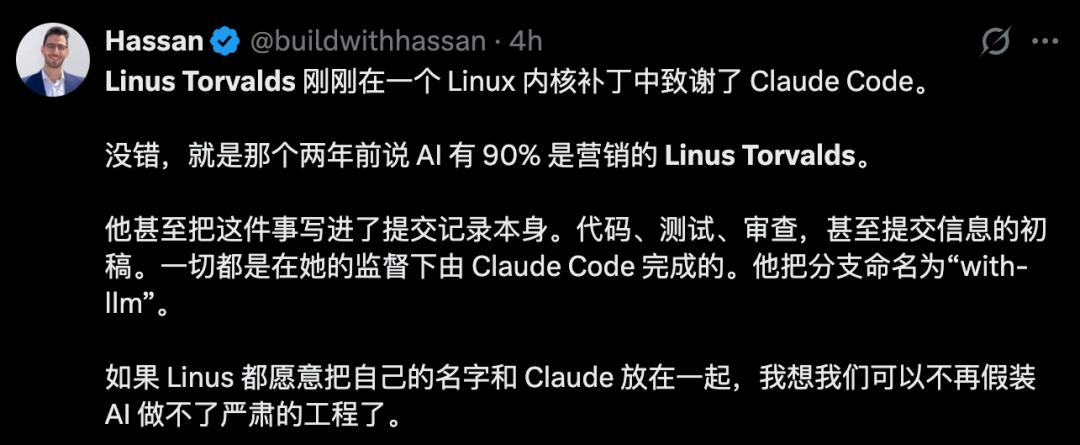
Der Mann, der einst sagte, „KI sei zu 90 Prozent Marketing“, hat seine Meinung geändert.
Der brandneue Zweig von Linus trägt direkt das Kürzel „llm“ im Namen
An der Stelle, an der Linus jetzt Claude Code zum Einsatz bringt, handelt es sich um den Kernmechanismus des „Speichermanagements“ von Linux.
Der Linux-Kernel nutzt den Page-Cache, um Dateidaten zwischenzuspeichern.
In alltäglichen Szenarien mit vielen gleichzeitigen Vorgängen ist eine häufige Operation: Mehrere Threads lesen gleichzeitig kleine Teile aus derselben Datei.
Nach dem vorhandenen Mechanismus muss bei jedem Lesevorgang die atomare Referenzzählung auf dem entsprechenden Speicherblock (Folio) geändert werden.
Das führt dazu, dass CPU-Kerne ständig die Anweisungen lock cmpxchg und lock decl ausführen, was auf Hardwareebene zu heftigen Cacheline-Konflikten führt.
Bereits 2024 wies der Kernentwickler des Kernels, Matthew Wilcox, auf dieses hartnäckige Problem aus der Produktivumgebung echter Kunden hin.
Auf Linus' eigenem Testgerät machte dieser Engpass bei gleichzeitigem kleinen Lesevorgang mit 8 Threads 99,92 % des gesamten Aufwands für „Load HITMs“ aus und beanspruchte fast die gesamte Busbandbreite der CPU.
Die Aufgabe von Claude ging zudem weit über das Hinzufügen einiger weniger Codezeilen hinaus.
Es war an der Umsetzung des Lösungsansatzes beteiligt, schrieb Programme zur Prüfung des Ansatzes und half dabei, potenzielle Probleme zu ermitteln.
Alle diese Schritte zusammen machen einen vollständigen technischen Versuch aus. Der geschriebene Code muss lauffähig sein, die Laufergebnisse müssen messbar sein und die erzielten Verbesserungen müssen erklärbar sein.
Die Patch-Beschreibung hat auch einen praktischen Nutzen. Andere Wartende müssen wissen, warum die Änderung vorgenommen wurde, welche Pfade betroffen sind und welche Fälle der Autor bereits geprüft hat.
Nachdem die KI den Entwurf erstellt hat, muss diese Beschreibung noch mit dem Code und den Testdaten übereinstimmen.
Nur bei einem solchen Maß an Offenheit gibt es eine Grundlage für nachfolgende Diskussionen. Genau darin liegt die Bedeutung von Linus' Aussage „unter meiner Anleitung“.
Durchsatz steigt von 10 Millionen auf 33 Millionen
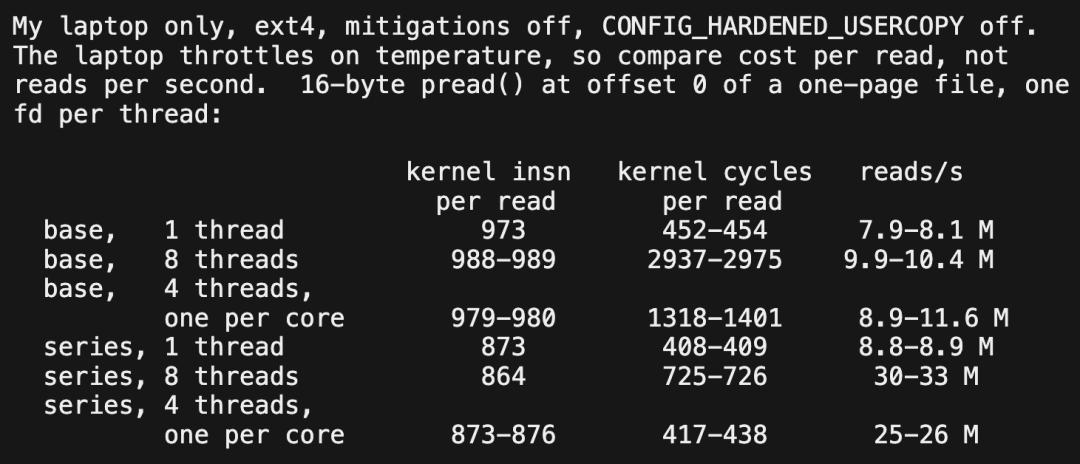
Für die Tests nutzte Linus einen Laptop mit Core i7-8565U, 4 Kernen und 8 Threads, als Dateisystem wurde ext4 verwendet.
Bei dem Test lasen mehrere Threads wiederholt dieselbe Datei der Größe einer Seite, wobei jedes Mal nur 16 Byte gelesen wurden.
Die Daten aus der Patch-Beschreibung lauten wie folgt:
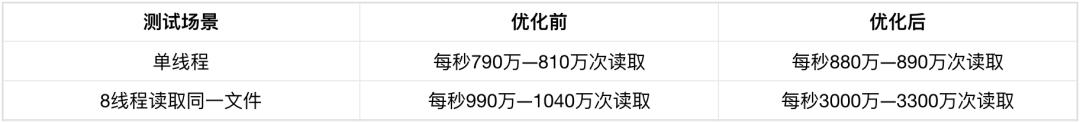
Der Durchsatz bei 8 Threads beträgt etwa das Dreifache des ursprünglichen Werts, die Verbesserung bei einem einzelnen Thread liegt bei etwa 10 Prozent.
Warum ist der Unterschied so groß? Der Schlüssel liegt in dem Umstand, dass „alle dasselbe Datei lesen“.
Linux speichert Dateidaten im Arbeitsspeicher zwischen, das ist der sogenannte Page-Cache. Nachfolgende Lesevorgänge können die Daten direkt aus dem Cache abrufen und sparen so den erneuten Zugriff auf das Speichergerät.
Der Speicher im Cache kann aber auch freigegeben werden. Der Kernel muss sicherstellen, dass der betreffende Speicherbereich nicht freigegeben und für andere Zwecke verwendet wird, solange der Thread noch liest.
Der ursprüngliche Lesepfad erhöht die Referenzzählung für das Speicherobjekt, das die Cache-Daten trägt, und verringert sie nach Abschluss des Lesevorgangs wieder. Dieses Objekt heißt Folio, man kann es sich als eine Gruppe von Seiten vorstellen, die vom Kernel verwaltet wird.
Das Problem ist: Wenn mehrere Threads gleichzeitig lesen, müssen alle denselben Zähler wiederholt ändern.
Um die Datenkonsistenz aufrechtzuerhalten, müssen die Prozessorkerne ständig die Cachezeile mit diesem Zähler austauschen. Ein Lesevorgang umfasst nur 16 Byte, der Lesevorgang selbst ist sehr schnell, aber der Aufwand für die Wartung der Zählung wird zum Engpass.
Das ist wie bei acht Leuten, die alle ein Buch durchblättern wollen und vor und nach jedem Umblättern darum wetteifern, dasselbe Anmeldeformular zu ändern.
Mit dieser Reihe von Patches versucht Linus, diesen Schritt im Lesepfad zu beseitigen.
Die Vorgehensweise lautet: Nachdem der Speicher aus dem Cache entfernt wurde, wird er erst nach einer Verzögerung tatsächlich an den Speicherzuweiser zurückgegeben. Mithilfe des RCU-Mechanismus erhalten die bereits laufenden zugehörigen Lesevorgänge die Möglichkeit, abgeschlossen zu werden.
Auf diese Weise können Threads innerhalb des geschützten Lesebereichs die Daten direkt kopieren und so den Wettbewerb um die gemeinsame Referenzzählung verringern.
Das erklärt auch, warum der Nutzen bei Tests, bei denen mehrere Threads dieselbe Datei gemeinsam nutzen, besonders deutlich ausfällt.
Anhand eines Bugs fördert die KI zudem ein zehn Jahre altes Problem zutage
Wenn Sie glauben, Linus habe Claude nur neuen Code schreiben lassen, unterschätzen Sie die Bedeutung dieser Angelegenheit.
Am Tag nach dem Erscheinen des Zweigs noref-filemap-read-with-llm tauchte in Linus' Repository zudem eine Bibliothek namens assoc-array-fixes auf.
Es handelt sich um eine Datenstruktur zum Organisieren und Suchen von Objekten nach Schlüsseln. Die ursprüngliche Implementierung geht auf das Jahr 2013 zurück.
Vor einigen Tagen reichte der Entwickler Nils Ollrogge einen Fehlerbericht ein und lieferte auch einen Patch zur Behebung des Problems.
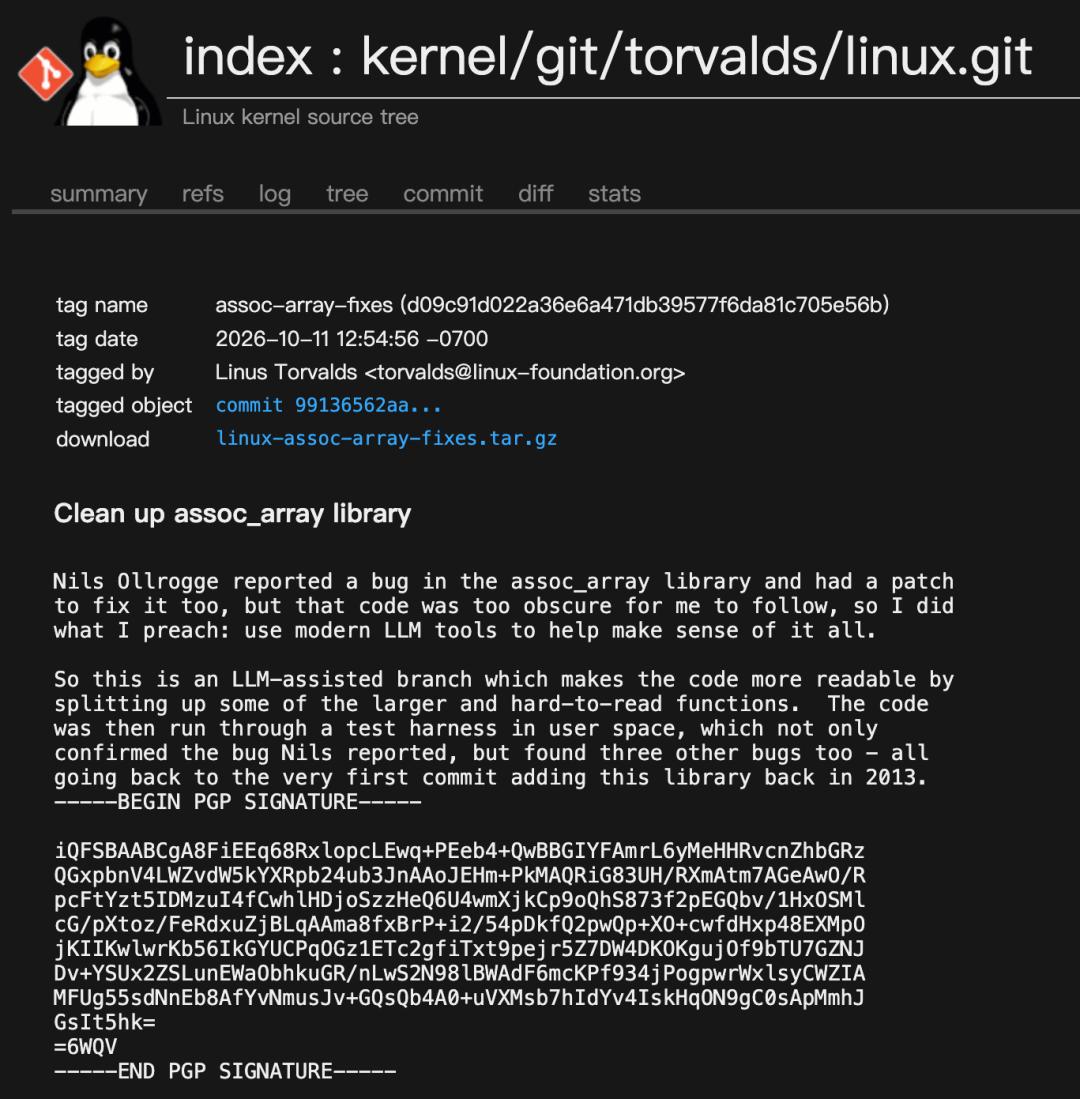
Nachdem Linus ihn gelesen hatte, stieß er auf ein Problem: Der Code war zu unverständlich, um die Logik nachvollziehen zu können.
Also nutzte er ein großes Sprachmodell, um den Code zu strukturieren, und teilte einige umfangreiche, schwer lesbare Funktionen auf, sodass die Grenzen zwischen verschiedenen Operationen klarer wurden. Danach wurde dieser Code in einem Testframework im Benutzerbereich ausgeführt.
Die Tests bestätigten das von Nils gemeldete Problem und fanden zusätzlich 3 weitere Bugs.
Alle vier Bugs lassen sich auf den Commit zurückverfolgen, bei dem diese Bibliothek 2013 zum ersten Mal in den Kernel aufgenommen wurde.
Wer hätte gedacht, dass ein einziger Fehlerbericht drei weitere seit über zehn Jahren vorhandene Mängel aufdeckt.
Ein konkretes Beispiel: Wenn eine bestimmte Wurzelknotenstruktur aufgeteilt wird, verschiebt sich das Bitfeld für den Index, sodass die zuvor gespeicherten Objekte nicht mehr gefunden werden können.
Die Patch-Beschreibung enthält ein Beispiel, das bereits mit nur 18 Schlüsseln ausgelöst werden kann.
Nach Abschluss der Operation sind 3 der Objekte nicht auffindbar. Bei erneutem Einfügen desselben Schlüssels wird ein neues Objekt hinzugefügt, statt das vorhandene ordnungsgemäß zu ersetzen.
Ein weiteres Problem liegt im Pfad bei fehlgeschlagener Speicherzuweisung.
Im Normalbetrieb kann es unentdeckt bleiben. Sollte aber einmal eine Zuweisung fehlschlagen, kann die Aufräumlogik über einen Zeiger auf einen alten, noch genutzten Baum zugreifen und eine Kernel-Fehlerprüfung auslösen.
Der entsprechende Test lässt jede Speicherzuweisung während der Operation nacheinander fehlschlagen und prüft jeden Ausnahmepfad einzeln, um das Problem aufzudecken.
Diese Erkenntnisse verleihen der Aussage „KI hilft bei der Code-Prüfung“ eine konkretere Bedeutung.
Alter Code wird durch Aufteilung und Erklärung leichter nachvollziehbar; Tests zwingen zudem die selten ausgeführten Pfade zum Vorschein.
Daraus lassen sich reproduzierbare Beweise für die Mängel gewinnen.
Sogar die Experten nutzen KI – die Überheblichkeit von Programmierern sollte zurückgestellt werden
Linus Torvalds hat einst einen berühmten Satz gesagt: „Talk is cheap. Show me the code.“
Wer ihn kennt, weiß, dass er extrem pragmatisch veranlagt ist und immer nur zwei Dinge prüft: Lohnt sich der Aufwand? Ist das Ergebnis überzeugend?
Diesmal zeigt er mit seinem Handeln eine andere Möglichkeit auf —
Wenn Code von KI geschrieben werden kann, ist das wirklich Wertvolle das Wissen, welcher Code überhaupt geschrieben werden soll, und die Fähigkeit zu beurteilen, ob der erstellte Code korrekt ist.
Der Mann, der einst sagte, „KI sei zu 90 Prozent Marketing“, hat jetzt in seinem Haupt-Repository einen Zweig mit dem Suffix „llm“ veröffentlicht.
Sogar der „Urvater“ nutzt KI, um seine Aufgaben schneller zu erledigen – wer hält noch an der Eitelkeit fest, alles per Hand tippen zu müssen?
Referenzmaterial:
https://www.phoronix.com/news/Linus-Torvalds-Claude-Code
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Ai-News“, Autor: ASI Offenbarung, veröffentlicht mit Genehmigung von 36Kr.