Alibaba, ByteDance und Meta legen eine wahnsinnige Schlagzahl vor, der Hype um persönliche Agenten ist im vollen Gange, wer kein gutes Modell hat, verdient nicht einmal einen Platz am Tisch.
Ende September kündigte Alibaba auf der Yunqi Conference an, dass Qwen die Entwicklung von persönlichen Agenten beschleunigen wird, um auf der Grundlage der Fähigkeiten der Qwen 3.8-Serie neue Produktformen zu entwickeln.
Am 13. Oktober hat Qwen endlich den persönlichen exklusiven Assistenten „Qwen Go!“ offiziell vorgestellt und auf der Qwen-App eine zeitlich begrenzte Einladungstestphase gestartet.
Nicht nur Alibaba, sondern auch ByteDance lässt Doubao derzeit einen persönlichen Agenten-Projekt mit dem Codenamen Spell im internen Testlauf durchführen, und beschleunigt aktuell die Integration in die vorhandenen Produkte von Doubao. Auch Tencent fehlt nicht: Derzeit gibt es zwei persönliche Agenten-Projekte namens TX Handy Bot und Yuanbao-Assistent.
Das von Meta eingeführte Muse ist der „Auslöser“ dieser aktuellen Welle persönlicher Agenten. Es ermöglicht Nutzern, alltägliche Angelegenheiten und langfristige Ziele einem Agenten anzuvertrauen, der über einen unabhängigen Cloud-Computer und einen Browser verfügt, und hat persönliche Agenten endgültig in den Fokus der Branche gerückt. Auch OpenAI hat nach Muse dots auf den Markt gebracht.
Dennoch ist der Boom auf Anwendungsebene nur die eine Seite der Medaille, die andere Seite sind die Veränderungen auf Modellebene.
Am 12. Oktober veröffentlichte Meta die Muse Wonder-Serie, die aus zwei Modellen besteht: Muse Wonder und Muse Wonder Full. Neben Fähigkeiten im Bereich der Codierung und professioneller Aufgaben gibt es dieses Mal zwei weitere Schlüsselbegriffe – Active Memory und Active Focus. Ersteres zielt darauf ab, nützliche Informationen über verschiedene Konversationen hinweg wiederzufinden, Letzteres darauf, Ziele nach dem Auftreten von Hindernissen weiterzuverfolgen.
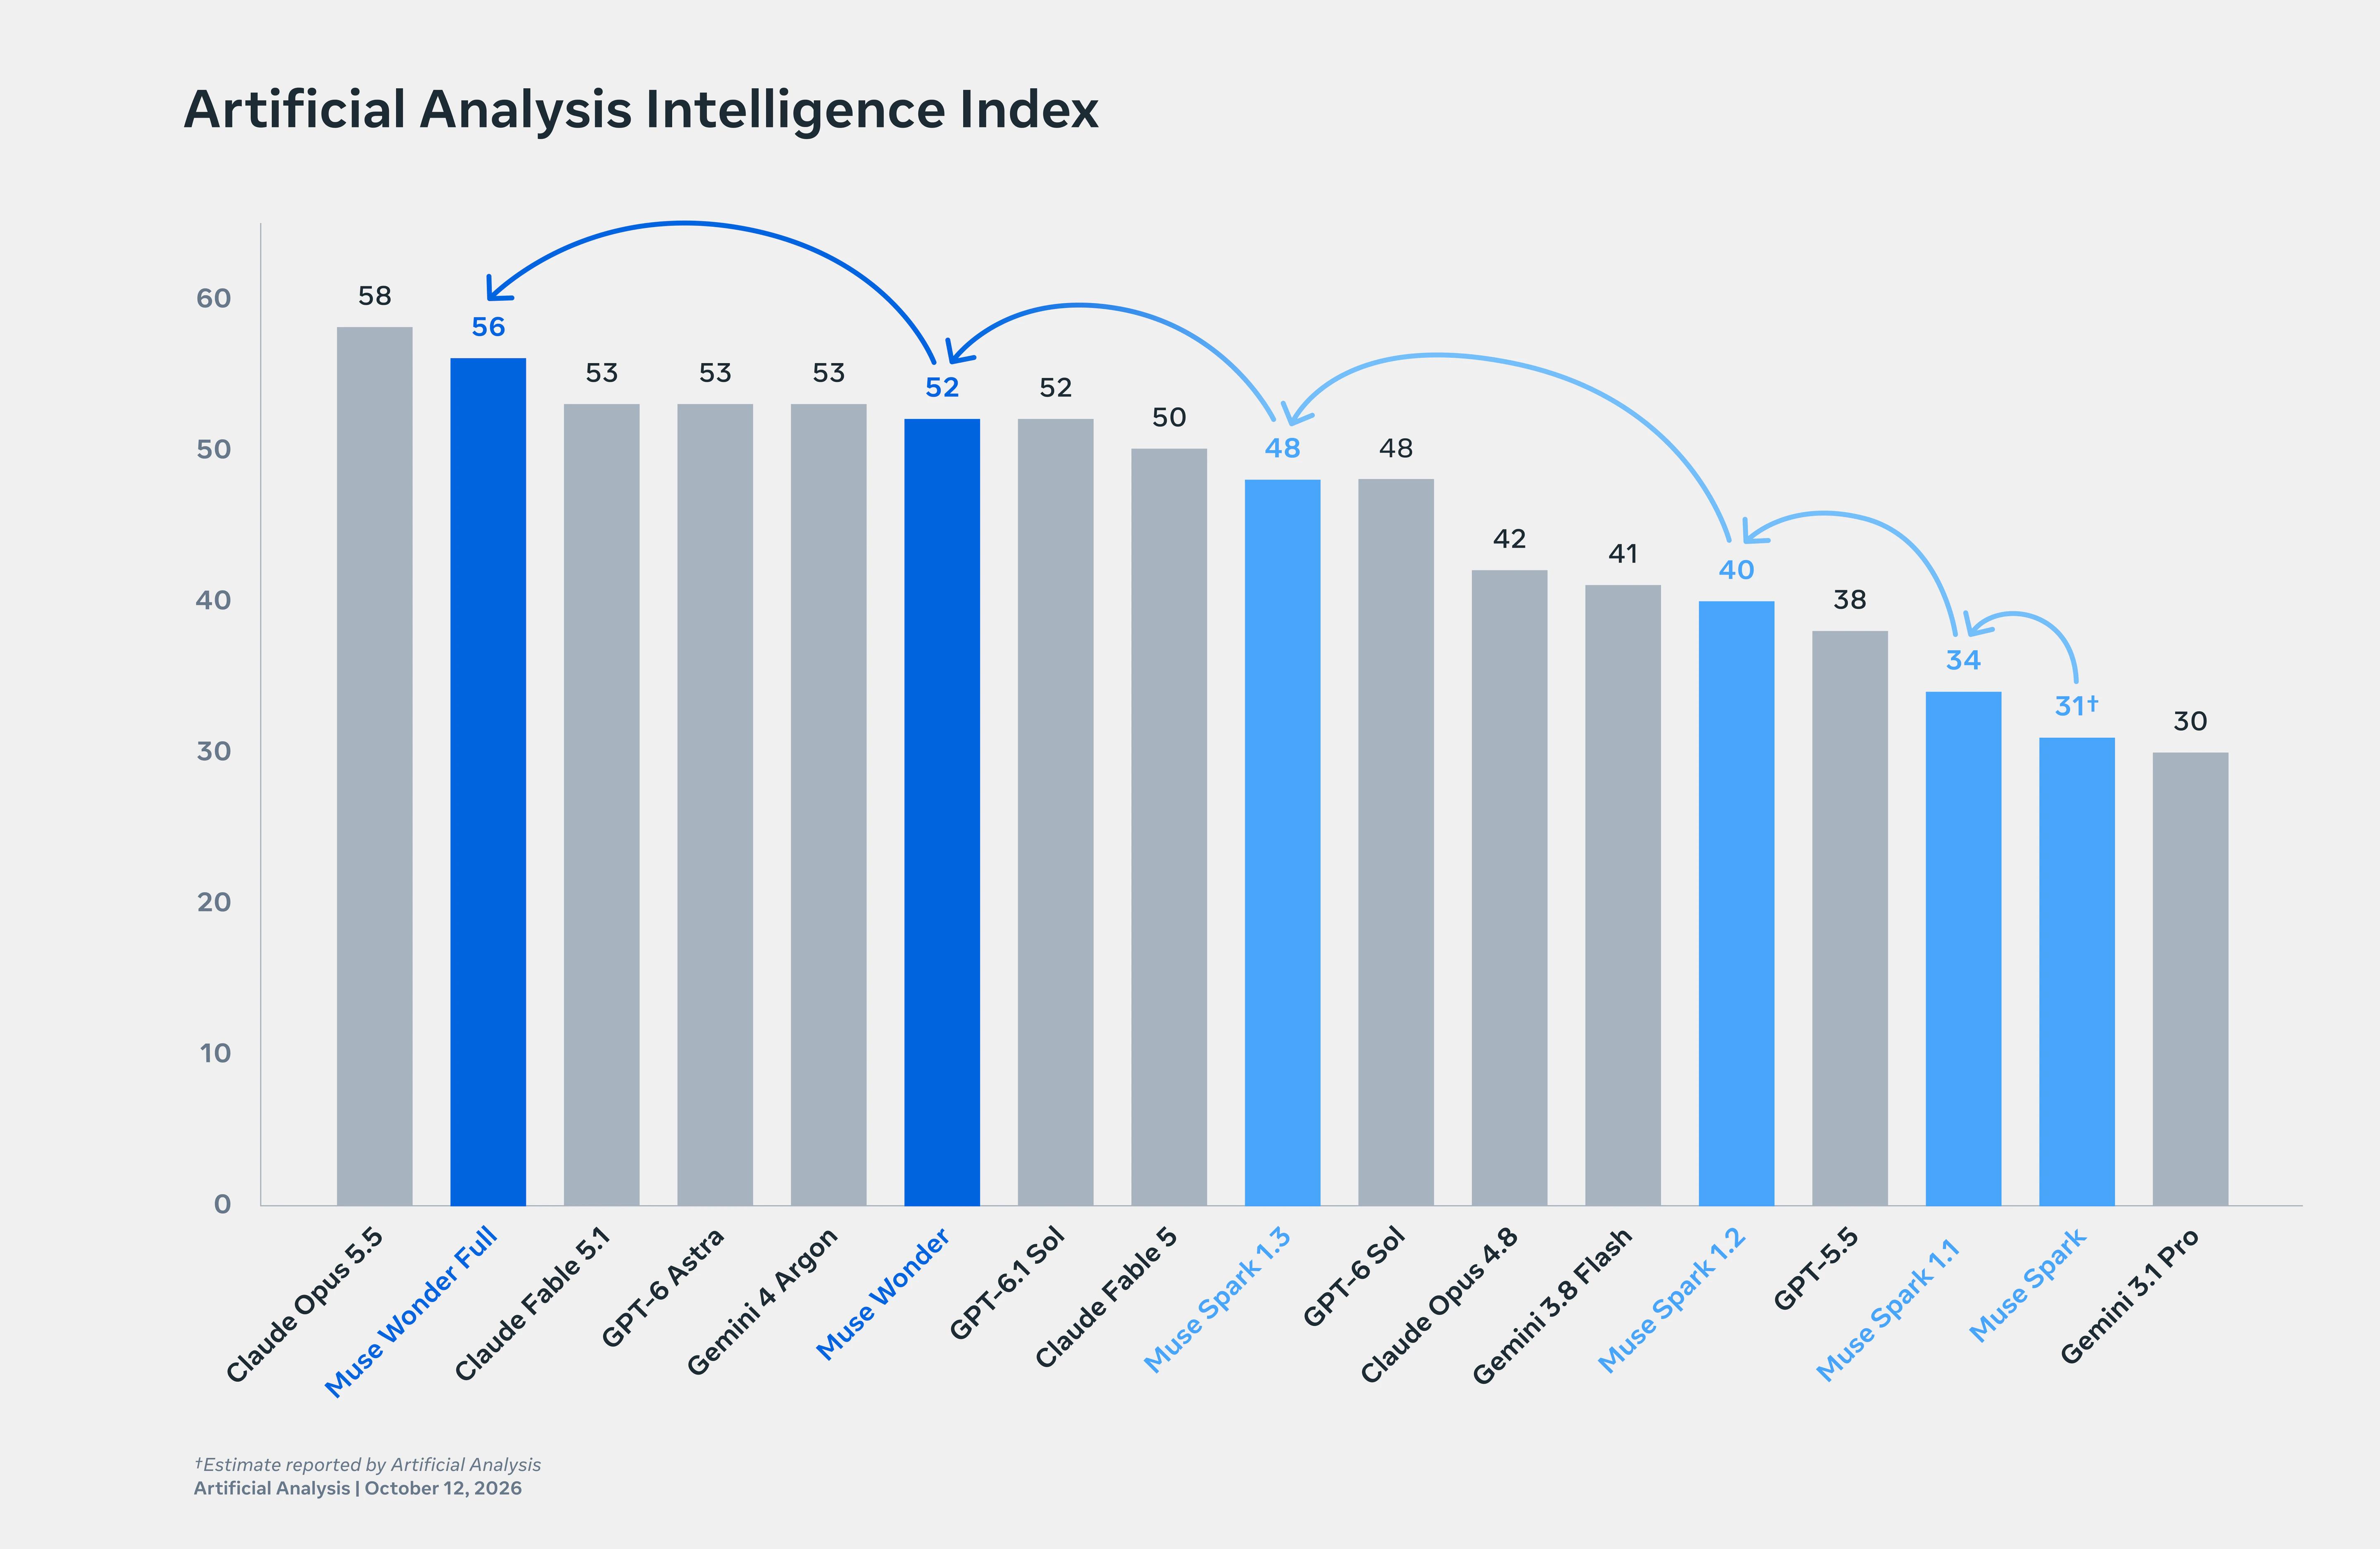
Wonder Full belegt auf der AA-Liste den zweiten Platz direkt hinter Opus 5.5, Bildquelle: Meta
Gleichzeitig hat das Qwen-Team QwenGyre vorgestellt, ein Online-Framework für verstärktes Lernen, das für extrem langwierige Agenten-Aufgaben ausgelegt ist. Die zugehörige Arbeitspapier wurde am 27. September auf arXiv eingereicht. Das zentrale Forschungsthema lautet: Wie kann das Trainingssystem diese Erfahrungen nutzen, wenn ein Agent mehrere Stunden lang arbeitet und Hunderte von Interaktionen mit der Umgebung durchführt – und wie kann der Leerlauf der teuren Rechenleistung reduziert werden?
Alle bereiten sich auf den Boom persönlicher Agenten vor.
Wenn das Modell nicht gut genug ist, kann man nicht von einem guten persönlichen Agenten-Erlebnis sprechen
Persönliche Agenten, also persönliche Assistenten, sind kein neues Konzept. Wir rufen schon seit vielen Jahren zu unseren Smartphones und hoffen, dass sie sich Dinge merken, Termine planen und Probleme für uns lösen.
Zu Beginn des Jahres hat der durch OpenClaw ausgelöste „Hummer“-Hype viele Menschen erstmals mit KI in Kontakt gebracht, die Dateien lesen, Tools aufrufen und kontinuierlich auf dem Computer arbeiten kann. Verständnis natürlicher Sprache, Tool-Ausführung, persönlicher Kontext und Hintergrundausführung werden endlich in einem einzigen Produkt kombiniert.
Erst danach haben Instinct und Muse den Wandel von aufgabenorientierten zu persönlichkeitszentrierten Agenten vorangetrieben – von PCs zu Smartphones, von Büroarbeiten zu alltäglichen Kleinigkeiten.
Bildquelle: Meta
Aber genau deswegen treten die Schwächen des Modells auf andere Weise zutage. Angenommen, Sie bitten einen persönlichen Agenten, eine Familienreise zu planen, und nennen das Budget, die freien Zeiten Ihrer Familienmitglieder sowie die Präferenz, nicht früh am Morgen zu fliegen. Wenn der Flug einige Tage später storniert wird, muss er Verkehr und Unterkunft neu überdenken.
Zu diesem Zeitpunkt reicht es nicht aus, zehn verschiedene Reisepläne aufzulisten. Er muss wissen, welche Vereinbarungen nicht mehr gültig sind, welche Einschränkungen weiterhin gelten und welche Punkte er Sie noch fragen muss. Wenn der gesamte Hintergrund jedes Mal neu erklärt werden muss, steht das sogenannte persönliche Agenten vor einer großen Herausforderung: dem persönlichen Kontext.
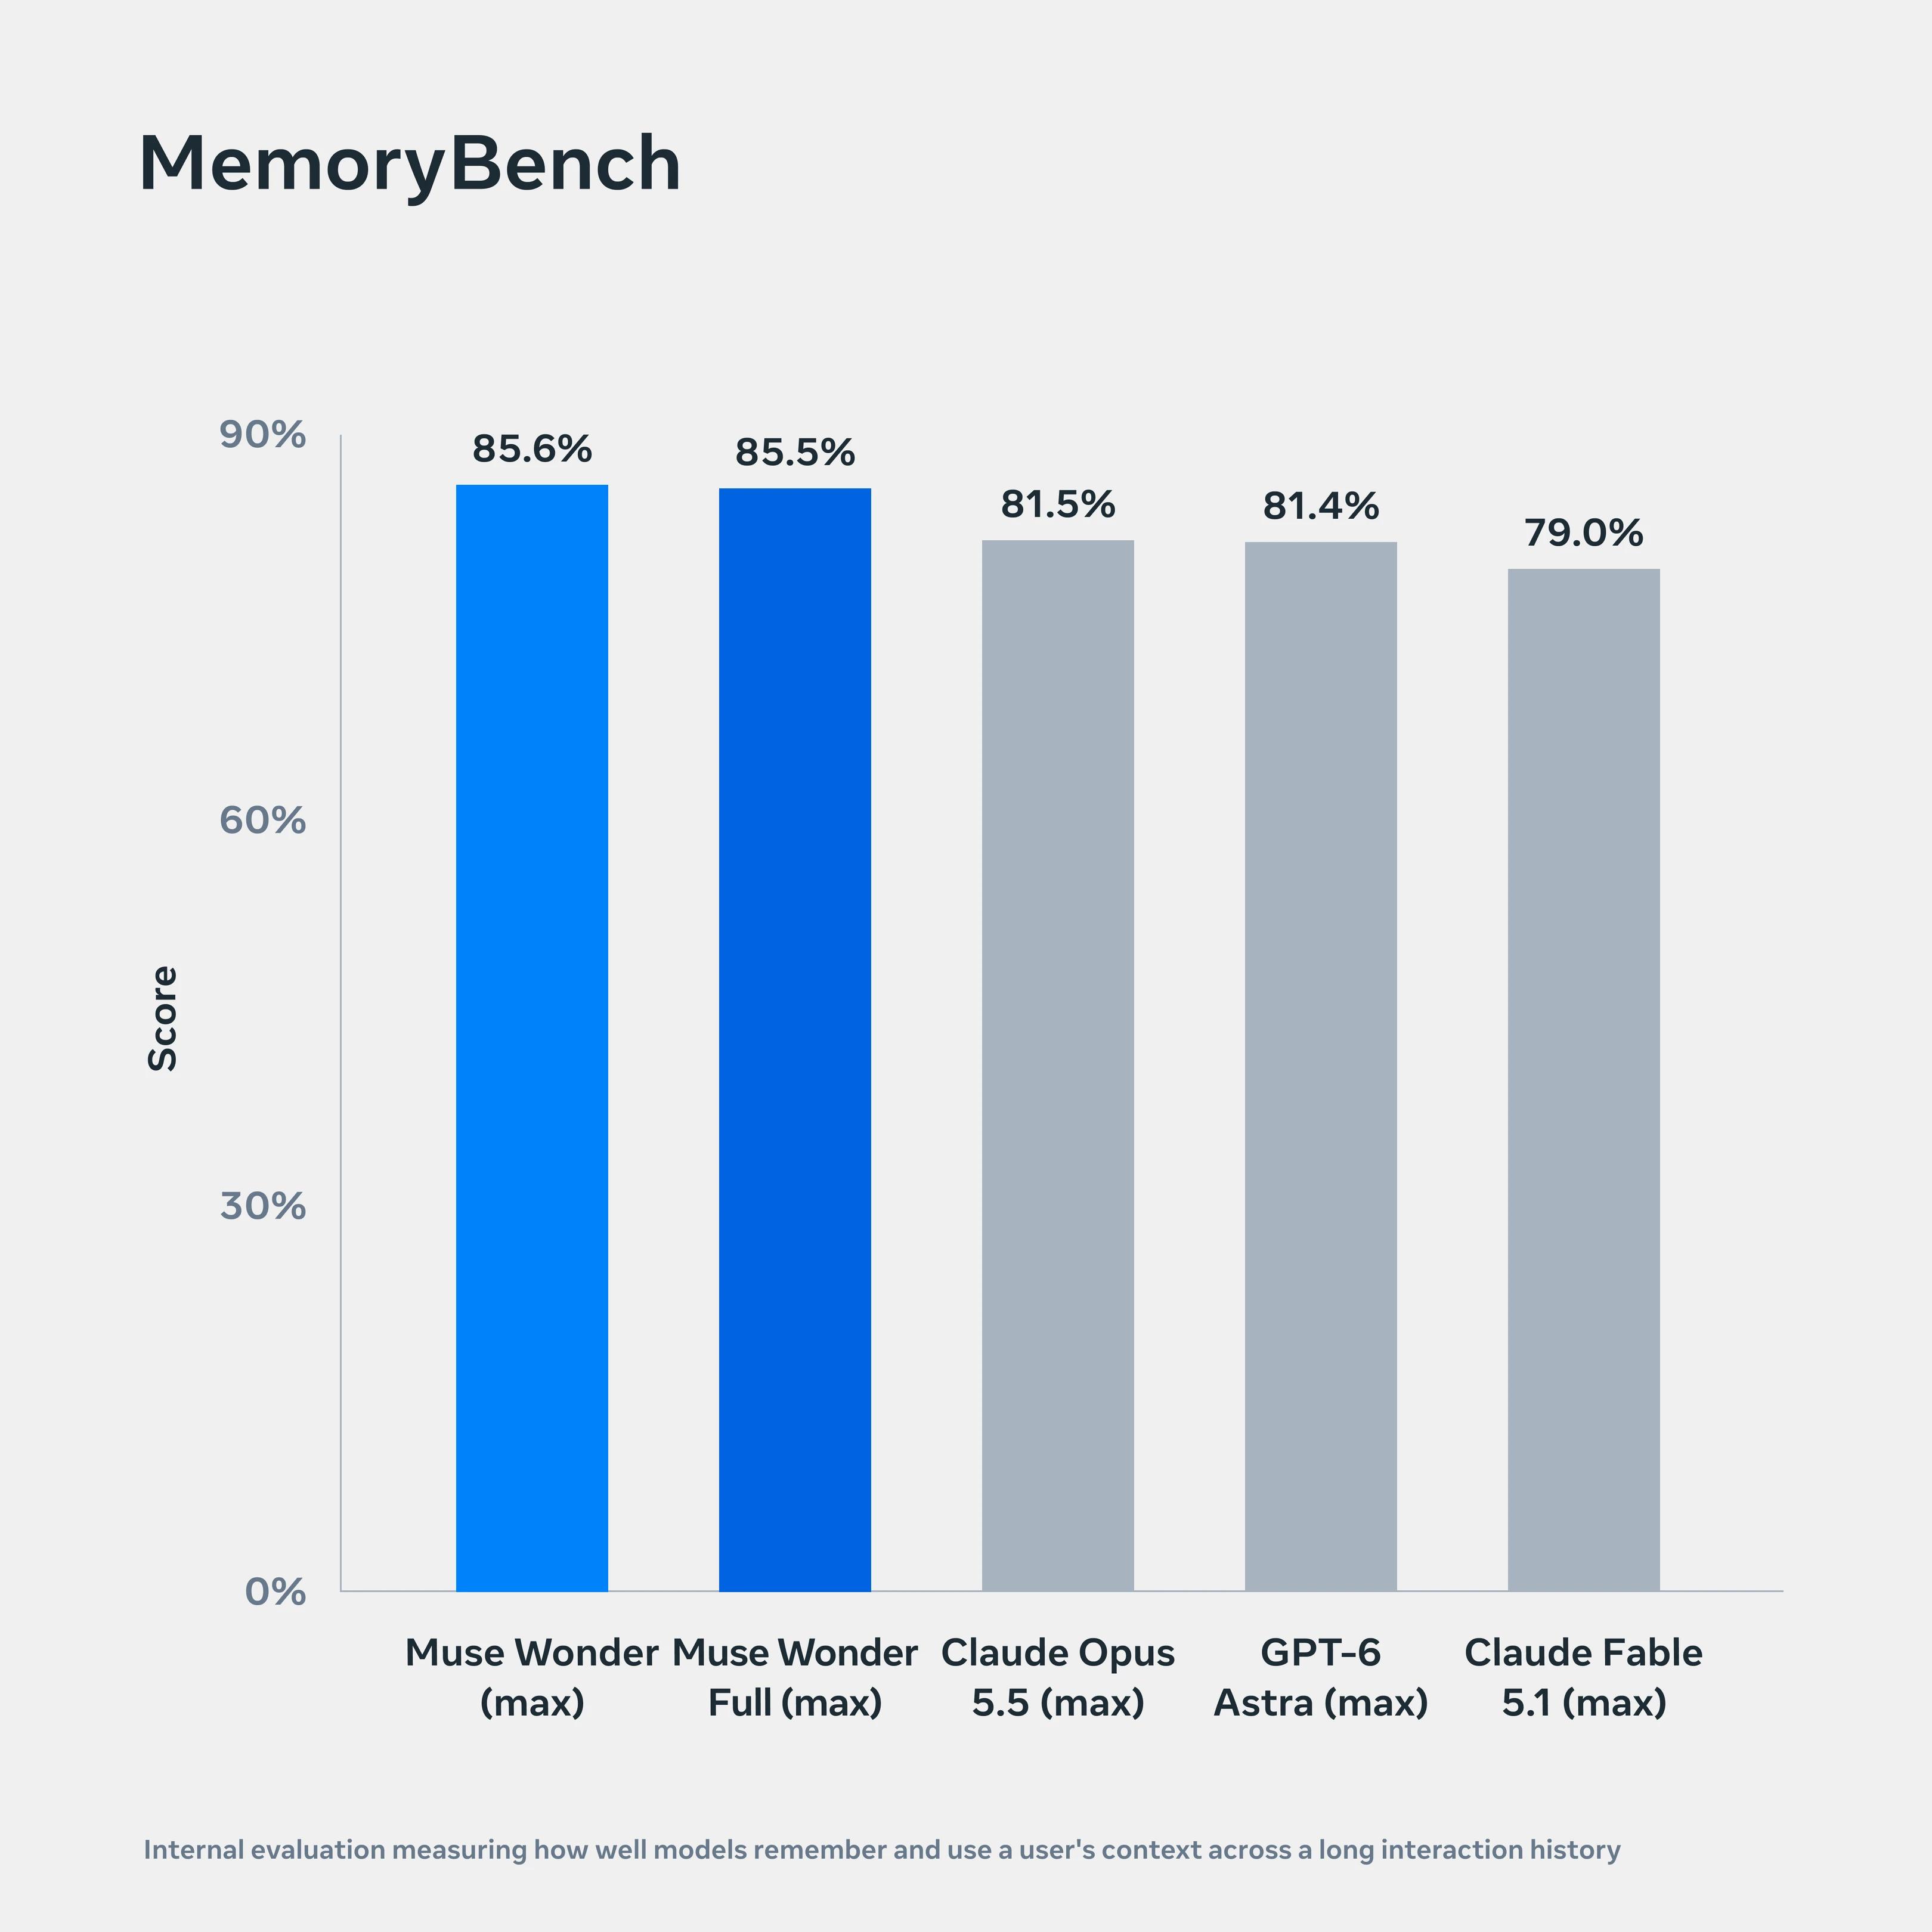
Das Active Memory von Muse Wonder zielt genau auf diese Art von Problemen ab. Für einen Agenten, der einer Person langfristig folgt, ist das Speichern von Informationen nur der Ausgangspunkt. Der Wert liegt darin, relevante Inhalte bei der Nutzung wiederzufinden. Eine Kleinigkeit, die Sie gestern erwähnt haben, könnte erst nächste Woche wichtig werden. Umgekehrt darf ein bereits geänderter Plan nicht die höchste Priorität behalten, nur weil er zuerst gespeichert wurde.
Von Meta veröffentlichte Informationen zeigen, dass der interne MemoryBench-Test komplexe Konversationen mit 64.000 bis 100.000 Token verwendet, Störinformationen sowie Inhalte hinzufügt, die mit ursprünglichen Informationen kollidieren oder später aktualisiert werden. Das kommt den Problemen, die persönliche Agenten verarbeiten müssen, viel näher als die einfache Prüfung, ob das Modell eine alte Information wiedergeben kann.
Bildquelle: Meta
Dennoch kann die Gedächtnisleistung in einem langen Gespräch nicht direkt belegen, dass das Modell eine Person bereits seit Monaten zuverlässig versteht. Wie Informationen gespeichert werden, wann sie abgerufen werden und wie Nutzer sie korrigieren oder löschen, muss gemeinsam durch das Produktdesign außerhalb des Modells realisiert werden. Ein Fenster mit einer Million Token kann mehr Inhalte aufnehmen, aber es sagt dem Modell nicht automatisch, welche alte Vereinbarung heute nicht mehr ausgeführt werden soll.
Hinzu kommt die Fähigkeit des Active Focus.
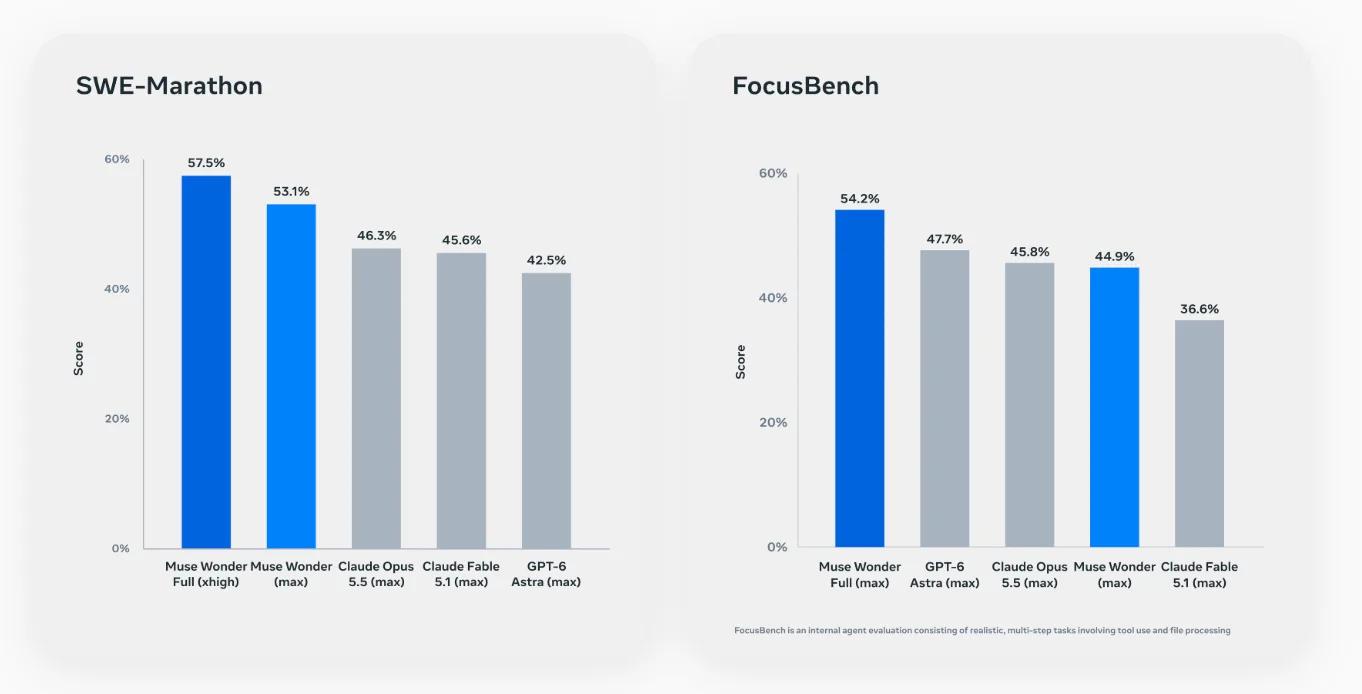
Nach der Beschreibung von Meta wird Muse Wonder alternative Lösungen ausprobieren, Hindernisse bewältigen und Maßnahmen an neue Informationen anpassen. Auf der offiziellen Produktseite werden langfristige Aufgabenplanung, Aufgabenteilung durch Unteragenten, parallele Tool-Aufrufe und Fehlerwiederherstellung als Schwerpunkte der Fähigkeiten aufgeführt. Das ist für persönliche Agenten sehr wichtig.
Bildquelle: Meta
Der Nutzer übergibt eine Angelegenheit, keine Reihe von Anweisungen, die er selbst einzeln überwachen muss. Wenn beispielsweise bei einer Datensammlung eine Webseite nicht geöffnet werden kann, sollte ein wirklich nützlicher Assistent beurteilen können, ob es andere Quellen gibt. Weiterzuarbeiten bedeutet manchmal, einen anderen Weg zu wählen, manchmal anzuhalten und den Nutzer um zusätzliche Informationen zu bitten – nicht einfach blind weiterzumachen.
Der interne FocusBench von Meta beginnt ebenfalls, diese Kontinuität zu testen, und konzentriert sich auf reale Hindernisse und dynamische Veränderungen bei Aufgaben wie Wohnen, Reisen und IT. Beide Muse-Wonder-Modelle wurden zudem mit verschiedenen langwierigen Aufgaben trainiert, um die Fähigkeit zur kontinuierlichen Fortführung zu erhalten.
Das bedeutet, dass persönliche Agenten die Anforderungen, die früher oft unter dem Begriff „intelligenter“ zusammengefasst wurden, aufteilen können: Informationen müssen korrekt gespeichert werden, Veränderungen müssen verfolgt werden, bei Problemen muss es Lösungen geben, und bei wichtigen Entscheidungen muss der Nutzer hinzugezogen werden. Diese Anforderungen sind bereits in die Fähigkeitsbeschreibungen und Bewertungssysteme der Modelle eingegangen.
Nach den von Meta veröffentlichten Plänen wird Wonder für das persönliche Agenten-Produkt Muse verwendet und zuerst für Abonnenten eingeführt.
Die Ausrichtung der Modelliteration wird angepasst, das Training muss ebenfalls angepasst werden
Wenn das Modell lernen soll, über lange Zeit zu arbeiten, muss es im Training tatsächlich arbeiten. QwenGyre als Online-Framework für verstärktes Lernen für extrem langwierige Agenten-Aufgaben löst das Problem, wie dieser Prozess effizienter gestaltet werden kann.
Beim Online-verstärkten Lernen führt das Modell Aufgaben aus, erhält Feedback und aktualisiert dann seine Parameter mit den neu erzeugten Erfahrungen. Je komplexer die Arbeit des Agenten wird, desto eher treten zwei Probleme im Training auf:
Das erste ist das Warten. In derselben Charge von Aufgaben sind einige bereits abgeschlossen, andere rufen noch Tools auf und ändern Pläne. Wenn die Rechenleistung nur warten kann, bis die gesamte Charge von Aufgaben abgelaufen ist, bevor das Training beginnt, oder fest in Ausführung und Training unterteilt wird, kann es vorkommen, dass einige GPUs bereits leerlaufen, während die Aufgaben noch ausgeführt werden.
Das zweite ist die Wiederholung. Der Agent komprimiert den Kontext, verteilt Unteraufgaben und versucht nach einem Fehler möglicherweise einen anderen Weg. Diese Prozesse erzeugen verschiedene Zweige, enthalten aber viele gemeinsame Erfahrungen. Wenn jeder Pfad vollständig zum Training verwendet wird, werden dieselben Inhalte wiederholt berechnet.
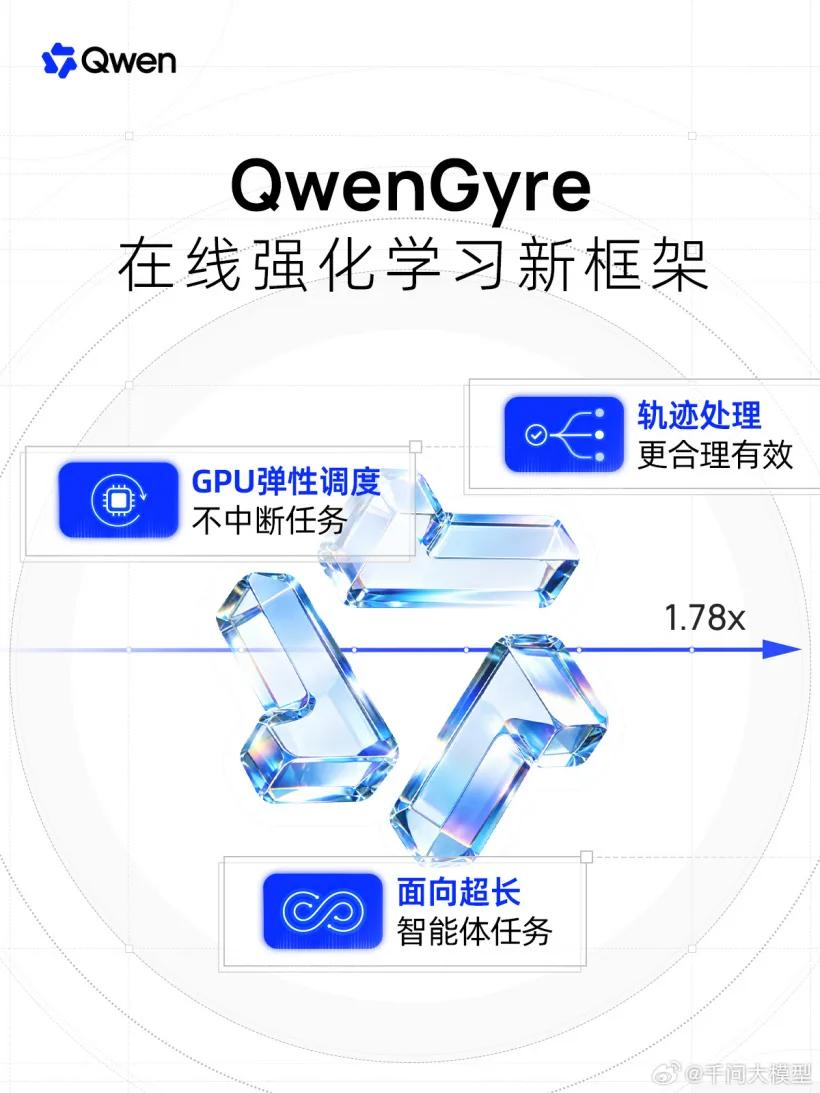
QwenGyre führt entsprechend zwei Maßnahmen durch: Es verteilt GPUs je nach Aufgabenfortschritt neu zwischen Ausführung und Training, während noch nicht abgeschlossene Aufgaben weiterlaufen. Anschließend organisiert es die verzweigten Ausführungsaufzeichnungen zu einem Trajektorienbaum mit gemeinsam genutzten Präfixen, um Wiederholungen zu reduzieren und den Umfang der Trainingsstichproben zu steuern. Selbst wenn eine Aufgabe die Zeit überschreitet, kann sie nützliches Feedback liefern, solange die erhaltenen Teilergebnisse bewertet werden können.
Bildquelle: Qwen
In den von Qwen veröffentlichten Experimenten verarbeitet Qwen 3.8 2.4T bei einer einzelnen Ausführung insgesamt etwa 700.000 Token. Nach 48 Schritten des verstärkten Lernens stieg die Bestehensrate bei NL2RepoBench von etwa 52,5 % auf 58,5 %. Bei gleichem GPU-Budget spart QwenGyre im Vergleich zum Async-Schema etwa 44 % der Trainingszeit ein, wobei die Trainingsergebnisse nahezu gleich sind.
Auch das ist erforderlich für persönliche Agenten.
Die bereits erwähnte Familienreise, bei der Flüge, Unterkunft und Verkehr neu arrangiert werden müssen, umfasst ebenfalls mehrere Runden von Operationen, Tool-Aufrufen und Anpassungen nach Fehlern. Das Modell muss ständig die externe Umgebung beobachten, Maßnahmen an neue Informationen anpassen und manchmal sogar den ursprünglichen Plan verwerfen. Das ist nicht nur eine Fähigkeit zum Aufruf von Tools, sondern umfasst auch Fähigkeiten wie langfristige Planung, Zustandspflege, dynamische Entscheidungsfindung und Fehlerwiederherstellung.
QwenGyre zielt genau auf diese Komplexität während der Aufgabenausführung ab und versucht, die entsprechenden Probleme beim Modelltraining zu lösen.
Für Alibaba ist dieser Weg ganz natürlich.
Bildquelle: Alibaba
Qwen hat eindeutig festgelegt, persönliche Agenten zu entwickeln und die entsprechenden Fähigkeiten auf der Grundlage der Qwen 3.8-Serie aufzubauen. QwenGyre wird bereits für das langfristige Training der Flaggschiff-Modelle derselben Serie verwendet. Das Team gibt an, dass es den Aufgabenbereich und das Trainingsvolumen weiter ausweiten möchte. Anwendungen erfordern, dass das Modell kontinuierlich arbeitet, und das Trainingsrahmenwerk senkt die Kosten für langwierige Aufgaben – es gibt konkrete Gründe für die weitere Integration.
Daher ist es sehr wahrscheinlich, dass Alibaba QwenGyre weiterhin für das zukünftige Agenten-Training von Qwen-Modellen verwenden und die Szenarien für persönliche Assistenten erforschen wird. Dies kann sich sowohl in neuen Generationen von Modellen widerspiegeln als auch durch nachträgliches Training vorhandener Modelle realisiert werden.
Nach dem Codieren definieren persönliche Agenten den Begriff „KI“ neu
Der Einfluss von Anwendungen auf Modelle wurde bereits in der Phase der Codierungs-Agenten einmal bestätigt. Früher half KI beim Programmieren hauptsächlich, Code zu vervollständigen. Später begannen Nutzer, das gesamte Projekt Claude Code oder Codex zu übergeben, und forderten es auf, die Beziehungen zwischen Dateien zu verstehen, Code zu ändern, Tests auszuführen und Fehler nach der Fehlermeldung weiter zu beheben.
Die Aufgaben der KI haben sich geändert, und das Optimierungsziel des Modells hat sich entsprechend geändert. Die langen Ausführungszeiten, parallelen Tool-Aufrufe und Dateigedächtnis, die bei der Veröffentlichung von Claude 4 hervorgehoben wurden, sowie die Optimierung von GPT-5-Codex für agentenartiges Programmieren, reagieren alle auf diese Anf