1 GW Rechenkapazität, ein Jahr Zeit, Metas quellgeschlossene Modelle dominieren alle Ranglisten, verkauft Zuckerberg keine APIs?
Meta kehrt zurück zum Kernwettbewerb der hochmodernen großen Modelle.
In den frühen Morgenstunden des 13. Oktober nach Pekinger Zeit hat das Superintelligence-Labor von Meta offiziell zwei neue Modelle veröffentlicht: Muse Wonder und Muse Wonder Full.
Dies ist das erste hochmoderne Flaggschiffmodell (Frontier Model), das Meta seit der Übernahme von Scale AI für 14,3 Milliarden US-Dollar im letzten Jahr und der Ernennung seines Gründers Wang Tao (Alexandr Wang) zum Leiter der KI-Forschungs- und Entwicklungsarbeit auf den Markt gebracht hat.
In einem nach der Modellveröffentlichung ausgestrahlten ausführlichen Videointerview enthüllten Mark Zuckerberg, Geschäftsführer von Meta, und Wang Tao, dass diese beiden Modelle mit dem internen Codenamen "Wassermelone" (Watermelon) auf dem über 1 Gigawatt großen Supercluster "Prometheus" in Ohio trainiert wurden und mehr als ein Jahr intensiver Forschung und Entwicklung des Teams widerspiegeln.
Nur etwa sechs Wochen nach der Veröffentlichung der vorherigen Generation Muse Spark 1.3 haben die neuen Modelle deutliche Fortschritte in den umfassenden Intelligenzbewertungen erzielt.
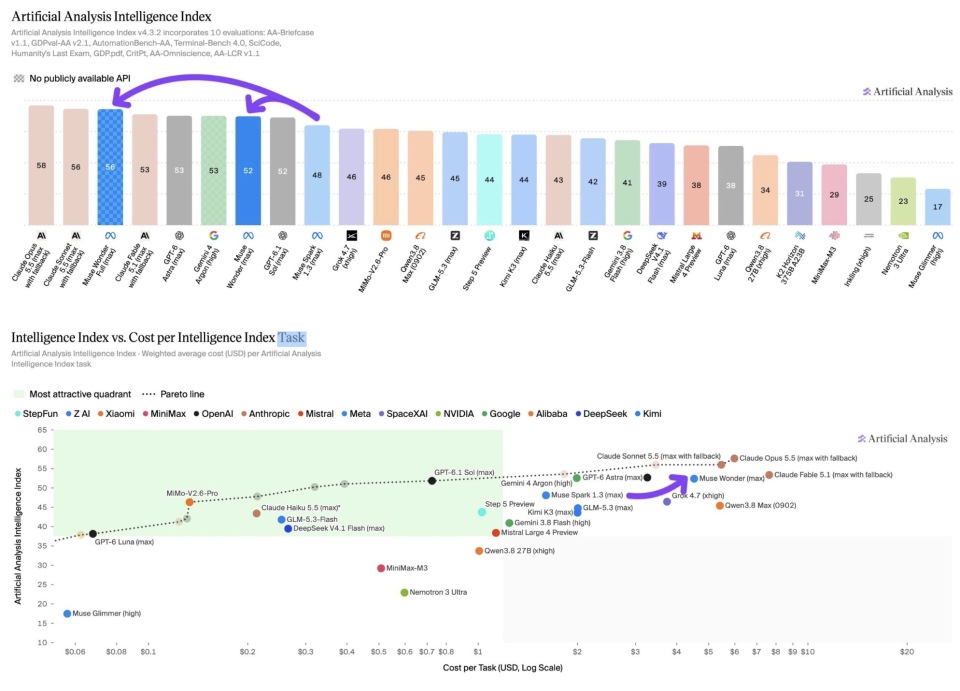
Leistungsdaten von Artificial Analysis
Daten des Drittbewertungsinstituts Artificial Analysis zeigen, dass bei höchster Inferenzintensität der umfassende Intelligenzindex (Intelligence Index v4.3) von Muse Wonder und Muse Wonder Full 52 bzw. 56 Punkte erreicht, was um 4 bzw. 8 Punkte höher ist als die 48 Punkte von Muse Spark 1.3.
Dabei erreicht Muse Wonder Full das Niveau von Claude Sonnet 5.5 von Anthropic, übertrifft GPT-6 Astra von OpenAI und Gemini 4 Argon von Google (beide mit 53 Punkten) und liegt nur hinter dem Flaggschiffmodell Claude Opus 5.5 von Anthropic (58 Punkte).
Neben den Leistungsverbesserungen hat Meta mit dieser Veröffentlichung ein weiteres wichtiges Signal gesetzt: Dieser Technologieriese, der einst die Popularisierung großer Modelle mit der quelloffenen Llama-Serie vorangetrieben hat, führt nun einen geschlossenen Quellcode-Hosting-Mechanismus für seine hochmodernen Top-Modelle ein.
Für beide Muse-Wonder-Modelle sind keine Modellgewichte zum Herunterladen für Nutzer freigegeben. Das leistungsstärkere Muse Wonder Full ist vorübergehend nur für zahlende Abonnenten des Programmierassistenten Muse Code zugänglich, und es wird keine öffentliche API-Aufruffunktion bereitgestellt.
01 Verbesserte umfassende Intelligenz, Ausrichtung auf langzyklische Agenten
In der vergangenen Zeit konzentrierte sich die Muse-Spark-Serie von Meta hauptsächlich auf Kosten und Praktikabilität, während die neu veröffentlichte Muse-Wonder-Serie den Wettbewerbsschwerpunkt auf die komplexere Ausführungsfähigkeit von langzyklischen Agenten verlagert.
Die Bewertung von Artificial Analysis zeigt, dass Muse Wonder Full bei zehn Bewertungen des umfassenden Intelligenzindex sechs Mal unter die ersten drei Plätze gelangt. Im langzyklischen Programmiertest SWE-Marathon erzielte Muse Wonder Full 57,5 Punkte, was höher ist als die 46,3 Punkte von Claude Opus 5.5 und die 42,5 Punkte von GPT-6 Astra. Dies zeigt die Fähigkeit, in langfristigen Softwareprojekten die Entwicklung kontinuierlich voranzutreiben und Fehler selbst zu korrigieren.
Im Terminal-Automatisierungstest Terminal-Bench 4.0 stieg die Punktzahl von Muse Wonder Full von 33 % bei Muse Spark 1.3 auf 57 %, und die Standardversion Muse Wonder erreichte ebenfalls 52 %. Dies zeigt, dass beide neuen Modelle deutliche Fortschritte bei Agentenaufgaben wie dem Aufrufen von Tools und dem Ausführen von Befehlen erzielt haben. Darüber hinaus erzielte Muse Wonder Full im Harvey-Rechtsagententest 13,1 Punkte, was höher ist als die 8,6 Punkte von GPT-6 Astra und die 4,2 Punkte von Claude Opus 5.5, und belegte mit 33 % den ersten Platz im CritPt-Wissenschaftslogiktest.
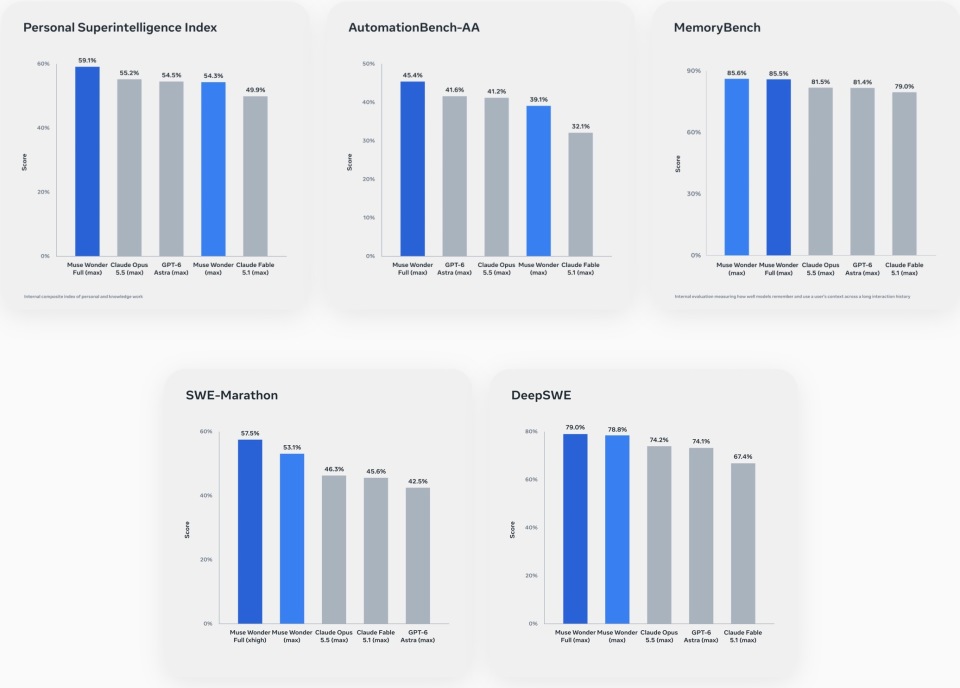
Vergleichsleistung der Muse-Wonder-Serie bei mehreren Schlüsselindikatoren wie persönlicher Superintelligenz, langzyklischer Programmierung (SWE-Marathon) und Agentengedächtnis (MemoryBench)
Um komplexe langzyklische Aufgaben zu unterstützen, hat Meta zwei Kernmechanismen eingeführt: Active Memory (aktives Gedächtnis) und Active Focus (aktive Konzentration).
Wang Tao betonte im Interview, dass das aktive Gedächtnis es dem Modell ermöglicht, den persönlichen und beruflichen Hintergrund der Nutzer über verschiedene Sitzungen hinweg zu behalten und historische Details bei neuen Aufgaben aktiv abzurufen und zu nutzen. Dadurch wird das alte Problem traditioneller Agenten mit schlechtem Gedächtnis deutlich verbessert.
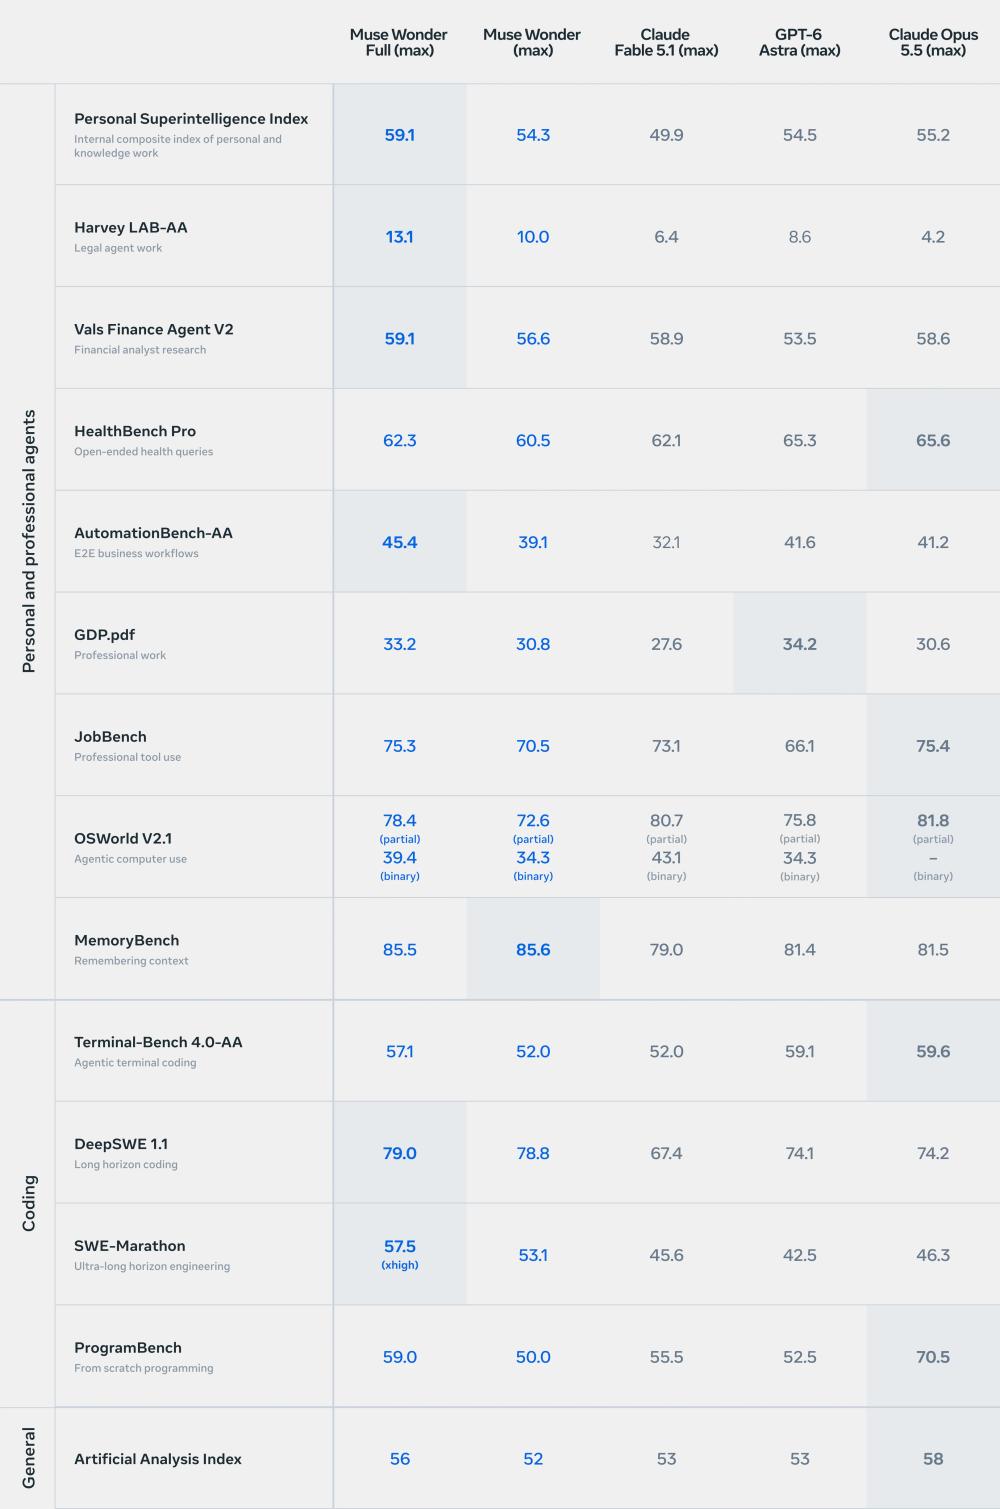
Vergleichsdaten der Muse-Wonder-Serie mit gängigen Flaggschiffmodellen bei einzelnen Indikatoren für persönliche/berufliche Agenten, Programmierung und umfassende Bewertungen
Allerdings sind die neuen Modelle nicht in allen Bereichen führend.
Im umfassenden Intelligenzindex liegt Muse Wonder Full mit 58 Punkten immer noch hinter Claude Opus 5.5 zurück. Im medizinischen Test HealthBench Pro liegt sein Ergebnis von 62,3 Punkten ebenfalls unter dem von Opus 5.5 und GPT-6 Astra. Eine objektivere Beurteilung lautet, dass Muse Wonder Full erfolgreich in die Spitzengruppe hochmoderner Modelle eingetreten ist, aber noch keine absolute Dominanz in allen Fähigkeiten erreicht hat.
02 Verbesserte Inferenzeffizienz, aber hohe Kosten pro Aufgabe
Neben der Intelligenzsteigerung zeigen die Daten von Artificial Analysis auch, dass der Verbrauch von Ausgabe-Tokens bei der Erledigung von Bewertungsaufgaben durch die Muse-Wonder-Serie gesunken ist.
Bei Aufgaben des umfassenden Intelligenzindex verbrauchen Muse Wonder und Muse Wonder Full bei höchster Inferenzintensität durchschnittlich etwa 54.000 Ausgabe-Tokens pro Aufgabe, was um etwa 10 % weniger ist als die etwa 60.000 Tokens von Muse Spark 1.3.
Dieser Verbrauch liegt unter den 62.000 Tokens von Gemini 4 Argon und den 78.000 Tokens von Claude Fable 5.1, aber über den 38.000 Tokens von GPT-6.1 Sol und den 27.000 Tokens von GPT-6 Astra.
Bei Eingabe-Tokens verbraucht Muse Wonder Full durchschnittlich etwa 6,44 Millionen Eingabe-Tokens pro Aufgabe, was um etwa 16 % weniger ist als die etwa 7,69 Millionen Tokens der Standardversion Muse Wonder. Das bedeutet, dass die Flaggschiffversion bei gesteigerter Intelligenz eine höhere Effizienz bei der Nutzung von Tokens aufweist.
Bei der kommerziellen Preisgestaltung setzte Meta für die Standardversion Muse Wonder einen API-Preis von 4 US-Dollar pro Million Eingabe-Tokens, 20 US-Dollar pro Million Ausgabe-Tokens und 0,20 US-Dollar für zwischengespeicherte Eingaben fest, was genau dem Standard-API-Preis von Claude Opus 5.5 entspricht.
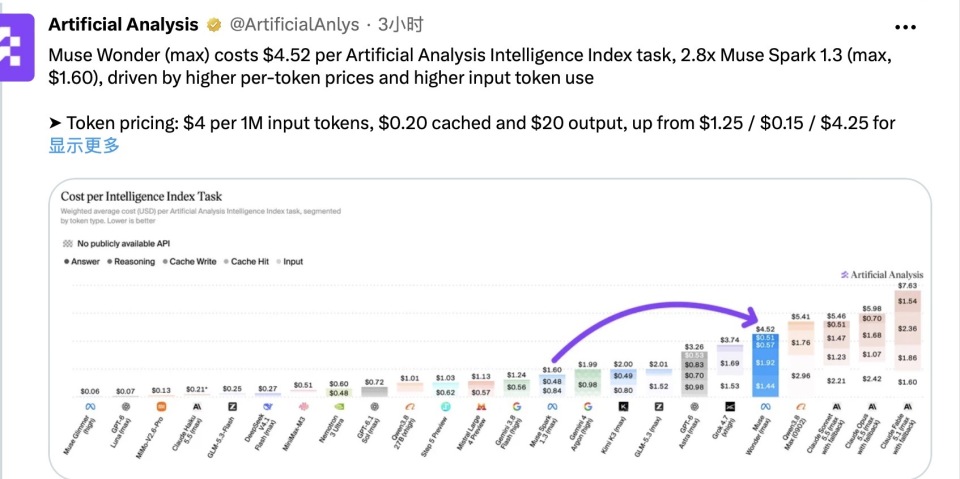
Das Vergleichsdiagramm der Kosten pro Aufgabe von Artificial Analysis zeigt, dass die durchschnittlichen Kosten von Muse Wonder (max) pro Aufgabe 4,52 US-Dollar betragen, was weit höher ist als bei der Vorgängerversion Spark 1.3 (1,60 US-Dollar) und GPT-6 Astra (3,26 US-Dollar), aber unter dem Flaggschiffmodell der Claude-Serie liegt
Laut Schätzungen von Artificial Analysis belaufen sich die Kosten für die Erledigung einer Bewertungsaufgabe des umfassenden Intelligenzindex durch Muse Wonder auf etwa 4,52 US-Dollar. Diese Kosten pro Aufgabe sind zwar niedriger als die 5,98 US-Dollar von Claude Opus 5.5 und die 5,46 US-Dollar von Claude Sonnet 5.5, aber höher als die 3,26 US-Dollar von GPT-6 Astra, 1,99 US-Dollar von Gemini 4 Argon und 1,60 US-Dollar von Muse Spark 1.3.
03 Flaggschiffmodelle gehen zu geschlossenem Quellcode über, Berechtigungen für die Bereitstellung werden eingeschränkt
Verglichen mit der technischen Leistung hat der Wechsel von Meta bei der Offenlegung von Modellen und der kommerziellen Bereitstellung mehr Aufmerksamkeit in der Branche erregt.
Die Standardversion Muse Wonder wird über die Meta Model API und Muse Code bereitgestellt, während die Flaggschiffversion Muse Wonder Full vorübergehend nur für Muse-Code-Nutzer verfügbar ist und keine öffentliche API-Aufruffunktion unterstützt.
Derzeit bietet Muse Code zwei Abonnementstufen für Muse Wonder Full an: die Power-Stufe für 50 US-Dollar pro Monat und die Maximum-Stufe für 200 US-Dollar pro Monat. Beide Stufen weisen Nutzungsbeschränkungen auf und gewähren keinen uneingeschränkten Zugriff auf die Entwickler-API. Das bedeutet, dass Unternehmen das Flaggschiffmodell im Programmierassistenten von Meta testen können, es aber nicht direkt in ihren eigenen Produktionssystemen oder Anwendungen auf Kundenseite bereitstellen können.
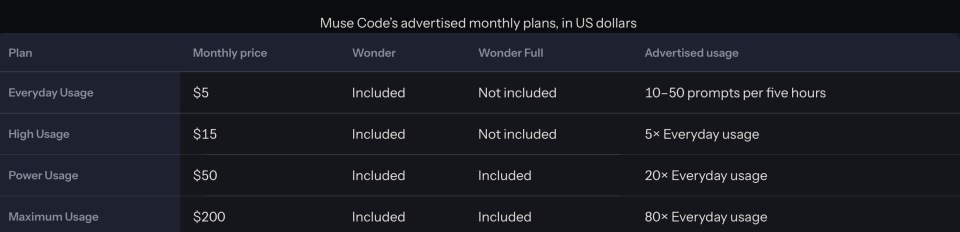
Übersicht der monatlichen Tarife von Muse Code, die Flaggschiffversion Muse Wonder Full ist streng auf die höherstufigen Abonnementstufen von 50 US-Dollar (Power) und 200 US-Dollar (Maximum) pro Monat beschränkt
Datengovernance und Datenschutzrichtlinien verdienen ebenfalls die Aufmerksamkeit von Unternehmenskäufern.
Einerseits wird die nutzungsabhängig bezahlte Muse-Wonder-API nur im Standardmodus bereitgestellt (eingereichte Inhalte werden nicht für das Modelltraining verwendet), während das Muse-Code-Abonnement standardmäßig den Contributor-Modus aktiviert (Meta darf eingereichte Prompts, Codes und Dateien zur Verbesserung des Modells verwenden).
Andererseits können Unternehmenskunden zwar die Zusage zur Null-Datenspeicherung (ZDR) beantragen, aber nach der Aktivierung stehen Funktionen wie der Sitzungsstatus auf dem Server, Hintergrundanfragen, Dateiuploads und die integrierte Websuche nicht mehr zur Verfügung.
Für Agenten, die auf Kontext und langzyklische Ausführung angewiesen sind, müssen Unternehmen bei der Beschaffung einen vorsichtigen Ausgleich zwischen dem Datenschutzmechanismus und der Funktionsverfügbarkeit vornehmen.
04 Umstellung auf die praktische Anwendung von Agenten, die kommerzielle Prüfung hat gerade erst begonnen
Mark Zuckerberg und Wang Tao empfangen ein Interview
Die Veröffentlichung von Muse Wonder bedeutet, dass Meta von seiner bisherigen Modelllinie, die auf Leichtgewicht und Kostenleistung ausgerichtet war, vollständig in den Markt für hochmoderne Intelligenz und professionelle Agenten einsteigt.
Wie Zuckerberg im Interview sagte, gibt sich Meta nicht damit zufrieden, ein reines Anwendungsunternehmen zu sein. Stattdessen baut es durch die tiefe Kontrolle über grundlegende Gigawatt-Datenzentren, selbst entwickelte Chips und hochmoderne Modellarchitekturen eine persönliche Superintelligenz auf, die die Arbeit und das Leben der Menschen wirklich verändern kann.
Der Wettbewerb zwischen den Giganten im Silicon Valley hat sich von dem reinen Vergleich umfassender Bewertungspunkte auf Programmierfähigkeiten, den Abschlussgrad professioneller Aufgaben, die Effizienz des Toolaufrufs und die Leistung bei langzyklischer Ausführung ausgedehnt. Seit der Einführung von Wang Tao als Leiter des KI-Teams und dem Aufbau des Prometheus-Datenzentrums im letzten Jahr verwandeln sich die riesigen Investitionen von Meta in echte Wettbewerbsfähigkeit der Modelle.
Aber die Prüfung der kommerziellen Umsetzung hat gerade erst begonnen. Die Kosten pro Aufgabe der Standardversion Muse Wonder haben keinen absoluten Vorteil erzielt, und das stärkste Modell Muse Wonder Full befindet sich noch in einem Zustand mit geschlossenem Quellcode und eingeschränktem API-Aufruf.
Als Nächstes muss Meta nicht nur beweisen, dass seine Modelle in echten Unternehmensumgebungen einen stabilen Automatisierungsnutzen bringen, sondern auch ein langfristiges Gleichgewicht zwischen der quelloffenen Ökologie und der kommerziellen Nutzung mit geschlossenem Quellcode finden.
Der freie Übersetzer Wuji hat ebenfalls zu diesem Artikel beigetragen
Dieser Artikel stammt von „Tencent Technology“, Autor: Su Yang, Redakteur: Xu Qingyang, von 36Kr mit Genehmigung veröffentlicht.