Neuer RSI-Durchbruch: Die Teams von UC Berkeley und Sakana AI stellen „Multi-Agent-Selbstüberwachung“ MASS vor.
Verbesserte Kugelpackungsgrenzen, neue Gluon-Streuformeln sowie experimentell validierte Nanokörperdesigns … Fortschrittliche KI-Systeme haben bereits begonnen, originelle Ergebnisse in der wissenschaftlichen Forschung zu erzielen.
Wie kann dieser Prozess fortgesetzt und die Effizienz der Forschung weiter gesteigert werden? Rekursive Selbstverbesserung (Recursive Self-Improvement, RSI) gilt als ein vielversprechender Ansatz.
RSI wird hauptsächlich von zwei Kernkomponenten angetrieben: Bewertung und Verbesserung. Bei der Spitzenforschung stehen diese beiden Glieder jedoch vor praktischen Schwierigkeiten: Auf der Bewertungsebene ist es schwierig, zuverlässige Bewertungsergebnisse zu erhalten, wenn die Forschungsergebnisse die Urteilsfähigkeit bestehender menschlicher Experten übersteigen oder die Rückmeldung aus Experimenten sehr lange dauert. Auf der Verbesserungsebene muss das Modell anhand hochwertiger Ausführungsspuren lernen, deren Qualität wiederum davon abhängt, ob der Arbeitsablauf angemessen ist. Die manuelle Anpassung von Gliedern wie Aufgabenzerlegung, Werkzeugnutzung und Ergebnisvalidierung für verschiedene Aufgaben und Bereiche ist sehr aufwendig und lässt sich nur schwer verbreiten.
Das Problem liegt ferner darin, dass Modelle oft auf sich selbst angewiesen sind, um ihre eigene Leistung zu beurteilen und zu verbessern. Aufgabengenerierung, Ergebnisbewertung und Arbeitsablaufanpassung basieren alle auf dem vorhandenen Wissen und Urteilsvermögen des Modells. Wenn diese Urteile selbst Abweichungen aufweisen, kann die Selbstrückmeldung Fehler fortwährend fortsetzen.
Aus diesem Grund haben die Universität Berkeley in Kalifornien und das Team von Sakana AI das Konzept der „Multi-Agent-Selbstüberwachung“ (Multi-Agent Self-Supervision, MASS) vorgeschlagen, das die Koordination mehrerer Agenten nutzt, um Selbstüberwachung für RSI zu generieren.
Link zum Papier: https://arxiv.org/pdf/2610.12176
Genauer gesagt lassen sie dasselbe Modell abwechselnd die Rollen des Aufgabenlösungsagenten, des Arbeitsablaufoptimierers und des Bewerters übernehmen. Zuerst wird unter der Voraussetzung eingefrorener Gewichte optimiert, wie mehrere eigene Kopien zusammenarbeiten, anschließend werden die durch die Zusammenarbeit erzeugten Spuren zurück zu den gemeinsamen Gewichten destilliert.
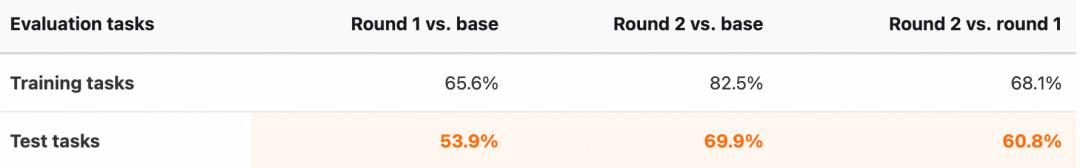
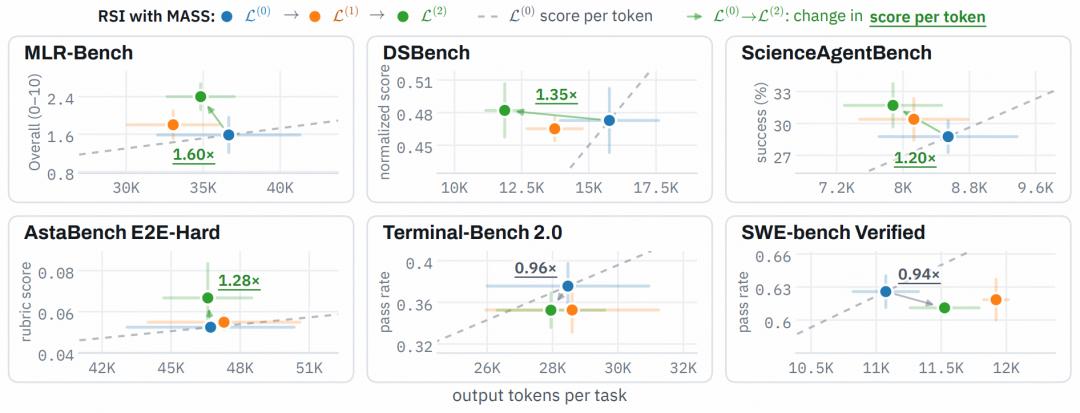
Nach zwei Runden des MASS-Zyklus stieg die Gewinnrate von Qwen3.6-27B gegenüber externen starken Modellrichtern bei drei Testaufgaben von 53,9 % auf 69,9 %, und der Punktwert pro ausgegebenem Token bei vier öffentlichen wissenschaftlichen Benchmarks erreichte das 1,2–1,6-fache des Basis-Modells.
Darüber hinaus stellten sie fest, dass die optimierten Arbeitsabläufe Informationsübermittlung und Agentenrouting entsprechend den Aufgabeneigenschaften organisieren. In der ersten Experimentierrunde erreichte das Multi-Agent-Schülermodell eine Gewinnrate von 68,3 % gegenüber dem Basis-Modell. Als Vergleich trainierte das Single-Agent-Schülermodell mit etwa dem 1,4-fachen an verarbeiteten Überwachungs-Tokens und erzielte eine Gewinnrate von 64,0 %. Dies zeigt, dass gemeinsames Lernen von Orchestrierung und begrenzter Ausführung durch Unteragenten eine effektivere Überwachung für RSI liefern kann.
Diese Ergebnisse zeigen, dass die Optimierung der Kooperationsweise zwischen Agenten und die Ausführung von Arbeiten durch jeden Unteragenten in einem klar definierten Aufgabenbereich dazu beiträgt, die Qualität der Trainingsdaten zu verbessern und effektivere Überwachungssignale für die fortlaufende Verbesserung des Modells bereitzustellen.
I. Forschungsmethodik
MASS aktiviert zuerst die kollektive Intelligenz des Multi-Agent-Teams durch Optimierung des Arbeitsablaufs und destilliert anschließend die Teamerfahrung in das gemeinsame Modell. Der innere Zyklus optimiert den Arbeitsablauf des Teams unter der Voraussetzung, dass die Modellgewichte festgelegt bleiben, wobei das Modell selbst bewertet und entscheidet, welcher Arbeitsablauf optimal ist. Der äußere Zyklus aktualisiert die Gewichte, indem er die Ausführung des optimierten Arbeitsablaufs erlernt. Die folgende Animation zeigt den Vorgang:
Video │ MASS-Animationsdarstellung. Die Arbeitsablaufsuche verändert die Kooperationsweise zwischen den Agenten; das Training auf Basis der ausgewählten Ausführungsspuren überträgt diese Erfahrungen in die gemeinsamen Gewichte; das aktualisierte Modell übernimmt sofort wieder alle drei Rollen.
1. Vorbereitungsphase: Der Arbeitsablauf als Prompt
Der Arbeitsablauf ist ein schriftlicher Plan, wie das Multi-Agent-Team zusammenarbeitet. Der Orchestrator ist dafür verantwortlich, Unteragenten Aufgaben zuzuweisen und die Ergebnisse zu integrieren. Dieser Plan wird dem Aufgaben-Prompt hinzugefügt, sodass die Organisationsweise des Teams vom Modell überprüft und angepasst werden kann, und umfasst vier Teile:
- Rolle (Role): Die jedem Unteragenten zugewiesene Verantwortung, z. B. die Vorbereitung von Daten.
- Anweisung (Instruction): Die Arbeit, die der Unteragent ausführen soll.
- Vertrag (Contract): Die Informationen und Ergebnisse, die er zurückgeben muss, einschließlich aller erforderlichen Prüfungen.
- Aufrufreihenfolge (Hop): Die Reihenfolge, in der Unteragenten aufgerufen werden, einschließlich der Rückkehr zu vorherigen Schritten.
Wenn historische Entscheidungen Informationen aus der Zukunft nutzen, kann ein Backtest überzeugend erscheinen. Dieser Vertrag verlangt von dem Datenspezialisten, solche Fehler zu prüfen und zu melden, ob die Zeitaufteilung gültig ist. Er teilt auch nachfolgenden Agenten mit, welche Beweise sie erhalten müssen, bevor sie fortfahren. So wird ein Teil des Forschungsplans als „was Agenten feststellen müssen und was sie einander übermitteln müssen“ ausgedrückt.
2. Innerer Zyklus: Suche nach besseren Arbeitsabläufen
Für jede Trainingsaufgabe behält MASS einen „Champion“ bei: Nach dem Urteil des aktuellen Modells der beste Arbeitsablauf, der bisher gefunden wurde. Jede Iteration umfasst drei Schritte:
- Ausführen (Execute): Das Team führt den Vorgang gemäß dem Kandidaten-Arbeitsablauf aus und erzeugt einen Arbeitsbereich.
- Bewerten (Evaluate): Der Bewerter vergleicht diesen Arbeitsbereich mit dem des Champions und erläutert, welcher besser ist. Der gewinnende Kandidat wird der neue Champion.
- Überarbeiten (Revise): Der Optimierer nutzt den Verlauf der Rückmeldungen, um den nächsten Arbeitsablauf vorzuschlagen.
Der Bewerter beurteilt die abgeschlossene Arbeit; der Optimierer nutzt dieses Urteil, um den Prozess zu überarbeiten, der diese Arbeit erzeugt hat. Der System-Prompt des Optimierers betont Vertrag und Aufrufreihenfolge (Hop) und lenkt die Arbeitsablaufsuche darauf, welche Informationen zwischen Agenten ausgetauscht werden und wann sie diese erhalten.
3. Äußerer Zyklus: Lernen vom ausgewählten Team
Selbst mit optimierten Arbeitsabläufen kann die Qualität langfristiger Forschungsarbeiten zwischen den einzelnen Läufen schwanken. Daher führt MASS den selbstbewerteten optimalen Arbeitsablauf (also den Champion-Arbeitsablauf, den bisher besten gefundenen Arbeitsablauf) mit mehreren zufälligen Seeds aus, sortiert die erzeugten Arbeitsbereiche mit dem aktuellen Modell und behält die Spuren mit der höchsten Rangfolge bei. Jede Spur (Trajectory) zeichnet die Nachrichten, Werkzeugaufrufe und Werkzeugergebnisse des Orchestrators und seiner Unteragenten auf.
- Führen Sie den Champion-Arbeitsablauf für jede Aufgabe 18 Mal aus.
- Vergleichen und sortieren Sie die erzeugten Arbeitsbereiche mit dem aktuellen Modell.
- Behalten Sie maximal 16 Spuren pro Aufgabe bei: 15 für das Training und 1 für die Validierung.
- Beim Erstellen von Trainingsbeispielen wird der Arbeitsablauftext aus dem anfänglichen Prompt des Orchestrators entfernt.
- Passen Sie das gemeinsame Modell mit LoRA auf den Dialogen zwischen Orchestrator und Unteragenten fein an. Die Ausgabe des Modells ist das Trainingsziel; Aufgaben-Prompts und Werkzeugergebnisse liefern den Kontext.
Das Entfernen des Arbeitsablaufs aus dem Trainings-Prompt des Orchestrators kann das Modell dazu anregen, zu lernen, Arbeiten ausgehend von der Aufgabe selbst zu organisieren.
II. Experimentelle Ergebnisse
Das Forschungsteam nutzte Qwen3.6-27B als Basismodell und führte zwei Runden MASS in der Programmier-Agenten-Umgebung von qwen-code durch. Das Experiment verwendete 12 synthetische Forschungsaufgaben aus den Bereichen Finanzen, Robotik und Pharmazeutik, wobei jede Aufgabe die Lieferung von Code, quantitativen Ergebnissen und Forschungsberichten verlangte. 9 davon wurden für das Training und 3 für den Test zurückgehalten. GPT-5.5 und Claude Opus 4.8 fungierten als externe Richter, deren Urteile an keinem Glied des MASS-Prozesses teilnahmen.
Auf den zurückgehaltenen Testaufgaben stieg die Gewinnrate des Modells gegenüber dem Basismodell von 53,9 % in der ersten Runde auf 69,9 % in der zweiten Runde, und die Gewinnrate der zweiten Runde gegenüber der ersten Runde betrug 60,8 %.
Auf 6 öffentlichen Benchmarks erreichte der Punktwert pro ausgegebenem Token des Modells nach zwei Trainingsrunden im Vergleich zum Basismodell das 1,60-fache von MLR-Bench, das 1,35-fache von DSBench, das 1,28-fache von AstaBench E2E-Hard und das 1,20-fache von ScienceAgentBench. Im Vergleich dazu lagen Terminal-Bench 2.0 und SWE-bench Verified bei 0,96-fachem bzw. 0,94-fachem, was zeigt, dass die Verbesserungen zwischen verschiedenen Aufgaben nicht gleichmäßig verteilt sind. Das Forschungsteam vermutet, dass das Hinzufügen von Softwareentwicklungsaufgaben zu den Trainingsdaten die Leistung bei diesen beiden Benchmarks verbessern könnte.
Bemerkenswert ist, dass die Trainingsdaten nur Aufgabenlösungsspuren enthalten, aber die Fähigkeiten der beiden Rollen Arbeitsablaufoptimierung und Selbstbewertung gleichzeitig verbessert wurden:
- Selbstbewertung: Die Übereinstimmungsrate zwischen Bewerter und externen Richtern stieg von 0,73 auf 0,91 und weiter auf 0,93.
- Arbeitsablaufoptimierung: Die Arbeitsabläufe, die das Modell der ersten Runde erzeugt, waren selbst dann, wenn sie vom Basismodell ausgeführt wurden, in 64 % der Vergleiche besser als die Arbeitsabläufe, die das Basismodell selbst erzeugt hat.
- Suchgeschwindigkeit: Das trainierte Modell kann effektive Arbeitsabläufe früher finden.
Die Trainingseffizienz von Multi-Agent-Spuren ist ebenfalls höher. M+ (das MASS-Modell der ersten Runde) verarbeitete 28,8 Millionen Überwachungs-Tokens und erzielte eine Gewinnrate von 68,3 % gegenüber dem Basismodell; S++, das mit Single-Agent-Spuren trainiert wurde, verarbeitete 42 Millionen Überwachungs-Tokens und erzielte eine Gewinnrate von 64,0 %. Ersteres nutzte 31 % weniger Überwachungs-Tokens und erreichte dennoch eine höhere Gewinnrate. Diese Token-Zahl enthält nicht den Aufwand für Datengenerierung, Arbeitsablaufsuche und Bewertung.
In einem Vergleichsexperiment zwischen Optimierer und Bewerter, bei dem der Ausführende fest als Basismodell festgelegt war und Bewerter sowie Optimierer gleichzeitig durch GPT-5.5 ersetzt wurden, wurden für alle 12 Aufgaben innerhalb von 5 Iterationen Arbeitsabläufe gefunden, die besser waren als der Arbeitsablauf des Basismodells ohne Arbeitsablauf. Wenn nur der Bewerter ersetzt wurde, war der Nutzen deutlich geringer. Der homogene geschlossene Kreislauf, der vollständig vom Basismodell übernommen wurde, war langsamer, deckte aber bis zur 13. Iteration auch 11 Aufgaben ab. Das Forschungsteam ist der Ansicht, dass bei begrenztem Budget der Optimierer vorrangig aufgerüstet werden sollte.
Diese Ergebnisse zeigen, dass MASS eine effektive Selbstüberwachung für RSI liefern kann. Das Forschungsteam gibt an, dass die Beschleunigung der Leistungssteigerung in jedem Zyklus nach wie vor eine wichtige Richtung für zukünftige Arbeiten ist.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Academic Headline“ (ID: SciTouTiao), Autor: Academic Headline, veröffentlicht mit Genehmigung von 36Kr.