Gerade jetzt hat Metas stärkstes Flaggschiff GPT-6 und Opus übertrumpft! Über Nacht ist es zurück in die weltweiten Top 3 gerückt.
Diesmal hat Mark Zuckerberg wirklich aufgeholt!
Spät in der Nacht hat Meta auf einen Schlag zwei große Modelle, Muse Wonder und Muse Wonder Full, veröffentlicht.
Das Unternehmen bezeichnet es unverblümt als das leistungsstärkste Modell, das Meta bisher hervorgebracht hat, und zugleich als historischen Durchbruch auf dem Weg zur „persönlichen Superintelligenz“.
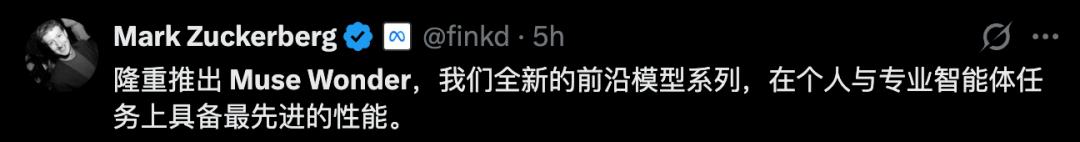
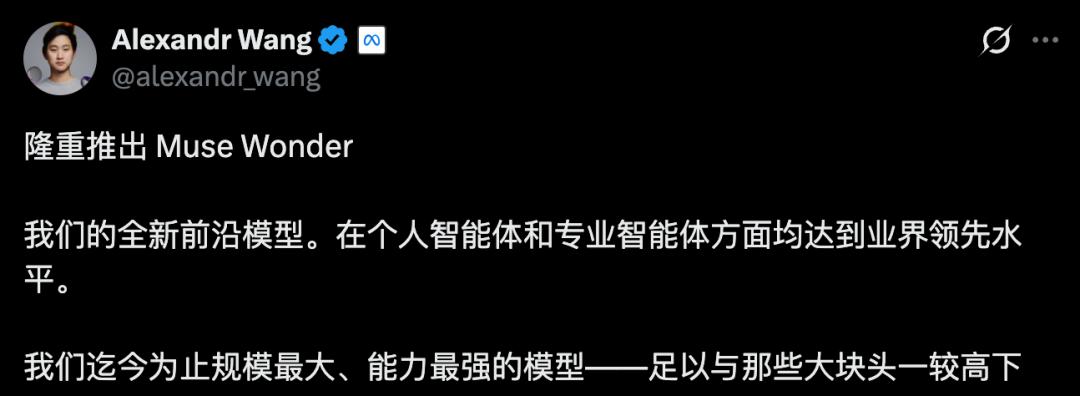
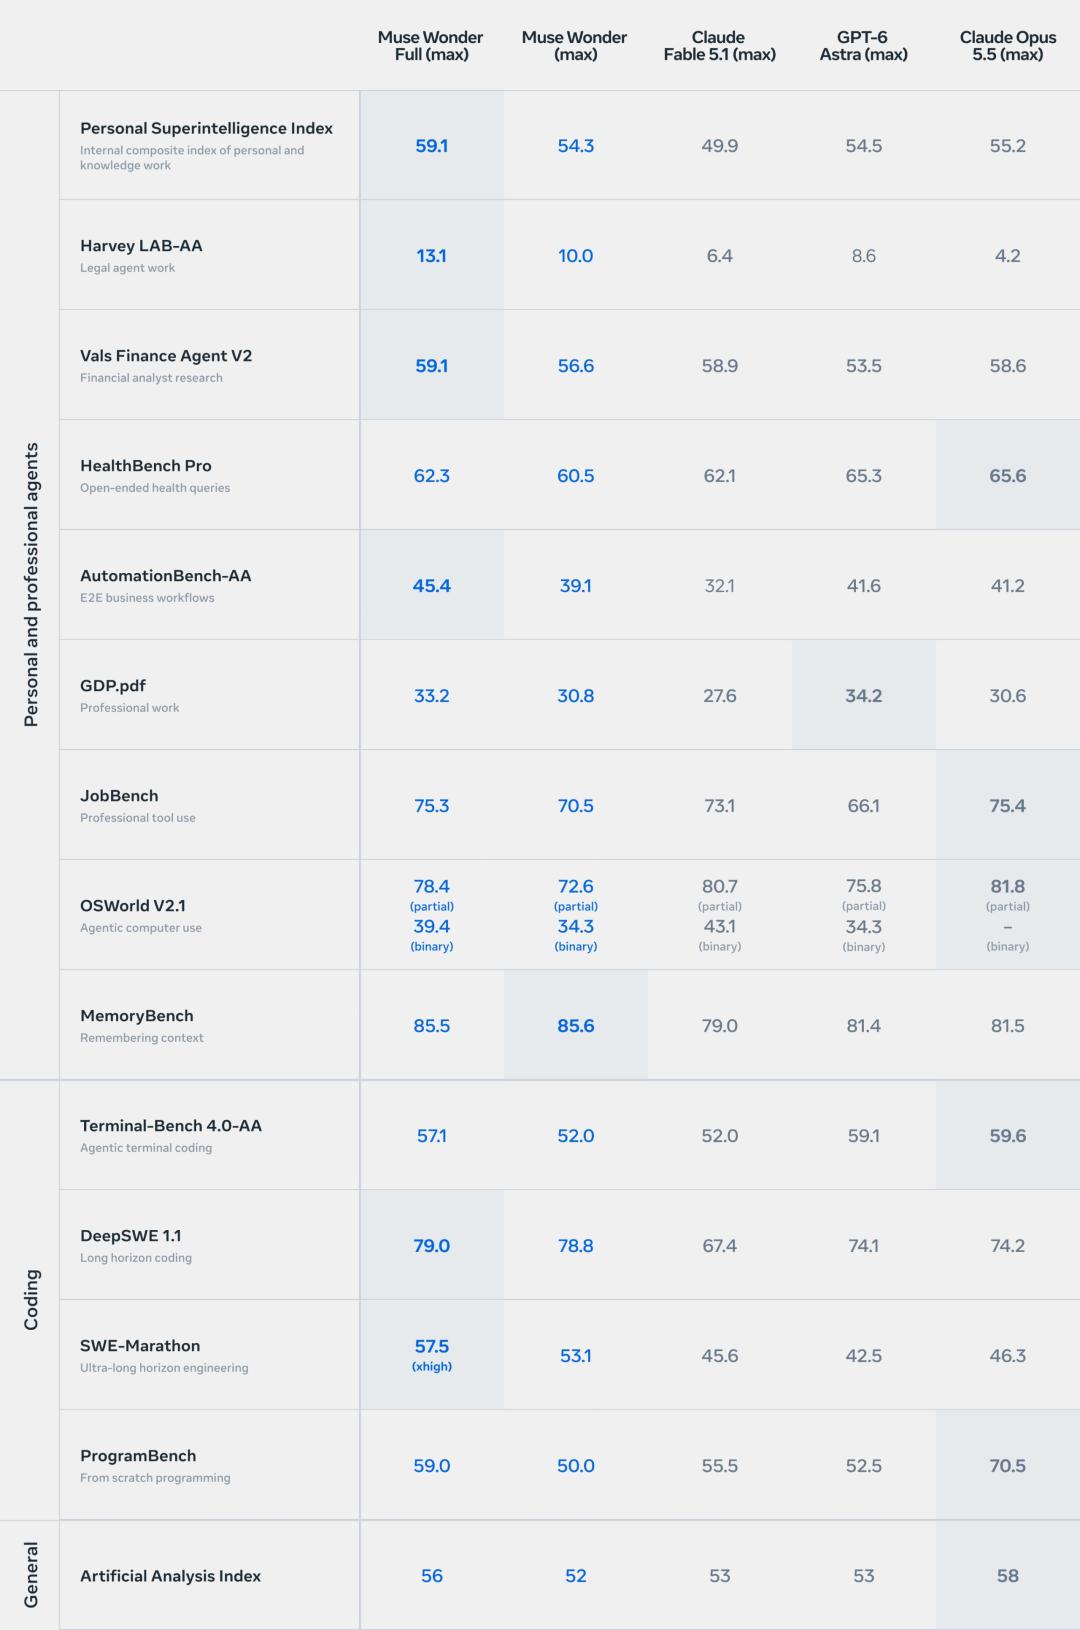
In allen Benchmark-Tests können die beiden neuen Modelle von Meta nun endlich direkt mit Claude und GPT konkurrieren.
Die derzeit stärksten Modelle Claude Fable 5.1 und GPT-6 Astra werden von Muse Wonder fast direkt übertroffen.
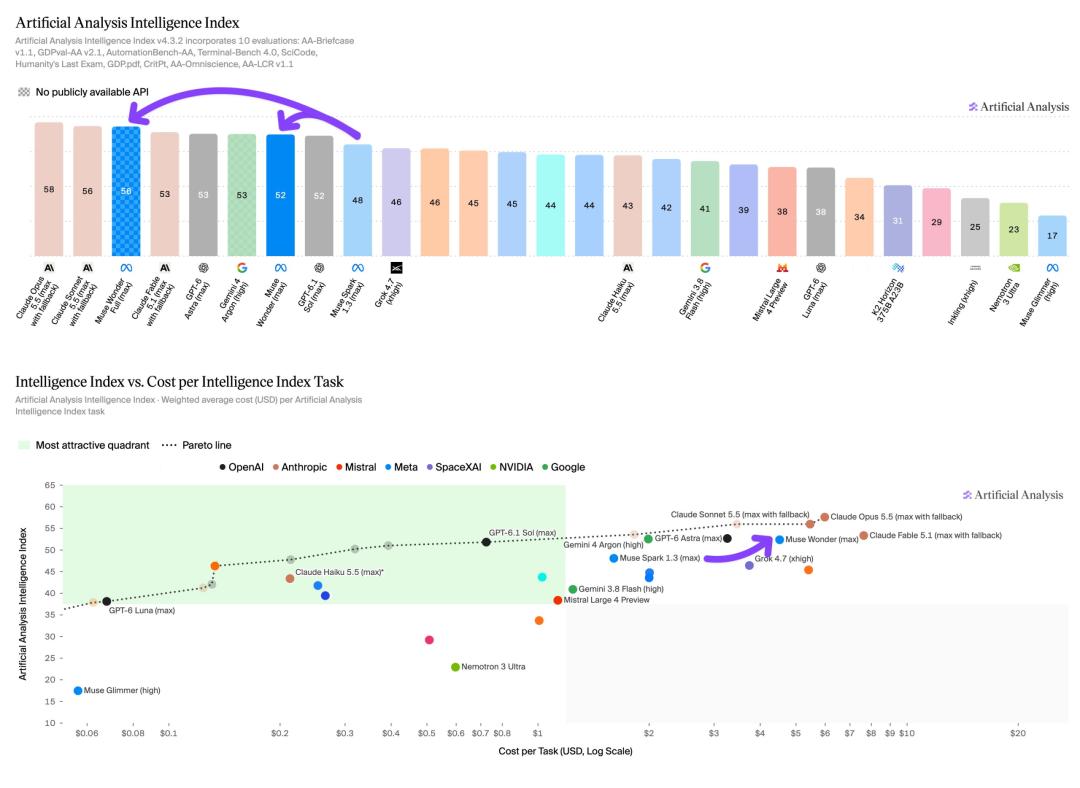
Auf Artificial Analysis erreicht Muse Wonder Full 56 Punkte, gehört fest zur globalen Spitzengruppe, liegt auf Augenhöhe mit Sonnet 5.5 und übertrifft GPT-6 Astra.
Muse Wonder erreicht ebenfalls 52 Punkte und übertrifft die Vorgängergeneration Muse Spark 1.3 in allen Bereichen.
Bei der Programmierung für lang andauernde Aufgaben übertrifft Meta sogar direkt Opus und Astra. Nicht nur die Top-Version Full gewinnt, auch die Standard-Version Wonder gewinnt!
Es verfügt über zwei stärkste Trümpfe: Active Memory (Aktives Gedächtnis) + Active Focus (Aktive Fokussierung).
Plötzlich staunen viele Menschen, dass anscheinend alle großen Labore das RSI-Problem gemeistert haben.
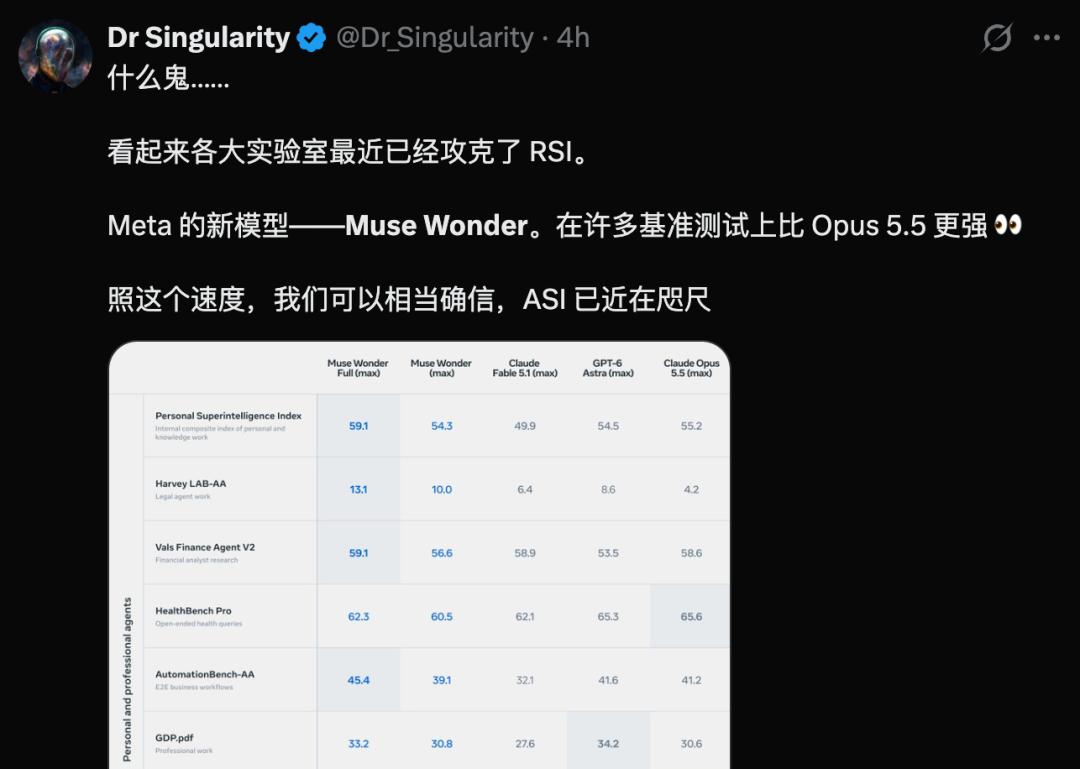
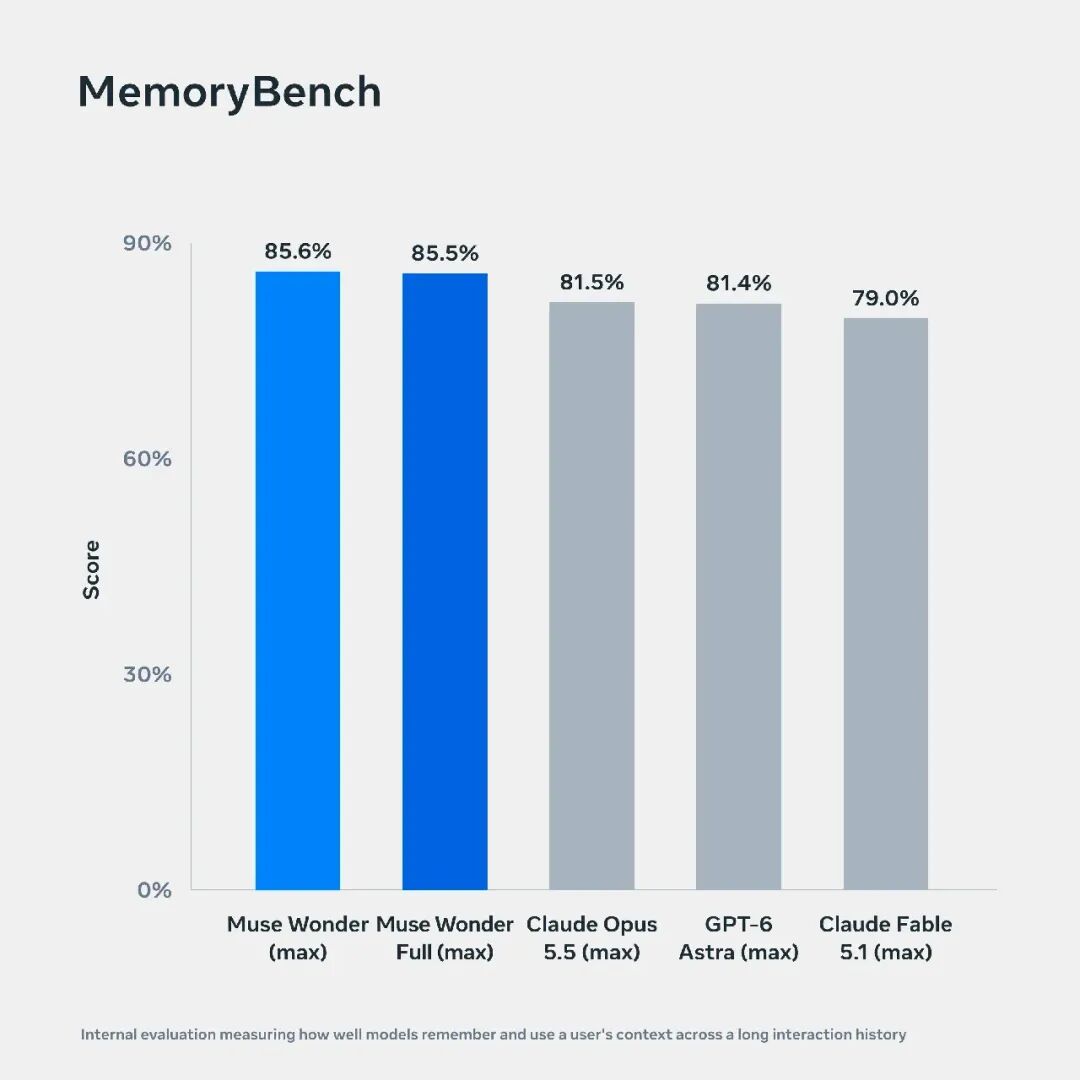
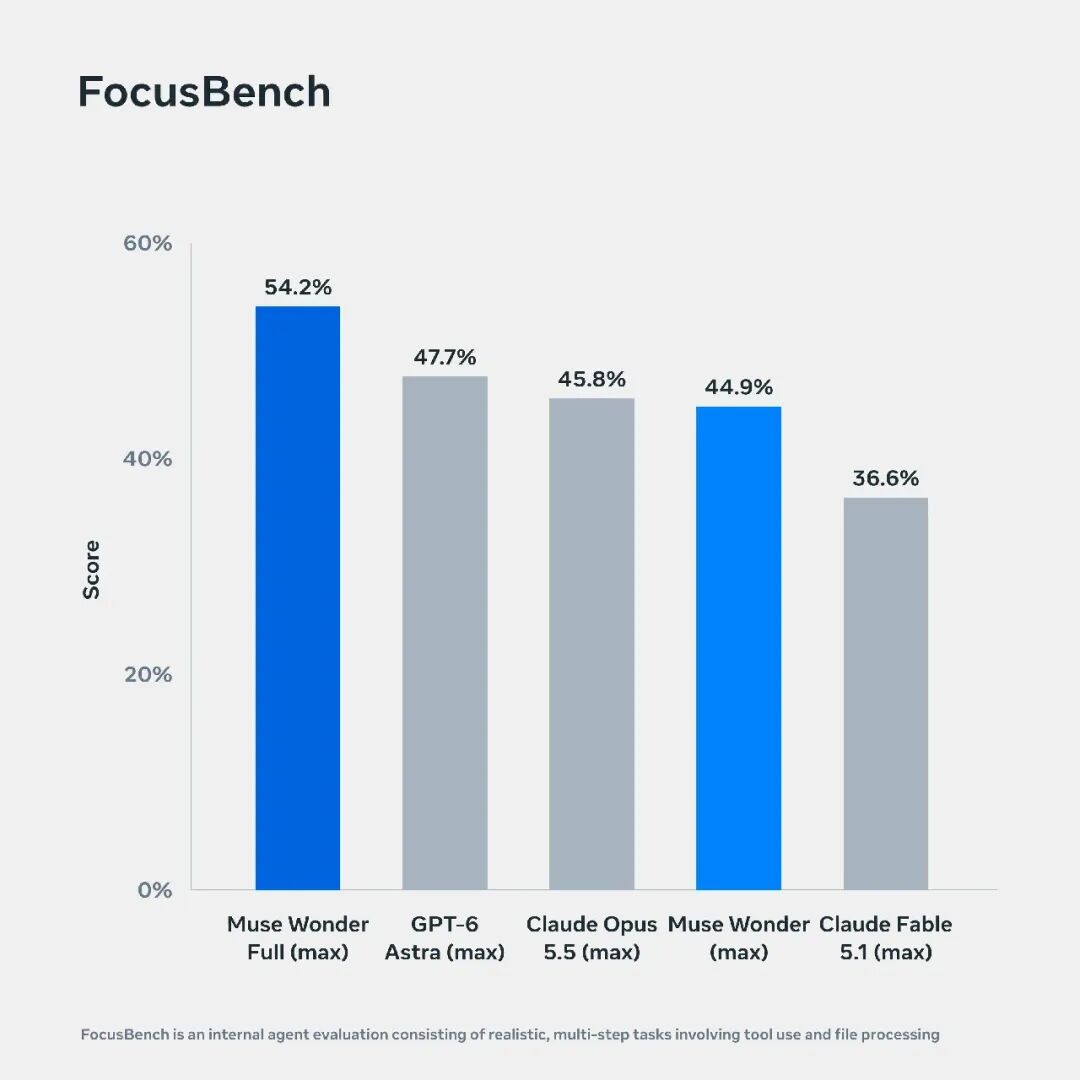
Dieses Upgrade verbessert alle Fähigkeiten, die wichtigsten Punkte im Überblick —
Eintritt in die Spitzengruppe bei Programmierung: Mit Muse Code und Full erreicht das Modell auf der AA-Programmier-Agent-Liste das Niveau von Claude Sonnet; beide Wonder-Modelle übertreffen Opus und Astra in den Tests für lang andauernde Aufgaben.
Merken Sie sich Ihre Informationen über mehrere Dialoge hinweg, und setzen Sie lang andauernde Aufgaben nahtlos fort: Active Memory speichert Ihre wichtigen Informationen; Active Focus lässt das Modell nach Hindernissen nach anderen Lösungen suchen, nach Fehlern eine Überprüfung durchführen und Pläne an neue Anforderungen anpassen.
Auch bei professionellen Arbeiten aufgeholt: 14 Tests decken Fähigkeiten in Recht, Finanzen, Gedächtnis und fortlaufender Ausführung ab. Full übertrifft Opus 5.5 in 8 Punkten und GPT-6 Astra in 11 Punkten.
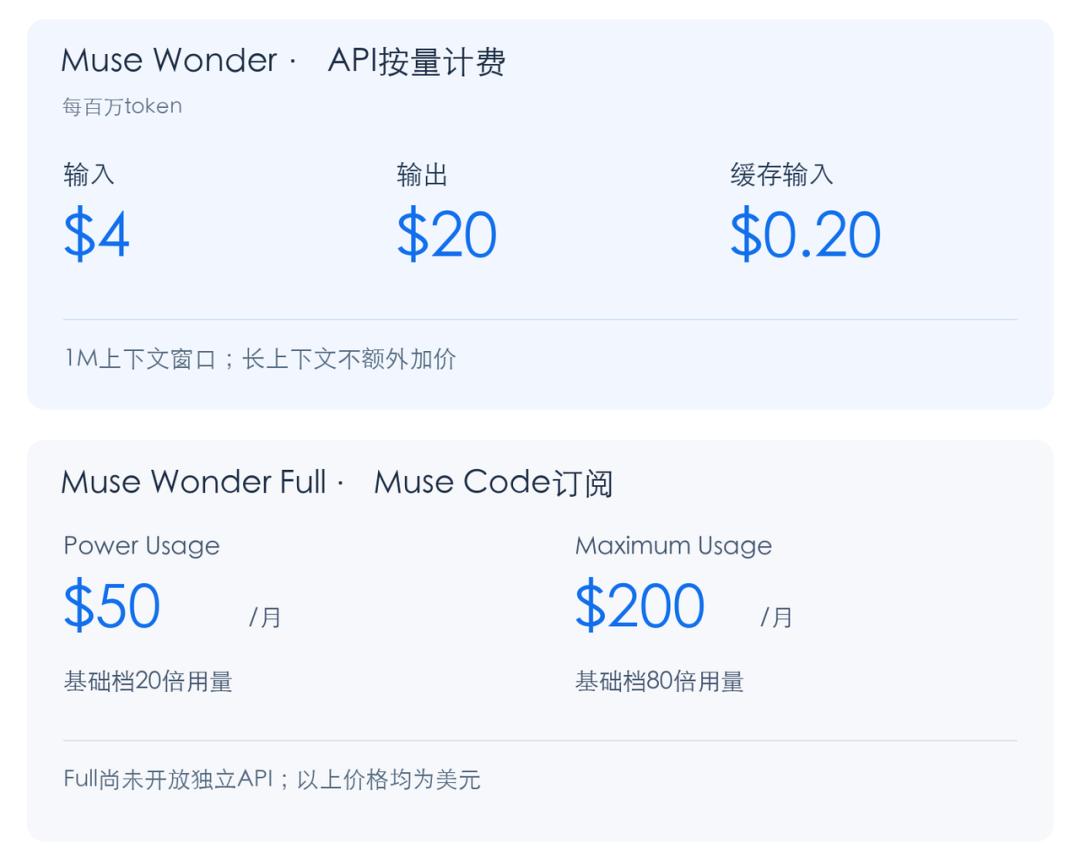
Preis: Die Standard-API kostet 4 US-Dollar pro Million Token für die Eingabe und 20 US-Dollar für die Ausgabe; Full ist über das Muse Code-Abonnement verfügbar und kostet 50 oder 200 US-Dollar pro Monat.
In sechs Wochen um 8 Punkte gestiegen, alle zehn Tests schlagen die Vorgängergeneration!
Laut Statistiken von Artificial Analysis liegen zwischen der Veröffentlichung von Muse Spark 1.3 und den neuen Modellen nur sechs Wochen.
Der Intelligenzindex ist von 48 auf 56 Punkte gestiegen, ein ganzer Anstieg von 8 Punkten!
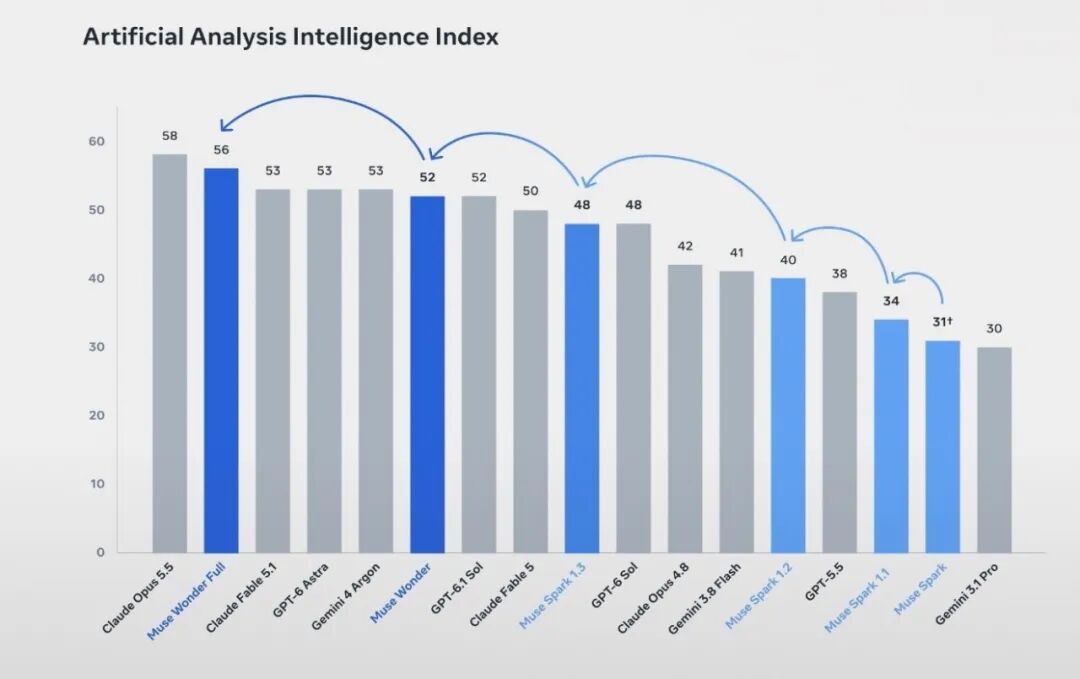
Alle zehn Tests übertreffen Spark 1.3; sechs davon erreichen die Top 3, zwei belegen den ersten Platz!
Bei den wissenschaftlichen Schlussfolgerungstests CritPt und dem professionellen Dokumententest GDP.pdf erreicht Full jeweils 33 % und belegt den ersten Platz in der entsprechenden AA-Liste! Beim Test für berufliches Wissen GDPval-AA v2.1 erreicht Full 1857 Elo und belegt den zweiten Platz.
Drei weitere Punkte belegen den dritten Platz, nämlich der Wissensarbeitstest AA-Briefcase, der Automatisierungstest für Geschäftsprozesse AutomationBench-AA und der wissenschaftliche Programmiertest SciCode.
Bei Terminal-Bench 4.0 muss die KI selbst Dateien lesen, Befehle eingeben und Fehler bearbeiten. Spark konnte nur 33 % der Aufgaben erledigen, Full erreicht bereits 57 % – ein Anstieg von 24 Prozentpunkten auf einmal!
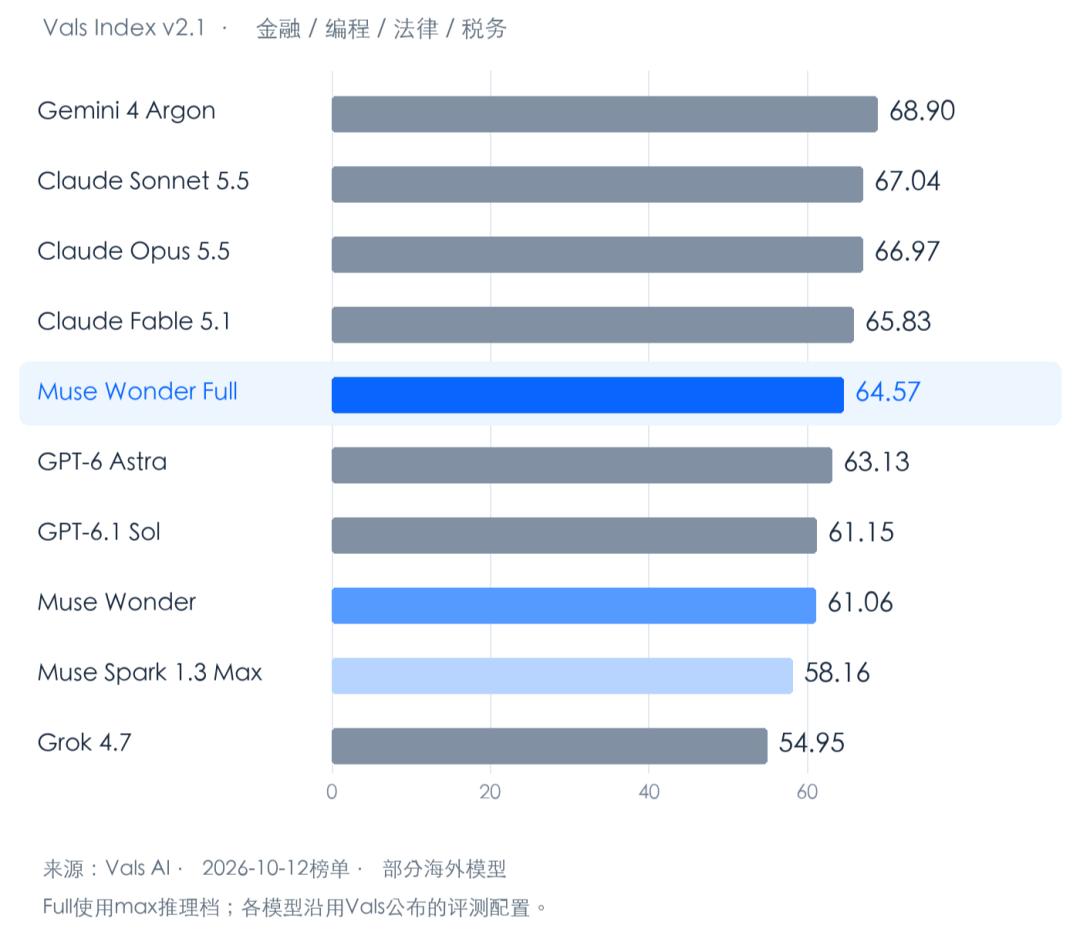
Ein weiteres Bewertungsinstitut Vals hat ebenfalls neue Ergebnisse veröffentlicht.
In der Gesamtrangliste des Vals Index, die Arbeiten in Finanzen, Programmierung, Recht und Steuern abdeckt, erreicht Wonder Full mit 64,57 Punkten den fünften Platz und übertrifft alle OpenAI-Modelle auf der Liste!
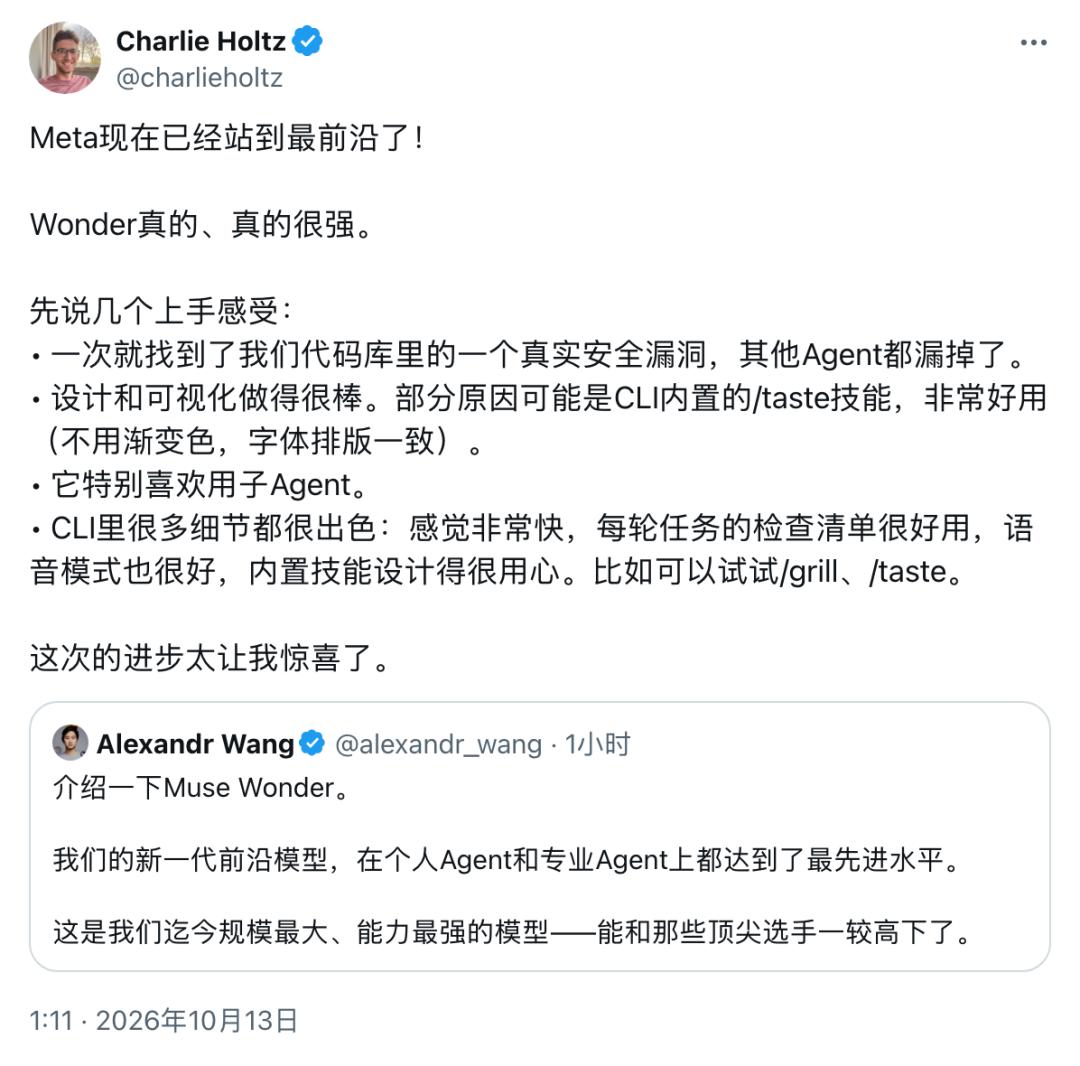
Neben Benchmark-Ergebnissen hat der Conductor-Entwickler Charlie Holtz Wonder bereits in seinem eigenen Code-Repository eingesetzt.
Überraschenderweise fand Muse auf Anhieb eine echte Sicherheitslücke, die alle anderen Agenten zuvor übersehen hatten.
Darüber hinaus lobte er sein Design und die Visualisierungseffekte, die Geschwindigkeit der CLI und den Sprachmodus und erklärte offen: „Meta steht jetzt an der Spitze der Entwicklung“!
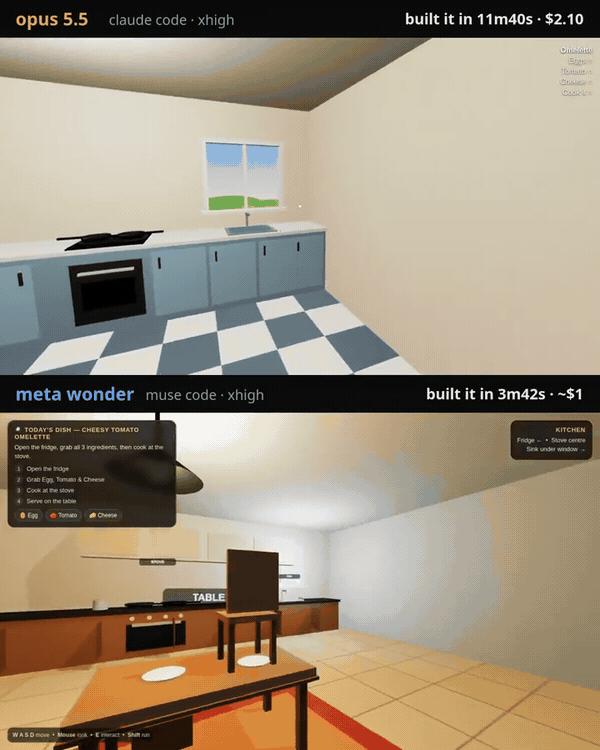
In einem weiteren Test führte der Entwickler Yair einen Vergleich zum gleichen Thema durch, bei dem Wonder und Opus 5.5 gleichzeitig ein Ego-3D-Spiel entwickeln sollten.
Claude Code mit Opus 5.5 brauchte 11 Minuten und 40 Sekunden, während Muse Code mit der Standard-Version Wonder nur 3 Minuten und 42 Sekunden benötigte – weniger als vier Minuten!
Übertrifft Opus bei lang andauernden Aufgaben, übertrifft Astra umfassend bei Programmierung
Auf dem Benchmark SWE-Marathon zur Bewertung lang andauernder Aufgaben erreicht Full 57,5 %, Opus 5,5 46,3 % und Astra 42,5 %.
Die Vorsprünge betragen jeweils 11,2 und 15 Prozentpunkte!
Sogar ohne die Full-Version erreicht die Standard-Version Wonder 53,1 % und übertrifft damit ebenfalls diese beiden Flaggschiff-Modelle.
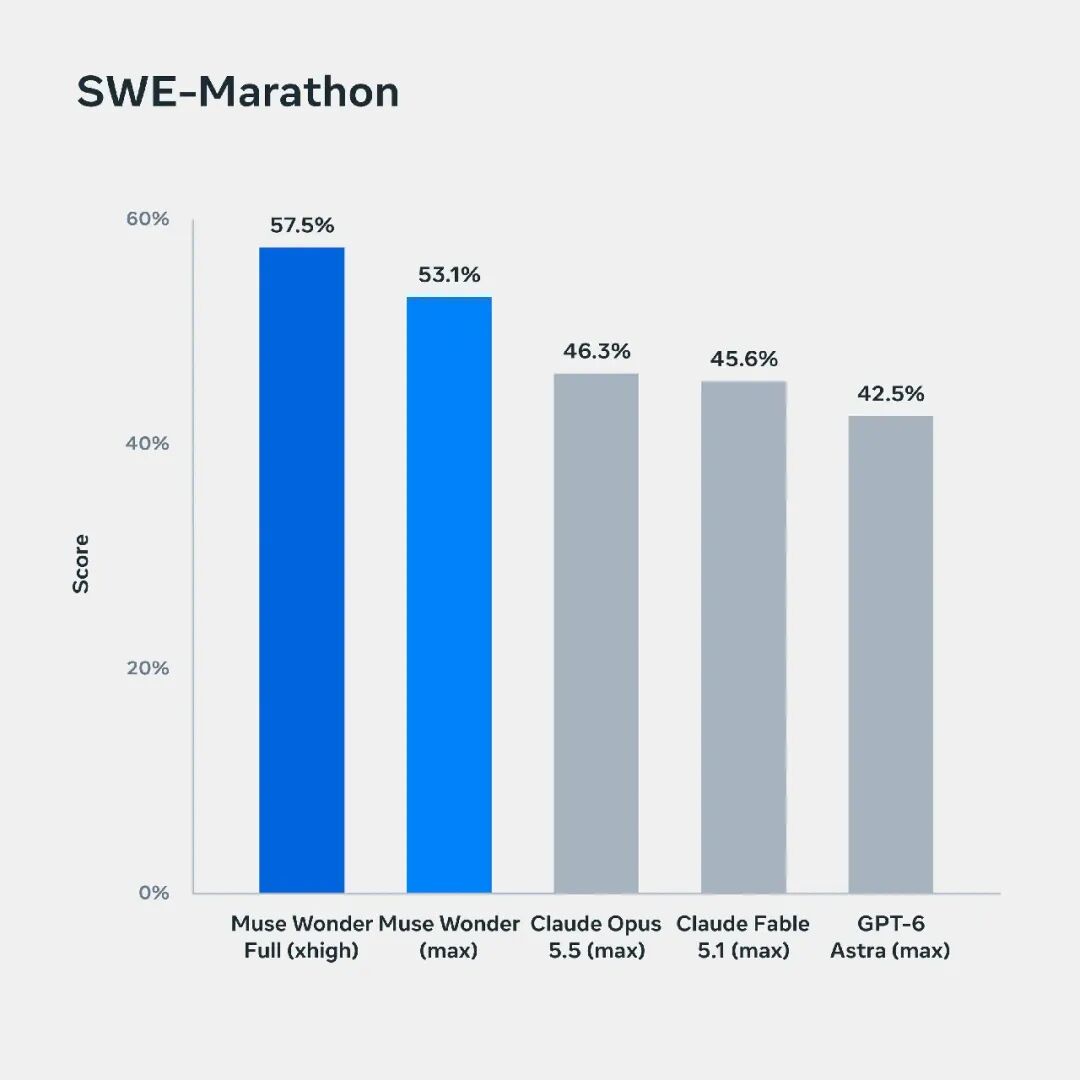
SWE-Marathon verlangt von der KI, Software-Projekte fortlaufend abzuschließen: Anforderungen lesen, mehrere Dateien ändern, Tests ausführen und nach Fehlern selbst die Ursache finden und weiter korrigieren.
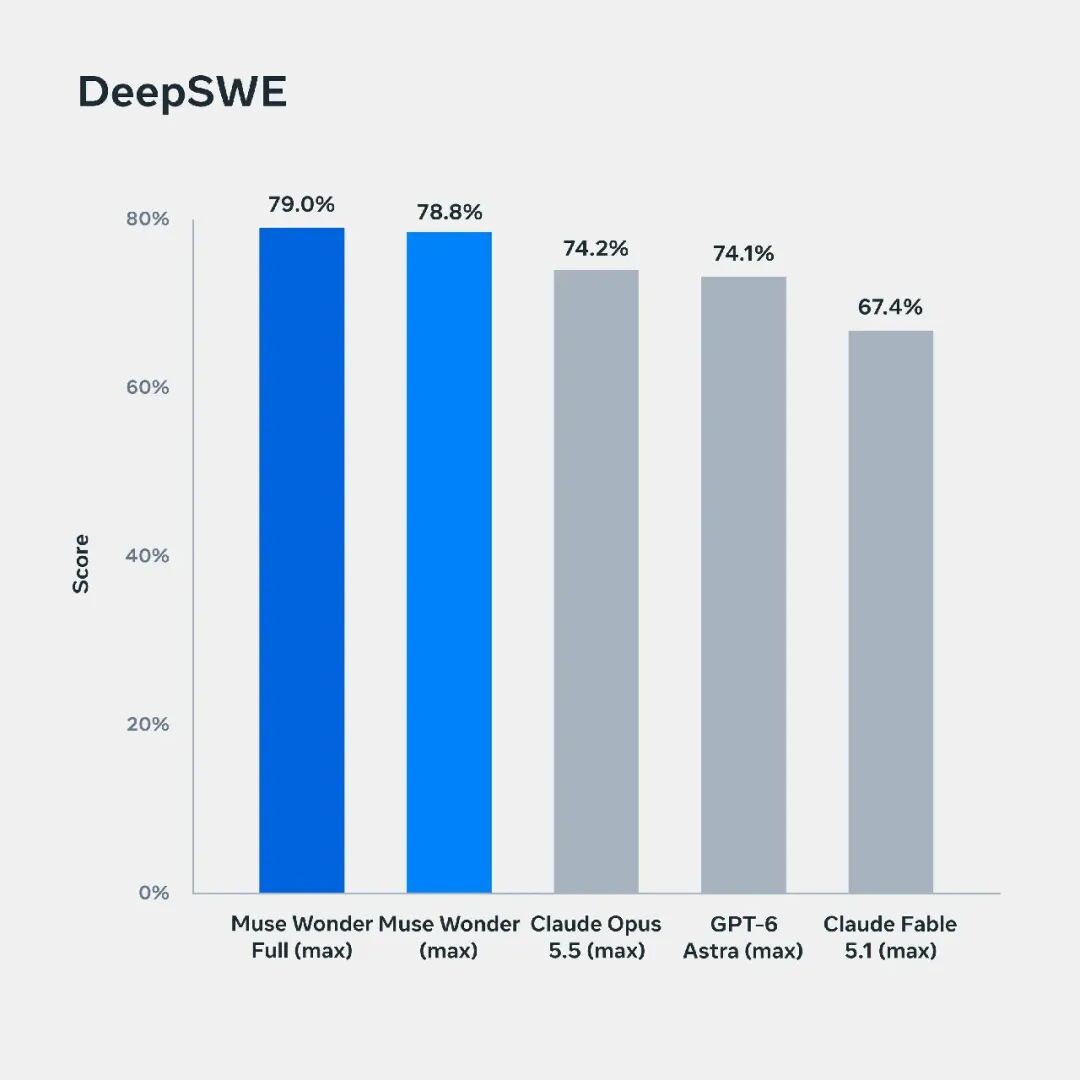
DeepSWE v1.1 umfasst 113 Aufgaben, die 91 Code-Repositories und fünf Programmiersprachen abdecken.
In den von Meta zusammengefassten Ergebnissen erreicht Full 79,0 %, Wonder 78,8 %, Opus und Astra erreichen jeweils 74,2 % und 74,1 %.
Betrachtet man dann die AA-Programmier-Agent-Liste (Coding Agents Index), erreicht Muse Code mit Full 68 Punkte, erreicht das gleiche Niveau wie Claude Code mit Sonnet und übertrifft den Wert von 66 Punkten mit Opus.
Die Vorgängergeneration Muse Code mit Spark 1.3 erreichte nur 54 Punkte. Mit Full steigt der Wert direkt um 14 Punkte! Auch mit der Standard-Version Wonder werden 63 Punkte erreicht.
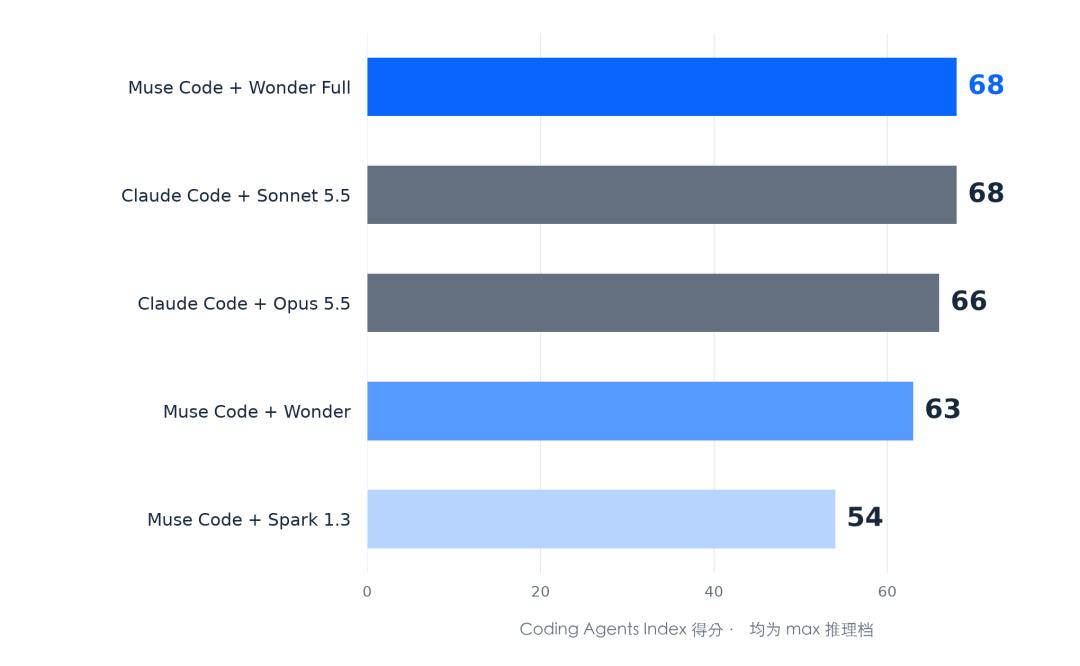
Teilergebnisse des Artificial Analysis Programmier-Agent-Tests für Muse Code und Claude Code
Bei ProgramBench für Anfänger ohne Programmiererfahrung erreicht Full 59,0 Punkte, höher als Astra mit 52,5 Punkten, während Opus 70,5 Punkte erzielt.
Bei den Terminal-Programmierergebnissen erreicht Full 57,1 Punkte, Astra und Opus erreichen 59,1 bzw. 59,6 Punkte.
Darüber hinaus liegen die Ergebnisse eines größeren Schwachstellentests vor.
Die Betreuer von VulnPR-100 haben Wonder 1.0 100 Code-Änderungen mit bekannten Schwachstellen zugewiesen, jede mit einer Frist von einer Stunde.
Es fand 46 Schwachstellen und erzielte das gleiche Ergebnis wie GPT-6 Astra. Die gesamte Runde kostete 284,88 US-Dollar, durchschnittlich 6,19 US-Dollar pro Schwachstelle.
36 richtige Mathematikaufgaben mehr, 40 % weniger Token
In ProofBench von Vals AI löst Full 94 mathematische Beweisaufgaben, 36 mehr als die Vorgängergeneration; in der gleichen Liste erreicht Opus 100 Aufgaben und Astra 99 Aufgaben.
Mehr Aufgaben gelöst, aber die Ausgabe-Token sind von 4,5 Millionen auf 2,7 Millionen gesunken, ein Rückgang von 40 %! Bei der Anwendung liegt die Punktzahl bei etwa 86 %, die durch