Muse Wonder versetzt Astra einen Ellenbogenstoß, Meta kehrt zurück an die Spitze der Modellentwicklung
Nach mehr als einem Jahr hat Meta endlich wieder ein großes Sprachmodell vorgelegt, das direkt mit OpenAI und Anthropic konkurrieren kann.
Am 12. Oktober kündigte Mark Zuckerberg an, dass das Meta Super Intelligence Lab (MSL) offiziell die Modelle Muse Wonder und Muse Wonder Full veröffentlicht. Dies ist das erste Flaggschiffmodell mit eigenangabenem Spitzenniveau, das MSL seit seiner Gründung vor mehr als einem Jahr auf den Markt gebracht hat.
Zuvor sahen wir, wie OpenAI und Anthropic nacheinander die Modellranglisten aktualisierten, während Meta kein neues Flaggschiffmodell vorlegte. Wir glaubten eine Zeit lang, dass Zuckerberg den Wettbewerb um SOTA-Leistungen aufgegeben hatte.
Jetzt zeigt sich, dass Meta auf einen großen Wurf hingearbeitet hat.
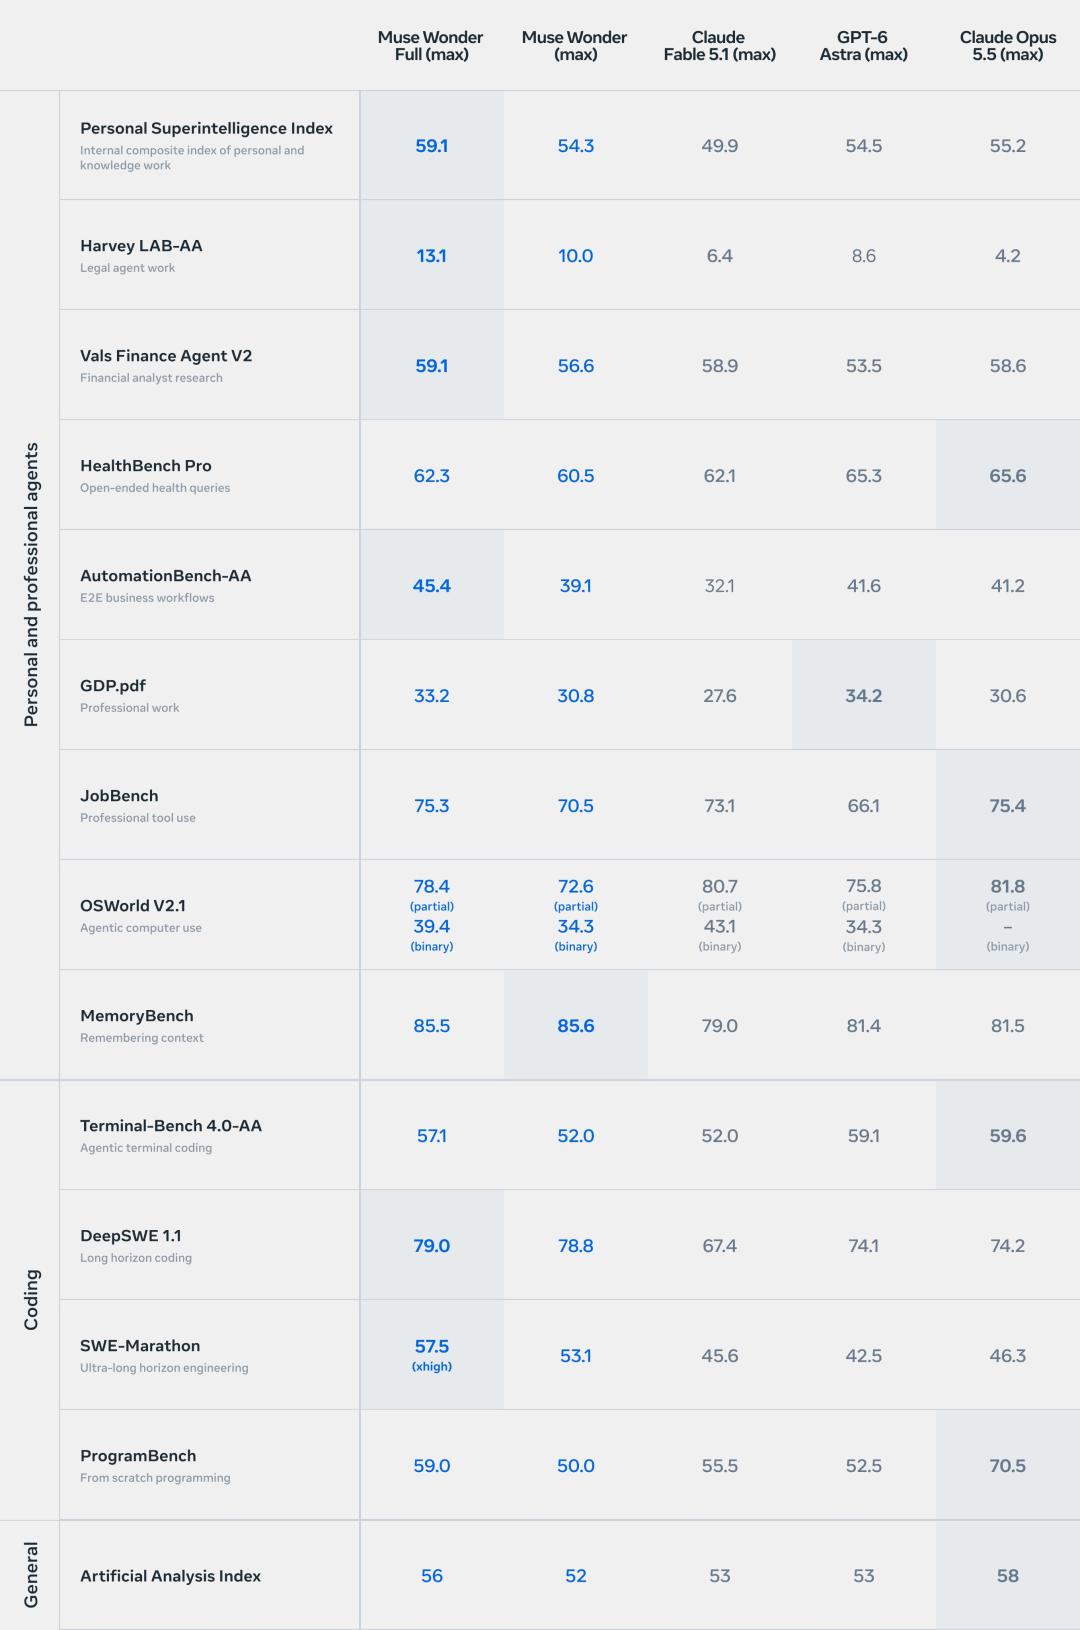
In Tests wie Programmierung, lang andauernden Agent-Aufgaben und Gedächtnisleistung hat Wonder Full bemerkenswerte Ergebnisse erzielt und einige Projekte übertreffen sogar GPT-6 Astra und Claude Opus 5.5.
Im April 2025 veröffentlichte Meta das vielversprechende Llama 4, das jedoch nicht die vorherige Dynamik fortsetzte und stattdessen in Kontroversen um Leistung und Ranglistenoptimierung geriet. Danach trat Zuckerberg persönlich in Aktion, investierte enorme Summen, um Talente anzuwerben und das KI-Forschungs- und Entwicklungsteam neu aufzubauen.
Heute hat Zuckerberg endlich diesen Leistungsbericht erhalten. Wie leistungsstark ist das neue Modell von Meta wirklich?
Meta hat endlich wieder ein Spitzenmodell
Diesmal hat Meta zwei Modelle vorgelegt: Muse Wonder und das leistungsstärkere Muse Wonder Full. Beide unterstützen ein Kontextfenster von 1 Million Token und konzentrieren sich auf Programmierung, langfristige Agent-Aufgaben und fachliche Wissensarbeit.
Laut den offiziellen Benchmarks von Meta hat Wonder Full in mehreren Projekten bereits die Fähigkeit, direkt mit den Flaggschiffmodellen von OpenAI und Anthropic zu konkurrieren.
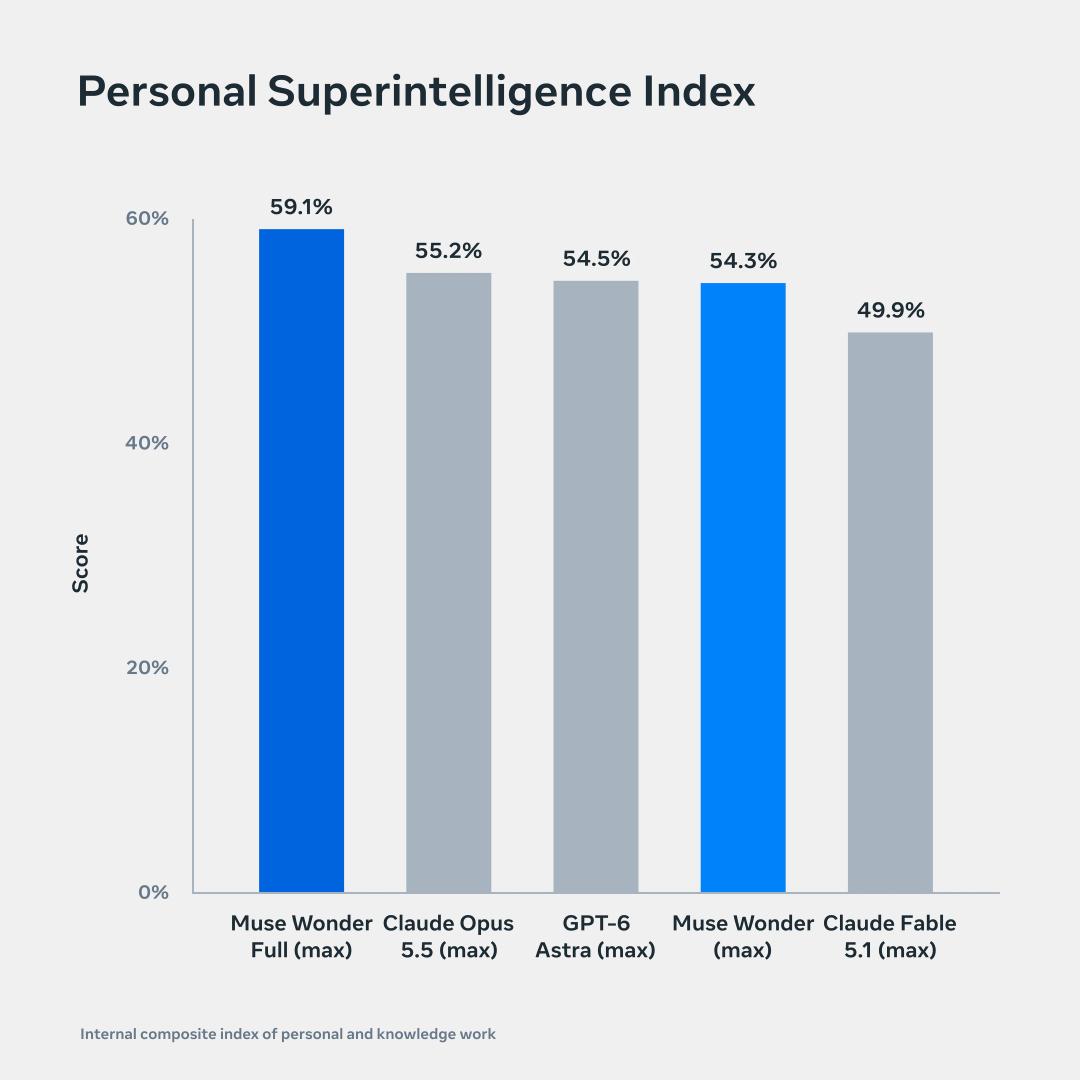
Am bemerkenswertesten ist ein Indikator namens Personal Superintelligence Index.
Dies ist ein von Meta intern entwickelter umfassender Indikator, der aus sieben Tests im Zusammenhang mit persönlichen Angelegenheiten und Wissensarbeit besteht und Szenarien wie berufliche Arbeit, automatisierte Abläufe und Weboperationen abdeckt.
In diesem Test belegt Wonder Full mit 59,1 % den ersten Platz, Claude Opus 5.5 und GPT-6 Astra erreichen 55,2 % bzw. 54,5 %. Die Standardversion von Wonder erreicht 54,3 % und übertrifft damit auch Fable 5.1.
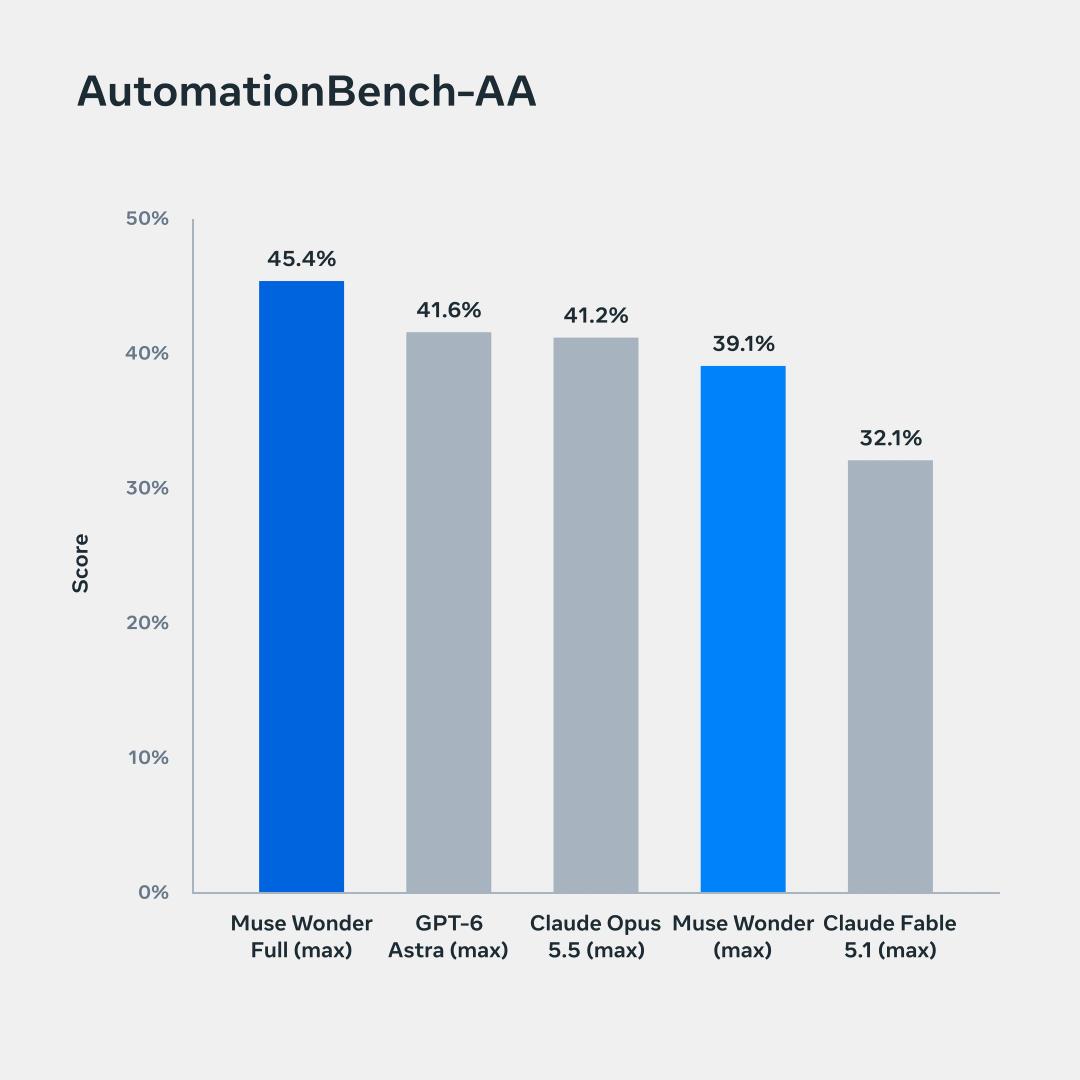
Meta hat zudem speziell die Automatisierungs- und Gedächtnisfähigkeit des Modells demonstriert.
In AutomationBench-AA, das die Fähigkeit zur End-to-End-Automatisierung von Geschäftsprozessen misst, erreicht Wonder Full 45,4 %, was über den Werten von Astra (41,6 %) und Opus 5.5 (41,2 %) liegt.
In MemoryBench, das die Gedächtnisleistung bei lang andauernden Dialogen testet, übertrifft die Standardversion von Wonder mit 85,6 % sogar leicht Wonder Full mit 85,5 %. Opus 5.5 und Astra erreichen 81,5 % bzw. 81,4 %. Dieser intern von Meta entwickelte Test prüft hauptsächlich, ob das Modell wichtige Inhalte aus langen Dialogen mit vielen Störungen und Informationsaktualisierungen korrekt abrufen kann.
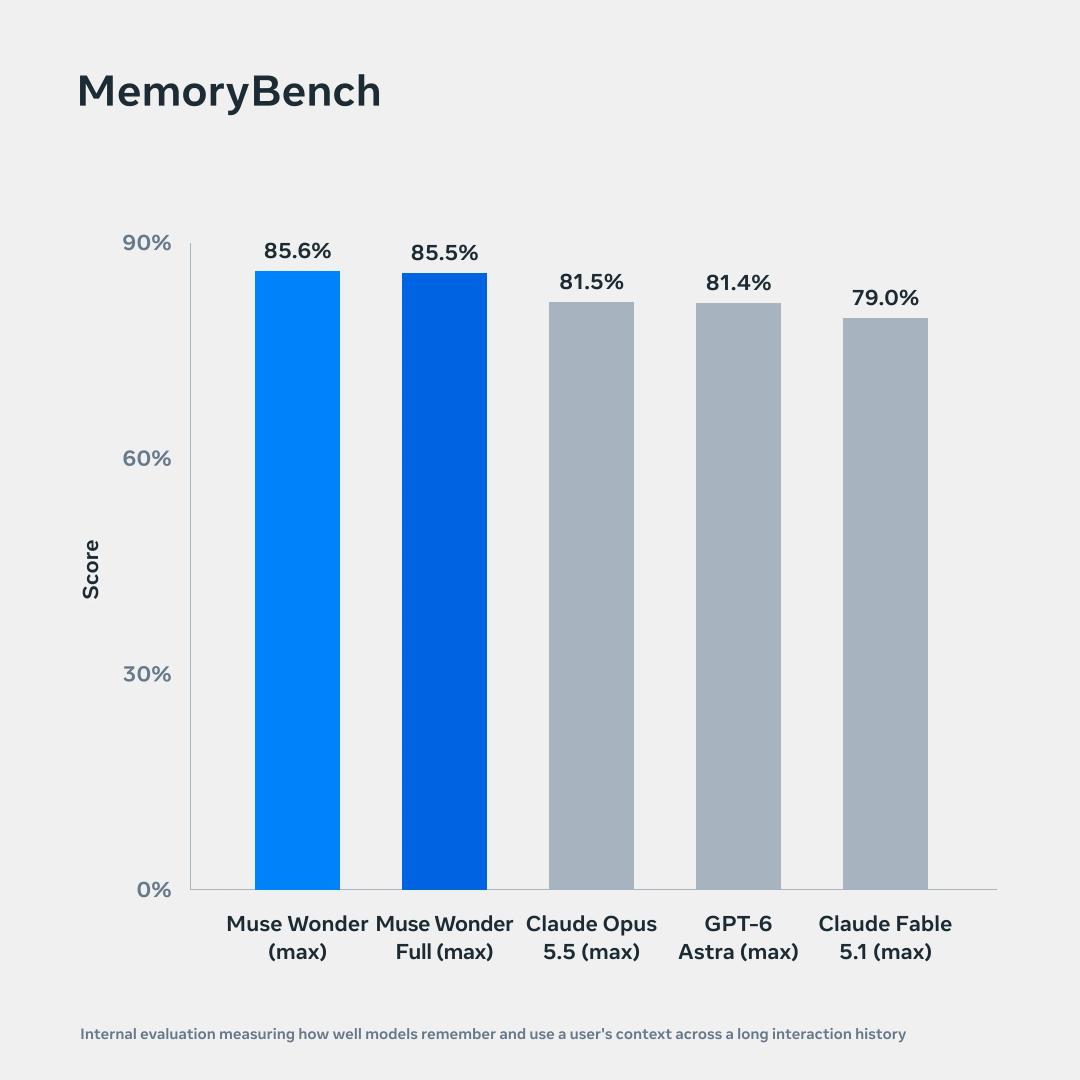
Von persönlichen und beruflichen Aufgaben über Prozessautomatisierung bis hin zur Informationsextraktion in langen Dialogen verdeutlichen diese drei Tests deutlich, dass Meta großen Wert auf die Fähigkeiten von Agenten legt.
Darüber hinaus hat Meta nicht aufgehört, mit OpenAI und Anthropic um Programmierfähigkeiten zu konkurrieren, nur weil es den Fokus auf persönliche Agenten legt.
In DeepSWE 1.1, das die langfristige Software-Engineering-Leistung testet, erreicht Wonder Full 79,0 % und übertrifft damit GPT-6 Astra (74,1 %) und Claude Opus 5.5 (74,2 %). In SWE-Marathon mit längeren Aufgabenzyklen, bei denen das Modell Softwareprojekte kontinuierlich modifizieren und warten muss, liegt die Erfolgsrate von Wonder Full bei 57,5 %, während GPT-6 Astra 42,5 % und Claude Opus 5.5 46,3 % erreichen.
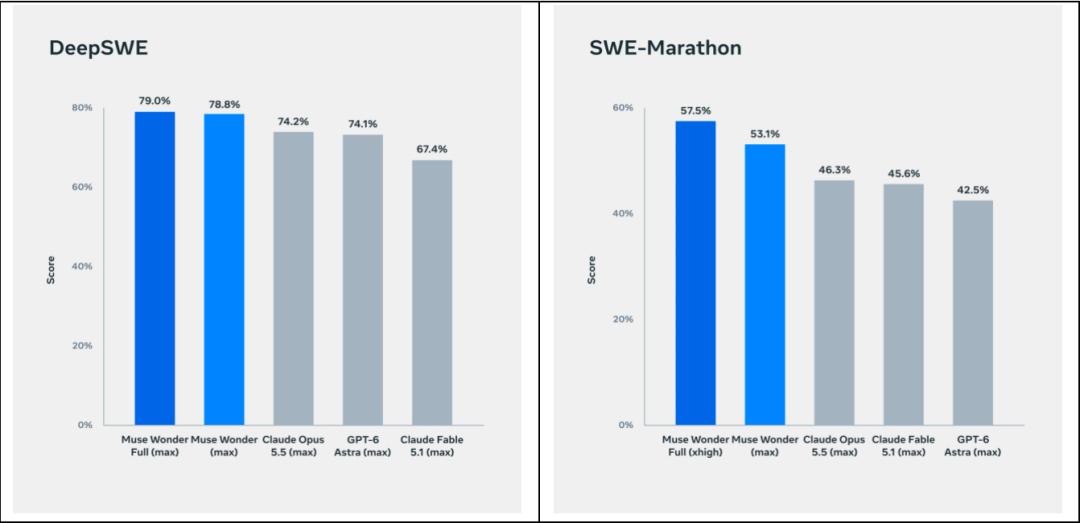
In fünf von Meta hervorgehobenen Tests liegt Wonder Full vor den Flaggschiffmodellen der beiden Konkurrenten. Sogar die Standardversion von Wonder ist in Programmierungs- und Gedächtnistests sehr wettbewerbsfähig.
Natürlich beweist dies noch nicht, dass Meta OpenAI und Anthropic umfassend übertroffen hat. Die genannten Ergebnisse enthalten von Meta intern festgelegte Bewertungsindikatoren, und die Laufkonfigurationen für verschiedene Tests unterscheiden sich, sodass sie nicht einfach mit der tatsächlichen Nutzungserfahrung gleichgesetzt werden können.
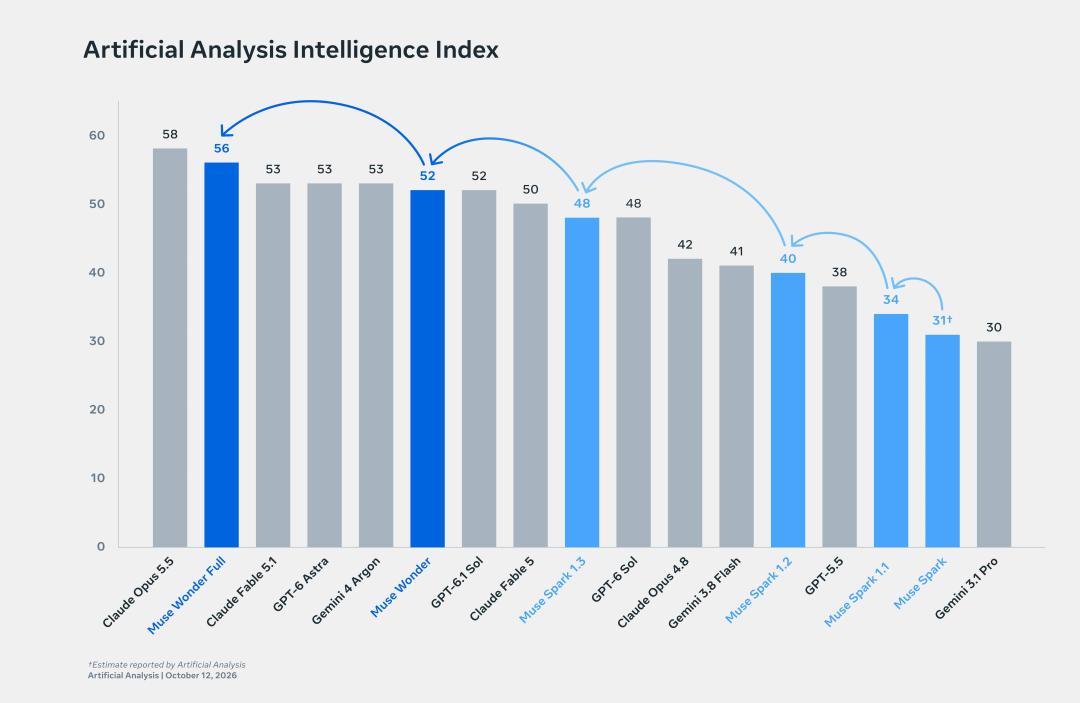
Darüber hinaus erzielt Wonder Full im umfassenden Drittbewertung Artificial Analysis Intelligence Index 56 Punkte, liegt vor GPT-6 Astra mit 53 Punkten, aber unter Claude Opus 5.5 mit 58 Punkten.
Neben den Ergebnissen ist auch die Preisgestaltung bemerkenswert.
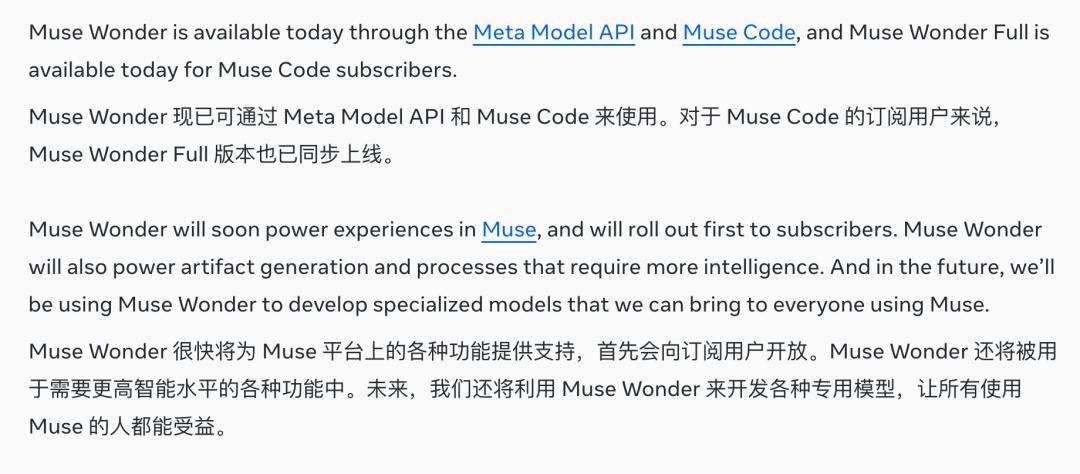
Derzeit ist die Standardversion von Muse Wonder über die Meta Model API und Muse Code verfügbar. Der API-Eingabepreis beträgt 4 USD pro Million Token, die Ausgabe 20 USD und die Cache-Eingabe 0,2 USD.
Zum Vergleich: Der Standard-API-Preis von Claude Opus 5.5 beträgt ebenfalls 4 USD für die Eingabe und 20 USD für die Ausgabe; GPT-6 Astra kostet 10 USD für die Eingabe und 50 USD für die Ausgabe.
Angesichts der Tatsache, dass die drei Modelle in einigen Tests sehr nah beieinander liegen, ist die Preisgestaltung von Wonder wettbewerbsfähig.
Zudem hat Meta angekündigt, dass für Wonder keine zusätzlichen Kosten für die Nutzung längerer Kontexte berechnet werden.
Die leistungsstärkere Wonder Full-Version mit besseren Testergebnissen kann vorübergehend nicht separat über die API erworben werden.
Sie ist derzeit nur für Abonnenten von Muse Code Power Usage und dem neu eingeführten Maximum Usage zugänglich. Ersterer kostet 50 USD pro Monat, Letzterer 200 USD pro Monat. Das Nutzungslimit des neuen Pakets beträgt das 80-fache des grundlegenden Everyday Usage-Pakets.
Was Muse, das persönliche Agent-Produkt von Meta, betrifft, wurde es bisher nicht gleichzeitig auf Wonder aktualisiert.
Meta gibt an, dass Wonder schrittweise in Muse integriert wird und zuerst für Abonnenten zugänglich sein wird. In Zukunft wird eine spezielle Version für die breite Öffentlichkeit veröffentlicht. Für Wonder Full gibt es noch keine konkreten Pläne zur Integration in Muse.
Obwohl das Flaggschiffmodell bereits veröffentlicht wurde, bleibt dieses Update für die meisten Nutzer vorerst auf Entwicklerprodukte und angekündigte Funktionen beschränkt.
Ausrichtung auf den Verbraucher-Agenten-Markt
Neben der Vorstellung von Testergebnissen hat Meta in seinem offiziellen technischen Blog viel Platz für die Diskussion der Generalisierungsfähigkeit des Modells eingeräumt.
Dabei werden zwei Begriffe besonders erwähnt: Benchmaxxing und Big model smell. Ersteres kann als „Ranglistenoptimierung“ verstanden werden, was bedeutet, dass das Modell übermäßig auf beliebte Benchmarks trainiert wird. Letzteres ist eine eher metaphysische Bezeichnung, die wörtlich „der Geschmack großer Modelle“ bedeutet.
Meta ist der Ansicht, dass selbst bei ähnlichen Testergebnissen zweier Modelle die tatsächliche Fähigkeit zur Bearbeitung unbekannter Aufgaben sehr unterschiedlich sein kann. Einige Modelle verfügen über Fähigkeiten, die über den Geltungsbereich beliebter Benchmarks hinausgehen, und Nutzer können dies im tatsächlichen Gebrauch spüren.
Um dies zu überprüfen, hat Meta speziell Muse Spark 1.3 und Wonder Full verglichen.
Die Forscher teilten zwei Arten von Aufgaben ein: Eine Kategorie von Aufgaben, die im Nachtrainingsprozess stark optimiert wurden, und eine andere Kategorie unbekannter Aufgaben, die nicht speziell optimiert wurden, und beobachteten die Leistung der beiden Modelle bei unterschiedlicher Inferenzintensität.
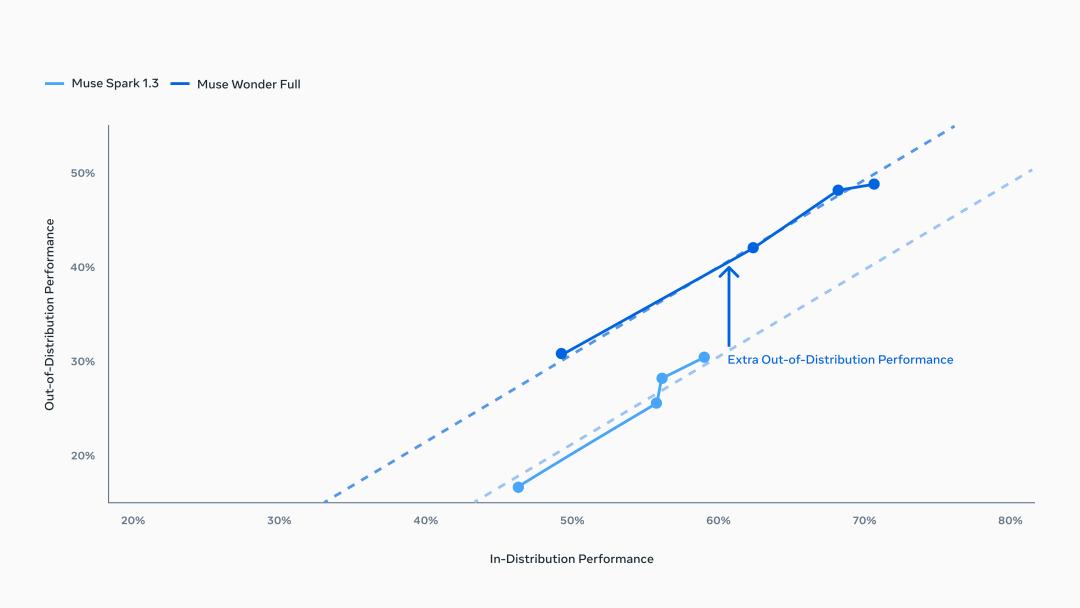
Die Ergebnisse zeigten, dass bei ähnlichen Ergebnissen bei stark optimierten Aufgaben Wonder Full bei unbekannten Aufgaben besser abschnitt und die Vorhersagen auf Basis der Testtrends von Spark 1.3 übertraf.
Meta geht davon aus, dass dies darauf zurückzuführen ist, dass Wonder auf einem größeren und leistungsstärkeren Grundmodell basiert. Je leistungsstärker das Grundmodell ist, desto wahrscheinlicher lassen sich die Verbesserungen durch das Nachtraining auf Aufgaben übertragen, die nicht speziell trainiert wurden.
Verglichen mit reinen Zahlen ist eine Reihe von offiziellen Beispielen von Meta vielleicht aufschlussreicher für die Entwicklungsrichtung von Wonder.
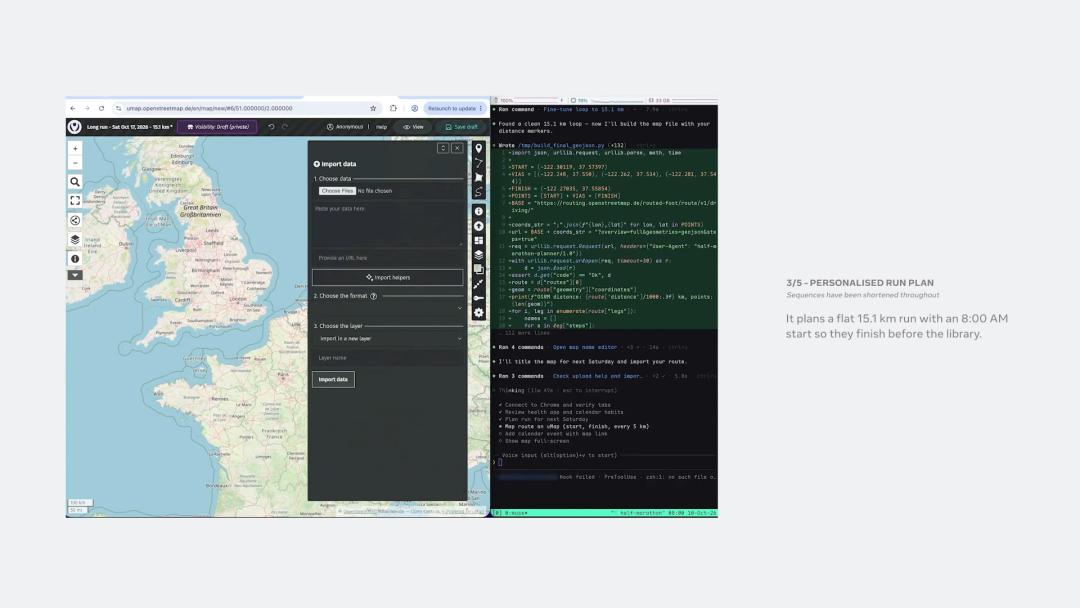
Beispielsweise kann Wonder einen Lauf am Samstag planen.
Wonder kann basierend auf den persönlichen Vorlieben und der tatsächlichen Situation des Nutzers zwischen Browser und mehreren Anwendungen operieren und einen Laufplan erstellen.
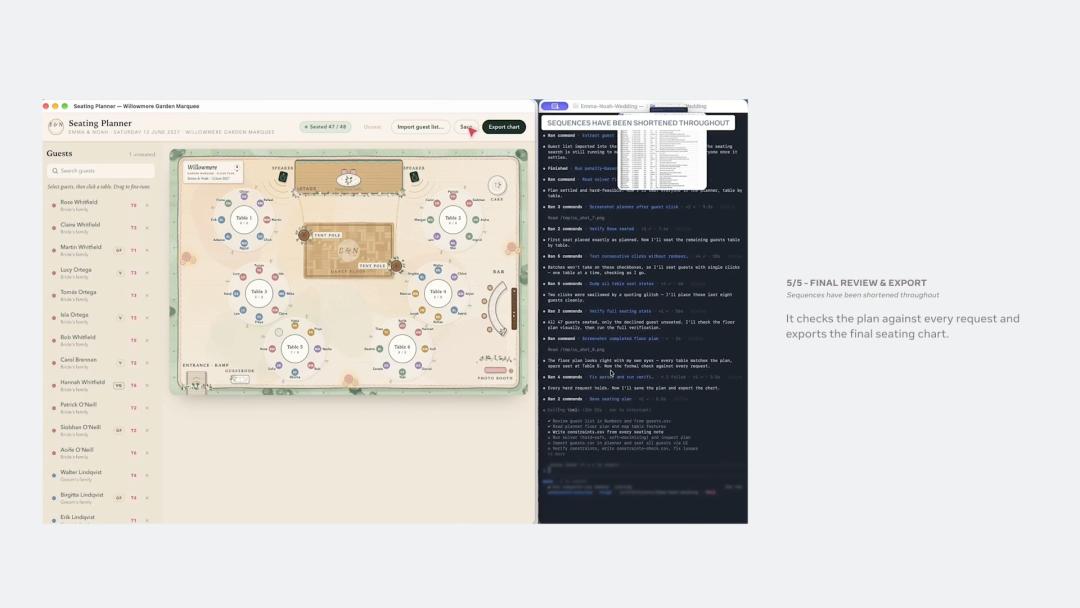
Ein weiteres Beispiel: Wonder soll Sitzplätze für eine Hochzeit arrangieren.
Der Nutzer stellt eine Reihe komplexer Anforderungen, einschließlich der Beziehungen zwischen Gästen und Einschränkungen bei der Sitzverteilung. Wonder erstellt daraufhin eine angepasste Sitzordnung für die Hochzeit.
Meta hat zudem demonstriert, wie Wonder echte Fotos aus dem Instagram-Konto des Nutzers liest, personalisierte Souvenirs entwirft und den Bestellvorgang abschließt.
Natürlich kann Wonder auch professionellere Aufgaben erledigen: Beispielsweise direkt aus einem vom Nutzer bereitgestellten Bild ein spielbares 3D-Küchenspiel gener