AWS macht es sich zu einfach – taugt die modulare Netzwerkkonstruktion etwas?
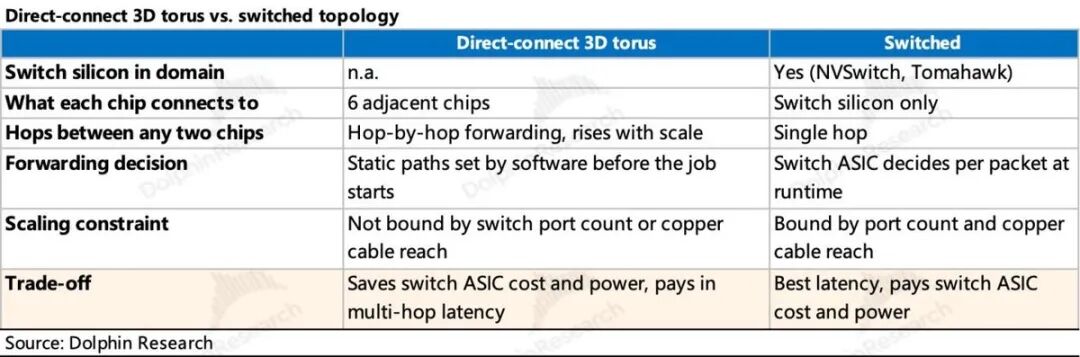
In den jüngsten Analysen zur Netzwerkkonfiguration hat Dolphin die 2D-Fat-Tree-Switching-Netzwerk, vertreten durch NVIDIA & AMD, sowie das 3D-Torus-Direktverbindungsnetzwerk, vertreten durch Google, systematisch aufbereitet.
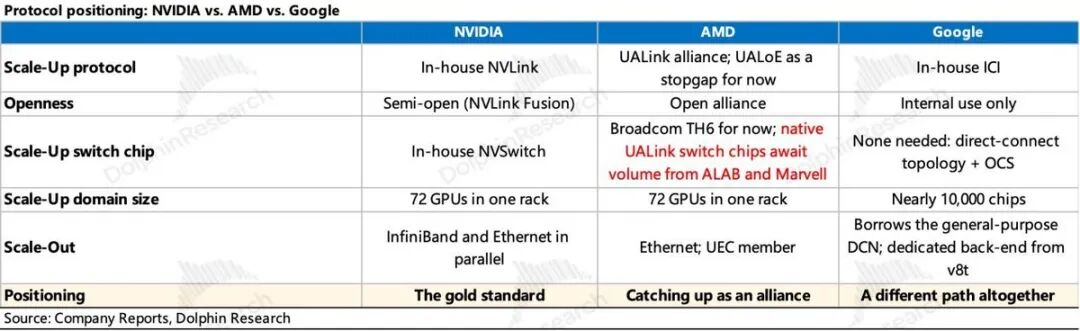
NVIDIA ist der Branchenmaßstab. Das gesamte Stack aus Hardware, Protokollen und Software wird selbst entwickelt, und die enge Abstimmung von Hard- und Software führt zu optimaler Leistung. Der Lösungsiterationsrhythmus ist schnell und die Sprünge sind groß, wodurch sich die Logik der Industriekette ebenfalls schnell ändert.
AMD folgt dem Beispiel von NVIDIA, konkurriert aber generationenversetzt. Helios übernimmt die Netzwerkarchitektur von GB300 NVL72, zielt aber bei der Bandbreitenleistung auf Vera Rubin ab. Schlüsselhardware wie Switch-Chips wird dagegen extern beschafft. Obwohl die Scale-Up-Bandbreite inzwischen gleichgezogen hat, liegen Gesamtleistung und Kosten immer noch hinter NVIDIA zurück.
Google geht einen völlig neuen Weg. Dank seiner herausragenden Softwarefähigkeiten verbindet Google mit der 3D-Torus-Topologie fast 10.000 Scale-Up-Domänen über OCS in Serie, was bei großen Anforderungen an die Netzwerkskalierung ein hervorragendes Preis-Leistungs-Verhältnis bietet.
Wie gehen Hersteller vor, die noch keine starke Wettbewerbsfähigkeit besitzen, aber intensiv daran arbeiten, die systemweite Lieferfähigkeit (insbesondere die Netzwerkfähigkeit) zu verbessern?
Dieser Artikel wendet sich dem letzten CSP-Giganten zu, der über eine systemweite Lösung verfügt: AWS. Die Kernmerkmale seines Netzwerks lauten: Zuerst auf den Markt bringen, dann nachbessern; lieber kaufen als selbst entwickeln, und das Kostengünstige auswählen. Mit anderen Worten: AWS ist der Anbieter, der am wenigsten selbst entwickelte Netzwerkkomponenten einsetzt.
Auf der Grundlage dieser Merkmale geht Dolphin der Sache weiter auf den Grund:
Ist ein standardisiertes Netzwerkprotokoll praktikabel?
Wandel der Netzwerktopologie: Von 3D-Torus-Direktverbindung zu Switching-Lösung
Wo liegen die Chancen in der AWS-Lieferkette?
Ist ein standardisiertes Netzwerkprotokoll praktikabel?
1. Scale-Up-Protokoll: NeuronLink, das auf PCIe aufbaut
1) Es wird als eigenentwickelt bezeichnet, basiert aber im Kern auf PCIe
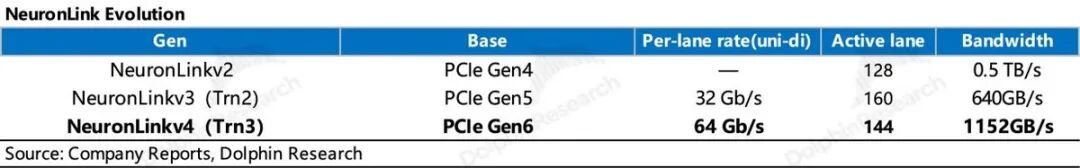
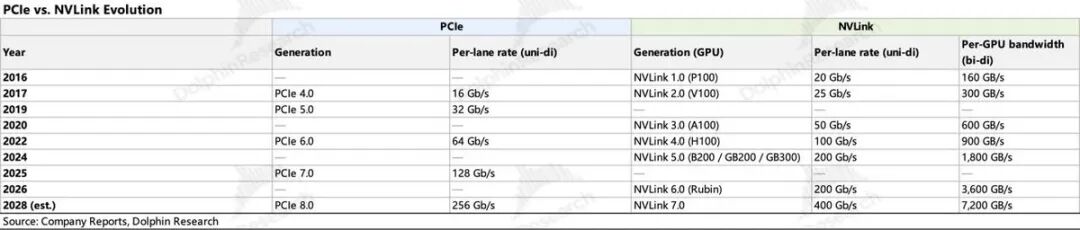
AWS hat für seinen selbst entwickelten Rechenchip Trainium (im Folgenden als Trn abgekürzt, der mit NVIDIAs GPU konkurriert) das On-Chip-Verbindungsprotokoll NeuronLink (NL, das mit NVLink konkurriert) entwickelt – aber dieses Protokoll ist im Wesentlichen eine Hülle für PCIe. Die aggregierte bidirektionale Bandbreite von NLv4 pro Karte beträgt 2.304 GB/s (offiziell angegeben als 2 TB/s, gegenüber 3,6 TB/s bei NVLink 6 & UALoE). Die Entwicklung verläuft wie folgt:
Da es ebenfalls auf standardisierten Kommunikationsprotokollen basiert, fällt einem leicht ein, dass AMD, da sein natives UALink-Switch-Chip noch in der Entwicklung ist, gezwungen ist, UALoE (UALink over Ethernet, auf Ethernet basierend) als Übergangslösung einzusetzen.
Aber AWS hat nicht die Absicht, selbst Switch-Chips zu entwickeln, sodass es kaum von PCIe abweichen kann – denn selbst entwickelte Protokolle erfordern normalerweise Chips als Unterstützung. Später könnte es stattdessen zu einem Einkäufer von UALink werden, was im späteren Abschnitt über die Netzwerklösung näher erläutert wird.
2) Was wird bei einem selbst entwickelten Protokoll tatsächlich selbst entwickelt?
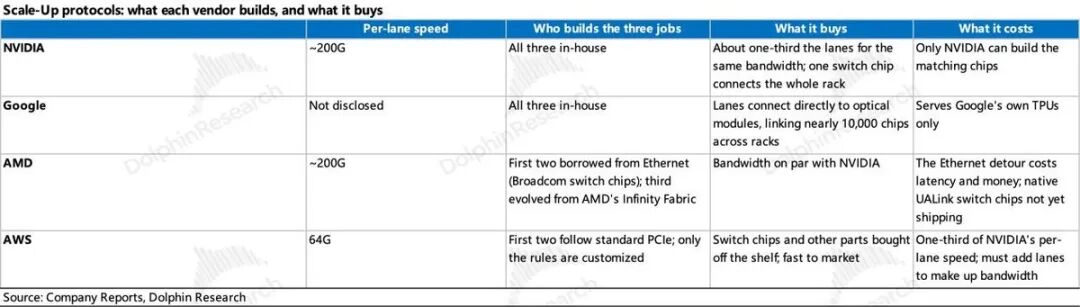
In der Branche scheint es selbstverständlich zu sein, dass Scale-Up-Protokolle selbst entwickelt werden müssen, um hohe Bandbreite und geringe Latenz zu erreichen. Um zu beurteilen, wie gut das auf PCIe basierende Netzwerkprotokoll von AWS ist, muss man zuerst verstehen, was die verschiedenen Hersteller bei ihren Scale-Up-Protokollen tatsächlich selbst entwickeln. Kurz gesagt: Ein Scale-Up-Protokoll muss drei Probleme lösen:
a. Wie schnell kann die Leitung laufen: Zwischen Chips werden Daten über einzelne Leitungen (Lane, also ein Paar aus Sende- und Empfangsleitung, vergleichbar mit einer Fahrspur) übertragen. Wie schnell jede Leitung laufen kann, hängt davon ab, wie gut die Schaltungen auf dem Chip für das Senden und Empfangen von Signalen (SerDes) ausgelegt sind – das ist die höchste Hürde.
b. Was tun, wenn ein Übertragungsfehler auftritt: Auf Leitungen treten unweigerlich Fehler auf, und das Protokoll muss festlegen, wie Fehler erkannt und behoben werden.
c. Was können die Chips miteinander tun: Das heißt, ob man direkt nach Adressen auf die Daten des anderen Chips zugreifen und sie lesen/schreiben kann, so wie man auf den eigenen Speicher zugreift. Der Unterschied zwischen Scale-Up und Scale-Out wird auf dieser Ebene definiert.
Von diesen drei Punkten ist a der wichtigste. Denn die Punkte b und c ähneln der Definition von Regeln, während die Qualität der Schaltungen ein Problem der physischen Implementierung ist, das sich direkt in der Geschwindigkeit pro Lane widerspiegelt. NVIDIA entwickelt selbst 200G-SerDes, und AMD erreicht durch den Einkauf von Broadcom TH6 ebenfalls eine Geschwindigkeit von 200G. Je schneller eine einzelne Lane ist, desto weniger Lanes werden für die gleiche Bandbreite benötigt.
Zurück zu AWS: Die Geschwindigkeit pro Lane bei PCIe Gen6 beträgt nur 64G. Um die Bandbreitenlücke zu schließen, muss man entweder auf die Iteration von PCIe warten, um die Geschwindigkeit zu erhöhen, oder die Anzahl der Lanes aufstocken.
3) Ist das auf PCIe basierende Kommunikationsprotokoll gut? Die Antwort ist Nein.
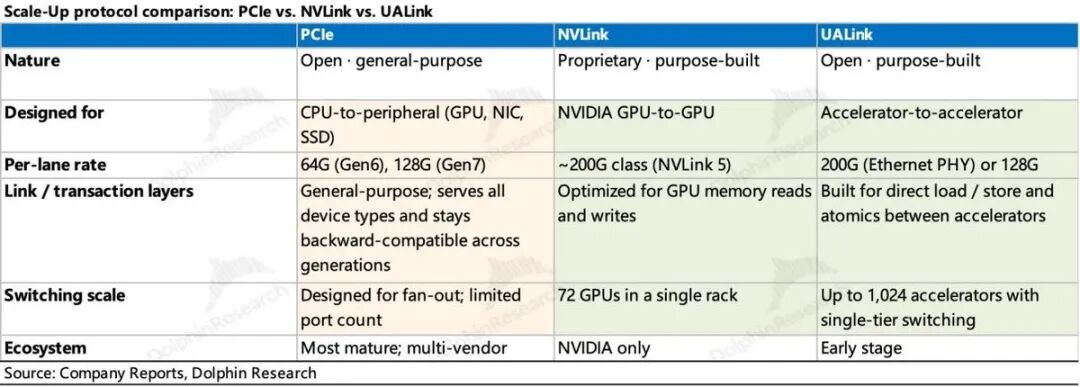
Abgesehen von der AWS-Lösung wurde PCIe ursprünglich für die Kommunikation zwischen CPUs und anderen Geräten (xPU, Netzwerkkarten usw.) entwickelt. Im Vergleich zu proprietären Protokollen hat es neben der langsamen Geschwindigkeit pro Lane auch Probleme wie eine begrenzte Anzahl von Ports, siehe die folgende Tabelle für Details:
a. Warten auf Iteration zur Geschwindigkeitssteigerung?
Der Rhythmus liegt zurück. PCIe hat etwa eine Generation alle drei Jahre, NVLink etwa eine Generation alle zwei Jahre. Der Iterationsrhythmus kann nicht mithalten, und von der Veröffentlichung der PCIe-Spezifikation bis zum Einsatz der Chips vergehen weitere Jahre – AWS kann nur passiv folgen.
b. Ist das Aufstocken der Lanes praktikabel?
Die Kosten steigen an. Um zwischen zwei Generationen mehr Bandbreite zu erhalten, muss man die Anzahl der Lanes aufstocken. Aber bei zu hoher Anzahl steigen die Kosten für Backplane-Kupferkabel, Steckverbinder und PCIe-Retimer (die das Signalverlängerungsproblem auf der Leitung lösen) automatisch an, was den Stromverbrauch und die Gesamtkosten erhöht.
c. Warum wird PCIe trotzdem gewählt, obwohl es zwei Nachteile hat?
Die Antwort ist einfach: Um Aufwand zu sparen und schnell auf den Markt zu kommen. Die Protokollebene von AWS muss nur den Standards folgen, und gleichzeitig entfällt der Entwicklungszyklus für Switch-Chips. Für Cloud-Anbieter ist es notwendig, die Aufschläge von NVIDIA zu vermeiden und selbst zu entwickeln, aber gleichzeitig die Lieferanforderungen für Rechenknoten von Schlüsselkunden (Anthropic) so schnell wie möglich zu erfüllen – daher wurde die Hülle von PCIe gewählt. Mit anderen Worten: Wettbewerbsfähigkeit ist nicht ihr primäres Kriterium, sondern die Lieferbarkeit.
4) NLv5: UALink/NVLink könnte ein guter Weg sein
Was das nächste Generation-Protokoll betrifft, wird die Situation auf der Protokollebene noch unangenehmer, wenn es weiterhin auf PCIe Gen7 basiert.
Man kann dies an der Entwicklungslogik von PCIe verstehen. Wie in der folgenden Tabelle gezeigt, hat sich die Geschwindigkeit pro Lane von PCIe 5.0 bis PCIe 6.0 verdoppelt, indem das Modulationsverfahren geändert wurde.
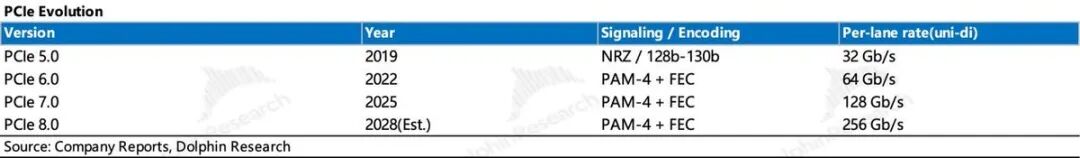
Es gibt zwei Möglichkeiten, die Geschwindigkeit physisch zu verdoppeln: Erstens die Frequenz der Signalwechsel (erzeugt durch Wechsel zwischen hoher und niedriger Spannung) zu verdoppeln – aber der Verlust von Kupferdrähten steigt mit der Frequenz stark an, was sehr hohe Anforderungen an die Leitungsführung stellt. Zweitens bei jedem Signalwechsel ein Bit mehr zu übertragen.
Beim NRZ-Modulationsverfahren wird die Spannung in zwei Stufen (hoch, niedrig) unterteilt, und bei jedem Wechsel wird 1 Bit übertragen (also 0, 1). Beim PAM4-Modulationsverfahren wird die gleiche Spannung in vier Stufen unterteilt, und bei jedem Wechsel werden 2 Bit übertragen (also 00, 01, 10, 11).
Das Problem von Gen7 ist, dass man die Geschwindigkeit nicht mehr durch Wechsel des Modulationsverfahrens verdoppeln kann – man muss die Signalfrequenz erhöhen, was den Druck auf Plattenmaterial und Retimer vervielfacht, und die Kosten sind nicht mehr beherrschbar.
Daher ist Dolphin der Ansicht, dass AWS zwei Wege hat: Erstens, wenn die Switch-Chips auf UALink umgestellt werden, kann die Protokollebene automatisch das mit den Chips verbundene UALink übernehmen, was eine höhere Bandbreite bringt. Zweitens, zu NVLink zu wechseln – AWS hat bereits angekündigt, dass Trn4 NVLink Fusion unterstützen wird.
2. Scale-Out-Protokoll: EFA, das keine großen Anstrengungen unternimmt
Nach der Betrachtung von Scale-Up ist die Netzwerkstrategie von AWS weitgehend klar: Bei dem Scale-Up, bei dem alle Hersteller stark konkurrieren, ist es sehr „entspannt“, und bei Scale-Out ist es noch zurückhaltender – daher wird dieser Punkt nur kurz erläutert.
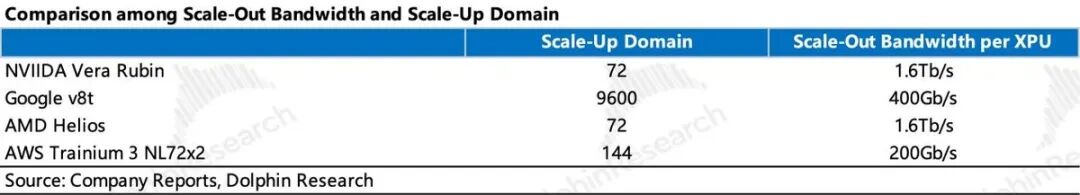
a. Die Bandbreite bleibt über zwei Generationen unverändert. Die Scale-Out-Schicht wird von dem selbst entwickelten EFA-Netzwerk von AWS getragen, das eigentlich eine Variante des Standard-Ethernets ist. Die Scale-Out-Bandbreite pro Karte bei den beiden Haupt-Rack-Lösungen beträgt nach wie vor 200 Gb/s, ohne Steigerung. Zum Vergleich: Im gleichen Zeitraum stieg bei NVIDIA die Bandbreite von 800G bei GB300 auf 1,6T bei Vera Rubin, und bei Google von 100G bei v7 auf 400G bei v8t.
b. Die Scale-Up-Domäne ist klein, und die Bandbreite ist sogar niedriger. Googles Scale-Up-Domäne mit fast 10.000 Karten senkt die Anforderungen an Scale-Out, aber die Bandbreite wurde trotzdem um das Vierfache erhöht. Die Domäne von NVIDIA hat nur 72 Karten, und ein großer Teil des Datenverkehrs läuft über Scale-Out, daher sind die Anforderungen an die Netzwerkkarten-Bandbreite höher. Die Scale-Up-Domäne von AWS hat 144 Karten und liegt dazwischen, aber die Scale-Out-Bandbreite beträgt nur 200G, was sogar niedriger ist als bei Google.
c. Der wichtige Switch-Hardware-Switch-ASIC wird extern beschafft. Obwohl AWS die Netzwerkkarte Nitro und White-Box-Switches selbst entwickelt, werden die darin enthaltenen Switch-Chips von mehreren Herstellern (Broadcom, Marvell) eingekauft.