Kann man Betrugsversuchen vorbeugen, wenn man nach dem Abheben des Anrufs zunächst drei Sekunden schweigt?
Am 11. Oktober veröffentlichte das offizielle WeChat-Konto des Ministeriums für Staatssicherheit einen Warnhinweis: Wenn Sie einen unbekannten Anruf erhalten, antworten Sie nicht sofort, sondern schweigen Sie zunächst drei Sekunden lang.
Kriminelle könnten nach dem Herstellen der Telefonverbindung absichtlich schweigen, um den Angerufenen dazu zu verleiten, Antworten wie „Hallo?“ oder „Wer ist da?“ zu geben. Eine nur wenige Sekunden lange Sprachprobe kann bereits für das Klonen von KI-Stimmprofilen verwendet werden, um dann die Identität einer Person vorzutäuschen und Betrug zu begehen. Warten Sie daher bei einem Anruf zunächst, bis die Gegenseite das Wort ergreift – falls die andere Person ebenfalls fortwährend schweigt, legen Sie den Anruf rechtzeitig auf.
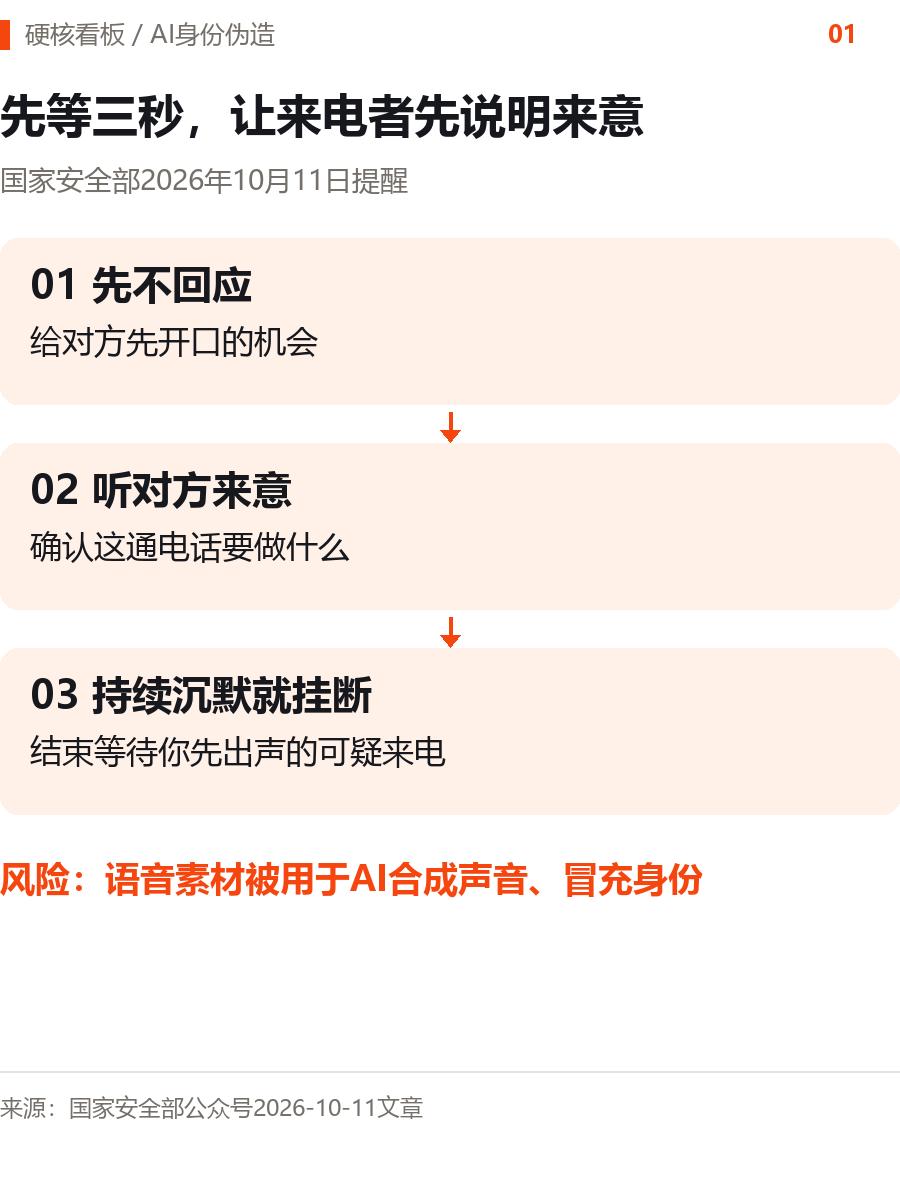
Die konkrete Vorgehensweise, auf die das Ministerium für Staatssicherheit hinweist: Lassen Sie den Anrufer zuerst sein Anliegen nennen, und legen Sie sofort auf, wenn er fortwährend schweigt.
Stimmen sind wertvoll zu sammeln, weil KI heute bereits mit der Stimme einer Person neue Sätze erzeugen kann, die diese Person nie gesagt hat.
Solches Material kann auch aus bereits öffentlich zugänglichen Ton- und Videodateien stammen. Alles, was online gesagt oder in Videos aufgenommen wurde, kann gesammelt werden, um Identitäten vorzutäuschen.
Darstellung eines KI-generierten Szenarios: Wenn ein unbekannter Anruf eingeht, hören Sie zuerst zu, was die Gegenseite zu sagen hat.
In bereits aufgedeckten Fällen mischen Betrüger synthetische Stimmen, Gesichtsersatz durch KI und echtes Bildmaterial zusammen. Eine fiktive Person bekommt Stimme, Gesicht und lebensnahe Szenen, die zu ihrer Identität passen – sie kann sogar in Unternehmenssitzungen auftreten.
KI-Stimmen können Menschen wirklich täuschen
Im April 2025 erhielt Tante Ding aus Huangshi in Hubei einen Anruf. Die Gegenseite gab sich als ihr Enkel aus, behauptete, er habe in der Schule eine Schlägerei gehabt und brauche Geld für eine Entschädigung, und jemand würde vorbeikommen, um das Geld abzuholen.
Sie hob 20.000 Yuan ab. Als die Person, die das Geld abholen sollte, bei ihr zu Hause ankam, rief sie erneut den „Enkel“ an, um sie zur Bestätigung aufzufordern. Erst als der echte Enkel am selben Abend nach Hause kam, wurde der Betrug aufgedeckt.
Hier hat KI die Stimme des Enkels gefälscht. Tante Ding hatte bereits eine Bestätigung vorgenommen, aber der zweite Anruf ging immer noch zu den Betrügern – die vertraute Stimme bürgte erneut für die Person, die das Geld abholte.
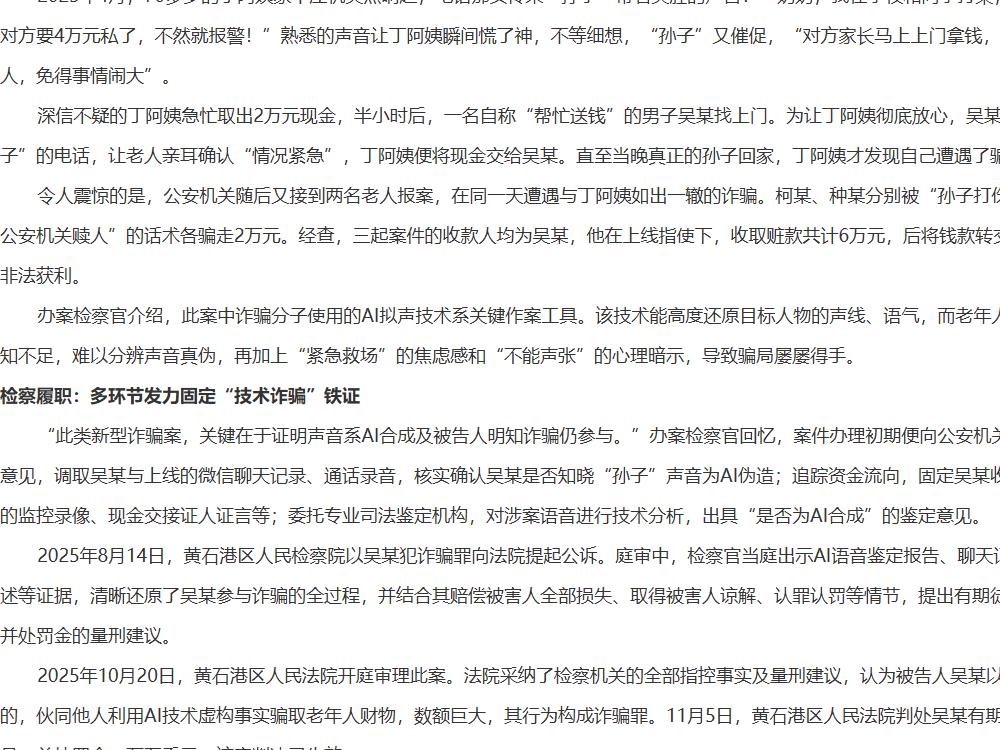
Screenshot eines Berichts der Staatsanwaltschaft des Stadtbezirks Huangshigang: KI gibt sich als Enkel aus, um Altersvorsorgegeld zu erschleichen.
Im Juni 2026 führten Forscher der Technischen Universität Breslau in Polen eine Studie durch: Sie verarbeiteten echte Aufnahmen von 9 Sprechern und per KI geklonte Stimmen jeweils mit Simulationen der Übertragung über herkömmliche Mobilfunkverbindungen, HD-Anrufe und Netzwerkanrufe, ließen 95 Teilnehmer die Echtheit prüfen und sammelten insgesamt 1710 Bewertungen.
Die Gesamtgenauigkeit betrug nur 54,8 %. Bei herkömmlichen Mobilfunkverbindungen lag sie bei 63,7 %, bei HD-Anrufen sank sie sogar auf 44 %.
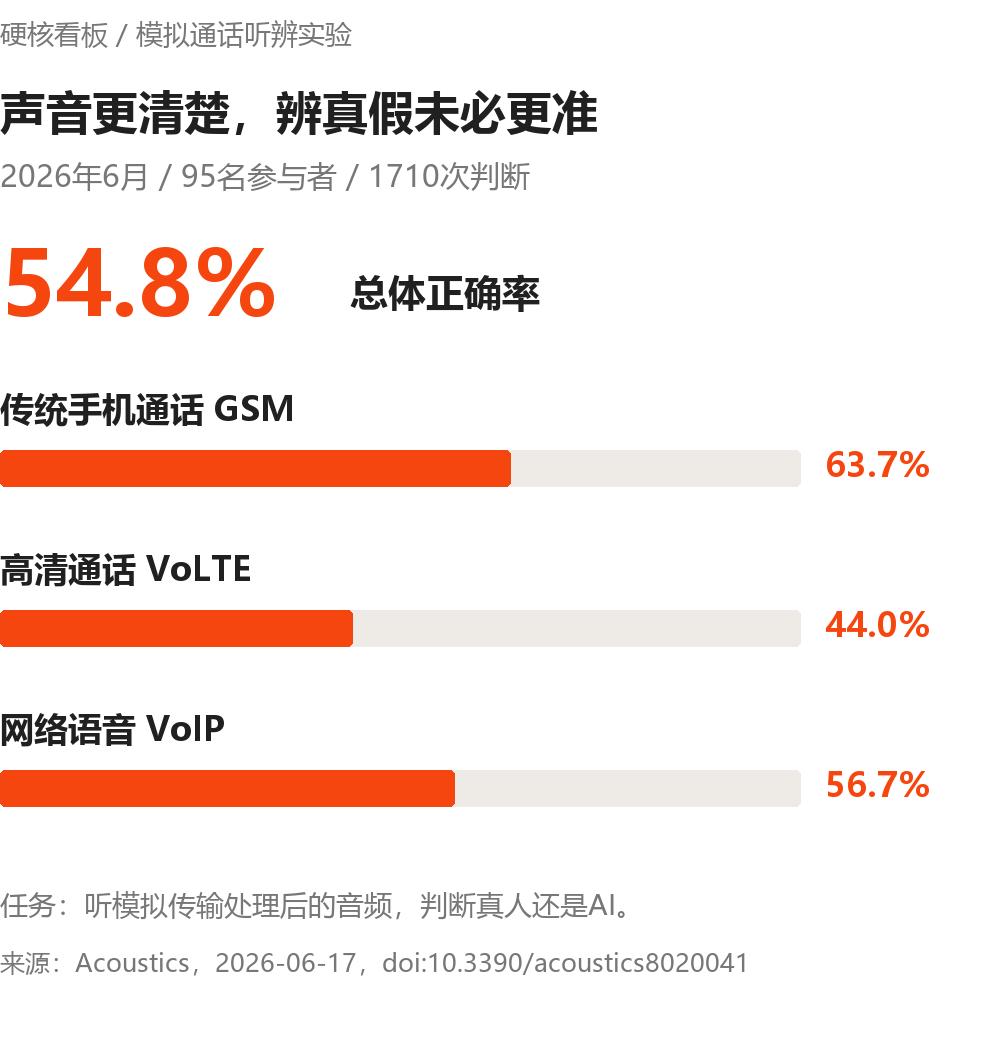
Experiment zur Erkennung von simulierten Anrufen 2026: 95 Teilnehmer beurteilten echte Stimmen und per KI geklonte Stimmen, die Gesamtgenauigkeit betrug 54,8 %.
HD-Anrufe sollten das Hören eigentlich klarer machen – in diesem Experiment fiel es den Zuhörern jedoch schwerer, Echt und Falsch zu unterscheiden.
Wenn im Telefon ein dringender Hilferuf ertönt, in einer Sitzung eine Zahlungsanweisung auftaucht und die Betrüger ständig drängen, richtet sich die Aufmerksamkeit schnell auf die Frage „Wie soll ich das jetzt erledigen?“, und es bleibt noch weniger Zeit, die Stimme zu prüfen.
Bei dem Fall mit falschen Offizieren aus Laixi in Shandong machte KI die Identität noch vollständiger.
Die Betrüger zeigten dem Opfer Trainingsvideos in Militäruniform und demonstrierten per Videoanruf eine Kasernenumgebung. Die Szenen aus der Kaserne wurden aus öffentlichem Material zusammengeschnitten, KI ersetzte die Gesichter in den Bildern echter Soldaten, und Sprachsynthese-Software erzeugte die Stimme. Dieses Material wurde verwendet, um Vertrauen aufzubauen und zu Investitionen zu verleiten.
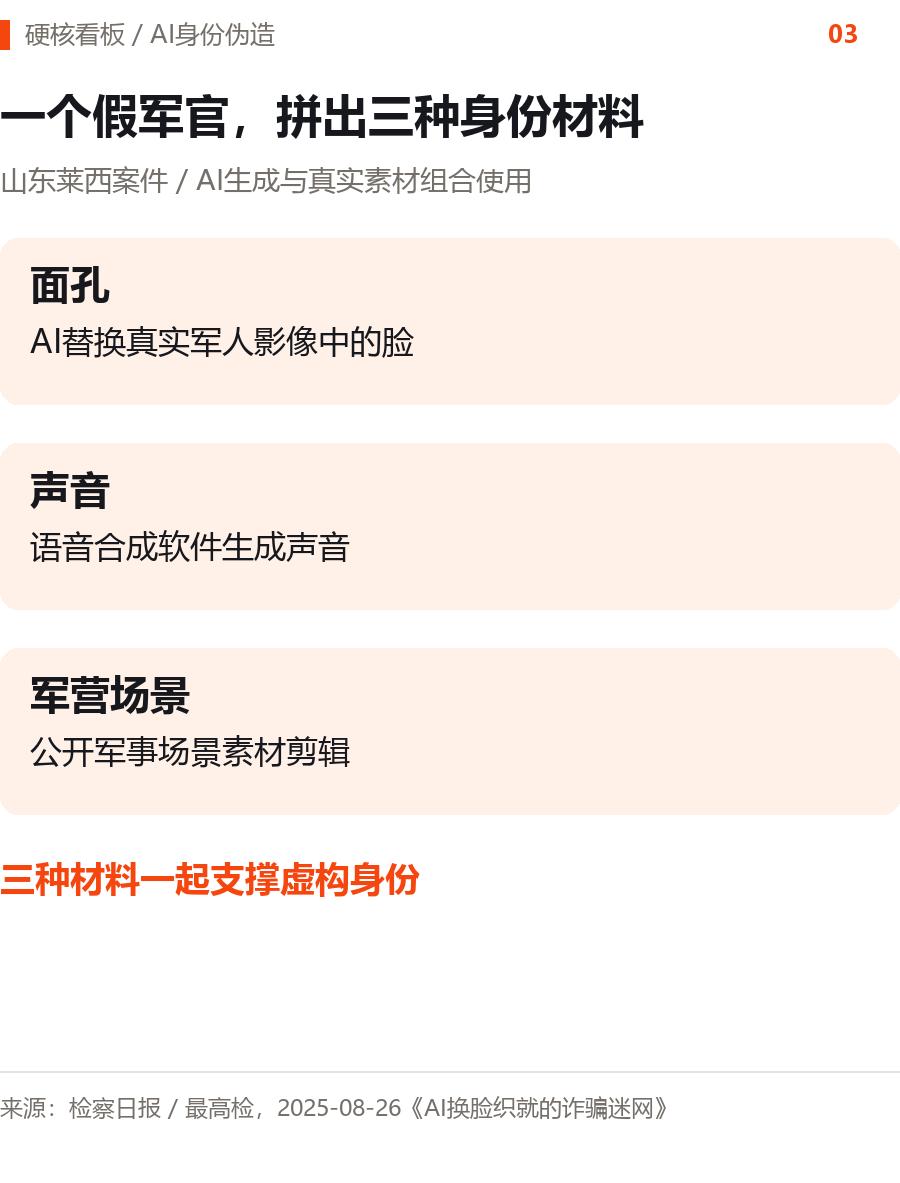
Im Fall von Laixi stützen KI-generierte Gesichter und Stimmen zusammen mit öffentlichem Material von militärischen Szenen die fiktive Identität.
Bei einem Unternehmensbetrug in Hongkong wurde sogar eine Videokonferenz erfunden.
Laut der Antwort der Regierung von Hongkong vom Juni 2024 gehen die Beamten davon aus, dass Betrüger öffentliche Videos und Stimmen nutzten, um mit Deepfake-Techniken voraufgezeichnete Konferenzen herzustellen und sich als Unternehmensmanager auszugeben. Das Opfer hatte keine tatsächlichen Gesprächsinteraktionen mit den Personen im Video, und nach Ende der Konferenz wiesen die Betrüger über Instant-Messaging-Dienste weiterhin zur Zahlung an. Nach den damaligen Angaben belief sich der Schaden auf etwa 200 Millionen Hongkong-Dollar.
Die Betrüger platzierten die vertrauten Manager in derselben Konferenz, sodass die Zahlungsforderung wie eine kollektiv bestätigte Anweisung aussah.
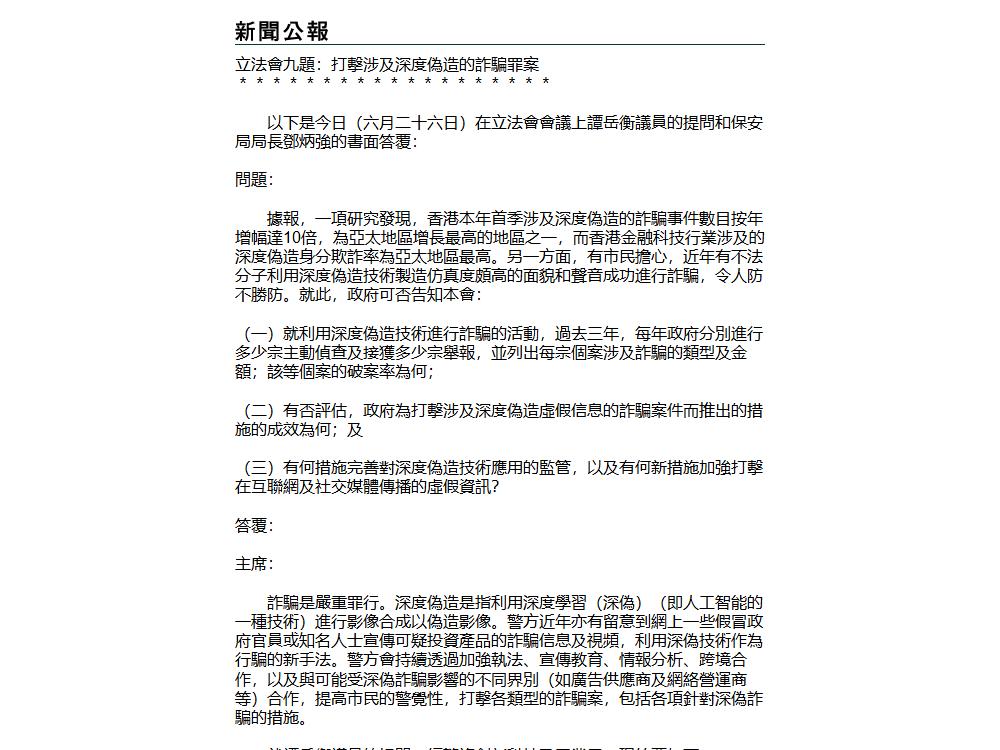
Screenshot der Antwort der Regierung von Hongkong vom 26. Juni 2024: Öffentliche Videos und Stimmen wurden zur Herstellung voraufgezeichneter Konferenzen verwendet.
Stimmen ab 9 Yuan, Gesichtsvideos können massenhaft geliefert werden
Eine Untersuchung der Xinhua-Nachrichtenagentur im April 2026 ergab, dass auf Second-Hand-Handelsplattformen Software zum Stimmenklonen, Anleitungen und Dienstleistungen zur Erstellung im Auftrag angeboten werden. Kunden liefern die Originalstimmdatei und den zu synthetisierenden Text, erhalten das fertige Produkt schnellstmöglich in 15 Minuten, normalerweise in einer halben bis einer Stunde.
Einige Shops verlangen 9 Yuan für 200 Wörter oder 10 Yuan pro Minute, andere suchen sogar kostenlos nach passenden Stimmquellen. Wenn die Leistung des eigenen Computers nicht ausreicht, bieten Händler auch Mietlösungen für Cloud-Plattformen an.
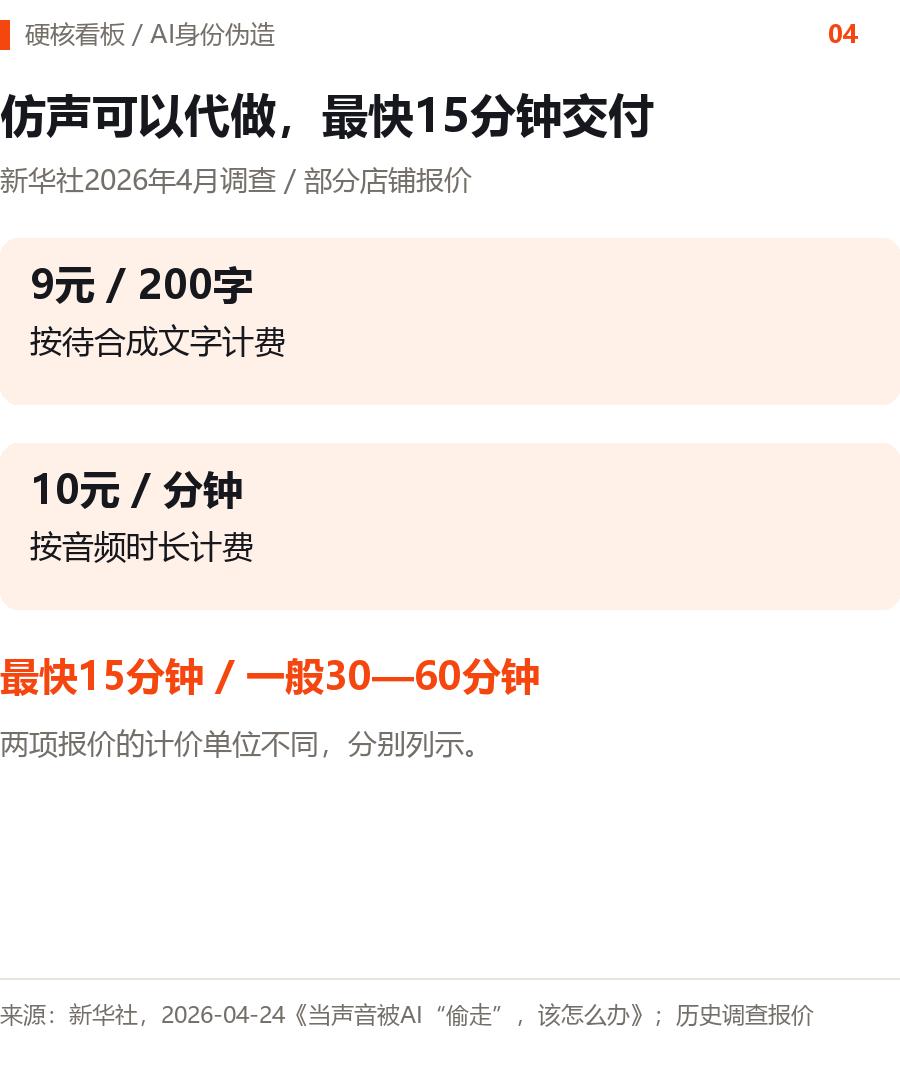
Von der Untersuchung der Xinhua-Nachrichtenagentur aufgezeichnete Preisangaben und Lieferzeiten einiger Shops, erhoben im April 2026.
Früher musste man für die Erstellung der individuellen Stimme einer Person oft extra Aufnahmen sammeln und Modelle trainieren. Heute haben einige Sprachmodelle aus großen Datenmengen bereits Sprach- und Ausspracheregeln gelernt – bei der Nutzung reicht es, eine Referenzaufnahme zur Verfügung zu stellen, damit das Modell den neuen Sprecher nachahmen kann. Technisch wird dies als „Null-Shot-Stimmenklon“ bezeichnet, das bedeutet, dass das Modell nicht extra für diese Person neu trainiert werden muss.
Wie lange muss die aufgenommene Stimme eigentlich sein? Die Dokumentation zur Stimmreproduktion von Alibaba Cloud verlangt eine Probe von 10 bis 20 Sekunden. Das Open-Source-Projekt GPT-SoVITS gibt eine 5 Sekunden lange Stimmprobe als Eingabe für die Null-Shot-Synthese an, es gibt auch einen Weg, mit einer 1 Minute langen Aufnahme eine Feinabstimmung vorzunehmen, um die Ähnlichkeit der Stimme zu erhöhen. In einem Video von einigen zehn Sekunden kann bereits genügend Referenzstimme enthalten sein.
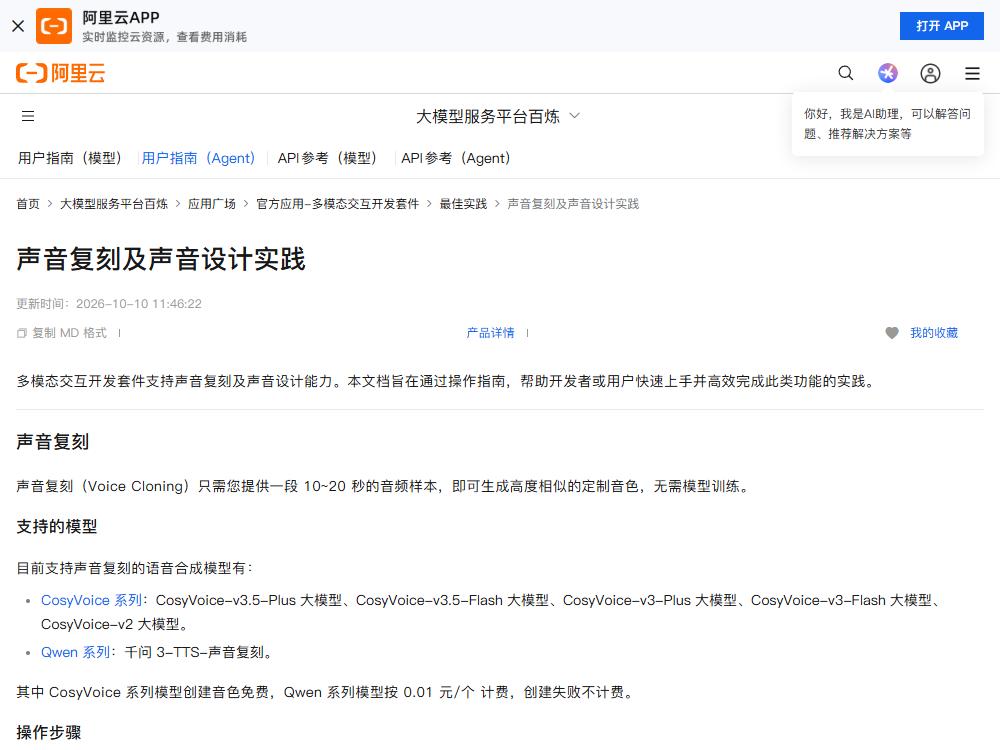
Screenshot der Dokumentation zur Stimmreproduktion von Alibaba Cloud: Die Referenzaufnahme soll 10 bis 20 Sekunden lang sein, kein separates Training erforderlich.
Das von einem Forschungsteam veröffentlichte F5-TTS-Projekt unterteilt die Eingaben klar: Referenzaufnahme, der Text, der zur Aufnahme gehört, und der neue Text, der erzeugt werden soll. Der Text zur Aufnahme kann auch automatisch durch Spracherkennung ergänzt werden.
Das Modell vergleicht Aufnahme und Text, ermittelt die Stimmmerkmale des Sprechers und erzeugt dann eine akustische Darstellung nach dem neuen Text. Man kann dies als digitale Beschreibung der Stimme verstehen, die anschließend von einem Vocoder zu einer abspielbaren Audiodatei umgewandelt wird.
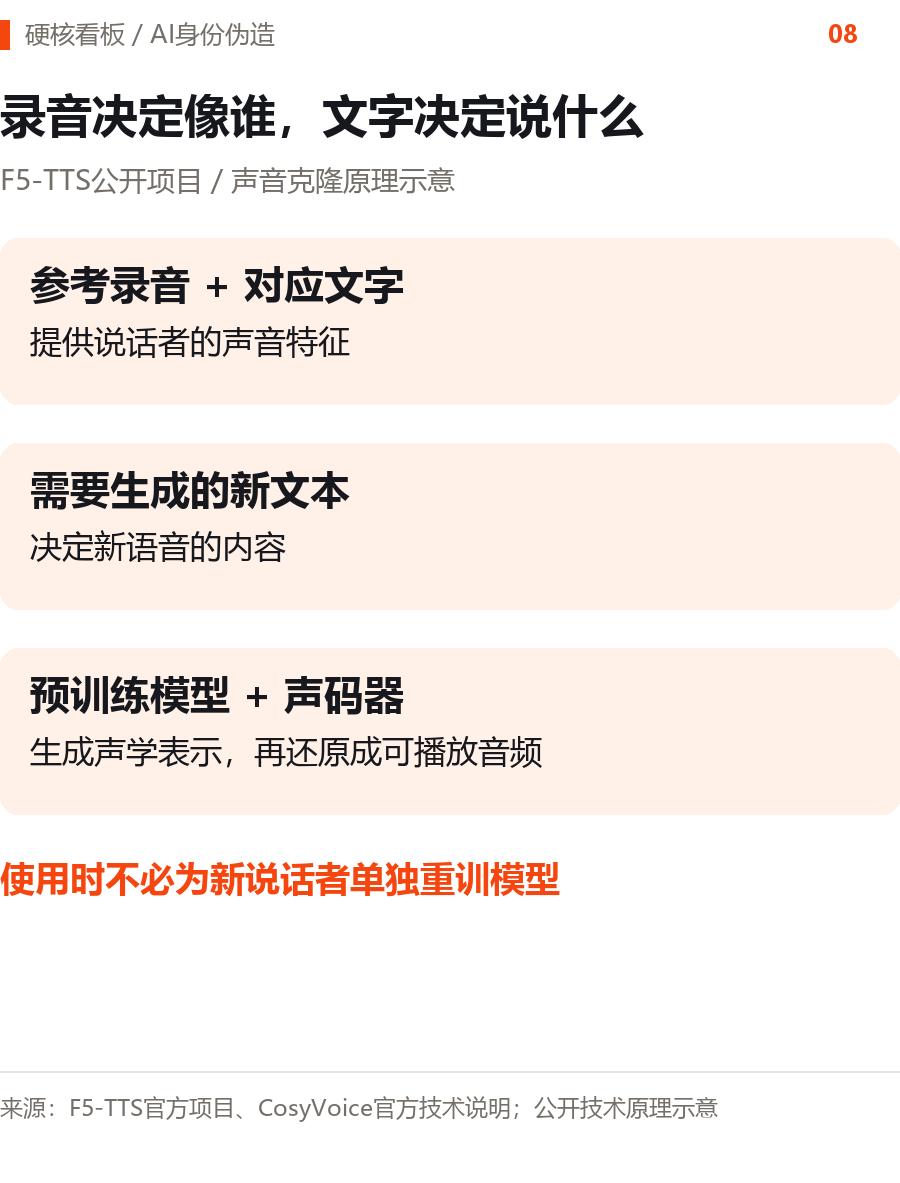
Beispiel am öffentlichen Projekt F5-TTS: Die Referenzaufnahme dient zur Nachahmung der Stimme, der neue Text bestimmt den generierten Inhalt.
Kann ein normaler Computer das ausführen? Die offizielle Testumgebung von GPT-SoVITS umfasst CPU, Apple-Chips und Nvidia-Grafikkarten, es gibt auch ein integriertes Paket für Windows. In einer veröffentlichten Gruppe von v2 ProPlus-Inferenztests wurden RTX 4060 Ti, RTX 4090 und Apple M4 CPU verwendet.
Wie schnell ist das? Der „Echtzeitfaktor“, der vom GPT-SoVITS-Projekt angegeben wird, beschreibt das Verhältnis von Generierungsdauer zur Audiodauer. Bei der 4060 Ti beträgt er 0,028, bei der M4 CPU 0,526. Umgerechnet dauert die Generierung einer einminütigen Stimme also etwa 1,7 Sekunden bzw. 32 Sekunden.
Für die Softwareinstallation gibt es auch fertige Lösungen. CosyVoice des Alibaba-Teams und F5-TTS des Forschungsteams haben ihre Modelle und Webschnittstellen öffentlich zugänglich gemacht. Wenn eine Person alle Abhängigkeiten und Modelle konfiguriert hat, können andere über die Schnittstelle Material einreichen. CosyVoice unterstützt zudem Streaming-Ausgabe: Wenn Text kontinuierlich eingespeist wird, kann die Stimme abschnittsweise ausgegeben werden.
Darstellung eines KI-Generierungsszenarios: Ein normaler Arbeitsplatz aus Computer, Kopfhörern und Mikrofon.
Wenn man den Cloud-Weg wählt, wird die Berechnung an den Dienstanbieter übergeben, der Computer ist nur für das Einreichen von Aufnahmen und Text zuständig. Die Kosten teilen sich in zwei Teile: die Erstellung der Klangfarbe und die Synthese neuer Sprache mit dieser Klangfarbe.