Gegen Agent, gegen RSI, das neue Modell von Yann LeCun widersetzt sich allen aktuellen KI-Narrativen
In *Avengers: Endgame* gibt es eine Szene, in der Captain America leise zu den Agenten von S.H.I.E.L.D. im Aufzug sagt: „Lang lebe Hydra“.
Nur durch diesen einen Satz übergeben die Hydra-Mitglieder, die sich als S.H.I.E.L.D.-Agenten ausgeben, Captain America das Zepter, in das der Gedankenstein eingelassen ist.
Das ist noch nicht alles: Gerade weil die Hydra-Mitglieder Captain America für einen ihrer eigenen hielten, wurde der Plan von Iron Man und seinen Kollegen, den Raumstein zur gleichen Zeit zu stehlen, nicht aufgedeckt. Am Ende besiegen die Avengers erfolgreich Thanos und retten das Universum.
Sie sehen: Selbst ein einziger Satz kann Auswirkungen auf das gesamte Universum haben. Das neue Weltmodell H-JEPA von Yann LeCun zielt darauf ab, durch die zugrundeliegende Logik des hierarchischen Schlussfolgerns die weitere Entwicklung abzuleiten.
Welche Folgen hat eine kleine Handlung kurzfristig? Und mittelfristig? Und langfristig?
Genau das beschreibt der berühmte Schmetterlingseffekt: Ein Schmetterling, der in Brasilien mit den Flügeln schlägt, kann letztendlich in Texas einen Tornado auslösen.
Was ist H-JEPA eigentlich?
Der Ausgangspunkt von H-JEPA ist Yann LeCuns JEPA, die vollständige Bezeichnung lautet Joint-Embedding Predictive Architecture, also eine Architektur zur Vorhersage gemeinsamer Einbettungen.
Im Gegensatz zu den heute verwendeten videogenerativen Modellen zeichnet es nicht das nächste Bild: JEPA komprimiert das Bild in eine Gruppe abstrakter Vektoren (die sogenannten latenten Repräsentationen) und sagt dann in diesem abstrakten Raum die Zukunft voraus.
Das ist so, als würden zwei Personen mit geschlossenen Augen Schach spielen. Man braucht überhaupt kein Schachbrett mehr, man muss nur sagen, welchen Zug man machen will, zum Beispiel „der General verlässt den Palast und zieht einen Schritt nach vorne“ oder „der Soldat rückt ein Feld vor“. Die andere Person kann anhand des Gehörten den Verlauf des Schachbretts im Kopf vorstellen und dann antworten.
Nachdem man JEPA verstanden hat, betrachtet man nun das neue H-JEPA: Es stapelt mehrere solcher JEPA-Schichten übereinander.
Jede Schicht verfügt über einen eigenen Beobachtungs-Encoder, einen Aktions-Encoder und einen latenten Prädiktor, und jede Schicht sagt in ihrem jeweiligen Repräsentationsraum den Zustand nach unterschiedlichen Zeitspannen voraus. Die unterste Schicht ist am detailliertesten und blickt am kürzesten in die Zukunft, während die darüberliegenden Schichten weiter und makroskopischer blicken.
Bei der Planung läuft es umgekehrt ab: Die obere Schicht gibt zuerst einen groben Zielzustand vor, der zum Unterziel der nächsten Schicht wird, die ihn weiter verfeinert, bis die unterste Schicht die eigentliche Aktion ausgibt.
Bereits 2022 schlug Yann LeCun in seinem Aufsatz *Ein Weg zur autonomen maschinellen Intelligenz (A Path Towards Autonomous Machine Intelligence)* ein hierarchisches JEPA vor. Erst vier Jahre später gibt es erstmals eine reproduzierbare vollständige Implementierung.
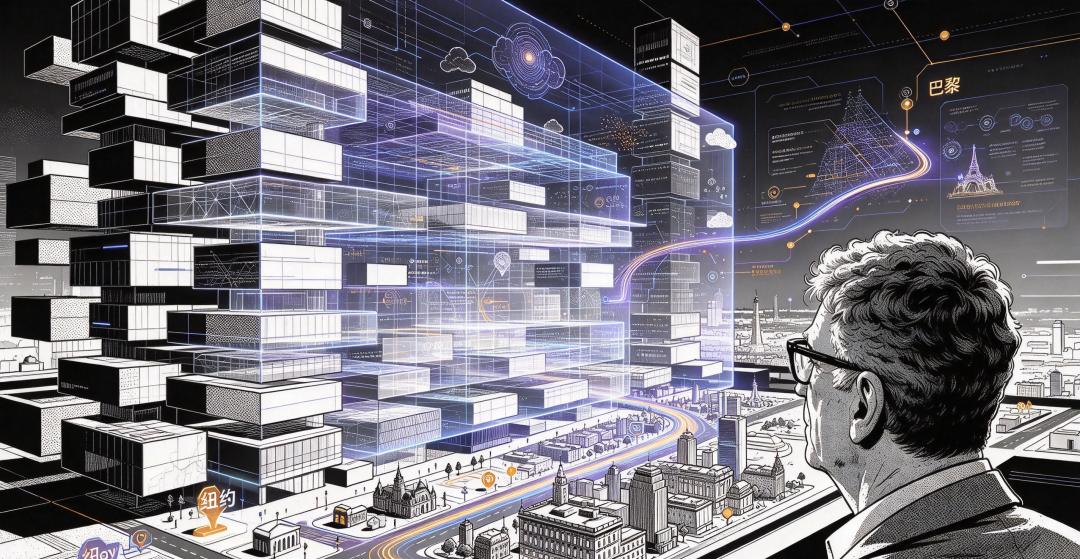
Die zugrundeliegende Logik der Hierarchie ist ein Konzept, das Yann LeCun einmal vorgeschlagen hat: „Von New York nach Paris fahren“.
Ein Beispiel: Wenn Sie von Peking nach Shanghai fahren wollen, ist die Planung in Ihrem Kopf zwangsläufig hierarchisch. Zuerst denken Sie an „mit dem Hochgeschwindigkeitszug fahren“, dann an „wie man zum Südbahnhof von Peking kommt“ und erst zuletzt an „welchen Fuß man zuerst setzt“.
Sie würden niemals beim Buchen des Tickets darüber nachdenken, wie hoch die Stufen vor Ihren Füßen sind.
Verschiedene Abstraktionsebenen müssen von vornherein unterschiedliche Informationen behalten. Auf der Ebene der Ticketbuchung braucht man nur „Zeit, Preis und Zugnummer“ zu kennen; auf der Ebene des Gehens braucht man erst „Schwerpunkt, Stufen und Boden“ zu kennen.
Genau das ist die größte Schwierigkeit von Transformer-Modellen. Wenn man jedes Token einzeln vorhersagt, bedeutet das, dass man die drei Dinge „Ticket buchen, zum Bahnhof gehen und die Treppe hinuntersteigen“ gleichzeitig denkt. Je mehr Schritte es gibt, desto leichter treten Fehler auf.
Um langfristigere Ziele zu erreichen, muss man alle Zwischenschritte im Detail durchgehen.
Der Aufsatz erwähnt, dass flache einschichtige Modelle bei langen Aufgaben viele feingranulare Schritte ausführen müssen, wobei sich Vorhersagefehler ansammeln und der Aktionssuchraum größer wird.
Als Referenzstandard für die hierarchische Struktur verwendet der Aufsatz die Visual-AntMaze-Labyrinth-Aufgabe. Die Erfolgsrate des einschichtigen LeWM liegt nur bei 18%, während die Erfolgsrate des dreischichtigen H-JEPA 73% erreicht.
An dieser Stelle stellt sich eine Frage: Wenn die Leistung bei drei Schichten so gut ist, warum fügt Yann LeCun dann nicht 100 oder sogar 10.000 Schichten hinzu?
Bei der Push-T-Aufgabe schneiden zwei Schichten am besten ab. Wenn man drei oder vier Schichten hinzufügt, sinkt die Leistung sogar.
Die Vermutung des Aufsatzes lautet: Die Aufgabentrajektorie ist von Natur aus kurz, was die für die oberen Schichten verfügbare Trainingsdatenmenge einschränkt. Bei drei Schichten können nur etwa 58% der übertragbaren Trainingsdaten von LeWM verwendet werden, bei vier Schichten sind es nur noch etwa 14%.
Mit anderen Worten: Mehr Schichten sind nicht immer besser.
Warum lehnt Yann LeCun Agenten ab?
Das Interessanteste an H-JEPA ist, dass sein Konzept der Hierarchie genau dem gegenteiligen Trend der heute verbreiteten Agenten-Erzählung widerspricht.
Derzeit werden bei Agenten lange Aufgaben in mehr Schritte unterteilt, und es werden mehr Token für Versuche aufgewendet.
Das bedeutet: Zuerst planen, dann Werkzeuge aufrufen, dann prüfen, dann neu anfangen. Je feiner die Unterteilung und je mehr Versuche es gibt, desto näher scheint man der Erfüllung der Aufgabe zu kommen.
Aber Yann LeCuns Aufsatz erwähnt, dass das Hinzufügen von Hierarchieebenen effektiver ist als das einfache Erhöhen der Schrittzahl. Nach der Hierarchisierung muss die obere Schicht nur in wenigen Schritten entscheiden, „in welche Richtung man geht“, die Details werden den unteren Schichten übergeben, und der Rechenaufwand für die Planung sinkt entsprechend.
Top-Unternehmen wie OpenAI und Anthropic verbessern die Fähigkeiten ihrer Modelle, indem sie auf derselben Granularitätsebene expandieren. Jede Iteration eines neuen Modells hat einen längeren Kontext, mehr Token und mehr Versuche. Deshalb ist es so, dass sie zwar ständig von Preissenkungen sprechen, aber wenn man sie tatsächlich nutzt, merkt man, dass es immer teurer wird.
H-JEPA schlägt eine Expansion nach oben vor: Die Abstraktionsebenen werden erhöht, sodass das Modell unterschiedliche Repräsentationen auf unterschiedlichen Zeitskalen verwendet.
Auf dem Weltwirtschaftsforum in Davos im Januar dieses Jahres sagte Yann LeCun, dass große Sprachmodelle zwar die Anwaltsprüfung bestehen und Code schreiben können, aber keine komplexen Probleme der realen Welt wirklich bewältigen können. Denn heute gibt es weder Haushaltsroboter noch autonomes Fahren der Stufe L5.
Er fügte hinzu: „Ich kann mir nicht vorstellen, dass ein System, das die Folgen seiner eigenen Handlungen nicht im Voraus vorhersagen kann, zu einem Agenten gemacht werden kann.“ Nebenbei bemerkt: Als Yann LeCun das sagte, war Dario Amodei direkt neben ihm.
H-JEPA ist ein Weltmodell. Jede Aktion wird vor der Ausführung zuerst im latenten Raum „durchgespielt“, um zu sehen, welche Zustände kurz-, mittel- und langfristig daraus resultieren, bevor die Aktion ausgewählt wird.
Daher vertritt Yann LeCun die Ansicht, dass ein echter Agent nicht „einen Satz sagt, die Reaktion beobachtet und es bei Misserfolg anders versucht“ sollte, sondern schon vor dem Aussprechen des Satzes ungefähr wissen sollte, welche Kettenreaktionen er auslösen wird.
Ein weiterer Punkt: Die heutigen Agenten, insbesondere Programmieragenten, werden hauptsächlich durch Belohnungstraining trainiert, also durch das Prinzip „Punkte hinzufügen bei richtiger Aktion, Punkte abziehen bei falscher Aktion“.
Einer der wichtigsten Gründe, warum Code zum Hauptschlachtfeld der KI geworden ist, ist dass es beim Schreiben von Code fertige Signale für Richtig und Falsch gibt: Ob Tests bestanden werden, ob Kompilierungsfehler auftreten oder ob die Benchmark-Punkte steigen.
In einem offiziellen Artikel von Anthropic wurde erwähnt, dass Claude unter der Voraussetzung vorgegebener Ziele und Bewertungsstandards bereits Experimente durchführen und Code optimieren kann, aber noch Lücken bei der „Auswahl von Zielen und der Beurteilung, welche Probleme es wert sind, erforscht zu werden“ hat. Je klarer die überprüfbaren Standards sind, desto besser funktionieren die Agenten.
Auch hier geht H-JEPA den entgegengesetzten Weg. Der Aufsatz betont wiederholt, dass sein Training „keine Belohnungen und keine Rekonstruktion erfordert“. Es braucht keine externen Bewertungen und keine pixelgenaue Wiederherstellung des ursprünglichen Bildes.
H-JEPA lernt von Anfang bis Ende im Repräsentationsraum, den nächsten Zustand vorherzusagen.
Die berühmte „Theorie der nassen Affen“ beschreibt genau diesen Sachverhalt.
In einem Käfig befinden sich 5 Affen, über ihnen hängen Bananen. Sobald ein Affe eine Leiter hochklettert, um die Bananen zu holen, werden alle Affen bestraft.
Die Affen wissen nicht, was eine Wasserpistole ist, aber nachdem sie mehrmals mit Wasser besprüht wurden, lernen sie, dass sie die Bananen nicht berühren dürfen.
Warum lehnt Yann LeCun auch RSI ab?
Im Mai dieses Jahres trat ein Unternehmen namens Recursive Superintelligence aus dem Stealth-Modus hervor. Es erhielt eine Finanzierung von über 650 Millionen US-Dollar, die Vorfinanzierungsbewertung liegt bei etwa 4,65 Milliarden US-Dollar.
Einer der Mitbegründer dieses Unternehmens ist Tian Yuandong, ehemaliger Forschungsdirektor von Meta FAIR. Er ist außerdem ein langjähriger Mitarbeiter, den Yann LeCun zu Zeiten bei FAIR ausgebildet hat.
Was das Unternehmen Recursive Superintelligence vertritt, ist, dass KI sich rekursiv selbst verbessern kann – schließlich heißt das Unternehmen genau so, die Lösung liegt direkt im Namen.
RSI ist so beliebt, dass sogar sein ehemaliger Mitarbeiter es umsetzt, aber Yann LeCun erwähnt in H-JEPA kein einziges Wort davon.
Denn Yann LeCun ist der Ansicht, dass das, was sowohl heutige Weltmodelle als auch seine idealen Agenten fehlen, nicht durch RSI ausgeglichen werden kann.
Yann LeCuns Standpunkt lautet: Wenn man eine KI sich selbst verbessern lässt, verbessert sie immer noch nur ihre grundlegenden Fähigkeiten. Wenn man zum Beispiel ein großes Sprachmodell durch RSI verbessert, wird am Ende nur seine Sprachfähigkeit gesteigert. Die fehlenden Multimodalitäts- und Schlussfolgerungsfähigkeiten von Sprachmodellen wachsen nicht einfach dadurch von selbst, dass man die Anzahl der Verbesserungsrunden erhöht.
Daher ist Yann LeCun der Meinung, dass RSI nur ein Verstärker ist, der das verstärkt, was bereits vorhanden ist.
Von JEPA bis H-JEPA: Selbst wenn RSI übermäßig erfolgreich wäre, würde es hier nicht helfen.
Gleichzeitig braucht man überprüfbare Bewertungsgrundlagen, damit RSI funktioniert.
Wie bereits erwähnt, sind Signale wie „ob Codetests bestanden werden“ oder „ob Benchmark-Punkte steigen“ solche Kriterien, aber beim Training von H-JEPA wird ausdrücklich keine Belohnung verwendet.
Yann LeCun ist der Ansicht, dass es in der physischen Welt keine fertigen Bewertungsstandards gibt. Wenn zum Beispiel ein Roboter einen Becher schief schiebt, wie viele Punkte sollte er dafür bekommen? In einer Welt ohne Punkte, wie soll man „Verbesserung“ messen?
Yann LeCun kritisiert RSI nebenbei auch direkt in seinem Aufsatz.
Im DROID-Experiment stammen die Daten aus Fernsteuerungsvideos echter Roboter, wobei sich Szenen, Beleuchtung und Objekte in verschiedenen Clips ständig ändern.
Wenn man das Modell nur vorhersagen lässt, lernt es nur, „welche Szene das ist“, und ignoriert den sich tatsächlich bewegenden Roboterarm im Bild. Der Aufsatz nennt dies „Slow-Feature-Collapse“ (Kollaps langsamer Merkmale).
Die Forscher müssen manuell eine inverse Dynamikseinschränkung hinzufügen, die das Modell auffordert, die mittlere Aktion aus den Zuständen vor und nach der Aktion abzuleiten. Ohne diese Einschränkung sinkt die Leistung des Modells direkt auf Null. Erst mit dieser Einschränkung wird die Planungsfähigkeit wiederhergestellt.
Das bedeutet: Das Modell lernt, „welche Folgen eine Aktion hat“, durch eine von Menschen entworfene Einschränkung, nicht dadurch, dass sich das Modell selbst immer weiter verbessert.
Außerdem hängt der Erfolg nicht von der Anzahl der Verbesserungen ab.
Ein altes Sprichwort sagt: „Wenn man ein Buch hundertmal liest, offenbart sich sein Sinn von selbst.“ Aber Yann LeCun ist der Ansicht, dass der Erfolg eines Modells nicht davon abhängt, wie viele Runden RSI durchlaufen werden. Entscheidend ist vielmehr, was jede Schicht behalten und was sie verwerfen soll, und ob das tiefe Modell über genügend Daten verfügt.
Das oben erwähnte Beispiel der Push-T-Aufgabe, bei der die Leistung bei drei und vier Schichten nicht steigt, sondern sinkt, ist der direkteste Beweis dafür. Rekursives Vertiefen führt nicht automatisch zu einer Steigerung der Modellfähigkeiten.
In Yann LeCuns Entwicklungslinie muss die KI zuerst lernen, die Welt kor