NeurIPS'26: Ist Attention auch FFN? Ein neues Verständnis der effizienten Attention ausgehend von schnellen Gewichten
Seit langem gelten im Transformer-Architektur die Aufmerksamkeit (Attention) und das Feed-Forward Network (FFN) als zwei Module mit unterschiedlichen und komplementären Funktionen:
Das Erste lässt die Token miteinander interagieren, das Zweite führt eine nichtlineare Transformation für jedes Token durch.
Wenn man jedoch die Formel des Aufmerksamkeitsmechanismus expandiert, wird eine leicht zu übersehende Verbindung sichtbar: Die Standard-Aufmerksamkeit kann auch als FFN geschrieben werden – nur dass ihre Gewichte durch die aktuelle Eingabe generiert werden und die Breite der verborgenen Schicht mit der Sequenzlänge wächst.
Daraus ergibt sich eine weitere Erklärung für den Overhead langer Kontexte: Wir verarbeiten nicht nur mehr Token, sondern betreiben auch ein Netzwerk, das ständig breiter wird. Können dann die scheinbar unterschiedlichen technischen Richtungen wie lineare Aufmerksamkeit, Aufmerksamkeit mit gemischten Experten und Top-k-Aufmerksamkeit neu verstanden werden, ausgehend von der Frage „Wie organisiert man dieses Netzwerk“?
Um dieses Problem herum hat das Team der Beijing University of Posts and Telecommunications das Mixture-of-Top-k Attention (MiTA) vorgeschlagen, das die bestehende Perspektive der Schnellen Gewichte (Fast Weights) zu einem fünfdimensionalen Klassifizierungsrahmen weiterentwickelt und darauf aufbauend verformbare, wiederverwendbare Top-k-Experten entworfen hat, die sowohl globale Informationen behalten als auch originale Details bei Bedarf abrufen. Diese Arbeit wurde von NeurIPS 2026 angenommen, und der Code ist quelloffen verfügbar.
Adresse des Papiers: https://arxiv.org/pdf/2602.01219
Code-Repository: https://github.com/QishuaiWen/MiTA
Auch die Aufmerksamkeit ist ein FFN – der Schlüssel liegt darin, woher die Gewichte stammen
Sei die Abfrage
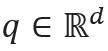
, Schlüssel und Werte werden spaltenweise zusammengesetzt
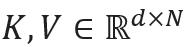
.
Wenn man das übliche zweischichtige Multi-Layer-Perceptron (MLP) des FFN und die Standard-Aufmerksamkeit zusammenlegt, wird die Breite der verborgenen Schicht des Ersteren mit D bezeichnet:
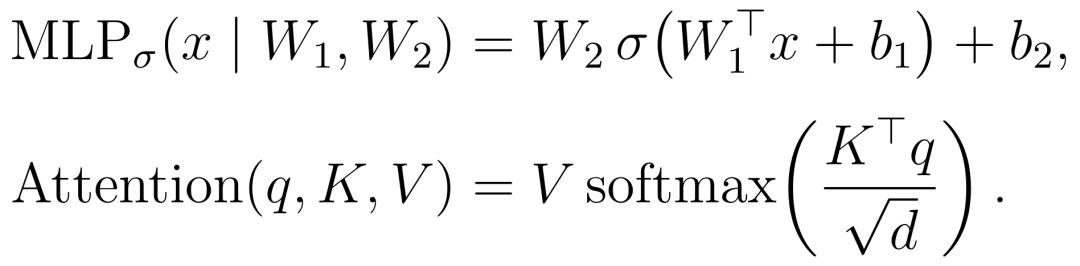
Man expandiert Softmax und absorbiert die Skalierung und die von der Abfrage abhängige Normalisierung in die Gewichte:
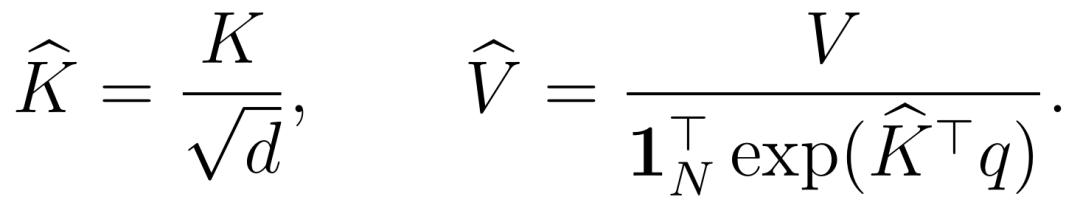
Die Entsprechung tritt sofort auf:
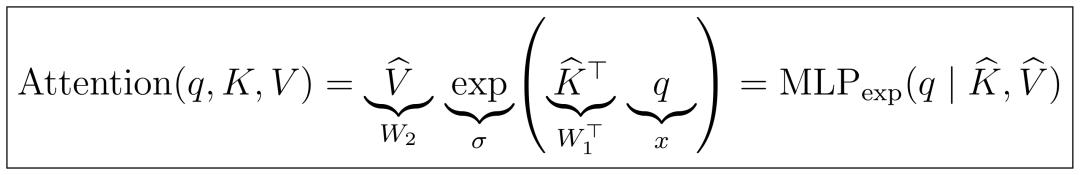
Die Abfrage entspricht der Eingabe, die transformierten Schlüssel und Werte entsprechen den beiden Schichten der Gewichte, die Exponentialfunktion entspricht der Aktivierungsfunktion, der Bias ist Null, und die Breite der verborgenen Schicht ändert sich von D zur Sequenzlänge N.
Der Unterschied liegt in der Herkunft der Gewichte: Das gewöhnliche FFN verwendet die trainierten Langsamen Gewichte (Slow Weights), während die Aufmerksamkeit die durch die aktuelle Eingabe generierten K, V als schnelle Gewichte verwendet, die sich mit dem Kontext ändern.
Der wichtigere Unterschied liegt in der Breite: Jedes Schlüssel-Wert-Paar entspricht einer verborgenen Einheit. Je länger der Kontext ist, desto breiter wird dieses schnelle Gewichts-MLP. Jede Abfrage greift auf N verborgene Einheiten zu, die Verarbeitung von N Abfragen erzeugt einen Gesamt-Overhead von

.
Das Design der effizienten Aufmerksamkeit wird damit zu einem einheitlichen Problem: Wie kann man das ständig wachsende schnelle Gewichtsnetzwerk skalierbar halten?
Verständnis von Kompression und Routing anhand eines immer breiter werdenden MLP
Gegenüber diesem immer breiter werdenden Netzwerk lassen sich die Hauptideen der effizienten Aufmerksamkeit in zwei Richtungen zusammenfassen.
Kompression: Umwandlung des breiten Netzwerks in kompakte Module (Scaling by Compression). Die lineare Aufmerksamkeit (Linear Attention) komprimiert Schlüssel-Wert-Informationen in gemeinsam genutzte lineare Schichten, Linformer bildet sie auf ein schmaleres MLP ab, und Test-Time Training (TTT) lernt kompakte schnelle Gewichtsmodule. Diese Richtung bietet eine globale Zusammenfassung, ist aber schwer, die Details der originalen Schlüssel-Wert-Paare direkt abzurufen.
Routing: Behalten des ursprünglichen Inhalts, nur Zugriff auf die benötigten Teile (Scaling by Routing). Man organisiert Schlüssel-Wert-Teilmengen zu Schnellgewicht-Experten (Fast-Weight Experts) und lässt dann die Abfragen nach Bedarf auswählen. Diese Experten bestehen aus Schlüssel-Wert-Paaren im aktuellen Kontext: Sie behalten die Details der ausgewählten Inhalte, fehlt aber eine Zusammenfassung des vollständigen Kontexts.
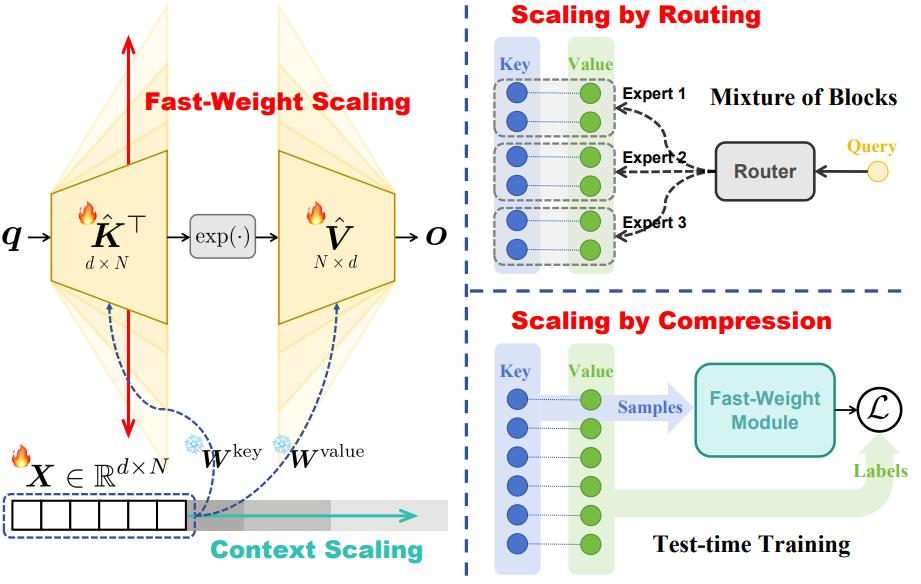
Abbildung 1: Das Wachstum des Kontexts macht das schnelle Gewichts-MLP breiter. Routing wählt einen Teil davon aus, während Kompression eine kompaktere Darstellung erzeugt.
Diese beiden Richtungen schließen sich nicht gegenseitig aus. Wenn man weiter Skalierungsstrategie (Scaling Strategy), Anzahl der Experten (Expert Count), Expertentyp (Expert Type), Methode zur Expertenkonstruktion (Expert Construction) und Routing-Topologie (Routing Topology) berücksichtigt, erhält man einen fünfdimensionalen Klassifizierungsrahmen.
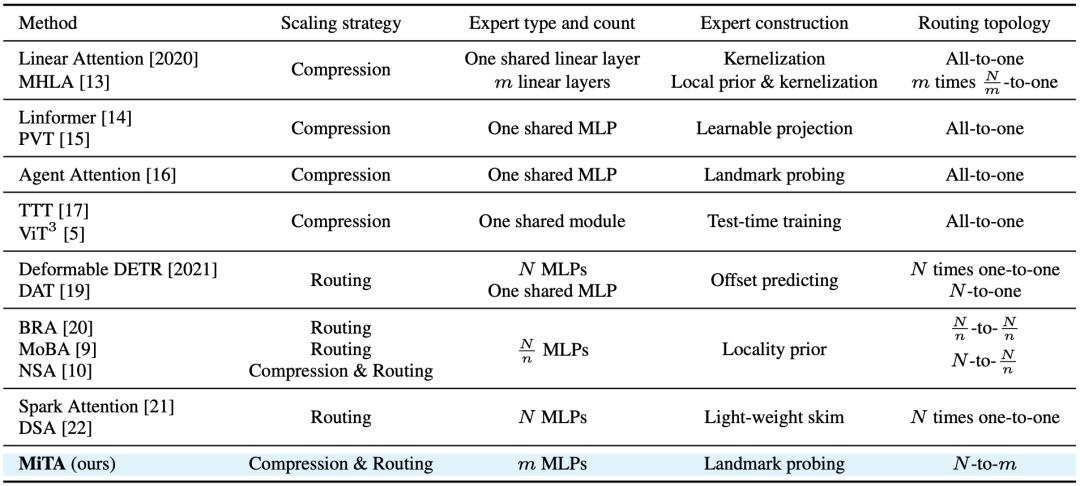
Tabelle 1: Der fünfdimensionale Klassifizierungsrahmen für effiziente Aufmerksamkeit aus der Perspektive schneller Gewichte.
Dieser Rahmen sortiert nicht nur bestehende Methoden, sondern stellt konkrete Fragen für neue Designs: Aus welchen Informationen werden Experten konstruiert? Wie viele werden benötigt? Welche Abfragen können denselben Experten wiederverwenden?
Der Ausgangspunkt von MiTA: Muss die Top-k-Menge für jede Abfrage separat ausgewählt werden?
Nehmen wir als Beispiel die blockbasierte Mixture-of-Experts-Aufmerksamkeit wie MoBA: Der übliche Ablauf lautet, die Sequenz zuerst in fortlaufende, nicht überlappende Blöcke zu schneiden, dann für jeden Block einen Routing-Vektor zu erzeugen und die Abfragen nach Bedarf auswählen zu lassen.
Das Routing kann sich mit der Abfrage ändern, aber die Grenzen der Experten sind im Voraus festgelegt. In Bildern liegen die relevanten Informationen desselben Objekts nicht unbedingt in demselben rechteckigen Block; um eine kleine Menge relevanter Inhalte abzurufen, muss die Abfrage möglicherweise den gesamten Block durchsuchen.
Die Top-k-Aufmerksamkeit geht in eine andere Richtung: Jede Abfrage wählt separat die k relevantesten Schlüssel-Wert-Paare aus, ohne an die Form fester Blöcke gebunden zu sein. Dementsprechend entsprechen N Abfragen jedoch auch N Sätzen „privater“ Mengen. Selbst wenn verschiedene Abfragen ähnliche Inhalte beachten, müssen sie die Auswahl und Organisation separat durchführen.
Kann man die Flexibilität der Top-k-Auswahl behalten und gleichzeitig die Auswahl von mehreren Abfragen wiederverwenden lassen?
MiTA dreht die Denkweise um: Statt den Inhalt der Experten im Voraus festzulegen, extrahiert man zuerst eine kleine Anzahl repräsentativer Abfragen, die dann Inhalte aus dem vollständigen Kontext auswählen, um Experten mit einstellbarer Anzahl zu bilden. Die ursprünglichen Abfragen müssen nur auswählen, welchen Experten sie besuchen wollen, statt jeweils einen eigenen globalen Top-k-Satz zu konstruieren.
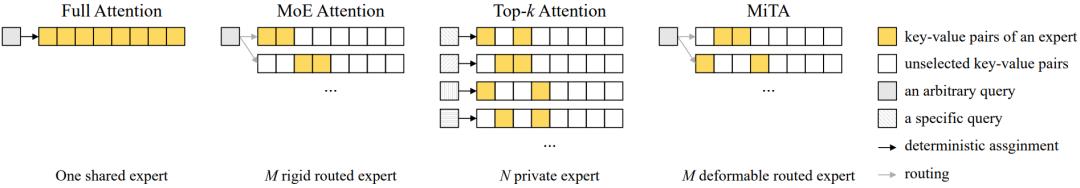
Abbildung 2: Die vollständige Aufmerksamkeit teilt alle Schlüssel-Wert-Paare, die blockbasierte MoE teilt feste Blöcke, die abfrageweise Top-k konstruiert private Mengen, und MiTA konstruiert wiederverwendbare verformbare Experten.
Konstruktion von globalen Zusammenfassungen und Detail-Experten gleichzeitig mit wenigen Landmark-Abfragen
MiTA extrahiert m Landmark-Abfragen (Landmark Queries) durch lokales Durchschnittspooling (Average Pooling). Jede Landmark untersucht die vollständige Sequenz und führt gleichzeitig die globale Informationszusammenfassung und die Abfrage von originalen Details durch.
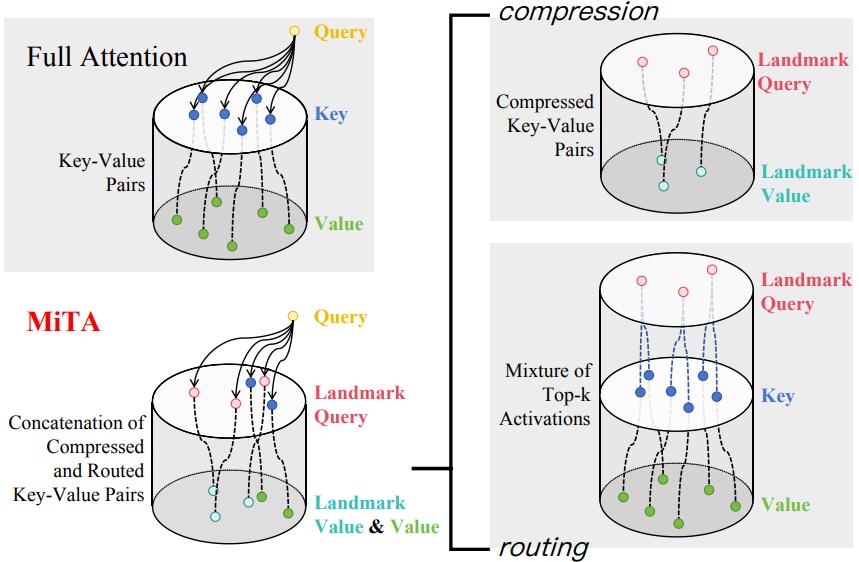
Abbildung 3: Jede Abfrage greift sowohl auf die komprimierten globalen Schlüssel-Wert-Paare als auch auf die durch Routing ausgewählten originalen Schlüssel-Wert-Paare zu.
Zuerst konstruiert man wiederverwendbare Top-k-Experten. Die i-te Landmark-Abfrage

passt zu allen Schlüsseln und wählt die k Positionen mit der höchsten Relevanz aus:
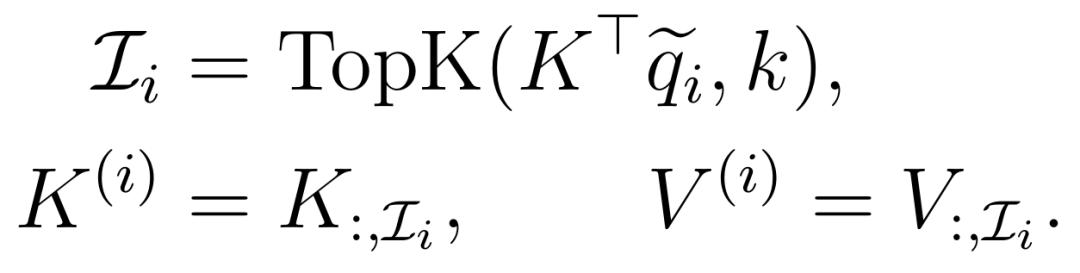
Diese Schlüssel-Wert-Paare bilden den i-ten Routing-Experten (Routed Expert), der verschiedene räumliche Positionen überqueren und seine Form mit dem Eingabeinhalt ändern kann, und verschiedene Experten dürfen sich überlappen.
Anschließend wählt die Abfrage den Experten aus, der zu der Landmark passt, die am besten zu ihr selbst passt:
