Liam Fedus, Mitschöpfer von ChatGPT: Nach der Mathematik sollte die KI ins Labor gehen.
Vor zwei Tagen veröffentlichte OpenAI auf GitHub auf einen Schlag 722 mathematische Manuskripte (einige davon wurden später zurückgezogen), die 17 Bereiche wie Zahlentheorie, Geometrie, Theoretische Informatik und Mathematische Physik abdecken. Ein Teil davon ist mit formalen Lean-Beweisen versehen, die von Computern maschinell überprüft werden können. Laut OpenAI stammen alle aus einem noch unveröffentlichten internen Spitzenmodell. Die Rechenleistung, die für jedes Ergebnis durchschnittlich verbraucht wird, entspricht etwa drei Stunden Laufzeit des Denkmodus von ChatGPT Pro.
Dies ist nicht die erste große Aktion von OpenAI im Bereich der Mathematik. Am 8. September vor einem Monat kündigte das Unternehmen an, dass sein internes Modell zehntausende Agenturen einsetzte und etwa 88 Stunden lang arbeitete, um einen Sprengbeweis im Zusammenhang mit dem Millennium-Problem von Navier-Stokes vorzulegen, woraufhin es sofort in einen Streit um Namensnennung und Priorität geriet. Nach der Veröffentlichung der 722 Manuskripte folgten ebenfalls Zweifel nacheinander.
Abgesehen von den Kontroversen wird eine Tatsache selten erwähnt: Dass Mathematik zum Wissenschaftsbereich wurde, in dem die KI am schnellsten Fortschritte macht, liegt zu einem großen Teil daran, dass sie einen eingebauten Schiedsrichter hat – nämlich ob ein Lean-Beweis korrekt ist, entscheidet der Compiler.
Sobald sich das Problem jedoch von der Papierform auf die materielle Welt verlagert, beispielsweise ob ein neues Material im Temperaturbereich von flüssigem Stickstoff Supraleitung erreichen kann oder ob eine Legierung bei hohen Temperaturen reißt, kann kein formales System ein echtes Experiment ersetzen.
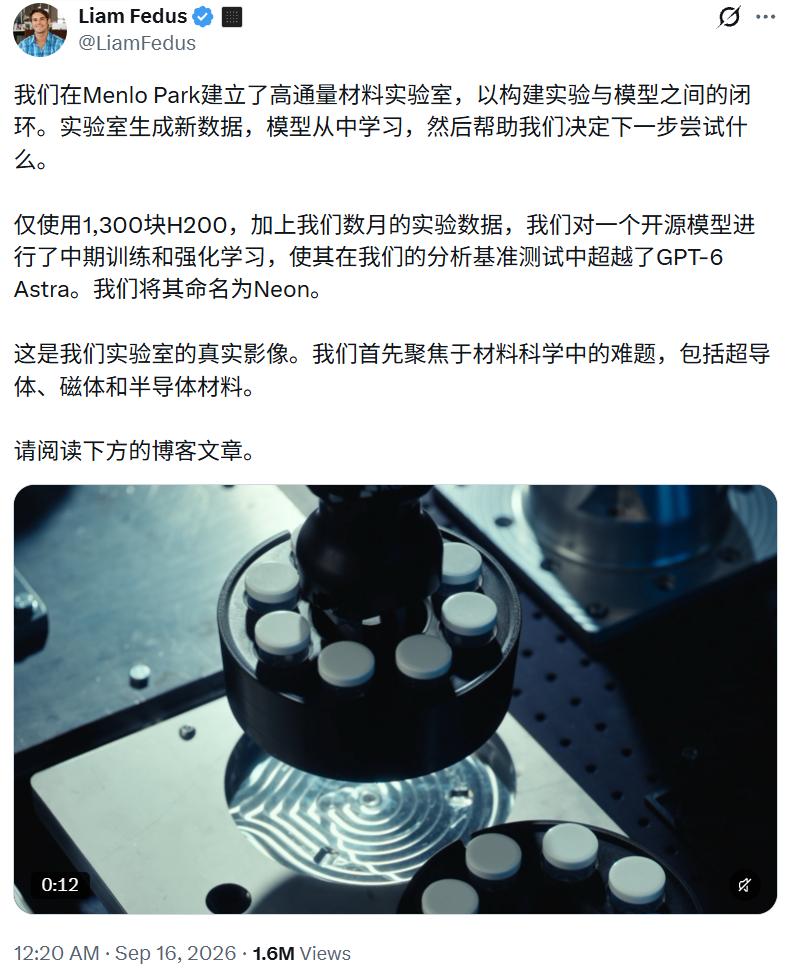
Genau dies ist der Standpunkt, den Liam Fedus in der neuesten Folge des Podcasts The Frontier betont. Der Mitbegründer von ChatGPT, ehemaliger Vizepräsident von OpenAI und Leiter des Post-Trainings, baut heute in Menlo Park ein physisches Labor, um KI-Wissenschaftlern die Datengrundlage zu ergänzen, die das Internet nicht liefern kann.
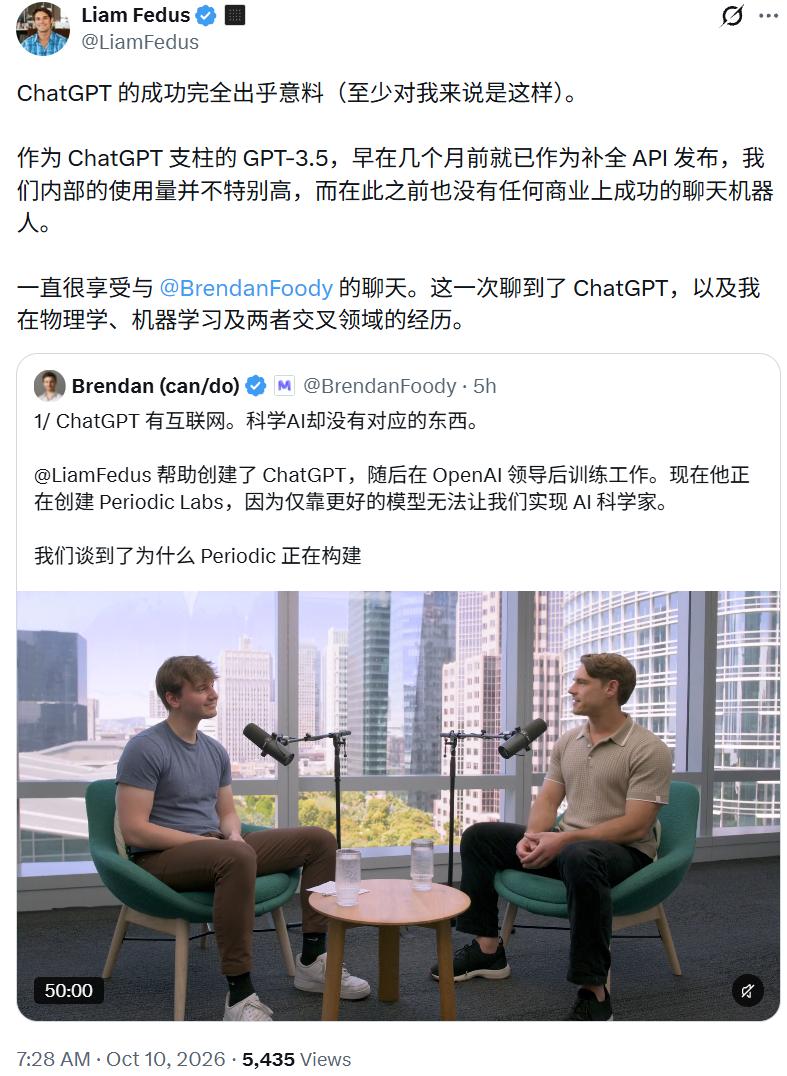
In einem 50-minütigen Gespräch mit dem Moderator und Gründer von Mercor, Brendan Foody, blickte er auf die internen Details vor und nach der Entstehung von ChatGPT zurück, erklärte, warum ChatGPT und die KI-Programmierung zuerst durchbrachen, und erläuterte, warum Periodic Labs unbedingt ein Labor aufbauen muss.
Vom ländlichen Maine zu ChatGPT: Der Umweg eines Physikers
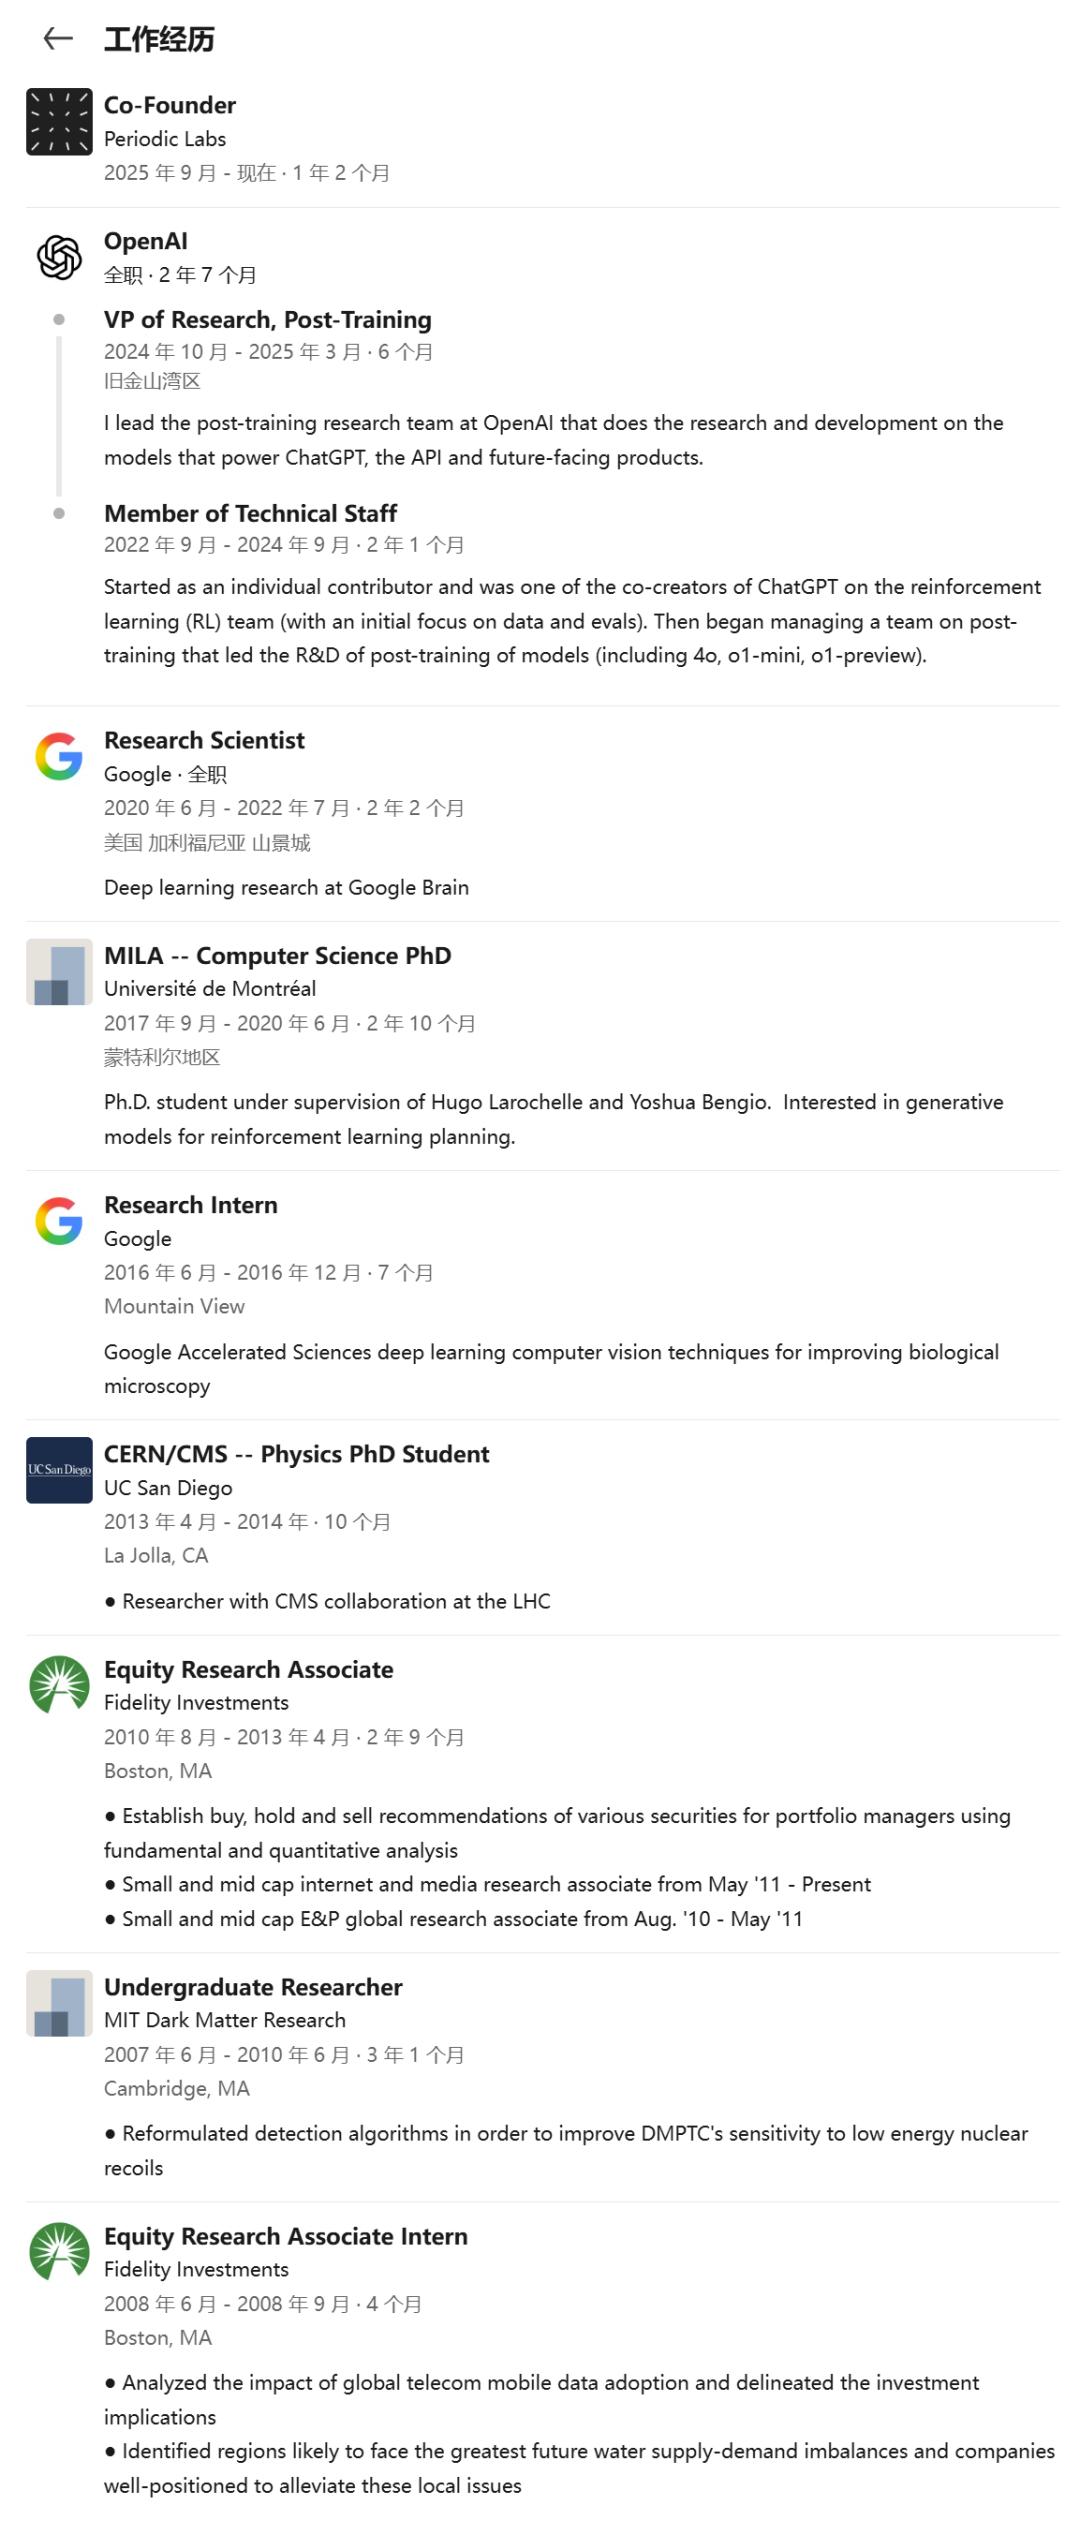
Fedus wuchs in der ländlichen Region von Maine auf. Er erinnert sich, dass es in der Schule eine Aufgabe namens „Wissenschaft in den Nachrichten“ gab, bei der die Schüler lokale Wissenschaftsnachrichten verfassen sollten. Da es in den Zeitungen auf dem Land kaum technische Fortschritte zu schreiben gab, suchte er sich Materialien im Internet aus und wurde schließlich von einer Physik-Website tief angezogen. Während seines Studiums schwankte er zwischen Physik, Chemie und Ökonomie und entschied sich schließlich für Physik, weil sie „grundlegend genug“ ist.
Während seines Physikstudiums am MIT beteiligte er sich an einem Projekt zur Erkennung dunkler Materie namens DMTPC. Nach einer der Theorien zeigt das Signal der dunklen Materie zeitliche Richtungsänderungen, und das Team hoffte, darauf basierend einen empfindlicheren Detektor zu bauen.
Genau hier stieß er zum ersten Mal auf das Problem des maschinellen Lernens: Um die Richtung und Energie von Teilchen aus den Rohdaten des Detektors abzuleiten, handelt es sich im Wesentlichen um eine Aufgabe des maschinellen Lernens. Danach arbeitete er kurzzeitig im Finanzbereich, studierte anschließend Teilchenphysik an der University of California in San Diego und beteiligte sich an der Rekonstruktion von Teilchenspuren am CERN, wo das gleiche Problem erneut auftrat. „Ich erkannte, dass ich an den Spitzeninstitutionen arbeiten muss, um die Spitze des maschinellen Lernens voranzubringen.“
Der Wendepunkt ereignete sich in der Zeit, in der die Generative Adversarial Network (GAN) populär wurde. Fedus versuchte, GAN für die Spracherzeugung zu verwenden, stellte jedoch fest, dass dies ein doppeltes Problem darstellt: Das Training von GAN selbst ist instabil und neigt zu Moduskollaps, und der Generator gibt diskrete Token aus, sodass der Gradient des Diskriminators nicht direkt zurückverteilt werden kann. Also „hat man gleichzeitig alle Probleme von GAN und alle Probleme des Verstärkungslernens“.
Aus diesem Grund schrieb er eine E-Mail an Ian Goodfellow, der damals als Forscher bei Google arbeitete. Die Antwort des Empfängers ließ ihn entschließen, sich diesem Team anzuschließen.
2016 trat er als Praktikant dem Team von Google Accelerated Sciences bei, erforschte die Replikation und Teilung von Hefezellen mit Faltungsnetzwerken, wechselte anschließend zu Google Brain und absolvierte sein Doktoratsstudium der Informatik bei Yoshua Bengio und Hugo Larochelle in Mila.
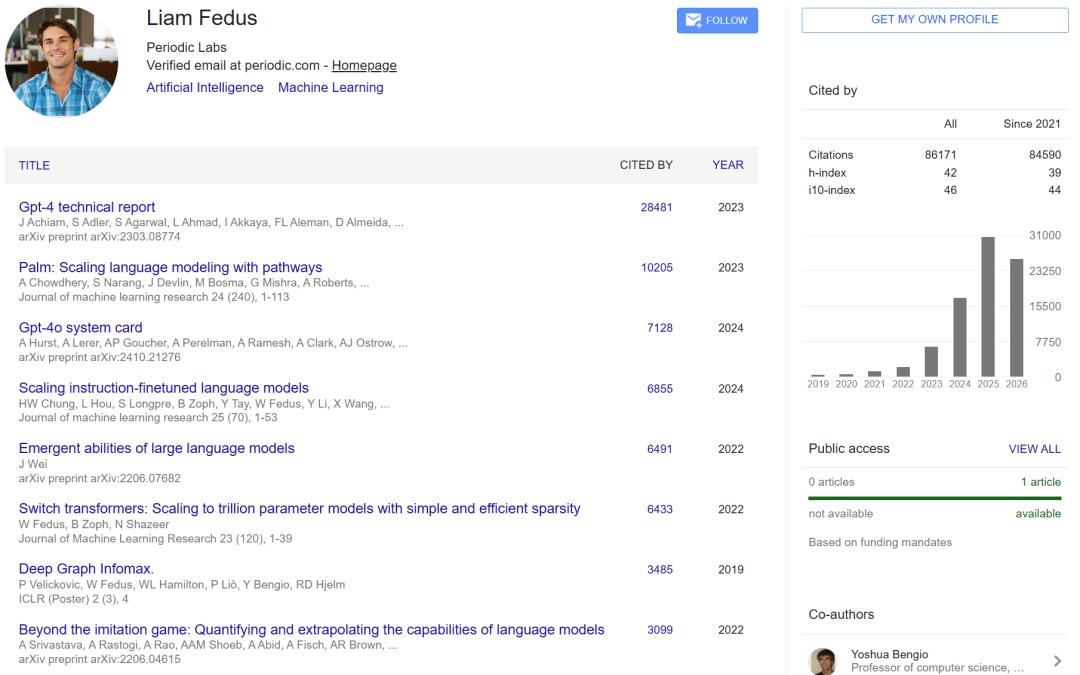
Bei Google Brain arbeitete Fedus mit Barret Zoph und Noam Shazeer zusammen, um das Switch Transformer vorzuschlagen, wodurch die Architektur des Mixture of Experts (MoE) auf einen Umfang von Billionen von Parametern gebracht wurde. Diese Arbeit wurde später zu einer wichtigen Referenz für quelloffene MoE-Modelle.
2022 trat er OpenAI bei, beteiligte sich an der Entwicklung von ChatGPT, übernahm im Oktober 2024 die Leitung des Post-Trainingsteams von Barret Zoph und verließ das Unternehmen im März 2025, um ein eigenes Startup zu gründen.
Das von ihm gegründete Periodic Labs hat einen weiteren Mitbegründer namens Ekin Dogus Cubuk. Die beiden kennen sich seit fast zehn Jahren bei Google Brain. Cubuk leitete später das Team für Chemie und Materialien bei DeepMind und ist einer der Autoren des GNoME-Papiers, das 2023 eine große Anzahl neuer stabiler Kristallstrukturen vorhersagte. 2025 trat Periodic Labs nach der Geheimhaltungsphase mit einer Seed-Runde in Höhe von 300 Millionen Dollar auf, zu den Investoren gehören a16z, DST, NVentures unter dem Dach von NVIDIA, Accel sowie persönliche Investoren wie Jeff Bezos, Eric Schmidt und Jeff Dean.
Mitte September dieses Jahres veröffentlichte Periodic das erste Modell Periodic Neon, ein Modell mit etwa 1 Billion Parametern, das auf den Daten des eigenen Labors nachtrainiert wurde und zur Interpretation von Röntgenbeugungsbildern dient. Das Unternehmen gibt an, dass es seine selbst erstellten Benchmarks über GPT-6 Astra übertrifft, aber dieses Ergebnis wird derzeit nur vom Unternehmen selbst gemeldet.
ChatGPT wäre fast zu einem Konferenzroboter geworden
Am ersten Tag, an dem Fedus zu OpenAI kam, ließ Greg Brockman die Neulinge das gerade fertig trainierte GPT-4 sehen. „Es liegt etwa anderthalb Jahre vor jedem System, das ich je gesehen habe.“ Aber er gab auch zu, dass GPT-4 immer noch Fehler macht, die andere Sprachmodelle häufig machen: Es halluziniert und kann keine Mathematikaufgaben lösen. Es war offensichtlich ein großer Fortschritt, aber niemand wusste, wie man es in etwas Wertvolles für die Welt verwandeln kann.
Etwa ein halbes Jahr vor der geplanten Veröffentlichung von GPT-4 diskutierte das Team verschiedene Produktformen, darunter Schreibroboter, Programmierroboter und Konferenzroboter, die von manchen besonders bevorzugt wurden und in Konferenzsoftware sitzen, um Notizen zu machen und Aufgaben zu verwalten. Der Moderator scherzte, dass die Welt ganz anders aussehen würde, wenn man damals wirklich einen Konferenzroboter gebaut hätte. Schließlich entschied John Schulman, der darauf bestand, die Allgemeinheit beizubehalten und einen Chatbot zu bauen.
Interessanterweise waren die frühen internen Signale nicht optimistisch. Fedus schätzt, dass etwa 90 % der Freunde und Verwandten, die Zugang zur Betaversion von GPT-4 erhielten, es nicht besonders beachteten. Als Forscher, der sich hauptsächlich mit Architekturforschung befasst, betrachtete er dies damals als negatives Signal. „Aber im Nachhinein verbirgt sich darin tatsächlich ein sehr positives Signal: 5 % bis 10 % der Leute lieben es sehr und nutzen es jeden Tag. Jedes Mal, wenn wir ein Update veröffentlichen, beschweren sie sich ‚Ich mag die vorherige Version des Modells lieber‘.“
Noch überraschender ist, dass das weltweit berühmte ChatGPT nicht einmal GPT-4 verwendete, sondern GPT-3.5, das bereits seit Monaten als API veröffentlicht wurde. Die echte Variable war die Produktform: von der „Vervollständigungs“-Schnittstelle zur „Konversations“-Schnittstelle.
Fedus gab ein Beispiel: Im Vervollständigungsmodus muss man, um das Modell dazu zu bringen, ein Gedicht in einem bestimmten Stil zu schreiben, zuerst einen Text wie „Ein verlorenes Gedicht eines berühmten Schriftstellers wurde kürzlich entdeckt, es beginnt wie folgt:“ verfassen. Im Gesprächsmodus reicht es einfach zu sagen „Bitte schreibe mir ein Gedicht in diesem Stil“. „Das ist eine Kleinigkeit, aber es ist sehr natürlich.“ Darüber hinaus wurde eine Menge langweiliger Detailarbeit im Bereich des überwachten Fine-Tunings und des RLHF geleistet. „Alles läuft letztendlich auf Daten zurück, wir haben die ganze Zeit die Daten beobachtet.“
Bei der internen Abstimmung zur Vorhersage der Nutzerzahl von ChatGPT rieten die meisten zu 10.000 oder 50.000, die Mutigsten rieten zu 1 Million. „Wir wollten nur eine bescheidene Forschungsvorschau machen, einen Blogbeitrag veröffentlichen und vielleicht 10.000 Forscher es ausprobieren lassen.“ Das Ergebnis war ein Chaos, „alle Anzeigedioden leuchteten rot“. Im Sommer 2023 ging die Nutzung zurück, das Team geriet kurzzeitig in eine „Existenzkrise“ und fürchtete, dass die Popularität von ChatGPT enden würde, bis es später herausfand: Die Schüler hatten einfach Sommerferien.
Wenn man zu nah an der Technologie ist, sieht man nur ihre Mängel
In der späten Phase bei OpenAI leitete Fedus das Post-Trainingsteam. Eine der Arbeiten, auf die er am meisten stolz ist, ist die Einführung von Inferenzmodellen in die Gesprächsszene.
Inferenzmodelle sind gut in Mathematik und Programmierung, aber es ist nicht einfach, sie für den täglichen Gesprächsgebrauch geeignet zu machen. „Wenn man nur fragt ‚Wie geht es dir?‘ und das Modell drei Minuten lang nachdenkt, ist das offensichtlich keine gute Benutzererfahrung.“ Das Team musste die dynamischen Grenzen des Denkens erfassen und verschiedene Inferenzstrategien für verschiedene Bereiche entwerfen – die Art, wie man Mathematikaufgaben löst, unterscheidet sich völlig von der Art, wie man einen Artikel entwirft.
Eine weitere Arbeit, die ihn zufriedenstellte, ist das Datenrad: Wie man das Benutzerfeedback nutzt, um das System kontinuierlich zu verbessern. Er stimmt der konsequenten Philosophie von OpenAI zur iterativen Bereitstellung sehr zu, nämlich so schnell wie möglich mit der realen Welt in Kontakt zu treten und den Zyklus so schnell wie möglich zu schließen, „damit sich die Welt schrittweise an das Kommende anpassen kann, während man herausfindet, wo das System Fehler macht“. Seiner Meinung nach ist es eine wichtige Errungenschaft des Teams, auf der Grundlage des Benutzerfeedbacks vorhersehbare Skalierungsgesetze aufzubauen.
Als er nach seinem ersten Eindruck von GPT-4 gefragt wurde, sagte Fedus einen Satz, der sehr typisch für einen Forscher ist: „Wenn man zu nah an der Technologie ist, sieht man nur noch ihre Mängel.“ Forscher freuen sich nicht darüber, dass das Modell 80 % der Fragen richtig beantwortet, sondern konzentrieren sich auf die Bewertung und fragen, warum es eine bestimmte Mathematikaufgabe nicht lösen kann und warum es den Anweisungen nicht folgen kann, um zusammenzufassen. Früher behielt jeder einige private „Gefühlstest“-Fragen für sich. Er selbst hatte eine Frage zur Quantenmechanik, die alle vorherigen Modelle sehr schlecht beantworteten, bis das Inferenzmodell erschien und es zum ersten Mal richtig beantwortete. „Ich war wirklich beeindruckt, es zeigte sehr interessante Eigenschaften wie Selbstkorrektur.“
Warum Chat und Programmierung zuerst durchbrachen
Der Moderator stellte eine Schlüsselfrage: In den letzten Jahren gab es zwei echte Durchbrüche, einer war ChatGPT, der andere die KI-Programmierung.
Warum genau diese beiden Bereiche? Was fehlt noch, damit die physische Welt einen ähnlichen Durchbruch erlebt?
Fedus antwortete, dass ChatGPT auf einem ausreichend starken vortrainierten Grundgerüst und RLHF ber