MIT: Wie weit kann dieser Weg gehen, auf dem KI durch Interviews dazu gebracht wird, reale Menschen zu simulieren?
Kann ein großes Sprachmodell zu dem „digitalen Double“ einer Person werden, solange man lange genug mit ihr spricht?
Ausgehend von virtuellen Nutzern und synthetischen Befragten bis hin zu personalisierten KI-Agenten zeichnet sich ein immer beliebterer technischer Ansatz ab: Zuerst lernt man eine reale Person durch Interviews, Fragebögen und persönliche Daten kennen, dann lässt man das große Sprachmodell diese Person nachahmen und vorhersagen, wie sie auf unbekannte Fragen antworten würde.
Dabei stellt sich eine schwierigere Frage: Selbst wenn die KI bereits gelernt hat, wie du heute denkst – kann sie in einer neuen, noch nie gestellten Situation immer noch so antworten wie du?
Um dies zu überprüfen, haben Forscher des MIT und anderer Institutionen HugAgent vorgeschlagen. Es lässt große Sprachmodelle anhand von Interviews mit echten Teilnehmern deren Antworten in neuen Situationen wie der allgemeinen Gesundheitsversorgung, der öffentlichen Überwachung und der Verdichtung des Wohnraums vorhersagen. Die Studie umfasste 54 Teilnehmer, 1.742 Bewertungsaufgaben und testete Modelle wie GPT, Claude, Gemini, DeepSeek, Llama und Qwen. Das zugehörige Paper wurde als EMNLP 2026 Main Oral angenommen.
Link zum Paper: https://arxiv.org/abs/2510.15144
Link zum Code: https://github.com/jajamoa/HugAgent
Projektseite: https://jajamoa.github.io/HugAgent/
Die Studie ergab, dass persönliche Interviews dem Modell tatsächlich helfen, eine bestimmte Person genauer zu simulieren. Doch ein auffälligeres Phänomen zeigt sich: Je länger man mit einer Person spricht, desto besser versteht die KI, wie sie aktuell denkt – aber sie weiß nicht unbedingt besser, wie sie antworten wird, wenn sich die Rahmenbedingungen ändern.
Das wirft eine grundlegendere Frage für „digitale Doubles“ auf: Baut die KI tatsächlich ein Modell von dir auf – oder erstellt sie nur ein immer detaillierteres persönliches Profil?
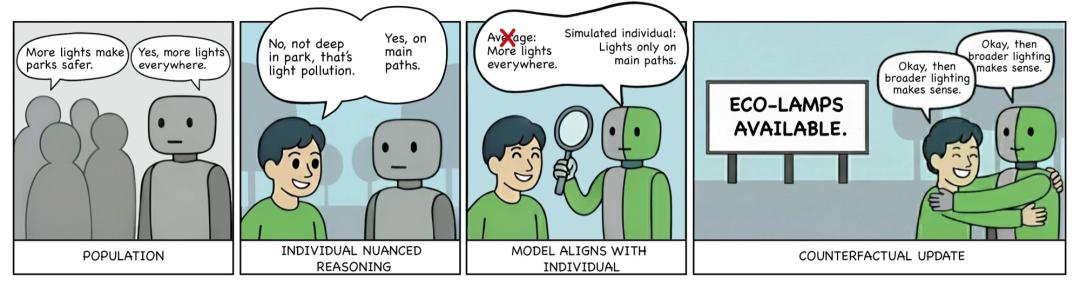
Von „wie ein gewöhnlicher Mensch“ zu „wie genau diese bestimmte Person“. HugAgent stellt die weiterführende Frage: Kann die KI diese Person auch dann noch vertreten, wenn sich die Bedingungen ändern?
Warum HugAgent benötigt wird
Von „wie ein Mensch“ zu „wie genau dieser Mensch“
In den letzten Jahren ist die Simulation von Menschen durch große Sprachmodelle allmählich zu einem echten Forschungsansatz geworden. Forscher lassen LLMs die Rolle von Verbrauchern, Wählern und Versuchspersonen übernehmen. Darüber hinaus beginnen sie, einzelne reale Personen zu simulieren: Sie erstellen „digitale Doubles“ durch lange Interviews, Fragebögen und persönliche Daten, und lassen die KI die betreffende Person bei neuen Fragen später vertreten.
Dieser Ansatz klingt naheliegend: Je mehr Informationen eine Person der KI mitteilt, desto besser versteht die KI sie – und desto genauer sollte sie ihre Antworten vorhersagen können.
Dabei gibt es einen entscheidenden Sprung:
Eine Person zu beschreiben, ist nicht dasselbe, wie eine Person vorherzusagen.
Nehmen wir an, eine Person gibt in einem Interview an, dass sie die allgemeine Gesundheitsversorgung unterstützt, aber gleichzeitig Bedenken hinsichtlich Kosten, Effizienz und persönlicher Wahlfreiheit hat. Das Modell kann ihre aktuelle Position möglicherweise bereits genau bestimmen.
Aber was, wenn sich die Bedingungen ändern?
Wenn das neue Konzept ihrer Familie jährlich 3000 US-Dollar einspart oder die private Versicherung weiterhin erhalten bleibt – würde sie dann noch dieselbe Wahl treffen?
An diesem Punkt muss das Modell nicht nur merken, dass „sie die allgemeine Gesundheitsversorgung unterstützt“, sondern aus früheren Äußerungen ableiten, was ihr wirklich wichtig ist – und wie sie unterschiedliche Bedingungen neu abwägt, wenn sich diese ändern.
Genau das ist die Frage, die HugAgent untersuchen will:
Wenn wir durch Interviews ein ausreichend detailliertes Persona erstellen – kann es dann vorhersagen, wie diese Person außerhalb des Interviews antworten würde?
Das ist eine unumgängliche Frage, wenn man von „wie ein Mensch“ zu „wie genau dieser Mensch“ übergeht.
HugAgent zeichnet nicht nur Antworten auf
Es fragt auch nach dem „Warum“
Um zu überprüfen, ob die KI „eine bestimmte Person“ simulieren kann, muss man zuerst wissen, was diese Person selbst wirklich denkt.
Deshalb greift HugAgent nicht auf öffentliche Personenprofile oder Online-Texte zurück, sondern rekrutiert echte Teilnehmer. Das Team wählte drei Themen aus, in denen es in den USA deutliche Meinungsunterschiede gibt und die echte Wertentscheidungen beinhalten: die allgemeine Gesundheitsversorgung, die öffentliche Überwachung und die Wohnraumverdichtung – also die Lockerung von Zonenbeschränkungen, um höhere und dichtere Wohngebäude zu ermöglichen. Nach einer Qualitätsfilterung von über 120 Rekruten blieben schließlich 54 Teilnehmer übrig.
Schritt 1: Fragebogen, um „das heutige Du“ festzuhalten.
Die Teilnehmer füllen zuerst demografische Angaben aus und bewerten dann die Unterstützung für verschiedene Themen auf einer Skala von 1 bis 10. Gleichzeitig geben sie an, wie stark eine Reihe von Argumenten ihre eigene Position beeinflusst.
Zum Beispiel kann eine Person, die gegen die Wohnraumverdichtung ist, am meisten das Ortsbild und den Immobilienwert fürchten, während eine andere vor allem Verkehr, Mieten oder Wohnraumversorgung im Blick hat. Das endgültige „dafür oder dagegen“ ist nur eine Antwort – was verschiedene Personen wirklich unterscheidet, sind oft die Gründe hinter der Antwort und ihre jeweilige Bedeutung.
Diese Informationen zusammen bilden den aktuellen „Belief State“ (Überzeugungszustand) einer Person: also welche Position sie heute vertritt und welche Gründe diese Position stützen.
Schritt 2: Bedingungen ändern, um festzuhalten „Was wäre, wenn…“.
Anschließend ändert der Fragebogen eine der Bedingungen.
Was, wenn die lokalen Mieten nach der Wohnraumverdichtung um 10 % bis 15 % sinken? Was, wenn die allgemeine Gesundheitsversorgung einer Familie jährlich 3000 US-Dollar einspart? Was, wenn die Aufnahmen der öffentlichen Überwachung nur 48 Stunden gespeichert werden?
Die Teilnehmer müssen in jeder neuen hypothetischen Situation ihre Position neu angeben und erneut die Bedeutung der zugehörigen Argumente bewerten.
Auf diese Weise weiß das Forschungsteam nicht nur, „wie eine Person heute denkt“, sondern zeichnet auch auf, wie sie selbst antworten würde, wenn sich eine bestimmte Bedingung ändert. Die Veränderung zwischen den beiden Zuständen bildet das „Belief Update“ (Überzeugungsaktualisierung), das HugAgent vorhersagen soll.
Noch wichtiger ist: Diese Antworten stammen von den Teilnehmern selbst. Wenn das Modell später die Prüfung ablegt, sieht es die richtige Antwort für die Zielsituation nicht direkt.
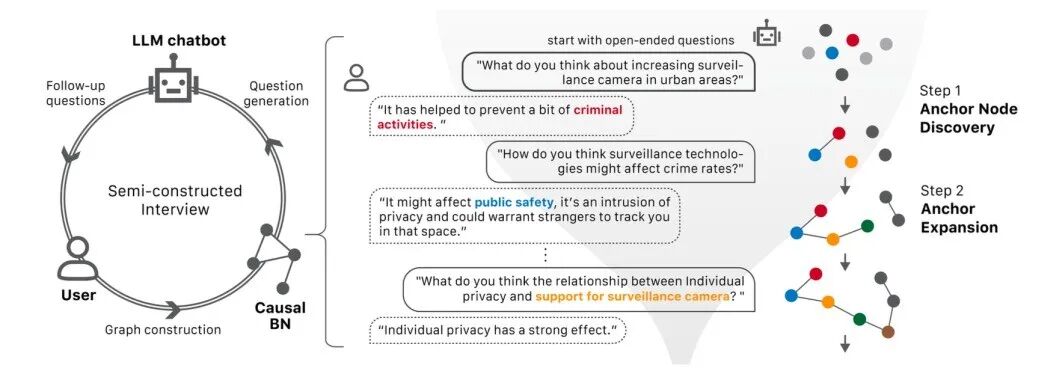
Bildunterschrift: Der Interviewprozess von TraceYourThinking. Das System beginnt mit offenen Fragen, erstellt dynamisch einen kausalen Überzeugungsgraphen basierend auf den Antworten der Teilnehmer und generiert automatisch die nächste Folgefrage, um schrittweise die Beziehungen zwischen den Ansichten, Gründen und verschiedenen Faktoren einer Person zu verstehen.
Schritt 3: Think-Aloud-Interview, um das „Warum“ schrittweise herauszufinden.
Das Aufzeichnen von Fragebogenantworten reicht nicht aus.
Die Teilnehmer nehmen anschließend über den quelloffenen Chatbot des Teams TraceYourThinking an einem halbstrukturierten Think-Aloud-Interview (Verbalisieren des Denkprozesses) teil – sie können tippen oder direkt sprechen und dabei die Gründe für ihre Urteile aussprechen, während sie nachdenken.
Das ist keine durchgehend feststehende Frageliste.
Der Roboter erstellt anhand der vorherigen Äußerungen des Teilnehmers dynamisch seinen „kausalen Überzeugungsgraphen“: Welche Faktoren er nennt, in welche Richtung diese die Position verändern und wie stark ihr Einfluss ist. Basierend auf diesen Informationen generiert das System automatisch die nächste Folgefrage, um Punkte nachzugehen, die noch unklar sind, Widersprüche enthalten oder sich weiter vertiefen lassen.
Wenn eine Person beispielsweise angibt, dass sie die Kosten einer bestimmten Politik fürchtet, kann der Roboter weiterfragen: Wenn die Kosten sinken – in welchem Maße würde das deine Einstellung ändern? Wenn sie sagt „Ich bin mir da nicht sicher“, verfolgt das System auch diese Unsicherheit weiter.
„Ich bin mir nicht sicher“ ist selbst eine Information.
Das kann bedeuten, dass die Position der Person nicht fest verankert ist – oder dass zwei Werte miteinander konkurrieren. Im Vergleich zu einer einfachen Bewertung von 1 bis 10 hinterlässt das Think-Aloud-Interview viel reichere Hinweise: Was diese Person wichtig findet, warum sie es wichtig findet, welche Urteile sicher sind und wo sie noch zögert.
Am Ende erhält das Modell die Hintergrundinformationen zu dieser Person und das Interview – nicht die tatsächliche Antwort der Person für die Zielsituation.
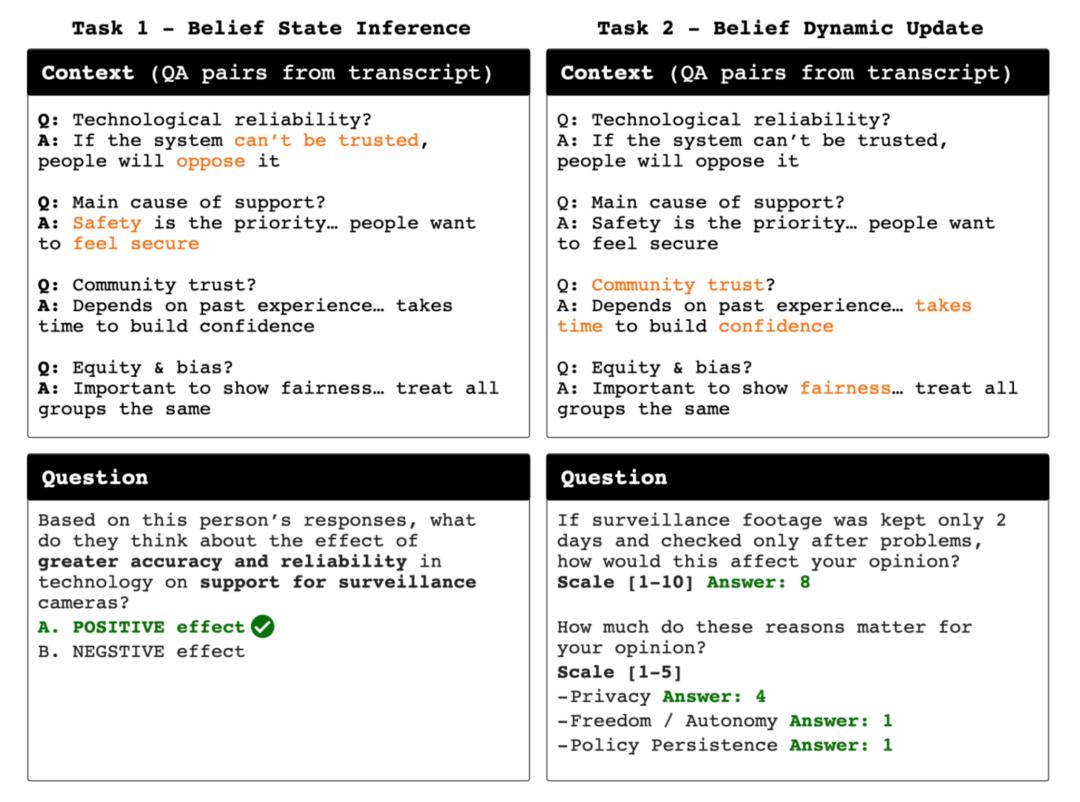
Bildunterschrift: Die zwei Arten von Bewertungsaufgaben von HugAgent. Belief State Inference leitet die aktuellen Überzeugungen einer Person aus dem Interview ab; Belief Dynamics Update fügt neue hypothetische Situationen hinzu und sagt voraus, wie sich Position und Gründe derselben Person verändern werden.
HugAgent wandelt diese Materialien in zwei Arten von Prüfungen um.
Die erste Art ist Belief State Inference mit insgesamt 356 Aufgaben, die testet, ob das Modell aus dem Interview die aktuellen, nicht direkt ausgesprochenen Überzeugungen der Person ableiten kann.
Die zweite Art ist Belief Dynamics Update mit insgesamt 1386 Aufgaben, die testet, ob das Modell nach Angabe einer neuen hypothetischen Situation die neue Position und die Gewichtung der Gründe der Person vorhersagen kann.
Das gesamte Benchmark umfasst 1742 Bewertungsaufgaben.
Um eine empirische Obergrenze für die Aufgaben festzulegen, lud das Team einige Teilnehmer 14 Tage später ein, dieselben Fragen erneut zu beantworten. Die Übereinstimmung der Antworten der Teilnehmer mit ihren eigenen Antworten von zwei Wochen zuvor betrug 84,84 % bzw. 85,66 % bei den beiden Aufgaben – dies wurde als empirische Obergrenze (Ceiling) für den späteren Modellvergleich verwendet.
An diesem Punkt wird eine ursprünglich sehr abstrakte Frage endlich direkt messbar:
Wenn man immer mehr mit einer Person spricht – wird ihr „digitales Double“ dann immer besser darin, ihre Antworten vorherzusagen?
Kernresultat: Es ist einfach, „das heutige Du“ zu verstehen – aber schwierig, wenn sich die Bedingungen ändern
Das offensichtlichste Ergebnis von HugAgent ist, dass die Leistung der Modelle bei den beiden Aufgaben deutlich auseinanderfällt.
Bei der Belief State Inference (Überzeugungszustandsableitung) erreicht die beste Methode eine Genauigkeit von 77,56 %, GPT-4o liegt bei 74,66 %. Die Selbstübereinstimmung der Teilnehmer bei der erneuten Beantwortung derselben Fragen nach 14 Tagen beträgt 84,84 % – das Paper verwendet diesen Wert als empirische Obergrenze für diese Aufgabe.
Bei der Belief Dynamics Update (dynamische Überzeugungsaktualisierung) erreicht das beste Modell Claude Sonnet 4.5 68,61 %, LLaMA 3.3 70B 67,57 %, GPT-4o 63,11 %; die entsprechende empirische Obergrenze liegt bei 85,66 %.
Das bedeutet: Unter den jeweiligen Bewertungsbedingungen sind große Sprachmodelle bereits relativ gut darin, aus Interviews nachzuvollziehen, „wie eine Person heute denkt“ – aber bei neuen, noch nie beantworteten Situationen gibt es noch einen deutlichen Abstand zu den tatsächlichen Antworten der Teilnehmer selbst.
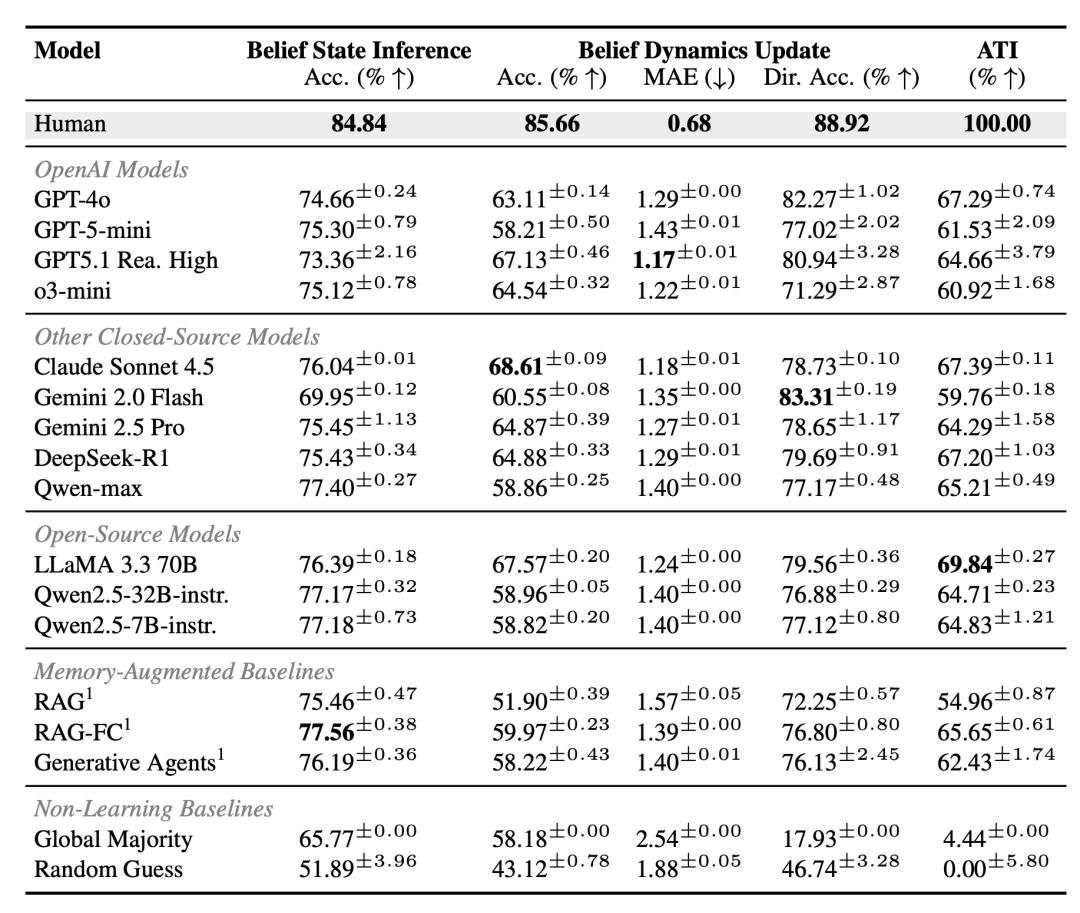
Bildunterschrift: Die Gesamtleistung verschiedener Modelle bei den zwei HugAgent-Aufgaben. Im Vergleich zur Ableitung der aktuellen Überzeugungen einer Person besteht bei der Vorhersage von Antworten in neuen Situationen noch ein deutlich größerer Abstand zur Obergrenze der Selbstübereinstimmung der Teilnehmer.
Das bedeutet aber nicht, dass sich Antworten in neuen Situationen überhaupt nicht aus Interviews vorhersagen lassen.
Nehmen wir GPT-4o als Beispiel: Ohne persönliches Interview und nur anhand demografischer Angaben liegt die Genauigkeit bei Belief Dynamics Update nur bei 39,83 %; nach Hinzufügen des vollständigen Interviews der Person steigt sie auf 63,11 %.
Bei Qwen2.5-32B zeigt sich eine ähnliche Veränderung: Die Genauigkeit steigt von 32,12 % auf 58,96 %.
Das bedeutet: Das Interview fügt dem Modell nicht