Je günstiger die Token sind, desto teurer ist die Rechnung. Die KI-Budgets der USA sind in drei Schichten aufgespalten – warum strömen sie alle gemeinsam zu chinesischen Modellen?
Unter dem Kostendruck von Token entwickeln sich die KI-Budgets amerikanischer Unternehmen allmählich zu einer dreistufigen Struktur.
Auf der ersten Ebene bauen Konzerne eigene Ersatzprodukte auf, auf der zweiten Ebene kürzen mittelständische Unternehmen ihre Budgets oder stufen ihre Anforderungen herab, und auf der dritten Ebene wenden sich kleine und mittlere Unternehmen direkt den quelloffenen chinesischen Gewichtungsmodellen zu. Hinter dieser Welle der Schichtung verlieren amerikanische Spitzenlabore wie OpenAI und Anthropic beide Enden des Marktes: Die größten Unternehmenskunden entwickeln ihre eigenen Tools, und die kleinsten Unternehmenskunden strömen zu chinesischen KI-Modellen.
Zu Beginn dieses Jahres war im Silicon Valley noch ein Begriff populär: TokenMaxxing – je mehr Token man verbraucht, desto höher ist die Produktivität, und das Budget sei schließlich dazu da, verbraucht zu werden. Dieser große Vorstoß bei den Token dauerte jedoch nur ein halbes Jahr, die Situation hat sich inzwischen vollständig gewandelt, und niemand erwähnt TokenMaxxing mehr. Als die Rechnungen fällig wurden, haben Unternehmen unterschiedlicher Größe völlig unterschiedliche Gegenmaßnahmen ergriffen. Dadurch hat sich der KI-Einkauf amerikanischer Unternehmen klar in drei Ebenen aufgeteilt, was chinesischen KI-Produkten einen eindeutigen Marktraum eröffnet.
Aktuelle Situation: Token sind günstiger geworden, aber man kann sie sich nicht mehr leisten, sie zu verbrauchen
Die auffälligste Zahl stammt von Uber. Ausländischen Medienberichten zufolge ist das gesamte KI-Programmierbudget von Uber für das Jahr 2026 in weniger als vier Monaten aufgebraucht worden. Der Verbrauch war so hoch, weil die Mitarbeiter auf Anweisung von Uber aktiv KI nutzten. Im März dieses Jahres stieg die Durchdringungsrate von Claude Code im 5.000-köpfigen Ingenieursteam von Uber von 32 % auf 84 %, wobei ein einzelner Ingenieur monatlich zwischen 500 und 2.000 US-Dollar für Token ausgab.
Ein extremeres Beispiel ist das Agenten-Framework OpenClaw, das hinter dem Hype um die Garnelenzucht steht. Schätzungen zufolge kann eine einzelne Instanz, die einen ganzen Tag lang autonom läuft, API-Kosten verbrauchen, die 1.000 bis 5.000 US-Dollar entsprechen, während die Nutzer dafür nur 200 US-Dollar pro Monat für das Claude-Max-Paket zahlen; Anfang April dieses Jahres gab es bereits mehr als 135.000 laufende OpenClaw-Instanzen. Anthropic hat daher Anfang April diesen Weg schnell blockiert und verlangt, dass die Nutzung solcher Drittanbieter-Frameworks separat abgerechnet wird, wodurch die Ausgaben einiger Nutzer um das Zehn- oder sogar Dutzendfache gestiegen sind.
Sechzehn Tage später stoppte GitHub die Neuregistrierung für Copilot Pro und Pro+, und der Produktvizepräsident Joe Binder nannte einen ebenso einfachen Grund: Der Rechenaufwand, der von Agenten-Workflows verbraucht wird, übersteigt oft die Kosten, die Nutzer für einen Monat zahlen, und die Kosten weniger Anfragen können den Preis des Pakets übersteigen.
Hier gibt es einen Trend, der weit verbreitet falsch interpretiert wird. Einerseits sinkt der Stückpreis von Token tatsächlich und fällt etwa alle 18 Monate um eine Größenordnung, andererseits steigt der Token-Verbrauch pro Aufgabe schneller, als der Preis fällt. Daraus ergibt sich ein für viele überraschendes Ergebnis: Je günstiger das Modell ist, desto teurer wird die Rechnung.
Gartner erwartet, dass die globalen KI-Ausgaben in diesem Jahr 2,5 Billionen US-Dollar erreichen werden, was einem Anstieg von 69 % gegenüber dem Vorjahr entspricht; gleichzeitig gehen sie jedoch davon aus, dass 25 % des KI-Budgets von 2026 in das Jahr 2027 verschoben werden. „Herabstufung“ ist die anständige Bezeichnung für Budgetkürzungen. Andererseits prognostiziert Gartner auch, dass nur 28 % der KI-Infrastrukturprojekte die ursprünglichen wirtschaftlichen Argumente vollständig umsetzen. Mit anderen Worten: Fast drei Viertel des verbrauchten Geldes konnten nicht beweisen, dass es sich lohnt, ausgegeben zu werden.
Erste Ebene: Konzerne versorgen sich selbst
Auf der ersten Ebene stehen KI-Giganten, die in der Lage sind, eigene Modelle zu entwickeln. Für sie lassen sich Kosteneinsparungen und die Förderung eigener Produkte gleichzeitig erreichen.
Nachdem Microsoft Claude Code ersetzt hat, hat es seine Ingenieure dazu gebracht, das selbst entwickelte MAI-Code-1-Flash zu nutzen. Dies ist ein kleines Modell mit etwa 5 Milliarden Parametern, das auf der diesjährigen Build-Konferenz vorgestellt und auf alle GitHub-Copilot-Pakete ausgerollt wurde; die Nachfolgeversion MAI-Code-1.1-Flash verspricht sogar eine weitere Kostensenkung um 73 %.
Hinter diesen Maßnahmen hat Microsoft Berichten zufolge die Budgetprognose für die interne Nutzung von Anthropic um mehr als ein Drittel gekürzt, während die vorherige Schätzung mindestens 1 Milliarde US-Dollar pro Jahr betrug.
Die Position von Microsoft in dieser Angelegenheit ist eigentlich ziemlich heikel. Im November 2025 haben sie gemeinsam mit Nvidia 15 Milliarden US-Dollar in Anthropic investiert, die Bewertung des Unternehmens auf 350 Milliarden US-Dollar gebracht und Claude auf Azure zum Verkauf angeboten. Die Investition in Anthropic und die Kürzung des internen Budgets für Claude stehen jedoch nicht im Widerspruch zueinander. Für Microsoft ist Claude eine Ware, während MAI das eigene Fundament ist.
Meta war der KI-Gigant, der früher am verrücktesten auf TokenMaxxing gesetzt hat, und hat sogar die Token-Nutzung als Bewertungsindikator verwendet. Unter dem Druck der Leistungsbewertung haben ihre Mitarbeiter innerhalb von 30 Tagen 60,2 Billionen Token über Tools von Anthropic verbraucht. Auf dem Höhepunkt schätzte Meta intern, dass es 10 Milliarden US-Dollar pro Jahr für die Modelle von Anthropic ausgeben würde.
Aber seit Ende Juni beschränken sie ihre Mitarbeiter darauf, Claude Code und OpenAIs Codex zu nutzen, wobei die KI-Anwendungsgruppe am strengsten eingeschränkt ist und einige Aufgaben sogar einen Genehmigungsprozess durchlaufen müssen. Ihre Ersatzprodukte sind MetaCode und Muse Code. Medienberichten zufolge ist die Anzahl der Claude-Nutzer bei Meta intern von etwa 60.000 auf 30.000 gesunken, was aus den Schätzungen des externen Token-Verbrauchs und der Ausgaben abgeleitet wird.
Selbst nach der Kürzung belaufen sich die monatlichen Ausgaben von Meta für Claude Berichten zufolge noch auf mehrere hundert Millionen US-Dollar. Ein weiterer Grund, warum Meta die Nutzung von Claude einschränkt, ist die Modelldestillation: Wenn der mit Claude geschriebene Code in die eigenen Trainingsdaten gelangt, kann das Modell von Meta die Merkmale des Konkurrenzmodells aufnehmen.
Zweite Ebene: Mittelständische Unternehmen können nur Budgets kürzen
Auf der zweiten Ebene stehen mittelständische Unternehmen wie Uber: Mit Tausenden von Ingenieuren haben sie Rechnungen in der gleichen Größenordnung wie Konzerne, besitzen aber keine eigenen Spitzenmodelle, auf die sie wechseln können. Der CTO von Uber, Praveen Neppalli Naga, gab im April dieses Jahres offen zu: Nachdem das Unternehmen Claude Code an etwa 5.000 Ingenieure verteilt hatte, war das gesamte jährliche KI-Budget in nur vier Monaten aufgebraucht, was ihn unvorbereitet traf.
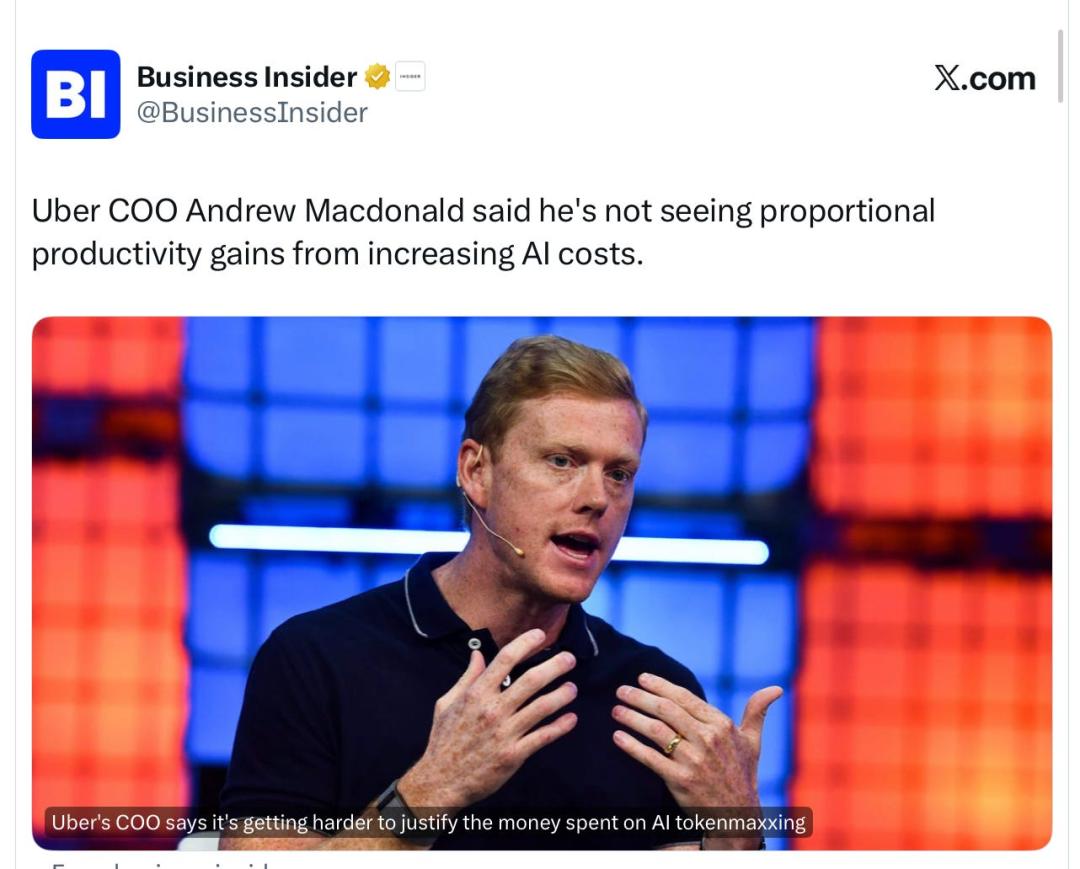
Die oberste Leitung von Uber wollte ursprünglich KI-Tools bei den Ingenieuren verbreiten – aus dieser Perspektive haben sie ihr Ziel erreicht. Statistiken vom Mai dieses Jahres zeigen, dass 95 % der Ingenieure von Uber monatlich KI-Tools nutzen. Die oberste Leitung hat jedoch die andere Seite nicht berücksichtigt: Die API-Kosten, die ein einzelner Ingenieur monatlich verursacht, betragen bis zu 500 bis 2.000 US-Dollar.
Angesichts der verblüffend hohen Token-Budgets müssen selbst große Unternehmen wie Uber mit einem Marktwert von 150 Milliarden US-Dollar dringend strenge hierarchische Verwaltungsregeln festlegen, um den Nutzungsverkehr der Mitarbeiter zu beschränken und die Kosten für jedes einzelne Token so sorgfältig zu kalkulieren, wie man früher Papier sparte.
Dies ist bereits ein allgemeiner Konsens in der Branche. Aaron Levie, CEO des Cloud-Dienstleisters Box, erklärte, dass er an einem Abendessen mit den Chief Information Officers von Fortune-500-Unternehmen teilgenommen habe und festgestellt habe, dass das Thema, über das die Wirtschaftsführer am meisten diskutierten, keine makroökonomischen Fragen waren, sondern die Token-Kosten ihrer Unternehmen.
Levie listete fünf Methoden auf, mit denen CIOs derzeit versuchen, Budgets zu kürzen: Aufgaben je nach Arbeitslast verschiedenen Modellen zuzuweisen, Agenten mit unterschiedlicher Leistungsfähigkeit je nach Benutzertyp auszugeben, verschiedenen Teams unterschiedliche Ausgabenobergrenzen zu setzen, von den Teams zu verlangen, die Notwendigkeit von KI je nach Nutzungsszenario zu begründen, und einige lassen es ganz laufen.
Nachdem diese Ebene an ihre Grenzen gestoßen ist, gibt es eigentlich nur drei Optionen: Die Anzahl der Nutzerlizenzen kürzen, auf günstigere Modelle herabstufen oder das Budget auf das nächste Geschäftsjahr verschieben. Der Anteil von 25 % des KI-Budgets, der nach Gartner verschoben wird, stammt hauptsächlich aus dieser Ebene.
Da es auf dem Markt günstige und gut funktionierende quelloffene chinesische Modelle gibt, warum wechseln diese mittelständischen Unternehmen nicht direkt zu ihnen? Weil amerikanische Unternehmen dieser Größe mehr Wert auf die Einhaltung der Datensicherheitsvorschriften legen. Sie nutzen KI lieber weniger, als regulatorische Risiken einzugehen – falls sie von Aufsichtsbehörden mit Verstößen konfrontiert werden, können die Geldstrafen weit höher ausfallen als die eingesparten IT-Kosten.
Die Haltung der US-Regierung zu quelloffener chinesischer KI ist nach wie vor unklar: Wie sie regulieren soll und ob sie regulieren soll, ist noch ungewiss. Auf dem offenen Brief der Branche zu offenen Gewichtungsmodellen im Juli haben Nvidia, Microsoft, Meta, IBM, Dell und Palantir unterschrieben; Anthropic hat nicht unterschrieben, ihr CEO Dario Amodei wendet sich gegen ein pauschales Verbot und befürwortet gezielte Regulierung. Solange die Regeln noch unentschieden sind, entscheiden sich die Rechtsabteilungen mittelständischer Unternehmen in der Regel dafür, nichts zu unternehmen.
Aus dieser Ebene taucht gelegentlich auch ein großer Kunde auf: Airbnb hat im Kundenservice-Szenario Tongyi Qianwen statt ChatGPT gewählt. Dies ist derzeit das überzeugendste Beispiel, das zeigt, dass sobald die Preisattraktivität einen bestimmten Schwellenwert überschreitet, selbst der Beschaffungsprozess eines börsennotierten Unternehmens nicht mehr standhalten kann.
Dritte Ebene: Viele Startups wenden sich chinesischer KI zu
Auf der dritten Ebene stehen kleine Unternehmen und Startups. Sie haben weder Compliance-Belastungen noch die Fähigkeit, eigene Modelle zu entwickeln, und die einzige verbleibende Entscheidungsvariable ist das Preis-Leistungs-Verhältnis.
Für eine KI-Untersuchung dieser Ebene kann man die Daten der Modell-Routing-Plattform OpenRouter heranziehen. Der wöchentliche Spitzenanteil chinesischer Modelle auf dieser Plattform hat 46,4 % erreicht, während der Anteil amerikanischer Modelle bei 35,7 % liegt. In der Rangliste der einzelnen Anbieter steht DeepSeek mit 17,6 % an erster Stelle, mit etwa 5,13 Billionen Token pro Woche, gefolgt von Tongyi Qianwen mit 13,9 % und Anthropic mit 14,8 %.
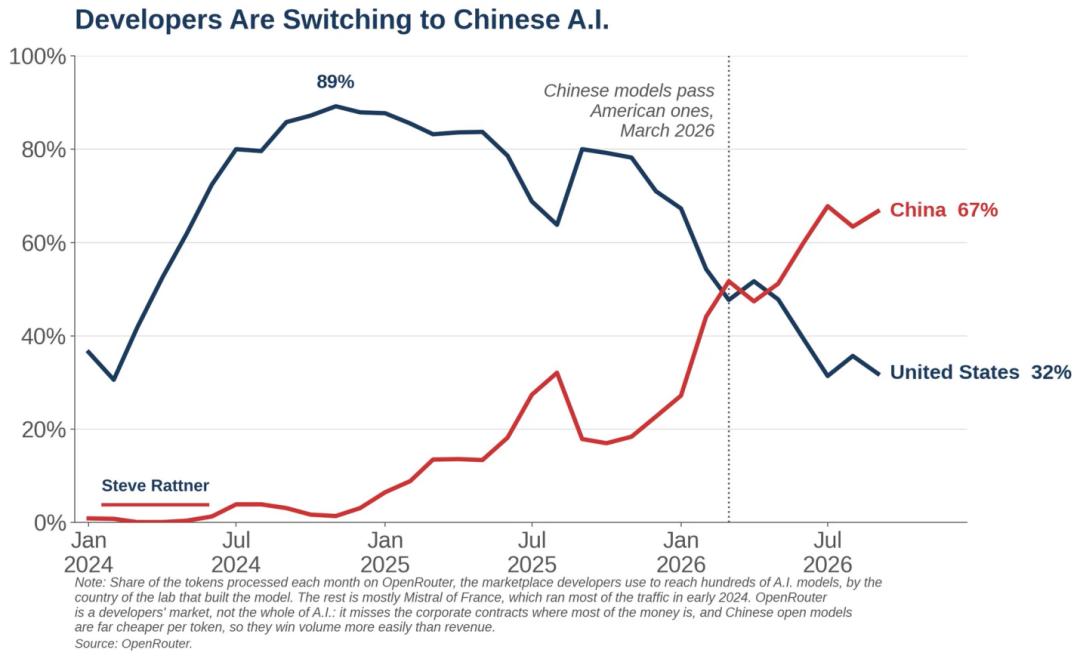
Der Preisunterschied erklärt fast alles. Justin Summerville von OpenRouter sagte, dass quelloffene chinesische Modelle 60 % bis 90 % günstiger sind als die Flaggschiffprodukte von Anthropic und OpenAI. Konkret kostet DeepSeek V4 Flash bis Juni dieses Jahres 0,14 US-Dollar pro Million Eingabe-Token, während GPT-5.5 5 US-Dollar kostet – der gesamte Preisunterschied liegt zwischen dem Vierfachen und dem Hundertfachen.
Man muss klarstellen, dass dieser Wert von 46 % nicht bedeutet, dass chinesische Modelle fast die Hälfte des amerikanischen Unternehmensmarktes erobert haben. Die Nutzerstruktur von OpenRouter neigt von Natur aus zu Entwicklern und kleinen und mittleren Teams, und der Datenverkehr großer Kunden, die direkt Unternehmensverträge mit Anthropic und OpenAI abschließen, ist nicht in diesem Pool enthalten.
Aber die Existenz der dreistufigen Struktur ist bereits ein unbestreitbarer Trend. Dass chinesische Modelle auf OpenRouter 46 % erreichen, zeigt, dass sie nicht den amerikanischen Unternehmensmarkt erobert haben, sondern den Markt für amerikanische Startups.
Für amerikanische Spitzenlabore ist das noch Schlimmere die Zukunft: Sie verlieren ihre nächste Generation von Kunden. Startups, die heute mit DeepSeek anfangen, werden in drei Jahren, wenn sie gewachsen sind, höchstwahrscheinlich nicht mehr zurückkehren.
OpenAI senkt die Preise zweimal hintereinander, um seinen Marktanteil zu vergrößern
Angesichts des gleichzeitigen Drucks der dreistufigen KI-Budgets von Unternehmen reagiert OpenAI mit Preissenkungen. Und es hat die Preise zweimal hintereinander gesenkt.
Bei der Runde am 30. Juli wurde GPT-5.6 Luna direkt um 80 % gesenkt, auf 0,20 US-Dollar pro Million Eingabe-Token und 1,20 US-Dollar für die Ausgabe, Terra wurde um 20 % auf 2 US-Dollar und 12 US-Dollar gesenkt. Bei der Runde am 22. September wurde GPT-6 Sol auf 2 US-Dollar und 10 US-Dollar gesenkt, während das Vorgängermodell GPT-5.6 Sol 4 US-Dollar und 20 US-Dollar kostete. GPT-6 Luna wurde auf 0,10 US-Dollar und 0,50 US-Dollar gesenkt, und das Lesen von zwischengespeicherten Eingaben wurde direkt mit 10 % des ursprünglichen Preises berechnet.
OpenAI hat klar angegeben, dass dies ein dauerhafter Preis ist und keine Werbeaktion. Die Erklärung von OpenAI für die Preissenkung weist vollständig auf interne Effizienz hin: Optimierung des Hardware-Routings, Verbesserung der Inferenzsoftware, Verbesserung des Kontext-Cachings. Sie erwähnten auch, dass Sol in Überwachungstests den Produktionskern autonom neu geschrieben, den Dienst