Tian Yuandong: Nachdem ich meine letzte wissenschaftliche Publikation gemeinsam mit GPT-5 verfasst habe, ist mir bewusst geworden, dass ich innerhalb von fünf Jahren arbeitslos werden werde.
Vor einiger Zeit veröffentlichte OpenAI auf GitHub auf einen Schlag 722 Manuskripte mathematischer Arbeiten. Diese Manuskripte sind in 372 Ergebnis-„Familien“ unterteilt, die 17 mathematische Fachgebiete abdecken, und stammen alle von einem noch unveröffentlichten, nicht öffentlich benannten internen Modell – dessen Leistung weit über die von GPT-6 Astra hinausgeht.
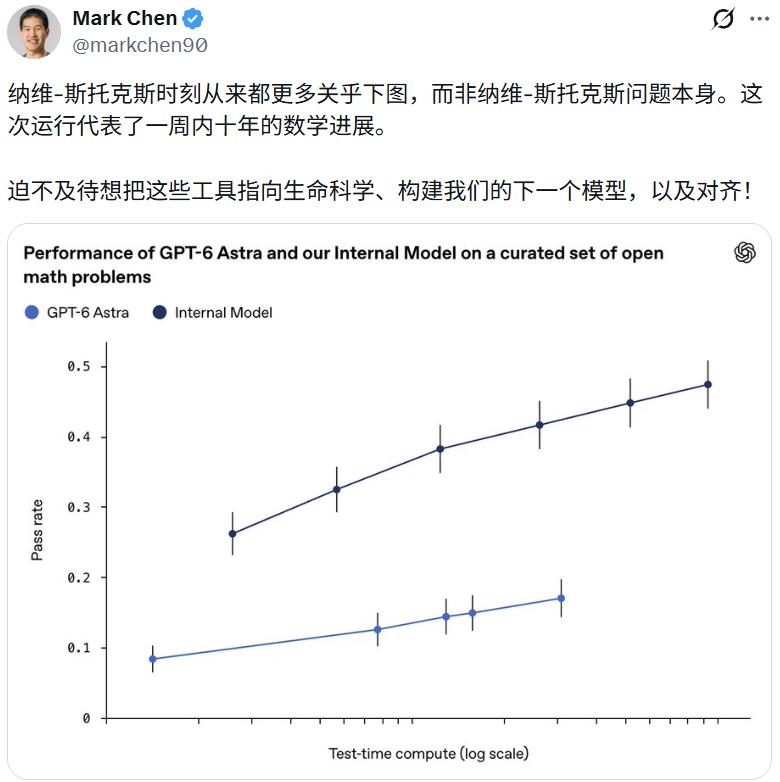
Der Tweet von Mark Chen, Chief Research Officer von OpenAI
Natürlich gibt es in der Mathematikwelt noch viele Kontroversen über die Qualität dieser Ergebnisse und die Art ihrer Offenlegung, aber eines ist kaum zu leugnen: Die Geschwindigkeit, mit der KI Forschungsergebnisse erzeugt, wird nun in Einheiten von „Hunderten von Arbeiten“ gemessen.
Fast zur gleichen Zeit äußerte ein Veteran des Deep Learning in der neuesten Folge des Podcasts *The Information Bottleneck* einen Satz, der viele Forscher aufhorchen ließ: „Nachdem ich dieses Projekt abgeschlossen und einige ziemlich interessante Ergebnisse erzielt hatte, wurde mir plötzlich klar: Wow, meine Arbeit wird wahrscheinlich in etwa fünf Jahren ersetzt werden.“
Podcast-Adresse: https://www.the-information-bottleneck.com/p/yuandong-tian-on-recursive-self-improvement-600
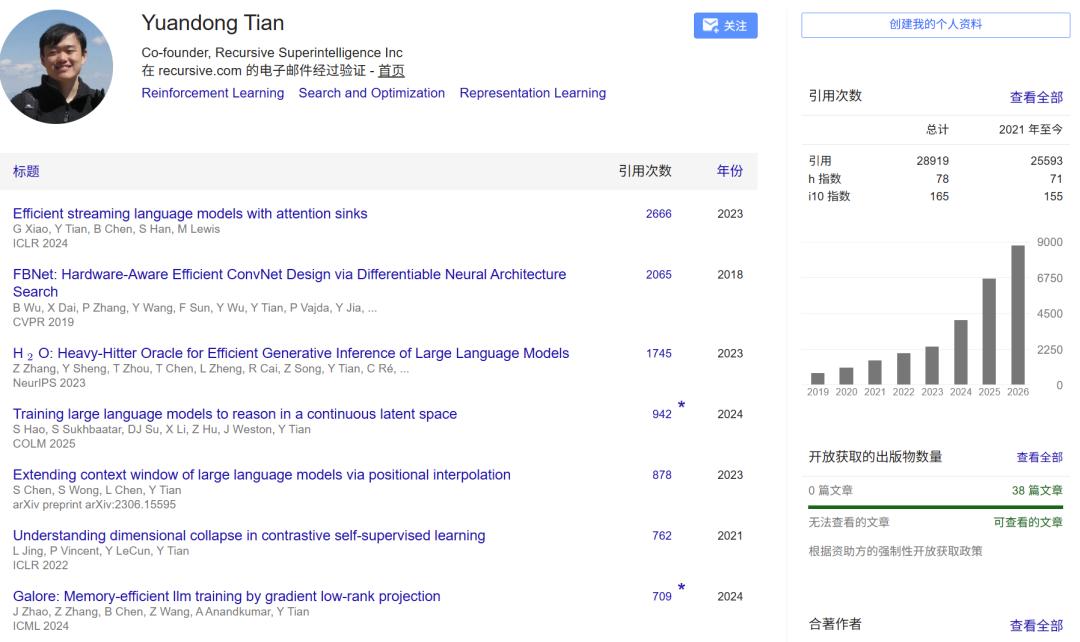
Derjenige, der das gesagt hat, ist Yuandong Tian. Er war fast zehn Jahre lang bei Meta FAIR tätig, arbeitete an Go-KI, verstärktem Lernen und der Interpretierbarkeit neuronaler Netze und ist einer der Autoren der Arbeit zu Coconut (Continuous Chain-of-Thought in latenten Räumen).
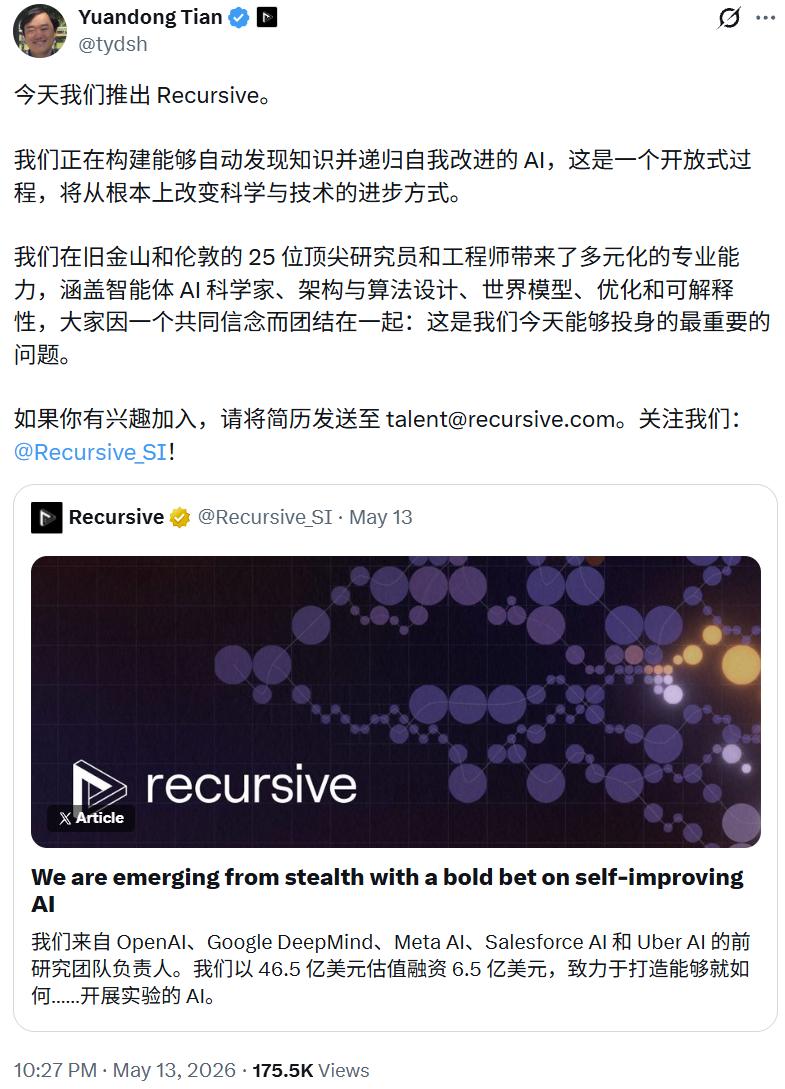
Heute ist er Mitbegründer von Recursive Superintelligence. Im Mai dieses Jahres beendete das Unternehmen seinen Stealth-Modus und gab bekannt, dass es eine Finanzierung von über 650 Millionen US-Dollar bei einer Bewertung von 4,65 Milliarden US-Dollar abgeschlossen hat, angeführt von GV und Greycroft, mit Beteiligung von Nvidia und AMD.
In dieser von Ravid Shwartz-Ziv moderierten Podcast-Folge erklärte Yuandong Tian, warum er sich für die Gründung eines eigenen Unternehmens entschieden hat: „Anstatt passiv meinen Arbeitsplatz zu verlieren, gründe ich lieber aktiv ein Unternehmen, das sich in diese Richtung entwickelt.“ Dennoch bremste er die Erwartungen an KI im Verlauf der Sendung ein wenig. „Wenn Sie das Modell eigene Ideen entwickeln lassen, liefert es Ihnen sehr banale Vorstellungen, die im Grunde jeder kennt und die keine interessanten Richtungen darstellen.“
In dem fast einstündigen Gespräch sprach Yuandong Tian von den Debatten um AlexNet zu seiner Zeit an der CMU über Go-KI, von „Aktionsräumen“ über Schlussfolgerungen in latenten Räumen bis hin zu rekursiver Selbstverbesserung, neuen Architekturen und Open-Source-Lösungen. Im Folgenden ist das Gespräch zusammengefasst wiedergegeben.
Streit im Smith Hall: War AlexNet wirklich nur ein Zufallstreffer?
Yuandong Tian kam 2008 in die USA, um am Robotik-Institut der Carnegie Mellon University zu promovieren. Damals hatte maschinelles Lernen noch lange nicht den Stellenwert von heute. „Viele Leute hielten maschinelles Lernen damals für keinen zuverlässigen Weg. Man sagte, es funktioniere nicht richtig, weil es zu Überanpassung neigt und man nicht verstehen kann, was darin vor sich geht.“
Sein Doktorarbeitsthema war das nicht-konvexe Optimierungsproblem in der Computer Vision, beispielsweise die Wiederherstellung von Bildverzerrungen, die durch Brechung an Wasseroberflächen entstehen. Er verwendete einen hierarchischen Ansatz zur Optimierung und bewies, dass selbst bei nicht-konvexen Problemen bei ausreichend großen Datenmengen die Optimalität in gewissem Maße nachgewiesen werden kann. „Die Kombination aus datengesteuertem Vorgehen und Optimierung ist sehr interessant, und ich bin bis heute sehr stolz auf diese Arbeit.“
2012 erschien AlexNet wie aus dem Nichts. Yuandong Tian schickte Alex Krizhevsky eine E-Mail, erhielt den Code und experimentierte damit selbst. Ihm wurde schnell klar, dass die hierarchische Verarbeitung von Faltungsnetzen im Grunde dasselbe ist wie der hierarchische Optimierungsgedanke in seiner Doktorarbeit – „vielleicht das, wonach ich immer gesucht habe, nur in einer anderen Form“.
Aber die Stimmung an der CMU war damals nicht freundlich. „Jeder kam täglich ins Büro und stritt sich heftig im Smith Hall darüber, ob das Ergebnis von AlexNet nur ein Zufallstreffer oder ein echter Durchbruch war. Die meisten Leute sagten, es sei nur ein Zufall, weil das nicht der Logik entspricht.“
Als er 2013 seinen Abschluss machte, erhielt er Angebote von mehreren Einrichtungen, die im Bereich Deep Learning tätig werden wollten. Schließlich entschied er sich aber für das selbstfahrende Auto-Team von Google, einerseits wegen des Renommees des Unternehmens, andererseits wegen einer Empfehlung durch einen Freund. Aber in den ein Jahr und drei Monaten dort konnte er keine Deep-Learning-Arbeiten durchführen, da das Team eher wie ein Startup funktionierte und praktische Probleme mit ausgereiften Lösungen lösen musste, statt wissenschaftliche Erkundungen durchzuführen. Also wechselte er zu FAIR und bezeichnet diesen Schritt als „eine der besten Entscheidungen, die ich damals getroffen habe“.
Zwei Personen, eine GPU: Yuandong Tians Vergangenheit mit Go-KI
Bei FAIR startete Yuandong Tian sein erstes Projekt mit einer Go-KI. 2015 entwickelte sein Team DarkForest, das mithilfe von Faltungsnetzen online Spitzen-Amateurspieler besiegte. Einige Monate später besiegte AlphaGo im Frühjahr 2016 einen professionellen Spieler.
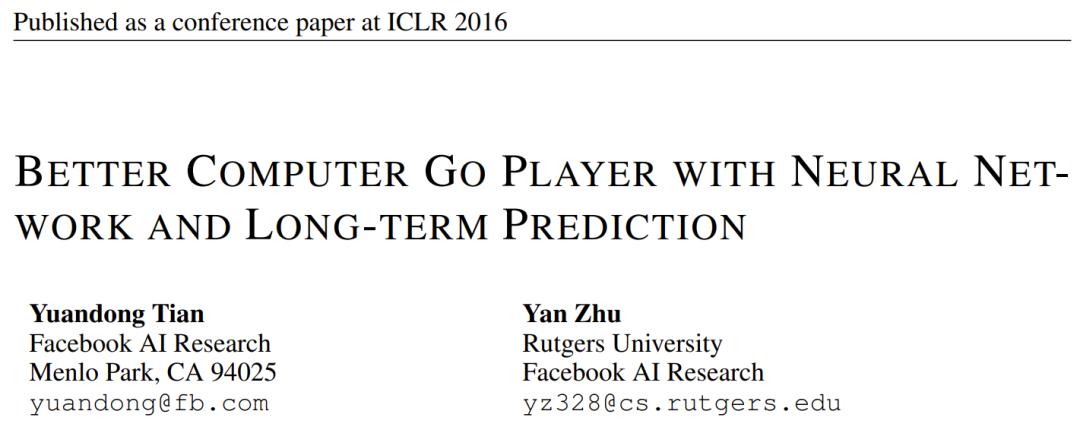
Angesichts dieses „Zufallstreffers“ kommt Yuandong Tian bei seiner Rückschau zu dem Schluss, dass AlphaGo zwei Dinge hatte, die seine eigene Lösung nicht hatte:
- Wertenetz – DarkForest verfügte damals nur über ein Strategienetz;
- Er selbst hatte zuvor kaum Hintergrundwissen im Bereich verstärktes Lernen – „Ich habe es im Grunde während der Arbeit gelernt, so als würde ich mich selbst verstärktem Lernen unterziehen“. Diese Erfahrung führte ihn später zu einer großen Anzahl von Forschungsarbeiten zum verstärkten Lernen.
Auf die Frage, ob AlphaGo überraschend war, antwortete er sehr aufschlussreich: Die Methode an sich war nicht erstaunlich, da Faltungsnetze die Muster auf dem Go-Brett erfassen können, auf die sich Menschen beim Spielen verlassen – „Das wirklich Erstaunliche war, dass es tatsächlich professionelle Spieler besiegen konnte“.
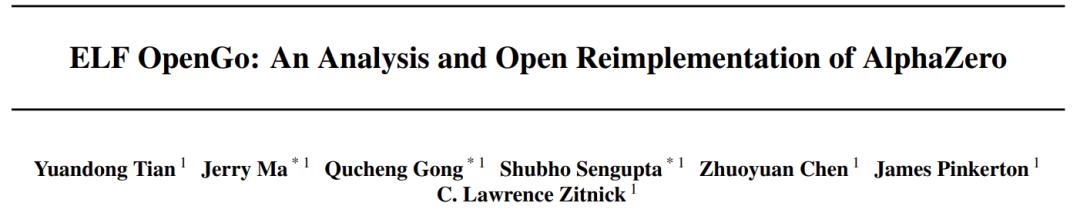
2018 reproduzierte das Team AlphaZero, also ein Konzept, das vollständig ohne menschliche Spielverläufe auskommt und von Null an selbst gegeneinander spielt. Mit einigen Effizienzverbesserungen entstand daraus OpenGo. Diese KI besiegte in offiziellen Partien gegen die Koreanische Go-Vereinigung mit nur einer einzigen V100-GPU vier professionelle Spieler, ohne dass diese auch nur eine Partie gewannen. „Ich glaube, das war ungefähr das erste Mal, dass jemand mit einer einzigen GPU professionelle Spieler besiegt hat.“
Vor dem Spiel gab es noch eine kleine Zwischenepisode: Das Team bat Freunde, die professionelle oder semiprofessionelle Spieler waren, die Spielstärke von OpenGo zu bewerten. Die Gegenseite gab an, dass sie die Eröffnungspartie noch verstehen könne, danach aber gar nicht mehr durchblicke und nur sagen könne: „Es sieht stark aus, aber ich weiß nicht, ob es wirklich stark ist“. Also beschloss Yuandong Tian: Dann spielen wir einfach direkt gegen echte professionelle Spieler.
Der Aktionsraum ist wichtiger als der Algorithmus
Im Hinblick auf das verstärkte Lernen jener Zeit ist Yuandong Tian der Ansicht, dass viele Methoden bis heute unterschätzt werden. Beispielsweise das verteilte verstärkte Lernen, bei dem das Modell nicht über einen einzelnen Skalarwert, sondern über eine Verteilung der Belohnungen angepasst wird; oder auch unterschiedliche Modellierungsverfahren wie Q-Learning. „Aber heute verwenden wir meistens Richtungsgradienten – das ist eine ganz andere Epoche.“
Er schätzt auch gradientenfreie Optimierungsmethoden sehr ein und ist der Ansicht, dass große Sprachmodelle ihnen neue Möglichkeiten eröffnen: „Große Modelle verfügen heute über ein besseres hochgradiges Verständnis des Systems und der zu optimierenden Zielfunktion. Dieses hochgradige Verständnis ist viel nützlicher als lokale Gradienteninformationen“. In Situationen, in denen Gradienten stark schwanken und lokale Optima überall zu finden sind, können Gradienten in Sackgassen führen, während gradientenfreie Methoden von Natur aus Exploration beinhalten – „etwas, das Gradientenverfahren niemals tun“.
Um 2018 und 2019 herum begann Yuandong Tian zu versuchen, verstärktes Lernen auf Probleme der realen Welt anzuwenden, und kam zu einem überraschenden Ergebnis: „Das wirklich Wichtige ist nicht der Algorithmus, sondern die Gestaltung des Aktionsraums und des Zustandsraums“.
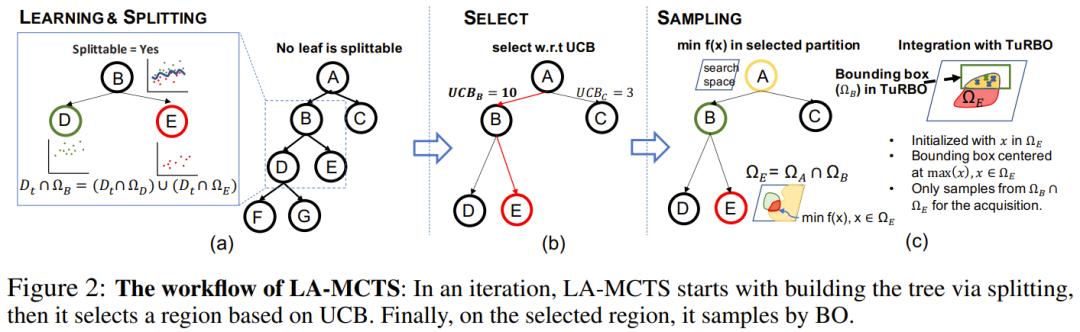
Als Beispiel nennt er die Suche nach neuronalen Architekturen. Menschen wissen, dass die Tiefe des Netzes entscheidend ist, aber die KI weiß das nicht. Wenn die KI zuerst Details wie die Größe der Faltungskerne der ersten Schicht durchsucht, schneiden alle Zweige ungefähr gleich gut ab, die Wertfunktion liefert keine nützlichen Signale, man kann nur schichtweise vorgehen, und der Suchraum explodiert exponentiell – „dann nützt kein Algorithmus etwas“. Wenn man umgekehrt den Aktionsraum neu organisieren kann, sodass die KI zuerst „versteht“, dass Tiefe wichtig ist, entsteht ein deutlicher Unterschied zwischen tiefen und flachen Netzen, und man kann die Richtung nach wenigen Rollouts erkennen. Aus diesem Grund schlug das Team die latente Raum-Monte-Carlo-Baumsuche (LA-MCTS) vor, deren Kernidee darin besteht, automatisch den Aktionsraum zu finden, der den Suchunterräumen die höchste Unterscheidbarkeit verleiht.
Coconut: „Wenn ich nachdenke, verwende ich niemals Sprache“
Der gemeinsame Moderator erwähnt die Arbeit zu Coconut, an der Yuandong Tian beteiligt war – ein Konzept, bei dem das Modell nicht im Token-Raum, sondern im kontinuierlichen latenten Raum Schlüsse zieht. Yuandong Tian sagt, diese Idee stamme aus seiner Selbstbeobachtung: „Wenn ich nachdenke, verwende ich niemals Sprache. Ich kann deutlich spüren, dass ich beim Denken einen anderen Teil meines Gehirns verwende, und dann muss ich die Gedanken in Sprache übersetzen, um reibungslos mit anderen kommunizieren zu können.“
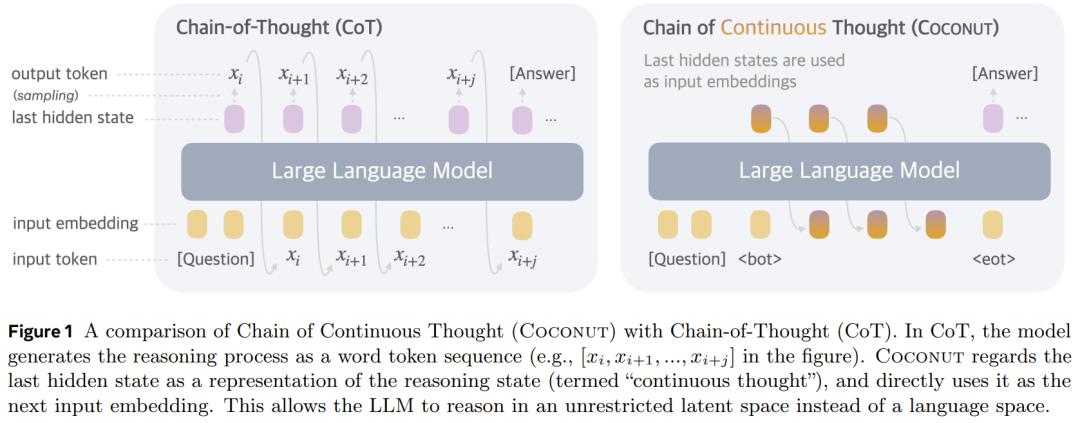
Aus dieser Intuition leitete das Team theoretische Ableitungen ab und stellte fest, dass latente Repräsentationen Überlagerungszustände verschiedener Ideen sein können. Mit ihnen zu schließen kann bei Problemen wie der Graphendurchquerung deutliche Vorteile bringen – „vielleicht keine exponentiellen, aber zumindest gewisse Vorteile“.
Warum verwenden aktuelle Spitzen