H-JEPA, LeCuns Startup für Weltmodelle hat seine Ergebnisse vorgelegt, der gesamte Code sowie alle Gewichte sind vollständig quelloffen.
LeCuns Startup für Weltmodelle, AMI (Advanced Machine Intelligence), hat gerade im Stillen seine neuesten Ergebnisse vorgelegt.
In der neuesten Arbeit H-JEPA haben Forscher von AMI gemeinsam mit der New York University, der INRIA Paris und der Brown University ein hierarchisches Weltmodell für die visuelle Planung vorgestellt.
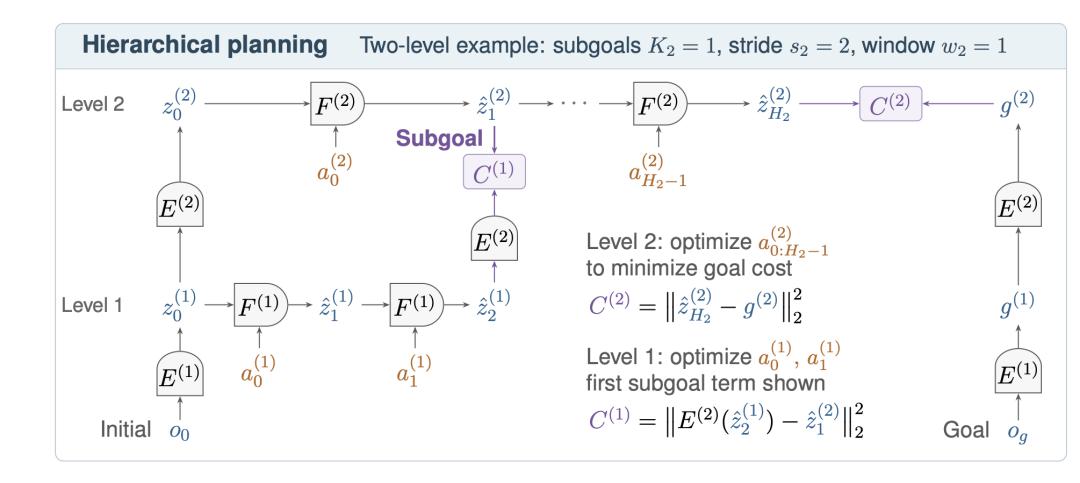
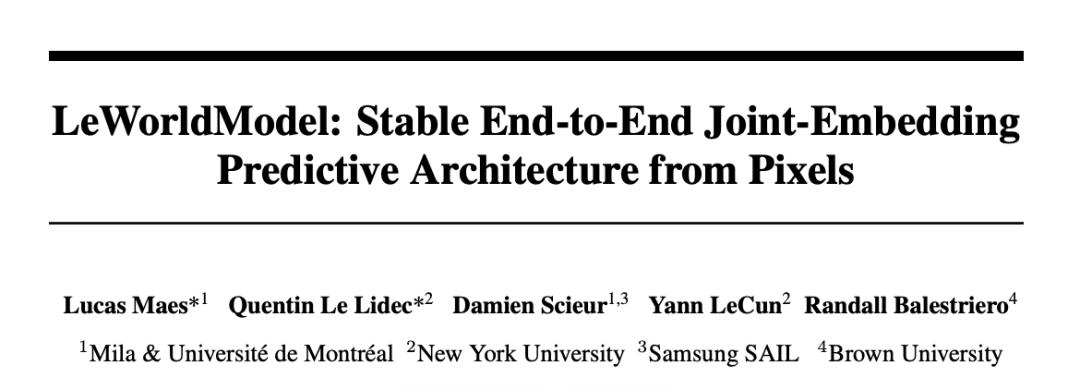
H-JEPA stapelt mehrere JEPA-Schichten übereinander, sodass jede Schicht in ihrem eigenen Darstellungsraum Zustände nach unterschiedlichen Zeitspannen vorhersagt.
Bei der Planung erstellt die obere Ebene zunächst einen groben Plan, übergibt die vorhergesagten Zwischenzustände dann als Unterziele an die untere Ebene, die diese schrittweise verfeinert, bis schließlich ausführbare Aktionen entstehen.
Durch diese Aufteilung kann das Weltmodell sowohl langfristige Ziele planen als auch unmittelbare Aktionen verarbeiten.
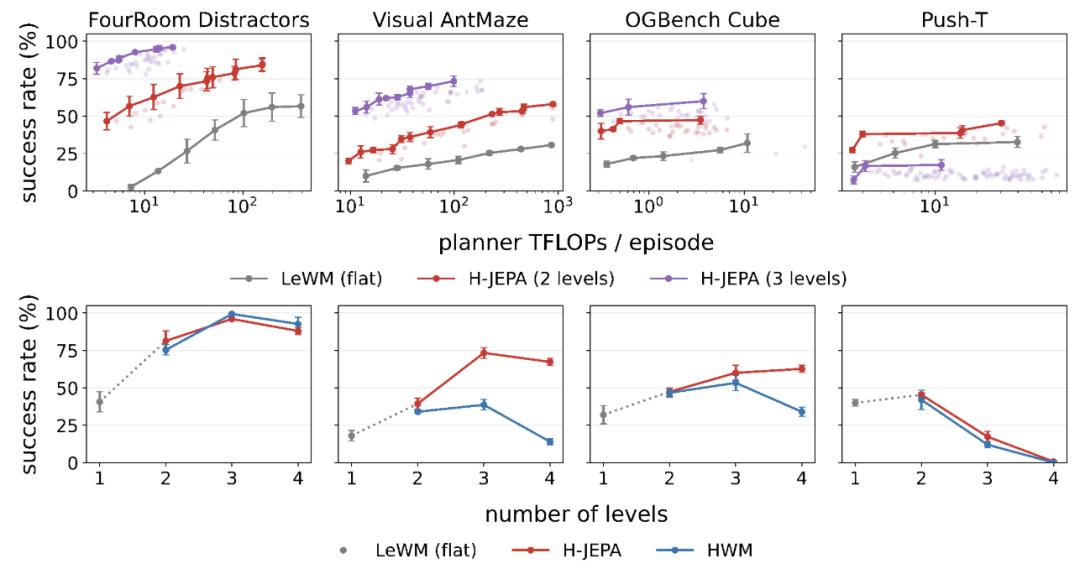
In der simulierten Labyrinthaufgabe Visual AntMaze erreicht das dreischichtige H-JEPA eine Erfolgsrate von 73%, während das einschichtige Modell nur 18% erreicht.
Zusätzlich erzielt das hierarchische Modell in mehreren Simulationsaufgaben eine bessere Leistung bei geringerem Planungsaufwand.
Neben den sichtbaren Testergebnissen setzt H-JEPA auch die Open-Source-Route fort, die LeCun bereits zu Beginn seiner Unternehmensgründung betont hat.
Das Team hat gleichzeitig den Code und die Gewichte des vortrainierten Modells veröffentlicht, sodass Forscher das Modell direkt laden und die Planungsexperimente reproduzieren können.
Warum brauchen Weltmodelle hierarchische Planung?
Darüber spricht LeCun eigentlich schon sehr lange.
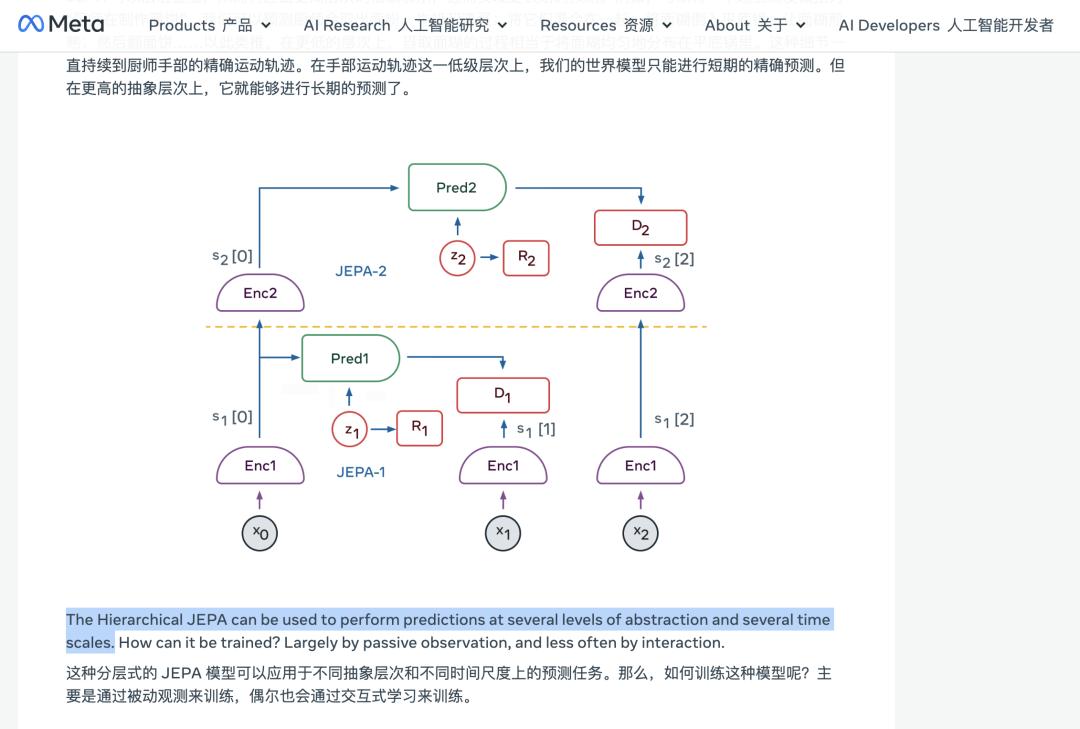
Bereits 2022, als er noch Chef-Wissenschaftler für KI bei Meta war, stellte er die Idee des hierarchischen JEPA vor:
Lassen Sie das Modell auf verschiedenen Abstraktionsebenen und Zeitskalen vorhersagen, und setzen Sie dann durch hierarchische Planung komplexe Ziele in Aktionen um.
Das klingt zunächst etwas abstrakt, aber anhand des Beispiels, das LeCun häufig anführt, ist es leicht verständlich.
Nehmen wir an, Sie sitzen im Büro der New York University und planen eine Reise nach Paris. Bei der Planung der gesamten Reise konzentrieren Sie sich auf das Ziel, die Flüge und den Zeitplan.
Nachdem der Reiseplan feststeht, planen Sie weiter, wie Sie das Büro verlassen, nach unten gehen und ein Taxi zum Flughafen nehmen.
Wenn Sie dann tatsächlich das Büro verlassen, konzentrieren Sie sich auf den Boden, die Treppe vor Ihnen und darauf, wohin Sie den nächsten Schritt setzen und welchen Fuß Sie zuerst bewegen sollen.
△
Diese Planungsebenen decken unterschiedliche Zeitspannen ab und erfordern unterschiedliche Informationen. Bei der Planung des Fluges ist die Höhe einer einzelnen Treppenstufe unter Ihren Füßen unwichtig; beim Hinuntergehen der Treppe bestimmt dieses Detail jedoch direkt, wie Sie Ihren Schritt setzen.
Das ist keine einzigartige Eigenschaft menschlicher Planung. Für Roboter muss die obere Ebene Aufgabenziele, Umgebungsbeziehungen und zukünftige Richtungen verstehen, während die untere Ebene konkrete Aktionen und Details der Körpersteuerung beherrschen muss.
Zum Beispiel ist ein vierbeiniger Roboter bereits an der Zielposition angekommen, aber seine Beinhaltung unterscheidet sich vom Zielbild – trotzdem kann das Modell aufgrund dieser Unterschiede glauben, es sei noch weit vom Ziel entfernt.
Damit gelangt man zu der Frage:
Wie können verschiedene Ebenen jeweils für sie geeignete Informationsdarstellungen lernen und dann die Pläne der oberen Ebene schrittweise in Aktionen der unteren Ebene umsetzen?
Wie funktioniert H-JEPA konkret?
Konkret konfiguriert H-JEPA zur Lösung des oben genannten Problems in jeder Ebene drei Komponenten, die jeweils Zustände, Aktionen und Vorhersagen verarbeiten.
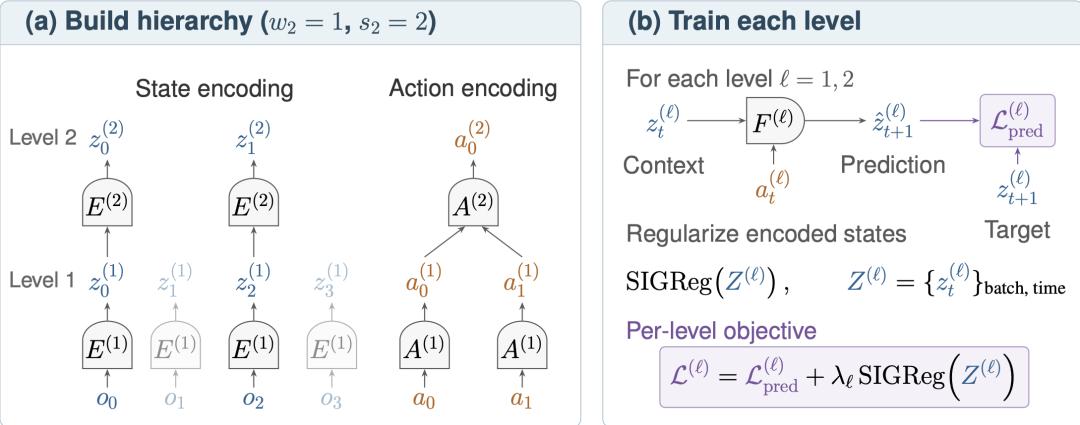
Dabei ist der Zustandskodierer für die Extraktion der Darstellung der aktuellen Umgebung zuständig. Die unterste Ebene liest direkt Bilder ein, während höhere Ebenen auf der Darstellung der unteren Ebene weiter abstrahieren und die wichtigeren Informationen dieser Zeitskala behalten.
Der Aktionskodierer ist für die Beschreibung der durch Aktionen verursachten Änderungen zuständig. Die untere Ebene stellt konkrete Aktionen dar, während die obere Ebene eine Reihe aufeinanderfolgender Aktionen zu Änderungen mit gröberer Granularität komprimiert.
Der Prädiktor kombiniert aktuellen Zustand und Aktion, um den zukünftigen Zustand vorherzusagen. Verschiedene Ebenen decken unterschiedliche Zeitspannen ab. In den Experimenten der Arbeit entspricht ein Schritt einer benachbarten oberen Ebene zwei Vorhersageschritten der unteren Ebene.
Bei der Modellausbildung lernen die Ebenen gemeinsam durch End-to-End-Training, und verschiedene Ebenen sind durch Unterziele miteinander verbunden.
Der von der oberen Ebene vorhergesagte Zwischenzustand wird zum Unterziel der unteren Ebene. Die untere Ebene wandelt ihren vorhergesagten Zustand in den Darstellungsraum der oberen Ebene um, vergleicht ihn mit dem von der oberen Ebene angegebenen Unterziel und passt die Aktion entsprechend an.
Beim Training des Weltmodells muss jedoch noch ein klassisches Problem gelöst werden: Darstellungskollaps.
Wenn der Kodierer alle Eingaben zu demselben Vektor komprimiert und der Prädiktor nur diesen Vektor ausgibt, kann zwar ein sehr niedriger Vorhersagefehler erzielt werden, aber das Modell hat tatsächlich keine nützlichen Informationen gelernt.
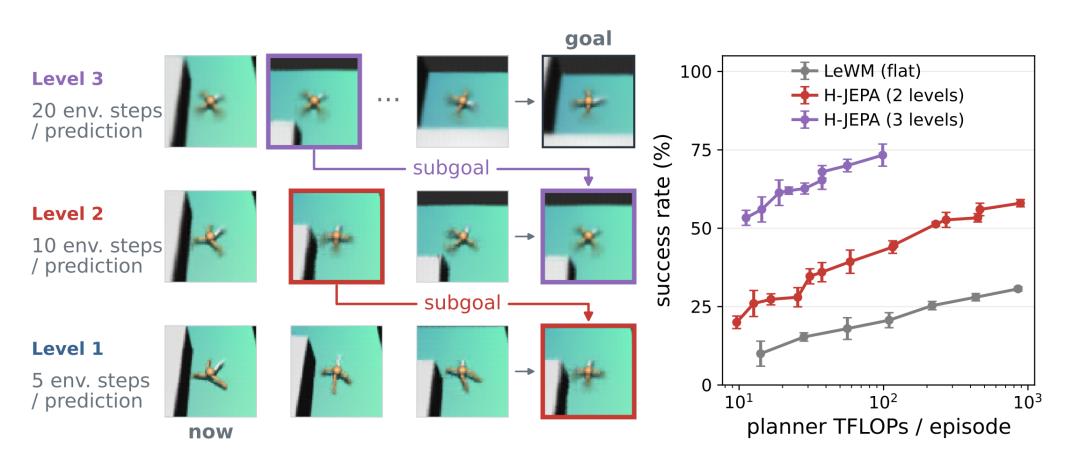
Aus diesem Grund verwendet H-JEPA das von LeCuns Team zuvor in LeJEPA vorgeschlagene SIGReg weiter, um die Darstellungsverteilung einzuschränken und zu verhindern, dass verschiedene Zustände zu demselben Vektor komprimiert werden.
In diesem Jahr hat LeWorldModel diese Methode für das Training von Weltmodellen eingesetzt. H-JEPA baut darauf als unterste Ebene auf und fügt weitere JEPA-Schichten hinzu, sodass eine Struktur entsteht, die gemeinsam trainiert wird und von oben nach unten plant.
In den Experimenten beobachteten die Forscher weiter, wie verschiedene Ebenen Informationen auswählen. In der Labyrinthaufgabe schwächt die obere Ebene allmählich die Darstellung der Beinhaltung ab, behält aber die Positionsinformationen des Roboters bei.
Allerdings ist die Hierarchie auch an Bedingungen gebunden. Das zweischichtige Modell in der Push-T-Aufgabe zeigt eine gute Leistung, aber wenn man es auf drei oder vier Schichten erweitert, sinken die Ergebnisse stattdessen.
Die Arbeit geht davon aus, dass dies darauf zurückzuführen sein könnte, dass kürzere Aufgabentrajektorien die für die obere Ebene verfügbaren Trainingsdaten einschränken.
LeCun ist immer noch derselbe LeCun
Insgesamt setzen diese Konstruktionen von H-JEPA eine grundlegende Behauptung von JEPA fort: Die Vorhersage wird im Darstellungsraum abgeschlossen.
JEPA steht für „Joint Embedding Predictive Architecture“ (Gemeinsame Einbettungsvorhersagearchitektur). LLMs lernen normalerweise Inhalte zu generieren, indem sie das nächste Token vorhersagen; das visuelle JEPA kodiert Bilder und Videos zunächst zu internen Darstellungen und sagt dann die Darstellung des Zielteils voraus, ohne dass Bildpixel einzeln generiert werden müssen.
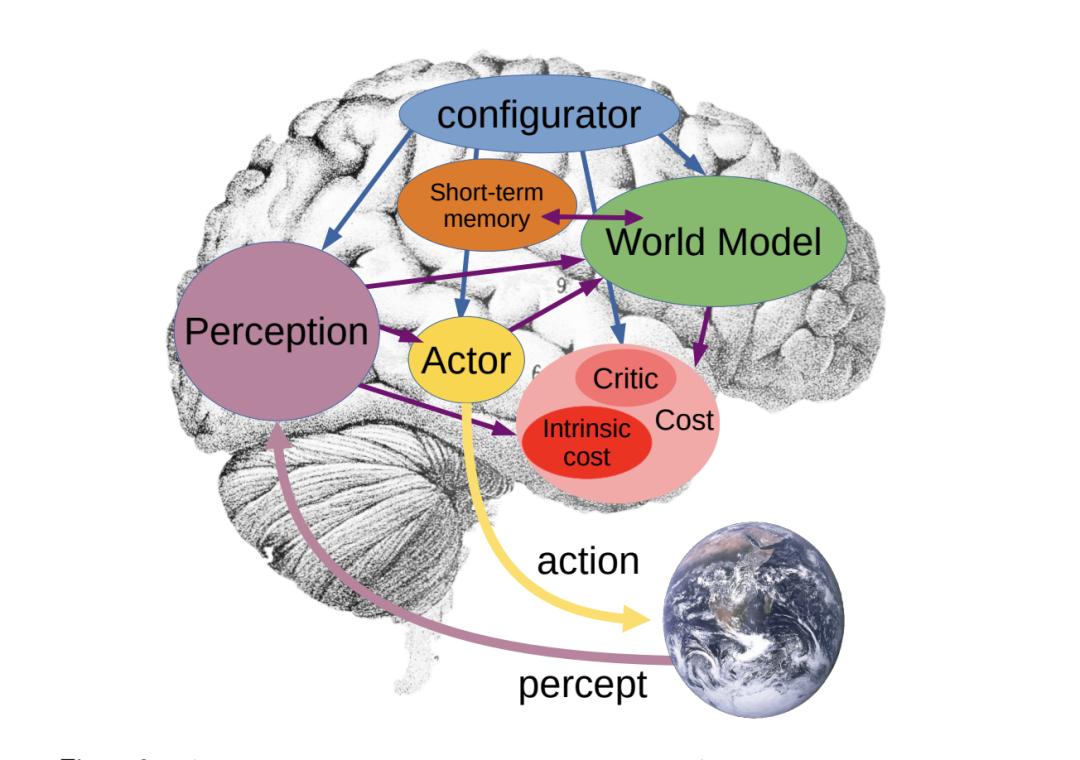
In Weltmodellen wie H-JEPA kombiniert das Modell zudem Aktionen, um die Darstellung zukünftiger Zustände vorherzusagen. Der Planer vergleicht daraufhin die Folgen verschiedener Aktionen, um den Weg zum Ziel zu finden.
LeCun war schon immer der Meinung, dass das Verstehen der Welt, das Vorhersagen der Folgen von Handlungen und das Planen Fähigkeiten sind, die für eine menschliche Intelligenz unverzichtbar sind. Seine Einschätzung zu LLMs dreht sich immer um diesen Punkt.
Im September dieses Jahres tauchten auf den Folien seines Vortrags auf der ECCV in Malmö, Schweden, erneut der bekannte Ratschlag auf:
Wenn Sie sich für menschenähnliche KI interessieren, sollten Sie keine LLMs erforschen.
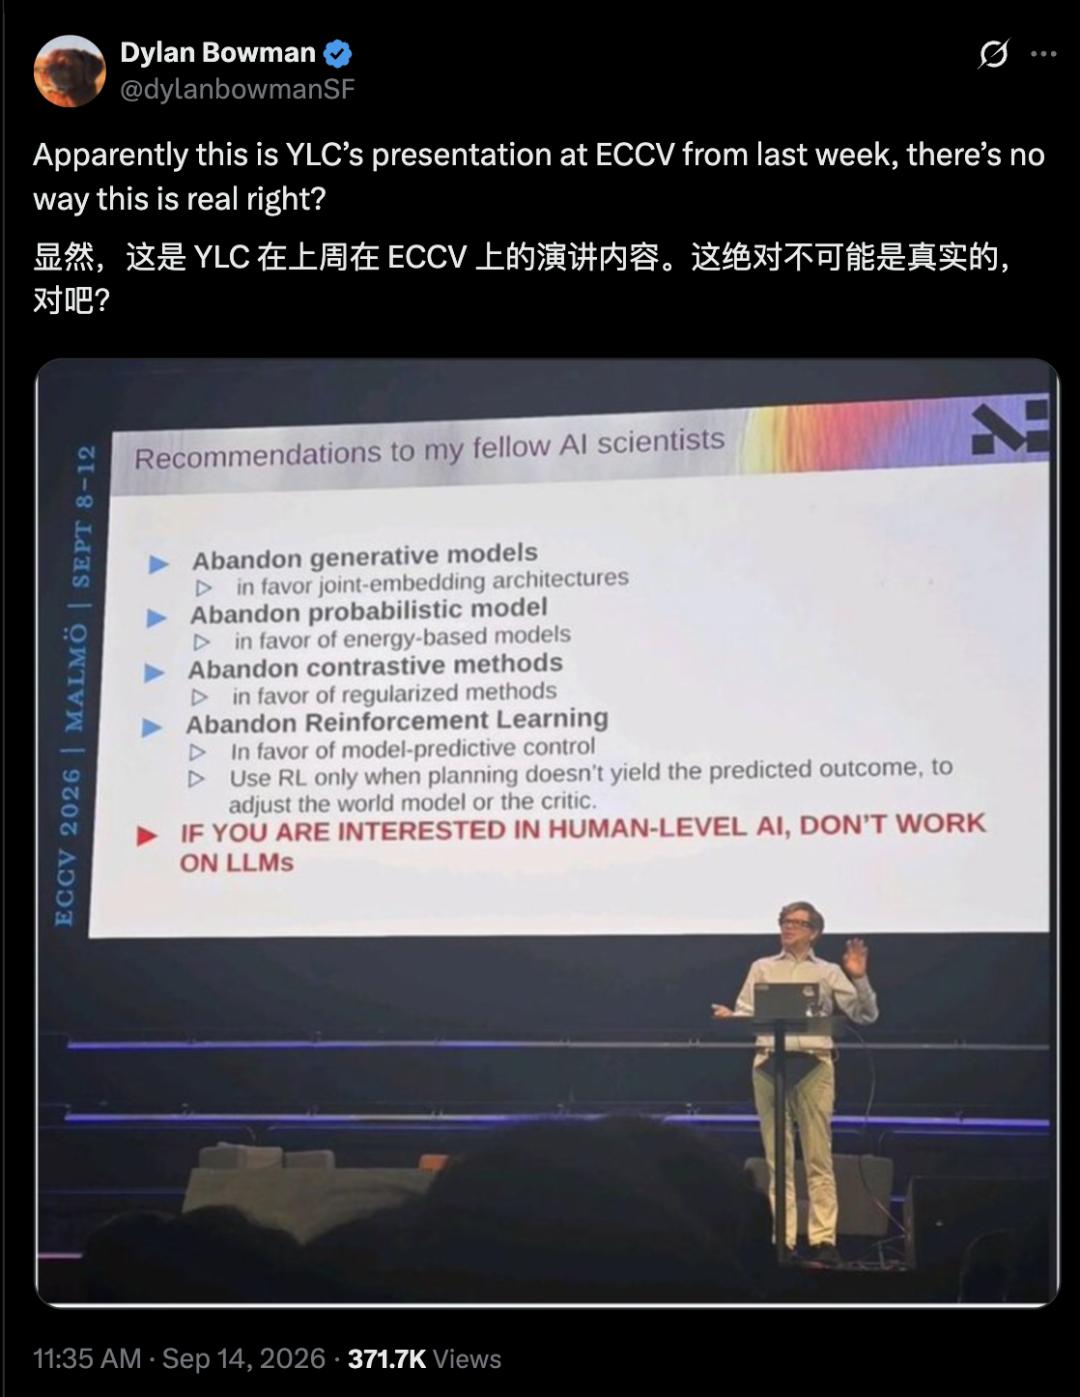
Nachdem diese Folie auf sozialen Plattformen verbreitet wurde, zweifelten einige an ihrer Echtheit. LeCun antwortete:
Das ist absolut echt.
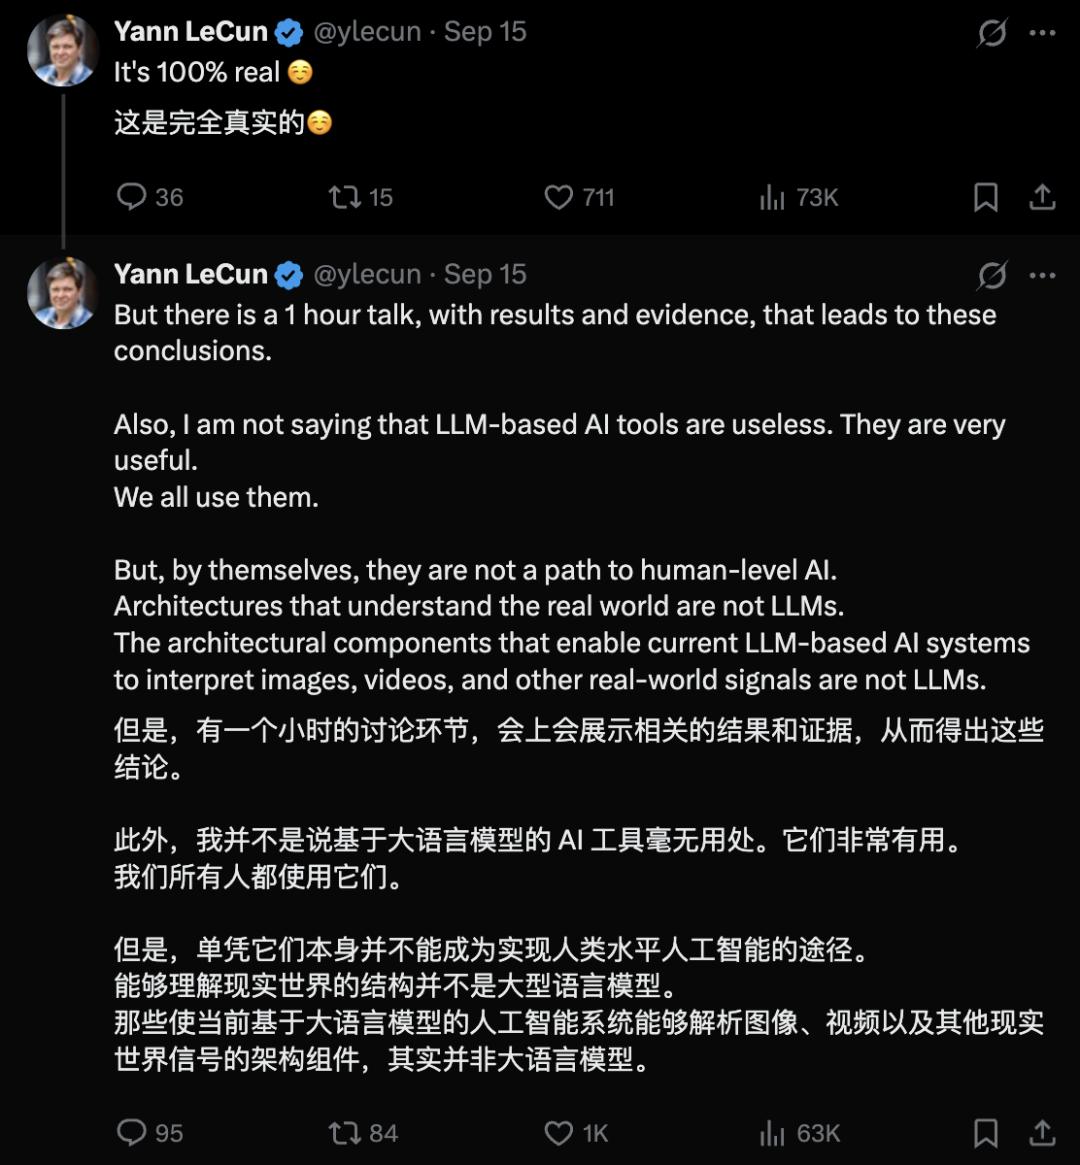
Anschließend fügte er hinzu, dass KI-Tools auf Basis von LLMs sehr nützlich sind und von allen verwendet werden. Seiner Meinung nach reichen LLMs allein jedoch nicht aus, um menschenähnliche Intelligenz zu erreichen.
Heute ist diese Forschungsrichtung auch die Gründungsmission von AMI.
Im März dieses Jahres gab AMI den Abschluss einer Finanzierungsrunde von 1,03 Milliarden US-Dollar mit einer Vorfinanzierungsbewertung von 3,5 Milliarden US-Dollar bekannt.
LeCun ist Vorsitzender des Unternehmens, Alexandre LeBrun ist CEO, Xie Saining ist Chefwissenschaftler, Pascale Fung verantwortet Forschung und Innovation, Michael Rabbat ist für das Weltmodell zuständig – und Rabbat ist einer der Autoren der H-JEPA-Arbeit.
Gleichwohl: Forschungsergebnisse sind Forschungsergebnisse, eine weitere Erwartung der Öffentlichkeit an AMI ist nach wie vor ein fertiges Produkt.
Zumindest auf der aktuellen Website zeigt das Unternehmen hauptsächlich technische Richtungen