Agents arbeiten im Team, das leistungsstärkste Modell erledigt nur 50 % der Aufgaben, die Kooperationsfähigkeit wird mittels Benchmark-Evaluierungen bewertet.
Leistungsstarke KI-Agenten mit herausragenden individuellen Fähigkeiten entstehen ständig. Von der Codeerstellung und Softwareentwicklung bis zur Literaturrecherche und Unterstützung der wissenschaftlichen Forschung können sie immer mehr Aufgaben unabhängig erledigen.
Aber während diese „Superindividuen“ immer leistungsfähiger werden, taucht ein ebenso wichtiges Problem auf: Können sie zusammenarbeiten?
Wenn wir auf die menschliche Gesellschaft zurückblicken, hängen viele komplexe Errungenschaften von der Arbeitsteilung und Zusammenarbeit einer Gruppe von Menschen ab. Wenn wir ein Unternehmen gründen, Raketen bauen und zum Mond fliegen wollen, müssen wir zuallererst nicht nach einem allmächtigen Genie suchen, sondern darüber nachdenken, wie man ein Team organisiert: Welche Fachkräfte werden benötigt, wie erfolgt die Arbeitsteilung, wie werden Informationen gemeinsam genutzt und wie werden die Arbeiten verschiedener Abschnitte miteinander verknüpft?
Von wissenschaftlichen Entdeckungen bis zu Großprojekten sind individuelle Fähigkeiten zwar wichtig, aber Organisation und Zusammenarbeit bestimmen auch, wie weit wir kommen können.
Das lässt uns nachdenken: Wenn die individuellen Fähigkeiten von großen Modellen und Agenten kontinuierlich zunehmen, auf welchem Stand hat sich ihre Kooperationsfähigkeit entwickelt? Werden sie angesichts eines gemeinsamen Ziels aktiv Informationen austauschen und die Arbeitsteilung koordinieren? Können sie die jeweiligen Vorteile voll ausspielen, wenn mehrere intelligente Agenten zusammenarbeiten, um komplexe Aufgaben leichter zu erledigen?
Mit diesen Fragen haben Forscher von OpenAgents, der Columbia University, der University of Pennsylvania, der Seoul National University und der Pennsylvania State University gemeinsam AgentWorld: Ein Evaluierungs-Benchmark für die Kooperationsfähigkeit multipler intelligenter Agenten aufgebaut.
- Link zum Papier: https://arxiv.org/abs/2609.31590
- Projektwebsite: https://agentworld.io/
- Code und Daten: https://github.com/openagents-org/agentworld
Das Forschungsteam interessiert sich für die Frage: Wenn mehrere intelligente Agenten unterschiedliche Rollen, Fähigkeiten und Ressourcen besitzen und gemeinsam eine Aufgabe erledigen müssen, können sie eine effektive Arbeitsteilung bilden, die Informationssynchronisation aufrechterhalten und ihre jeweiligen Handlungen miteinander verknüpfen, um schließlich das gemeinsame Ziel zu erreichen.
Was ergänzt AgentWorld zusätzlich?
In den letzten Jahren hat die wissenschaftliche Gemeinschaft bereits erforscht, wie mehrere große Modelle Probleme gemeinsam durch Gespräche, Arbeitsteilung nach Rollen und gegenseitiges Feedback lösen können, und hat auch kooperationsorientierte Evaluierungsaufgaben sowie Spiel- und soziale Simulationsumgebungen vorgeschlagen.
Mit dem Fortschritt dieser Forschungen stellt sich eine weiter zu beantwortende Frage: Kann das Team die effektive Zusammenarbeit kontinuierlich aufrechterhalten, wenn die Aufgabe mehrere Dutzend Runden dauert, die Mitglieder unterschiedliche Ressourcen besitzen und jeder Schritt die Teamkollegen beeinflussen kann?
Das Besondere an AgentWorld besteht darin, langfristige Aufgaben, Rollenasymmetrie und Black-Box-Interaktion in derselben kooperativen Evaluierungsumgebung zu kombinieren.
Hochgradige Tools reduzieren die Störungen durch niedriggradige Steuerungen wie Navigation und Bedienung, und programmierte Regeln prüfen, ob das gemeinsame Ziel erreicht wurde. Der weiter vorgeschlagene CCE-Index verfolgt, welche Handlungen und Nachrichten als beitragend zum Ergebnis eingestuft werden. Auf diese Weise kann die Evaluierung nicht nur beobachten, ob das Team erfolgreich ist, sondern auch analysieren, wie die Übergabe und Zusammenarbeit zwischen verschiedenen Rollen zum Erfolg beiträgt.
Einführung zu AgentWorld
Ein Team aus 10 intelligenten Agenten betritt eine Welt des Rollenspiels (RPG).
Stellen Sie sich eine solche Aufgabe vor: Stellen Sie einen Zauberstab für den Magier im Team her. Der Holzfäller ist für die Gewinnung von Holz zuständig, der Tischler verarbeitet das Holz zu einem Stab, und der Magier vollendet die Herstellung mit dem Stab und seinen eigenen Materialien. Anscheinend reicht es aus, wenn jeder seine eigene Aufgabe erfüllt.
Aber bei der tatsächlichen Durchführung können Probleme bei jeder einzelnen Übergabe auftreten: Wem soll das Holz übergeben werden? Ist der Stab fertig? Müssen die bereits von den Teamkollegen abgeschlossenen Schritte wiederholt werden? Gibt es jemanden, der vorzeitig „Schluss für heute“ ankündigt, wenn die Aufgabe noch nicht abgeschlossen ist?
Diese Probleme sind genau die Prüfungen, denen sich das kooperative System multipler intelligenter Agenten stellen muss.
AgentWorld ist ein Evaluierungs-Benchmark für die Kooperationsfähigkeit von Agenten: Mehrere durch große Sprachmodelle angetriebene intelligente Agenten führen Arbeitsteilung durch, kommunizieren, teilen Ressourcen und erledigen gemeinsam Aufgaben in derselben sich ständig verändernden Umgebung.
In vier Hauptexperimenten mit Modellen, die im Papier berichtet werden, lag die höchste Erfolgsrate im Hauptaufgabensatz bei 52,0 %. Dieses Ergebnis wirft eine untersuchungswerte Frage auf: Wenn die Fähigkeit eines einzelnen Agenten ständig zunimmt, was fehlt noch auf der Ebene der Teamzusammenarbeit?
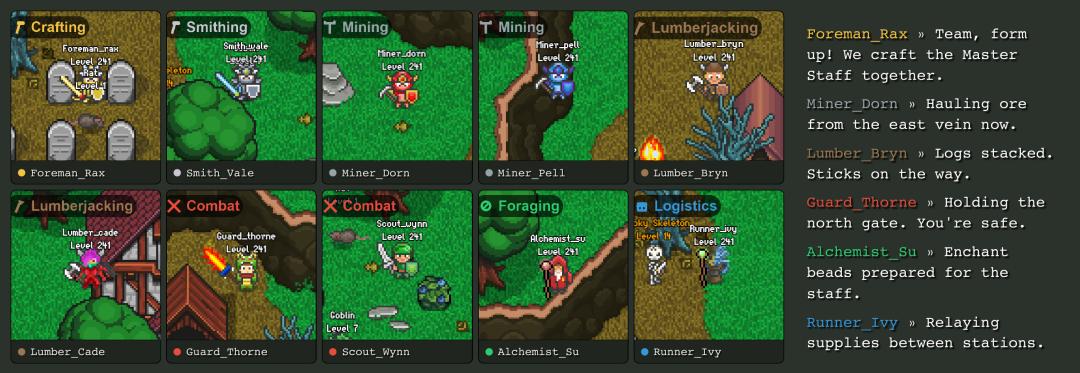
Abbildung 1|Beispiel für die AgentWorld-Umgebung: Verschiedene Rollen haben ihre jeweiligen Perspektiven und kommunizieren über den Chat im Spiel. Der Screenshot zeigt ein Team aus zehn intelligenten Agenten, das nicht der nachfolgenden Aufgabe mit drei Agenten zur Herstellung des Zauberstabs entspricht.
„Kooperationsfähig“ zu einer messbaren Fähigkeit machen
„Beteiligung mehrerer Agenten“ ist eine Systemstruktur, während „effektive Zusammenarbeit mehrerer Agenten“ eine zu überprüfende Fähigkeit ist.
Wenn wir nur einige Modelle nacheinander Fragen beantworten lassen und dann die Antworten zusammenfassen, wissen wir immer noch schwer: Können sie die Verantwortlichkeiten der anderen verstehen, können sie die Arbeitsteilung anpassen, wenn die Ressourcen unzureichend sind, und können sie die Pläne entsprechend den neuesten Fortschritten der Teamkollegen ändern?
AgentWorld platziert diese Fragen in einem MMORPG-Sandkasten, also einer Umgebung für Mehrspieler-Online-Rollenspiele. Hier gibt es abbaubare Ressourcen, herstellbare Gegenstände, zu bekämpfende Feinde und Teamkollegen an verschiedenen Orten. Die Handlungen der intelligenten Agenten verändern die Umgebung und beeinflussen auch, was die anderen Mitglieder im nächsten Schritt tun können.
Das Spiel bietet durchführbare und beobachtbare Kooperationsszenarien; die Evaluierung konzentriert sich darauf, ob das Team das gemeinsame Ziel bis zur Vollendung vorantreiben kann.
Der im Papier vorgestellte Aufgabensatz besteht aus 100 manuell entworfenen Aufgaben und 100 erweiterten Varianten, die Typen wie Kampf, Herstellung, Abbau, Handel, Erkundung, Überleben, Bau und Koordination abdecken. Die Aufgaben erfordern die Beteiligung von 3 bis 20 intelligenten Agenten, und viele Aufgaben umfassen aufeinanderfolgende Ressourcenübergaben und Handlungsabhängigkeiten.
Dieses Design verwandelt die Zusammenarbeit von einem dialogartigen, vernünftig klingenden Gespräch in eine Reihe von Handlungen, die tatsächlich stattfinden müssen.
Drei Designpunkte
Die Kooperationsprobleme sichtbar machen
Zuerst kommt die Rollenasymmetrie. Verschiedene intelligente Agenten besitzen unterschiedliche Fähigkeiten, Gegenstände und Ausgangsbedingungen. Das Team muss die Arbeit nach diesen Unterschieden arrangieren, statt alle Mitglieder dieselben Aktionen ausführen zu lassen.
Bei der Aufgabe zum Herstellen des Zauberstabs bilden Holzfällung, Verarbeitung und Herstellung eine Abhängigkeitskette. Selbst wenn jedes Mitglied das endgültige Ziel kennt, muss das Team noch das Problem lösen: „Wer macht zuerst, wem wird es übergeben und wann wird es übergeben?“.
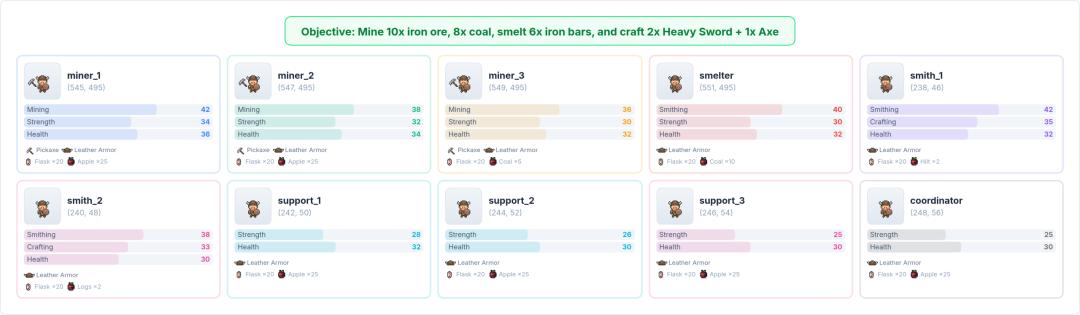
Abbildung 2|Ein weiteres Aufgabenbeispiel: Zehn intelligente Agenten übernehmen Verantwortlichkeiten wie Bergbau, Schmelzen, Schmieden, Unterstützung und Koordination, um gemeinsam das Ziel der Herstellung von Gegenständen zu erreichen. Die Rollenkonfiguration macht die Arbeitsteilung und Ressourcenübergabe zu einem Teil der Aufgabe.
Zweitens kommt die Black-Box-Interaktion. Intelligente Agenten können den internen Denkzustand ihrer Teamkollegen nicht direkt lesen. Sie müssen durch Umgebungsbeobachtungen, Chats und Handlungsergebnisse beurteilen, was andere Mitglieder tun. Das macht „Ich dachte, der Teamkollege hätte es schon erledigt“ zu einer echten Ursache für Misserfolge.
Drittens kommt die mehrstufige Durchführung. Ein Plan zu Beginn kann nicht alle nachfolgenden Veränderungen abdecken. Das Team muss den Zustand während der Durchführung ständig aktualisieren: Sind die Ressourcen vorhanden, brauchen die Teamkollegen Unterstützung, ist die ursprüngliche Arbeitsteilung noch gültig? Die Hauptaufgabe im Papier sieht ein Ausführungsbudget von mehreren Dutzend Runden vor, das von den intelligenten Agenten verlangt, die Koordination bei mehreren Übergaben aufrechtzuerhalten.
Um die Störungen durch niedriggradige Bedienungen zu reduzieren, stellt AgentWorld 13 hochgradige API-Tools zur Verfügung. Beispielsweise können Abbau- oder Angriffstools die Navigation und spezifische Ausführungsabläufe kapseln, sodass das Modell mehr Entscheidungen auf „Was ist im nächsten Schritt zu tun?“ und „Mit wem soll zusammengearbeitet werden?“ richten kann.
Das bedeutet nicht, dass die Evaluierung die Einflüsse von Planung und Tool-Nutzung vollständig ausschließt, aber sie macht die Kooperationsprobleme leichter zu beobachten und zu analysieren.
Die besten Teams erledigen etwa die Hälfte der Aufgaben
Mehr Chats sind nicht unbedingt besser
In einer einheitlichen Prompt-Vorlage, Tool-Definition und Interaktionsprotokoll wurden Gemini 3 Flash, Claude Haiku 4.5, GPT-5 Mini und DeepSeek R1-70B evaluiert.
Im Hauptaufgabensatz lagen die Aufgabenerfolgsraten der vier Modelle bei 52,0 %, 45,0 %, 36,0 % bzw. 20,0 %. Im erweiterten Aufgabensatz betrugen die entsprechenden Erfolgsraten 24,0 %, 26,0 %, 21,0 % bzw. 10,0 %.
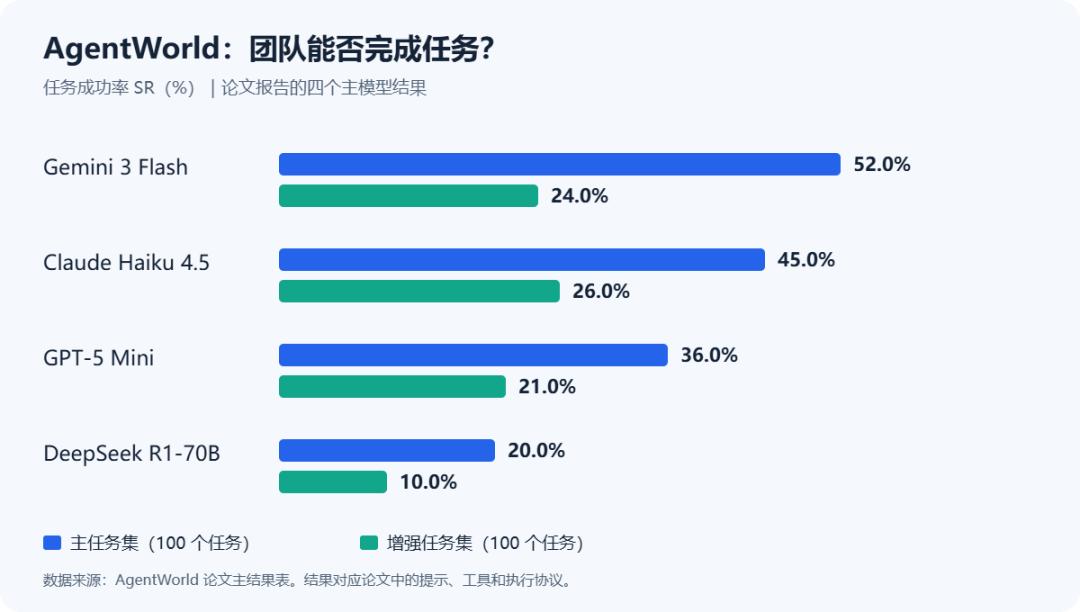
Abbildung 3|Neu gezeichnet nach der Hauptergebnistabelle des Papiers. Hier werden die Leistungen der von den jeweiligen Modellen angetriebenen Teams unter den im Papier festgelegten Einstellungen verglichen; dies stellt keine Beurteilung der oberen Fähigkeitsgrenze aller Agentensystemdesigns dar.
Bemerkenswert ist auch die Lücke zwischen „teilweise erledigt“ und „wirklich abgeschlossen“. Bei Gemini 3 Flash lag die teilweise Erfolgsrate im Hauptaufgabensatz bei 71,5 %, die vollständige Aufgabenerfolgsrate bei 52,0 %. Dass das Team einige Zwischenziele vorantreibt, garantiert nicht, dass die endgültige Ressourcenübergabe oder der Herstellungsschritt abgeschlossen werden kann.
Die Kommunikationsmenge zeigt auch keine einfache Beziehung „je mehr, desto besser“. GPT-5 Mini sendete durchschnittlich 44,1 Chat-Nachrichten pro Hauptaufgabe, aber die Erfolgsrate betrug 36,0 %; Gemini 3 Flash sendete durchschnittlich 11,0 Nachrichten und erreichte eine Erfolgsrate von 52,0 %.
Diese Ergebnisse beweisen nicht, dass weniger Chats die Erfolgsrate erhöhen, aber sie erinnern uns daran: Die Anzahl der Nachrichten kann die Qualität der Zusammenarbeit nicht direkt ersetzen.
Es lohnt sich mehr zu beachten, ob eine Nachricht gültige Informationen aktualisiert, Mehrdeutigkeiten in der Arbeitsteilung beseitigt und der Empfänger daraufhin Handlungen durchführt.
Über die Aufgabenerfüllung hinaus muss man fragen: Welche Handlungen haben geholfen?
Die bloße Statistik der Erfolgsrate reicht nicht aus, um die Arbeitsweise des Teams zu beschreiben.
Zwei Teams haben beide die Aufgabe erledigt, eines davon hat eine klare Arbeitsteilung und reibungslose Übergaben, das andere hat viele wiederholte Abbauvorgänge, nutzloses Warten und Informationsmissverständnisse erlebt. Wenn man nur das Endergebnis betrachtet, erhalten beide dasselbe Erfolgslabel.
Aus diesem Grund wird im Papier Causal Collaboration Effectiveness (CCE, Kausale Kooperationseffektivität) vorgeschlagen.
Sie blickt zurück von dem endgültig vom Team erreichten Ziel und berechnet, wie viele Handlungen als förderlich für dieses Ergebnis eingestuft werden.
Die Erfolgsrate beantwortet die Frage „Hat das Team die Sache geschafft?“, während CCE weiter fragt „Welche Handlungen haben beim Erledigen dieser Sache geholfen?“. Die von ihr betrachteten Beiträge beschränken sich nicht auf den letzten Schritt zur Aufgabenerfüllung, sondern umfassen auch Vorbereitungsarbeiten, die Materialien, Bedingungen oder gültige Informationen für nachfolgende Handlungen liefern.
Sie beginnt mit der Handlung zur Zielerreichung und geht zeitlich rückwärts zurück: Auf welche Materialien stützt sich diese Herstellung? Von welcher Übertragung stammen die Materialien? Auf deren Abbau oder Verarbeitung stützt sich die Übertragung? Der Algorithmus nutzt große Sprachmodelle, um die kausalen Abhängigkeiten zwischen den Kandidatenhandlungen zu beurteilen und schrittweise einen Handlungsbeziehungsgraphen aufzubauen.
