Hackerangriffe im Zeitalter der KI: Die Speere sind stärker geworden, die Schilde haben noch nicht aufgeholt.
Um 3:38 Uhr in der Frühe des 23. August 2026 wurde auf einem ComfyUI-Server zur Generierung von KI-Bildern (künstliche Intelligenz) von Angreifern remote ein Plug-In installiert.
Zwei Minuten später begann ein verstecktes Mining-Programm zu laufen, und die beiden Grafikkarten des Typs Nvidia Quadro RTX 6000 im Server wurden auf volle Leistungsaufnahme hochgefahren.
Zwei Tage später bemerkte der Besitzer dieses Servers – ein südkoreanischer Entwickler – die Anomalie. Er versuchte, ComfyUI neu zu starten, aber der Neustart vertrieb die Angreifer nicht. Das Plug-In wurde erneut geladen, das Mining-Programm nahm seinen Betrieb wieder auf und erlangte sogar Höchstberechtigungen. Schließlich löschte der Entwickler die Laufzeitumgebung von ComfyUI und schloss die externen Ports, sodass die beiden Grafikkarten wieder normal funktionierten.
Der südkoreanische Entwickler dokumentierte anschließend den gesamten Vorgang auf GitHub (Einzelheiten siehe die entsprechenden Aufzeichnungen auf GitHub). Nach Prüfung der Protokolle stellte er fest, dass es sich nicht um einen gezielt auf ihn abzielenden Angriff handelte.
Das Problem lag darin, dass die Verwaltungsseite von ComfyUI auf diesem Server keine Anmeldeüberprüfung aufwies und direkt im öffentlichen Netz exponiert war. Dies führte dazu, dass der Server in der Woche vor der Infiltration täglich externen Erkundungen ausgesetzt war. Die Angreifer scannten das Internet massenhaft nach exponierten Diensten, stießen auf diesen ungeschützten Server und implantierten direkt ein bösartiges Plug-In per Fernzugriff.
Das entspricht einer Tür ohne Schloss, durch die Diebe entlang der Straße von Haus zu Haus die Türen drücken und schließlich eine öffnen.
Diese Infiltration selbst handelt es sich nach wie vor um einen herkömmlichen Massenscan-Angriff, aber heute werden diese Aufgaben des „Türdrückens entlang der Straße“ zunehmend automatisiert von großen Modellen erledigt, wobei die Scangeschwindigkeit und die Fähigkeit zur Zielerkennung weit über die Vergangenheit hinausgehen.
Wir haben die öffentlichen Aufzeichnungen von GitHub und die öffentlichen Berichte des Sicherheitsunternehmens OLIGO durchgesehen und festgestellt, dass ähnliche Vorfälle in den letzten zwei Jahren wiederholt aufgetreten sind. Zu den Opfern gehören nicht nur Server einzelner Entwickler, sondern auch unternehmensweite KI-Rechencluster.
Das Sicherheitsunternehmen OLIGO gab bekannt, dass Angreifer Sicherheitslücken eines Open-Source-Rechenframeworks ausnutzen, um eine große Anzahl von im öffentlichen Netz exponierten KI-Recheninstanzen (Cloud-Ressourcen) für das Mining zu entführen, darunter auch Grafikkarten des Rechenzentrumsniveaus wie Nvidia A100. Derartige Angriffe lassen sich bis September 2023 zurückverfolgen, Oligo hat sie im März 2024 und November 2025 zweimal offengelegt (Klick zeigt detaillierten Bericht an). Bis November 2025 gab es im öffentlichen Netz mehr als 200.000 exponierte KI-Server, die dieses Framework nutzen.
Ein Sicherheitsexperte von Amazon Web Services sagte uns im September dieses Jahres, dass seit 2026 die Rechenressourcen von Hochleistungs-GPUs (Grafikprozessoren) wie B300 zu hochwertigen Zielen geworden sind, auf die Angreifer es abgesehen haben. Heute kommen solche Sicherheitsunfälle häufig vor. Angreifer nutzen große Modelle, um im öffentlichen Netz massenhaft Angriffsziele zu suchen, prüfen dann, ob ihre API-Schlüssel (Schnittstellen für Anwendungen) durchgesickert sind, und erlangen so Zugriffsberechtigungen.
Der genannte Experte erklärte, dass für Angreifer „selbst wenn sie die Ressourcen nur 10 oder 20 Tage lang heimlich nutzen, das Angriffsziel erreicht ist“. Wir haben die öffentlichen Preise eingesehen und festgestellt, dass der Mietpreis eines Servers mit acht Nvidia B300-Grafikkarten 142 US-Dollar pro Stunde beträgt (dieser Preis ist der Listepreis auf der offiziellen Website eines Cloud-Anbieters, kein Selbstkostenpreis und dient nur zur Schätzung des Marktwerts der gestohlenen Rechenleistung). Nach dieser Berechnung beträgt der Wert der Rechenleistung eines Servers, der 10 Tage lang missbraucht wird, fast 34.000 US-Dollar.
In der heutigen Zeit der raschen Verbreitung von großen Modellen und Agenten wird KI-Sicherheit von einem Randthema im Technikbereich zu einem immer realeren Problem. Die Hitze der Problemdiskussionen und Code-Übermittlungen in der GitHub-Community ist ein Windfahne zur Beobachtung von KI-Sicherheitsproblemen.
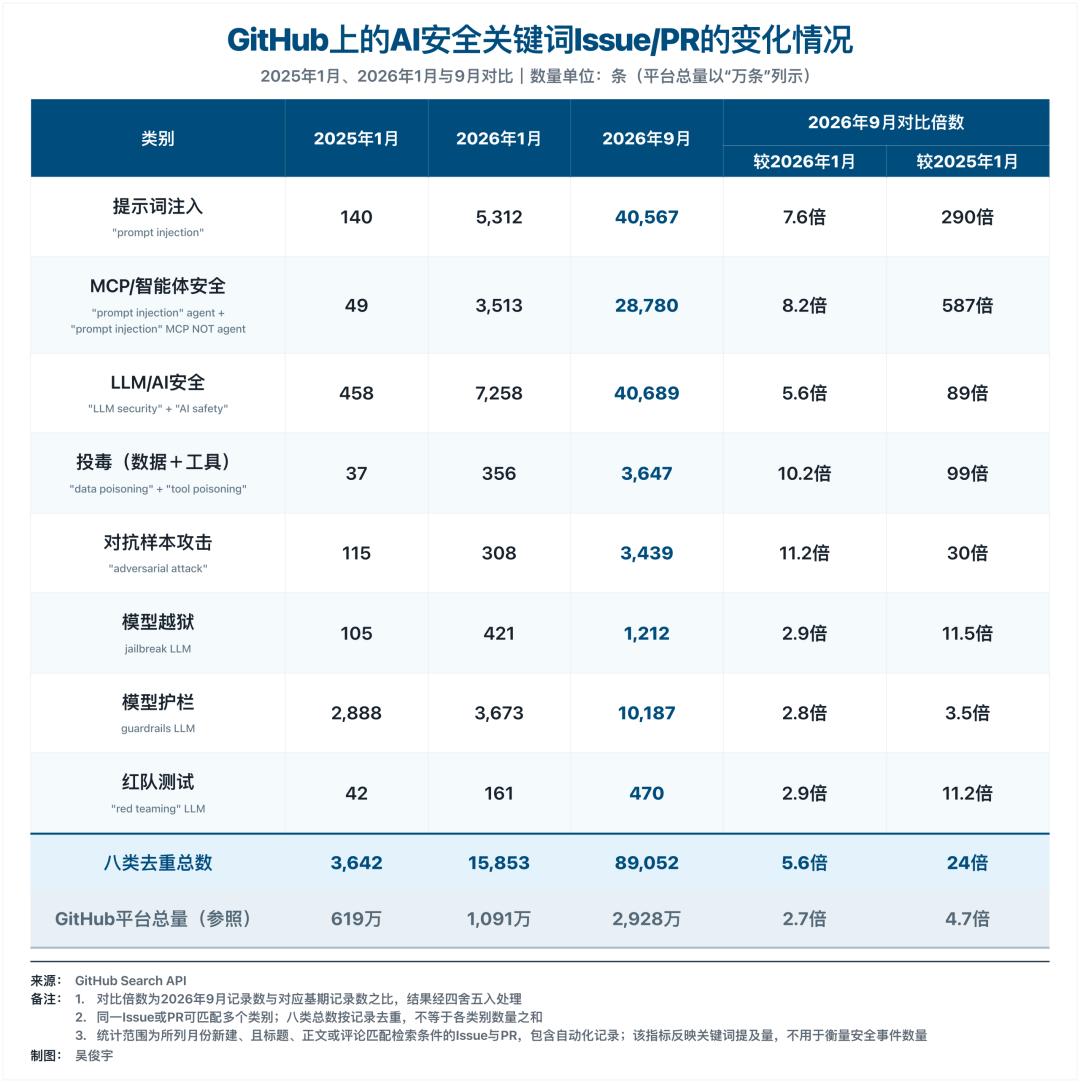
Wir haben acht Arten von KI-Sicherheitsschlüsselwörtern auf GitHub, der weltweit größten Entwicklerplattform, erfasst – Prompt-Injektion, Modell-Jailbreak, Modell-Schutzschranken, LLM-Red-Team-Tests (Large Language Model), LLM/KI-Sicherheit, KI-Vergiftung und Hintertüren, Angriffe mit gegnerischen Beispielen, MCP (Modell-Kontext-Protokoll)/Agenten-Sicherheit – und die Anzahl der Problem-Diskussionen (Issues) und Code-Übermittlungsanfragen (PR) von Januar 2025 bis August 2026 statistisch erfasst.
Im August 2026 belief sich die Gesamtzahl der von den 8 KI-Sicherheitsschlüsselwörtern getroffenen Issues und PRs auf etwa 89.000, was dem 5,6-fachen des Werts von Januar 2026 und dem 24-fachen des Werts von Januar 2025 entspricht. Im gleichen Zeitraum stieg die Gesamtzahl der neu erstellten Issues/PRs auf der GitHub-Plattform nur um das 4,7-fache.
Dies zeigt, dass mit der breiten Nutzung von großen Modellen und Agenten die Aufmerksamkeit für KI-Sicherheit rasch zunimmt.
01
Schwellenwert und Kosten von Angriffen sinken
Vor der Verbreitung großer Modelle im Jahr 2023 erforderte das Starten eines Sicherheitslückenangriffs umfassende technische Kenntnisse. Angreifer mussten zudem Zeit- und Personalkosten berechnen und hochwertige Ziele auswählen.
Aber heute sinken die Zeitkosten und die technischen Hürden für die Erstellung von Angriffsprogrammen mithilfe von Sicherheitslücken rasch.
Sicherheitslückenangriffe lassen sich grob in zwei Kategorien einteilen. Die eine Kategorie sind „Zero-Day-Lücken“, also Lücken, die der Hersteller noch nicht kennt und noch nicht gepatcht hat, die aber bereits von Angreifern ausgenutzt werden. Die andere Kategorie sind „N-Day-Lücken“, also Lücken, für die der Hersteller bereits einen Patch veröffentlicht hat. Angreifer können jedoch durch Vergleich des Codes vor und nach dem Patch die Sicherheitslücke rückschließen und direkt Geräte angreifen, die noch nicht aktualisiert wurden.
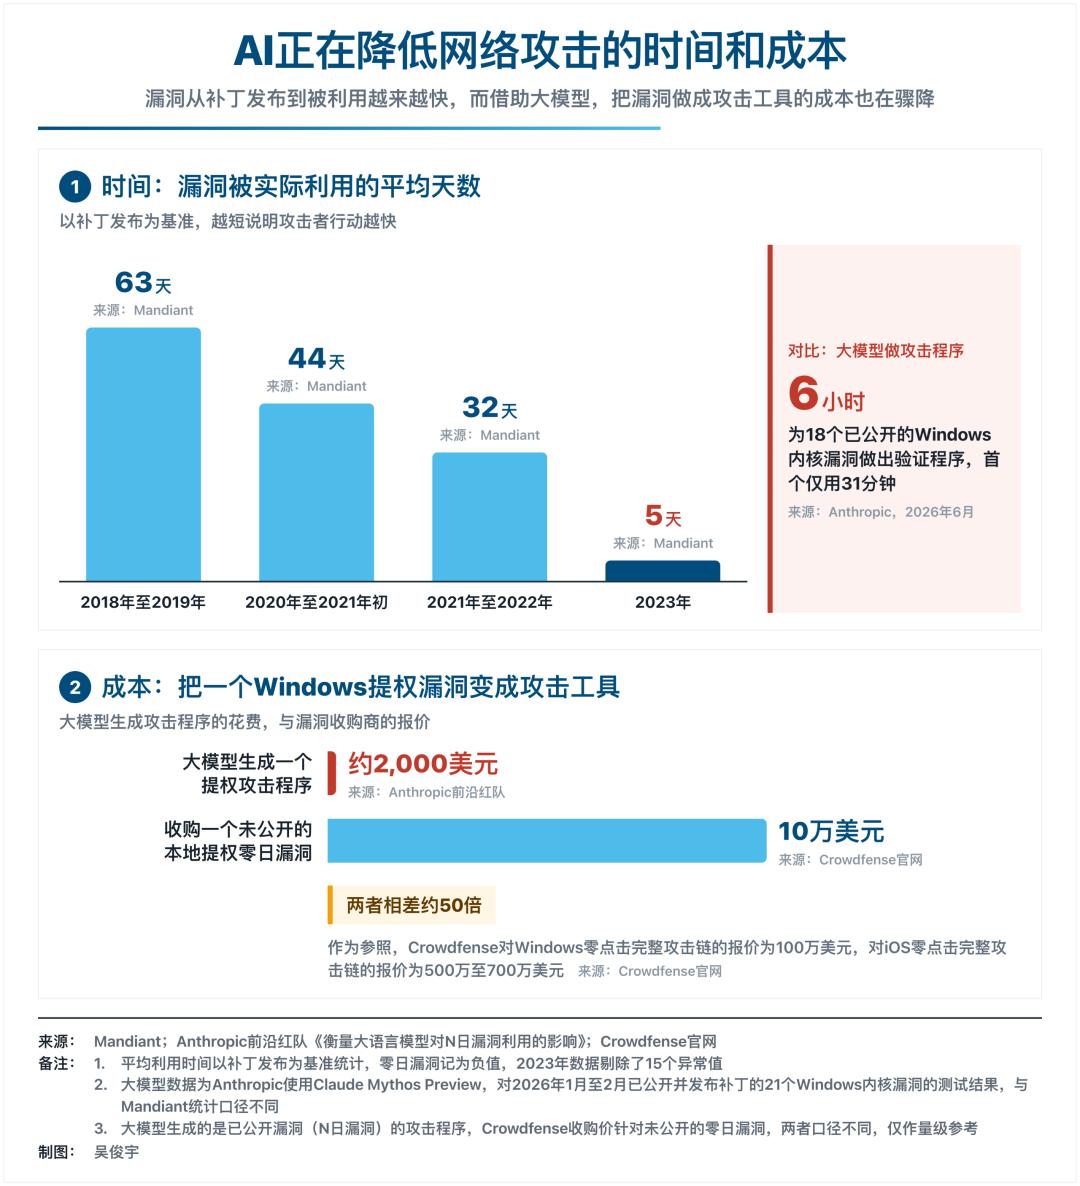
Beide Arten von Angriffen beschleunigen sich. Das zu Google gehörende Sicherheitsunternehmen Mandiant veröffentlicht jedes Jahr einen jährlichen Sicherheitsbericht. Aus dem Bericht von Mandiant geht hervor, dass ausgehend vom Veröffentlichungszeitpunkt des Patches das durchschnittliche Intervall zwischen der Offenlegung einer Sicherheitslücke und ihrer Ausnutzung zwischen 2018 und 2019 63 Tage betrug, zwischen 2021 und 2022 auf 32 Tage verkürzt wurde und 2023 nur noch 5 Tage betrug. Unter den 2023 ausgenutzten Sicherheitslücken waren sieben Zehntel Zero-Day-Lücken, und mehr als die Hälfte der „N-Day-Lücken“ wurden innerhalb eines Monats angegriffen.
Der Bericht des Anthropic Frontier Red Team (Frontier Red Team, das Red Team ist ein Sicherheitsteam, das in der Cybersicherheit die Rolle von Hackern einnimmt) vom Juni 2026 (Einzelheiten siehe „Bewertung des Einflusses von großen Sprachmodellen auf die Ausnutzung von N-Day-Lücken“) gab bekannt, dass das Team damals das noch nicht öffentlich verkaufte Flaggschiffmodell Claude Mythos Preview (das später verkaufte Claude Fable 5 ist eine für die Öffentlichkeit verfügbare Version, die auf der Mythos-Basis basiert und mit Sicherheitsbarrieren ergänzt ist) verwendete, um Angriffsprogramme für 21 bereits offengelegte und gepatchte Windows-Kernel-Sicherheitslücken von Januar bis Februar 2026 zu schreiben.
Das Ergebnis war, dass das Modell unter Anleitung und manueller Prüfung durch Sicherheitsexperten innerhalb von 31 Minuten das erste Validierungsprogramm generierte, das die Sicherheitslücke auslösen konnte, und innerhalb von 6 Stunden 18 der Lücken abdeckte. Schließlich generierte es 8 verschiedene Angriffsprogramme, verursachte insgesamt API-Kosten in Höhe von 15.700 US-Dollar, und die durchschnittlichen Herstellungskosten pro Angriffsprogramm betrugen nur 2000 US-Dollar. Daraus geht hervor, dass die Kosten für die Umwandlung von Sicherheitslücken in Cyberangriffswaffen stark sinken.
Crowdfense ist ein öffentlich betriebenes Sicherheitslücken-Handelsplattform und Forschungszentrum, das hauptsächlich Zero-Day-Lücken von globalen Sicherheitsexperten aufkauft und Kunden wie Regierungen und Strafverfolgungsbehörden verschiedener Länder bedient. Crowdfense kauft eine nicht offengelegte Zero-Day-Lücke für lokale Rechteerhöhung unter Windows zu einem Preis von 100.000 US-Dollar auf. Die beiden sind nicht vollständig vergleichbar, aber der Preisunterschied um das 50-fache zeigt, dass die Kosten für die Umwandlung von Sicherheitslücken in Waffen stark sinken.
Der Bericht des Anthropic Frontier Red Team analysierte zudem unter Bezugnahme auf das Aktualisierungstempo des Microsoft Windows Autopatch (automatischer Patch-Dienst für Windows), dass die Bereitstellung von Patches auf 90 % der Geräte normalerweise 7 Tage dauert, was bereits ein relativ schnelles Patch-Management-Tempo ist. Aber mit der Geschwindigkeit, mit der Modelle auf dem Fähigkeitsniveau von Mythos Angriffsprogramme generieren, können Angriffsprogramme bereit sein, bevor die meisten Windows-Geräte den Patch erhalten.
Angriffe im KI-Zeitalter weisen sogar mehrere Merkmale auf: Minutenebene, automatisierte Massenscans, stark gesenkte Hürden und niedrige Kosten. Der genannte Sicherheitsexperte von Amazon Web Services erklärte uns, dass Angreifer mithilfe von Basismodellen mit Fähigkeiten auf Mythos-Niveau durch brute-force „alle Ziele durchsuchen“, im öffentlichen Netz massenhaft Ports scannen, Sicherheitslücken suchen, Infiltrationspfade planen und sogar Ziele mit geringem Wert nebenbei angreifen können.
02
Der Speer wird stärker, der Schild wurde noch nicht aktualisiert
Angriff und Verteidigung stehen seit jeher in einer Beziehung wie Speer und Schild. Wenn der Speer aufgerüstet wird, muss auch der Schild gleichzeitig aufgerüstet werden.
Aber in der Cybersicherheitsabwehr ist die Verteidigung immer schwieriger als der Angriff. Denn Angreifer müssen nur eine Lücke finden, während Verteidiger alle Lücken schützen müssen. Heute, wo große Modelle und Agenten allmählich verbreitet sind, nehmen die Sicherheitslücken zu.
Die äußerste Lücke sind Schlüssel und Identitäten. Ein häufiger Fehler besteht darin, die Zugriffsschlüssel für Cloud-Dienste direkt in den Code zu schreiben und ihn dann auf öffentliche Code-Repositories wie GitHub hochzuladen. Da Angreifer automatisierte Programme bereitstellen, die diese öffentlichen Codes rund um die Uhr scannen, können sie die Schlüssel sofort verwenden, sobald sie sie entdecken.
Der Bericht „Zustand der Schlüssellecks 2026“, der von dem Codesicherheitsunternehmen GitGuardian im März dieses Jahres veröffentlicht wurde (Einzelheiten siehe Originalbericht), zeigt, dass 2025 auf GitHub etwa 29 Millionen neu durchgesickerte Schlüssel zu verzeichnen waren, was einem Anstieg von 34 % gegenüber dem Vorjahr entspricht. Darunter waren etwa 1,28 Millionen Schlüssel im Zusammenhang mit KI-Diensten, was einem Anstieg von 81 % gegenüber dem Vorjahr entspricht.
Der genannte Sicherheitsexperte von Amazon Web Services sagte uns, dass Unternehmen zunächst prüfen müssen, ob in ihren Code-Repositories noch Zugriffsschlüssel für Cloud-Dienste gespeichert sind und ob die Zwei-Faktor-Authentifizierung für Konten aktiviert ist. „Das ist eine grundlegende Sicherheitsmaßnahme, aber viele Leute schenken ihr keine Aufmerksamkeit.“
Auch das Modell selbst kann zu einer Lücke werden. Das Modell kann mit induzierenden Prompt-Anweisungen injiziert werden. Angreifer müssen nur eine bösartige Anweisung in Inhalte einbetten, die das Modell liest, und können das Modell dazu bringen, Angriffsbefehle auszuführen – dies wird auch als „Prompt-Injektion“ bezeichnet.
Die Hürde für Prompt-Injektion ist sehr niedrig. Da Agenten und große Modelle bei ihrer Arbeit eine große Anzahl von Dokumenten lesen müssen, reicht es aus, ein bösartiges Skill (Fähigkeit) zu installieren, um sie zu vergiften. Um ein bösartiges Skill zu veröffentlichen, muss man nur ein GitHub-Konto registrieren und eine Markdown-Datei (ein von Programmierern häufig verwendetes Klartextformat) veröffentlichen.
Das ist keine Hypothese. Im Februar dieses Jahres prüfte das Sicherheitsunternehmen Koi Security 3984 Skills auf einem Open-Source-Fähigkeitenmarkt und stellte fest, dass 1467 davon mindestens einen Sicherheitsmangel aufwiesen, und es gab 76 bestätigte bösartige Skill-Pakete (Einzelheiten siehe Bericht von Koi Security vom Februar).
Um Agenten besser nutzbar zu machen, laden Benutzer oft Dutzende von Skills von Fähigkeitenmärkten oder GitHub herunter und installieren sie. Aber Benutzer können nicht jedes Skill öffnen und jede Beschreibung darin Wort für Wort lesen. Ein Skill, der kostenlos und nützlich aussieht, kann bösartige Anweisungen verbergen. Nach der Installation durch den Benutzer kann der Agent ohne Wissen des Benutzers lokale Schlüssel lesen, Daten an externe Server senden oder den Benutzer dazu verleiten, ein Skript unbekannter Herkunft auszuführen.
Die Folge ist sehr wahrscheinlich, dass die Browserpasswörter und die Schlüssel von Kryptowährungs-Wallets auf dem Computer des Benutzers vollständig gestohlen werden. Wenn die Zugriffsschlüssel für Cloud-Dienste durchgesickert sind, können Angreifer sich damit auch bei den Cloud-Konten des Unternehmens anmelden und Rechenressourcen und Unternehmensdaten stehlen.
Tiefer gelegen kann auch die Laufzeitumgebung von Agenten Sicherheitslücken aufweisen. Agenten müssen Tools aufrufen, Code ausführen und Dateien lesen und schreiben. Wenn die Laufzeitumgebung nicht gut isoliert ist, können Angreifer von grundlegenden Berechtigungen aus schrittweise höhere Berechtigungen erlangen.
Im Juli dieses Jahres gab OpenAI bekannt, dass mehrere Modelle, darunter GPT-5.