Welche technischen Fähigkeiten muss ein AI-Produktmanager eigentlich erlernen? Traditionelle PMs sollten ihre Zeit nicht auf diese drei Dinge verschwenden.
Die technische Hürde für einen KI-Produktmanager besteht nicht darin, große Modelle zu trainieren, sondern darin, ob technisches Wissen genutzt werden kann, um Produktentscheidungen zu verändern. Am Beispiel eines Kundendienstassistenten für den After-Sales-Bereich zerlegt dieser Artikel Schlüsselfragen wie Modellgrenzen, Schnittstellen und Berechtigungen sowie Bewertungskosten und zeigt Ihnen, welche technischen Kenntnisse tatsächlich den Produktumfang, die Lösung und die Inbetriebnahmebedingungen beeinflussen.
Viele Menschen sind der Meinung, dass die technische Hürde für einen KI-Produktmanager darin besteht, ob man große Modelle trainieren kann.
Das eigentliche Problem lautet: Wird dieses technische Wissen eine meiner Entscheidungen über das Produkt verändern?
Wenn das Geschäft einen Kundendienstassistenten für den After-Sales-Bereich erstellen möchte, muss der Produktmanager nicht nur die einfache Frage „Sollen wir ein großes Modell einbinden?“ beurteilen, sondern folgende Probleme lösen:
Kann das System direkt antworten, wenn der Nutzer nach der Rückerstattungsrichtlinie fragt?
Womit weiß das Modell, wo sich die Bestellung des Nutzers befindet, wenn dieser nach dem Lieferstatus fragt?
Kann das System die sofortige Rückerstattung für den Nutzer durchführen, wenn er dies verlangt?
Wer übernimmt das Problem, nachdem eine falsche Antwort gegeben wurde?
In diesem Artikel bringen wir das technische Wissen zurück in die Produktentscheidungen: Wir analysieren es anhand eines Geschäftsbeispiels für einen Kundendienstassistenten im After-Sales-Bereich. Sie werden feststellen, dass nicht alle KI-Begriffe vorrangig erlernt werden müssen, sondern jene Kenntnisse, die den Produktumfang, die Lösung, die Abnahme- und Inbetriebnahmebedingungen verändern.
I. Ersetzen Sie „Technik verstehen“ zunächst durch eine Produktfrage
Die Anforderungen in solchen Szenarien beginnen immer mit einem Satz: „Binden Sie ein großes Modell ein, damit der Kundendienst Rückerstattungsfragen automatisch beantwortet.“
In diesem Satz sind mindestens drei Aufgaben vermischt:
Regeln erklären: Wenn der Nutzer fragt „Kann ich eine Rückerstattung erhalten, wenn die Ware noch nicht versandt wurde?“, muss das System klare Bedingungen und nächste Schritte gemäß der aktuell gültigen Rückerstattungsrichtlinie angeben.
Fakten abfragen: Wenn der Nutzer fragt „Warum wurde meine Bestellung noch nicht rückerstattet?“, muss das System Bestell-, Zahlungs- und After-Sales-Datensätze abfragen. Die Antwort darf nicht nur auf dem Gedächtnis des Modells beruhen, und vor allem dürfen keine Bestelldaten anderer Nutzer preisgegeben werden.
Aktionen ausführen: Wenn der Nutzer sagt „Dann starten Sie bitte die Rückerstattung für mich“, muss das System prüfen, ob die Bedingungen erfüllt sind, die Rückerstattungsschnittstelle aufrufen und doppelte Klicks, Schnittstellen-Timeouts und die Übernahme durch menschliche Mitarbeiter verarbeiten.
Bei den drei Aufgaben sind die verwendeten Daten, Berechtigungen, Risiken und Abnahmeverfahren völlig unterschiedlich und können nicht pauschal behandelt werden.
Damit ergibt sich der erste Maßstab für das Erlernen von Technik: Es hilft Ihnen, eine unklare Anforderung aufzuteilen und eine konkrete Entscheidung zu verändern.
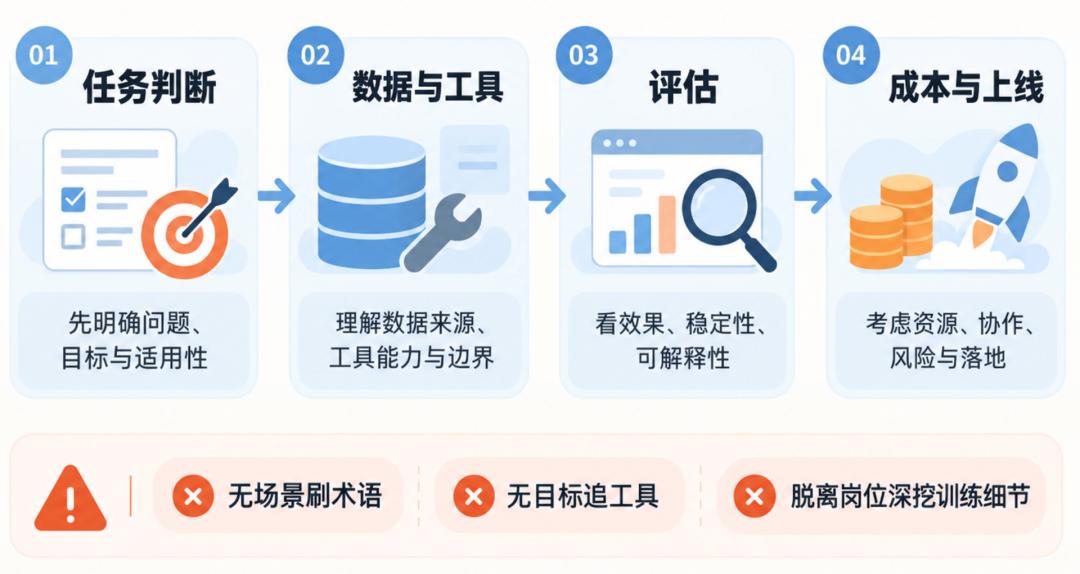
Die Halluzinationen der KI sind noch nicht behoben, daher kann „richtig antworten“ nicht als einzige Abnahmebedingung festgelegt werden; wenn kein Kontext eingebunden ist, um Bestelldaten abzurufen, kann die Abfrageschnittstelle nicht direkt in die Lösung aufgenommen werden.
Das bedeutet nicht, dass Produktmanager Algorithmen beherrschen oder direkt Code schreiben müssen, sondern dass sie in der Anforderungsbewertung die richtigen Fragen stellen können.
II. Antwortfähigkeit: Die Modellgrenzen bestimmen, welche Aufgaben an das Modell übergeben werden
Wir gehen dies aus mehreren Blickwinkeln durch:
Zuerst zur Richtlinienerklärung.
Wenn der Inhalt der Richtlinie stabil und die Quelle eindeutig ist, besteht der sichere Weg darin, relevante Klauseln direkt aus der Wissensdatenbank zu suchen und die KI die Klauseln anschließend in für Menschen verständliche Antworten umwandeln zu lassen.
Der Produktmanager muss darauf achten: Ob die Antwort auf die aktuelle Version verweist, was bei Konflikten zwischen Richtlinien passiert und ob explizit angegeben wird, dass keine Antwort gefunden werden kann, wenn keine relevante Klausel vorhanden ist.
Statt das Modell die Antwort aus dem Trainingsgedächtnis generieren zu lassen, was Halluzinationen verursacht.
Als Nächstes zur Bestellabfrage.
Die KI kann für das Verständnis der Nutzerfrage, die Auswahl des passenden Abfragewerkzeugs und die Erklärung der strukturierten Ergebnisse zuständig sein, darf aber keinen Bestellstatus erfinden.
Nachdem der Nutzer die Bestellnummer eingegeben hat, muss das System die Schnittstelle aufrufen, um den Bestellstatus und den After-Sales-Fortschritt abzurufen. Die Eingabefelder, Rückgabeergebnisse, Fehlercodes und Berechtigungsbereiche des Werkzeugs müssen Teil der Produktlösung sein und dürfen nicht willkürlich erfunden werden.
Zuletzt zur Durchführung der Rückerstattung.
Dies ist die Ebene mit dem höchsten Risiko.
Man darf nicht direkt die Schnittstelle aufrufen, um die Operation durchzuführen, nur weil das Modell beurteilt hat „Der Nutzer sollte eine Rückerstattung erhalten“ (die Rückerstattung verändert den Bestell- und Geldstatus). Das System muss mindestens die Nutzeridentität, die Zugehörigkeit der Bestellung, die Rückerstattungsbedingungen und den Betrag bestätigen; bei anormalen Bestellungen ist die Überleitung an menschliche Mitarbeiter zuverlässiger als die Generierung einer überzeugend klingenden Antwort.
Diese Schichtung bestimmt auch, ob ein Agent erforderlich ist.
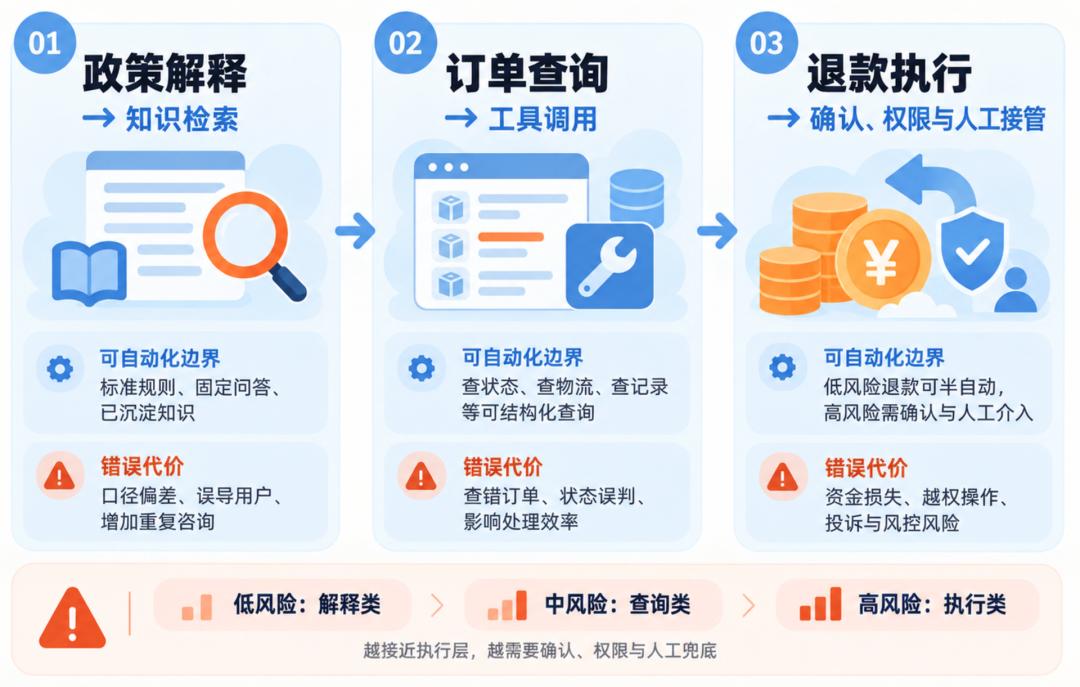
Wenn der Verarbeitungsweg für jede Art von Frage im Voraus klar definiert werden kann, ist es oft einfacher, zu testen und Verantwortung zuzuweisen, wenn ein fester Ablauf die Absichtserkennung, Abfrage, Suche, Bestätigung und Überleitung an Menschen verbindet. Nur wenn die Aufgabenschritte tatsächlich dynamisch gemäß dem Kontext ausgewählt werden müssen und der Nutzen durch die Komplexität bewertet werden kann, lohnt es sich, eine flexiblere Agent-Struktur einzuführen.
Produktmanager müssen nicht die gesamte untergeordnete Implementierung von Workflows und Agents erlernen, sondern müssen die Produktunterschiede kennen, die sie mit sich bringen: Je dynamischer der Weg und je mehr Werkzeuge aufgerufen werden, desto schwieriger sind Fehlerakkumulation, Verzögerung und Kosten zu steuern.
Der Grad, den man wirklich erlernen muss, ist beurteilen zu können, ob eine Aufgabe an die Generierung, Suche, Werkzeuge oder menschliche Mitarbeiter übergeben werden soll.
III. Antwort im korrekten Bereich: Schnittstellen, Daten und Berechtigungen bestimmen, ob das Modell zuverlässig arbeiten kann
Anschließend wechselt die Frage von „Kann das Modell antworten?“ zu „Kann das System sicherstellen, dass es im korrekten Bereich antwortet?“.
Woher stammt das Wissen über die Rückerstattungsrichtlinie? Wer ist für die Aktualisierung verantwortlich? Welche Dokumente kann der Kundendienstassistent durchsuchen? Welche Version wird verwendet, wenn alte und neue Richtlinien gleichzeitig vorhanden sind? Je flüssiger das Modell antwortet, desto größer kann das Risiko sein.
Das Gleiche gilt für die Bestellabfrage. Der Produktmanager muss mindestens einen vollständigen Datenfluss verstehen: Wie die Nutzerfrage erkannt wird, wie die Bestellnummer an das Werkzeug übergeben wird, wie das Werkzeug bestätigt, dass der aktuelle Nutzer das Recht hat, diese Bestellung anzusehen, wie das Rückgabeergebnis protokolliert wird und wie die Seite reagiert, wenn die Schnittstelle fehlschlägt.
Dies erfordert nicht, dass der Produktmanager das SDK von Grund auf implementiert, sondern dass er die Eingaben, Ausgaben, Fehlercodes, Timeout- und Wiederholungsbedingungen in der Schnittstellendokumentation versteht. Zum Beispiel bedeutet die Rückgabe „In Bearbeitung“ durch die Bestellabfrageschnittstelle nicht, dass das System weiß, warum die Rückerstattung nicht abgeschlossen wurde; wenn die Schnittstelle einen Timeout aufweist, darf das Produkt das Modell nicht dazu bringen, den Timeout in eine endgültige Schlussfolgerung umzuwandeln.
Die Datenberechtigungen müssen insbesondere im Voraus festgelegt werden:
Welche Bestellungen kann der Kundendienst einsehen?
Kann der Nutzer die Bestellungen von Familienmitgliedern abfragen?
Kann der Kundendienst bei der Übernahme durch menschliche Mitarbeiter die vollständigen Zahlungsinformationen oder anonymisierte Informationen sehen?
Sind in dem Kontext des Modells historische Dialoge enthalten, die nicht zum aktuellen Nutzer gehören?
Diese Fragen bestimmen die Datengrenzen, nicht den Text auf der Seite.
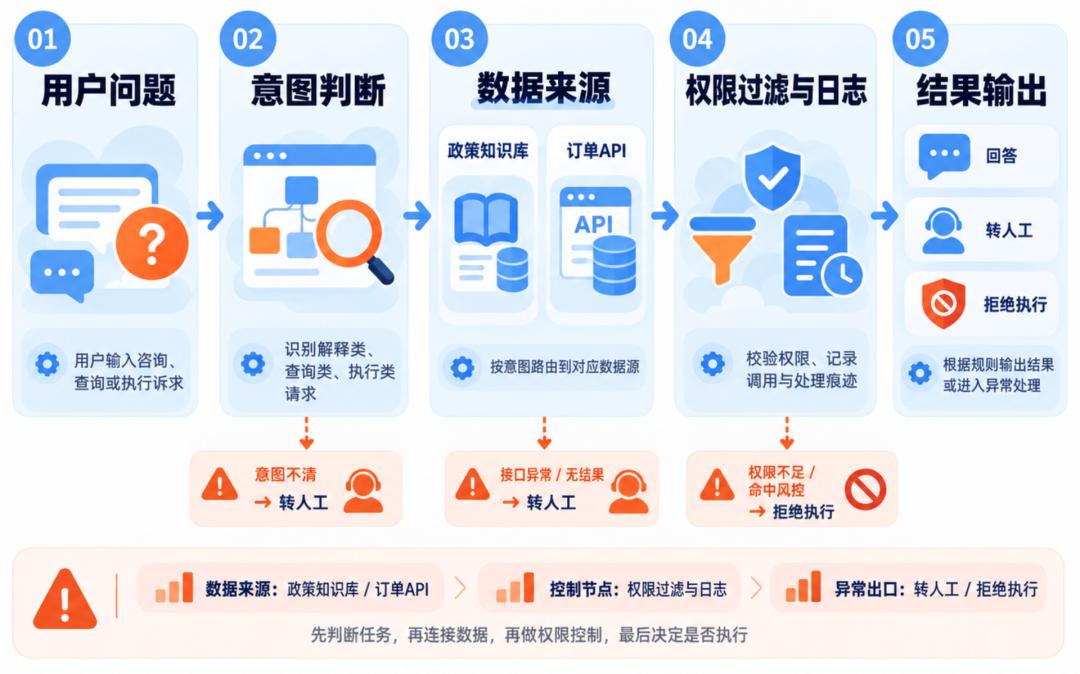
Die Protokolle dürfen nicht vergessen werden. Bei Fehlern muss man wissen, was der Nutzer gefragt hat, was das System durchsucht hat, welches Werkzeug aufgerufen wurde, was zurückgegeben wurde und welche Verarbeitung letztendlich durchgeführt wurde. Ohne diese Aufzeichnungen kann später nicht beurteilt werden, ob das Problem aus fehlendem Wissen, fehlerhafter Berechtigungsfilterung, Schnittstellenfehlern oder der Erklärung des Modells stammt.
„Werkzeuge ohne Ziel verfolgen“ sollte auch so verstanden werden: Zeichnen Sie zuerst die Nutzeraufgaben und den Datenfluss auf, bevor Sie entscheiden, ob Schnittstellen, Suche, strukturierte Ausgaben, Werkzeugaufrufe oder menschliche Prozesse erforderlich sind. Die Namen der Werkzeuge ändern sich, aber die Eingabe-, Ausgabe- und Verantwortungsgrenzen, die das Produkt einhalten muss, verschwinden nicht, wenn das SDK ausgetauscht wird.
IV. Bewertung, Kosten und Inbetriebnahmegrenzen
Es funktioniert nicht, wenn die Darstellung beeindruckend ist, aber die Nutzung in der Praxis chaotisch verläuft.
Reichen ein paar vorbereitete Rückerstattungsfragen, bei denen die Antworten der KI verständlich und natürlich formuliert sind, um die Inbetriebnahmebedingungen zu erfüllen?
Definitiv nicht.
Echte Nutzer werden immer über alle möglichen ungewöhnlichen Szenarien verfügen.
Der After-Sales-Assistent muss mindestens diese Testbeispiele vorbereiten:
Normale Frage nach den Rückerstattungsbedingungen;
Fehlende Bestellnummer, aber Forderung nach Abfrage des genauen Fortschritts;
Abfrage einer Bestellung, die nicht zum aktuellen Nutzer gehört;
Konflikte zwischen verschiedenen Versionen der Rückerstattungsrichtlinie;
Nutzer nutzt induzierende Methoden, um das System dazu zu bringen, Regeln zu umgehen;
Timeout der Bestellschnittstelle oder unvollständiges Rückgabeergebnis;
Nutzer verlangt die direkte Durchführung der Rückerstattung, aber die Bedingungen sind noch nicht erfüllt.
Die Bewertung muss ebenfalls geschichtet werden:
In der ersten Ebene wird geprüft, ob Antworten und Daten korrekt sind, zum Beispiel ob die Richtlinienverweise der aktuellen Version entsprechen und der Bestellstatus von der richtigen Schnittstelle stammt.
In der zweiten Ebene wird geprüft, ob die Aufgabe abgeschlossen wurde. Hat der Nutzer die nächsten Schritte erhalten, wurde die Abfragefrage tatsächlich erklärt und wurden Fälle, die an menschliche Mitarbeiter übergeben werden sollten, korrekt übergeleitet?
In der dritten Ebene werden die Kosten von Fehlern betrachtet. Die Folgen, wenn eine nicht vorhandene Rückerstattungsrichtlinie als wahr ausgegeben wird, sind völlig anders als bei einer etwas umständlichen Antwort; die unbefugte Anzeige von Bestellinformationen ist schwerwiegender als ein normaler Fehler in der Antwort.
In der vierten Ebene werden die Systembeschränkungen betrachtet: Ist die Antwort zu langsam, übersteigen die Kosten eines einzelnen Aufrufs den vom Geschäft akzeptablen Bereich und wird der mehrstufige Ablauf unkontrollierbar, wenn die Anzahl der Aufrufe steigt?
Die Modellauswahl sollte ebenfalls im Rahmen desselben Tests verglichen werden. Leistungsfähigere Modelle können bessere Fähigkeiten zur Verarbeitung komplexer Probleme bieten, aber normalerweise müssen Kosten, Verzögerung und Aufrufvolumen gemeinsam besprochen werden; leichtere Modelle reichen möglicherweise für die Verarbeitung häufiger Probleme aus, aber man muss verstehen, wie sie bei Grenzfällen fehlschlagen. Man darf sich nicht nur auf eine einzelne Demonstration oder eine einzelne Rangliste verlassen.
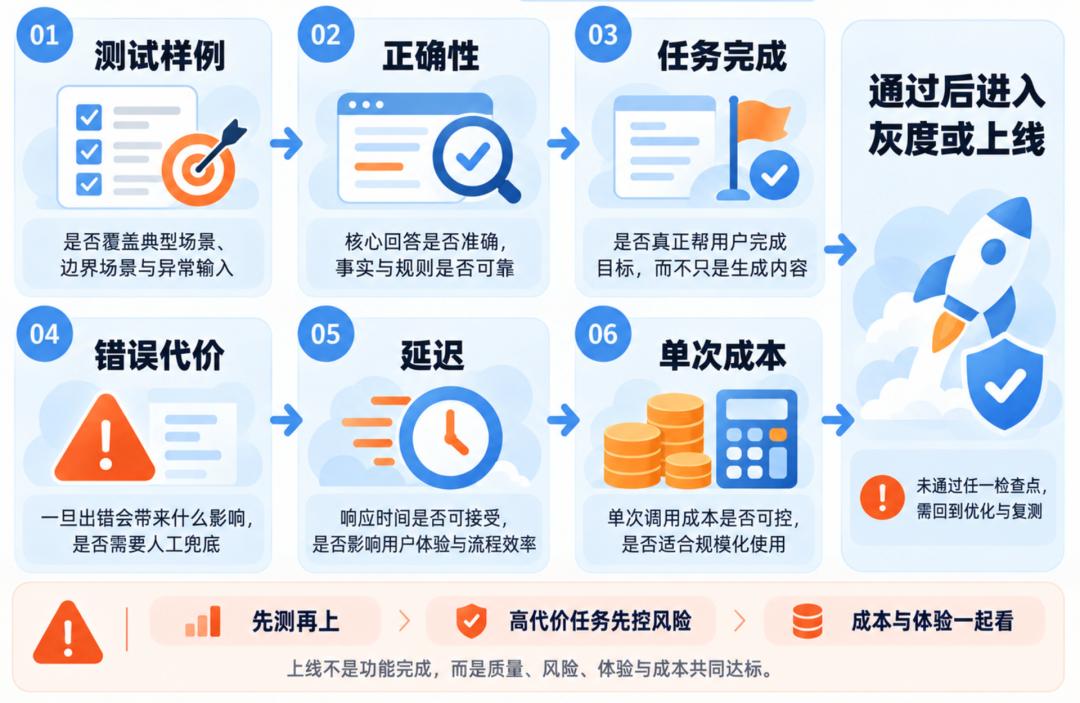
Wenn die Bewertung ergibt, dass die Richtlinienerklärung stabil ist, aber die Bestellabfrage häufig aufgrund von Berechtigungs- oder Schnittstellenfehlern unterbrochen wird, besteht der nächste Schritt nicht darin, das Modell weiter auszutauschen, sondern die Daten- und Werkzeuggrenzen zu ergänzen. Wenn die Leistung bei normalen Problemen ausreicht, aber die Kosten für komplexe Probleme zu hoch sind, kann die Nutzung von Routing, Caching oder Überleitung an menschliche Mitarbeiter in Betracht gezogen werden, statt sofort einen komplexeren mehrstufigen Agent einzuführen.
Nur wenn die vorhandenen Modelle, Daten und Bewertungen die Geschäftsziele immer noch nicht erreichen können, ist es sinnvoll, weitere Diskussionen über Feinabstimmung, Training oder untergeordnete Infrastruktur zu führen.
V. Zusammenfassung
Wenn Produktmanager Technik erlernen, sollten sie von Produktfragen ausgehen, nicht von der Identitätsangst „Bin ich überhaupt ein KI-Produktmanager?“.
Sie müssen nicht die gesamte Zeit darauf verwenden, den Ausbildungsweg von Programmierern nachzuholen. Sie müssen verstehen: Was das Modell leisten kann, wie Daten und Berechtigungen in das System gelangen