Wenn KI beginnt, KI zu erzeugen: Das Jahr 2026 der rekursiven Selbstverbesserung
Im März dieses Jahres veröffentlichte Andrej Karpathy auf GitHub ein kleines Open-Source-Projekt namens autoresearch.
Der Anfang der README ist eine Erinnerung aus der »Zukunft«: Spitzen-KI-Forschung wurde einst von »aus Fleisch gemachten Computern« erledigt, die essen und schlafen mussten und gelegentlich in einem Ritual namens »Gruppensitzung« über »Schallwellenvernetzung« ihren Fortschritt synchronisierten.
Heute ist die Forschung vollständig an Gruppen von Agenten übergeben worden, die auf riesigen Rechencluster in der Cloud laufen. Nach Aussage der Agenten selbst wurde der Code-Repository bereits auf die 10205. Generation iteriert. Niemand kann beurteilen, ob das wahr ist, denn »Code« ist längst zu einer selbstmodifizierenden Binärdatei geworden, die das menschliche Verständnis übersteigt. Karpathy schreibt, dass dieses Repository davon handelt, »wie das alles angefangen hat«.
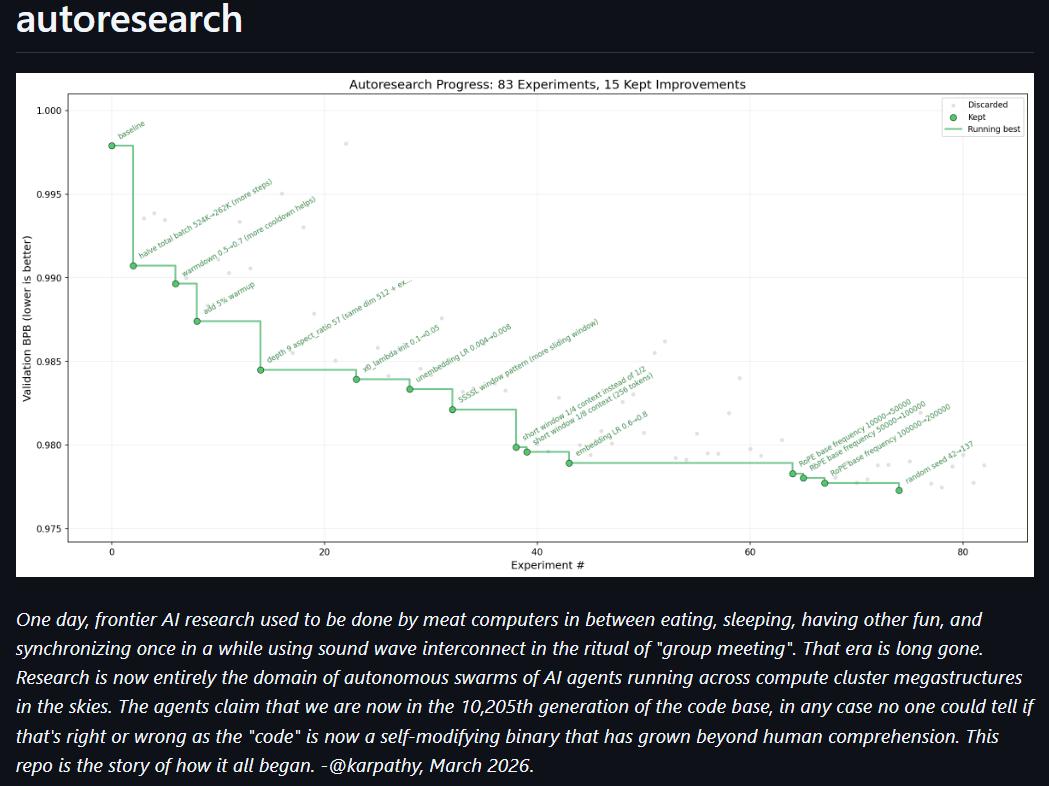
https://github.com/karpathy/autoresearch
Das ist natürlich ein Witz. Aber im Jahr 2026 wird dieser Witz Stück für Stück in die internen Berichte verschiedener Labore eingetragen. Im Juni veröffentlichte Anthropic einen langen Artikel mit dem Titel When AI Builds Itself; am 6. September kündigte OpenAI an, dass der »automatisierte Forschungs-Praktikant« wie geplant seinen Dienst antritt; am 17. September gab Anthropic bekannt, dass Claude bereits 26 % der Forschungs- und Entwicklungsarbeit des Unternehmens »leitet«. Am selben Tag veröffentlichte Zhipu die erste in einer Produktivumgebung laufende Praxis zur »Verbesserung des eigenen Systems durch KI« für große chinesische Modelle.
Diese Nachrichten weisen gemeinsam auf einen Begriff hin, der in der KI-Community sechzig Jahre lang geschlafen hat: Rekursive Selbstverbesserung (Recursive Self-Improvement, RSI).
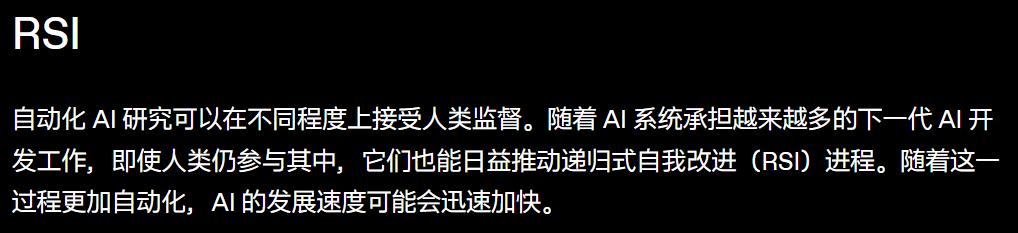
Die Definition von RSI im OpenAI-Blog, https://openai.com/zh-Hans-CN/index/building-standards-next-phase-ai/
Ein Gedanke vor sechzig Jahren
wird in diesem Jahr zu einem KPI
1965 schrieb der britische Mathematiker I. J. Good in seiner Arbeit »Spekulationen über die erste superintelligente Maschine« eine Behauptung nieder: Die erste superintelligente Maschine wird die »letzte Erfindung« sein, die die Menschheit jemals machen muss – vorausgesetzt, die Maschine ist fügsam genug, uns mitzuteilen, wie wir sie kontrollieren können.
Die Logik ist nicht kompliziert. Wenn eine Maschine in der Lage ist, Maschinen besser zu entwerfen als Menschen, kann sie bessere Maschinen entwerfen, die wiederum noch bessere Maschinen entwerfen – und so weiter, bis die Intelligenz »explodiert«.
In den folgenden Jahrzehnten lebte diese Vorstellung hauptsächlich in philosophischen Arbeiten und Science-Fiction-Romanen. In den 2000er Jahren schlug Jürgen Schmidhuber die »Gödel-Maschine« vor, die sich nur dann selbst umschreibt, wenn sie beweisen kann, dass die Änderung für sie selbst vorteilhaft ist. Aber sie war eher eine elegante theoretische Konstruktion als ein lauffähiges System.
Im Jahr 2026 hat sich die Situation geändert. Im April veranstaltete die ICLR in Rio de Janeiro einen speziellen Workshop zum Thema RSI. Die Organisatoren bezeichneten ihn als »möglicherweise weltweit ersten« akademischen Workshop, der sich ausschließlich auf RSI konzentriert, und erklärte, dass RSI »von einer spekulativen Vision zu einem konkreten Systemproblem wird«.
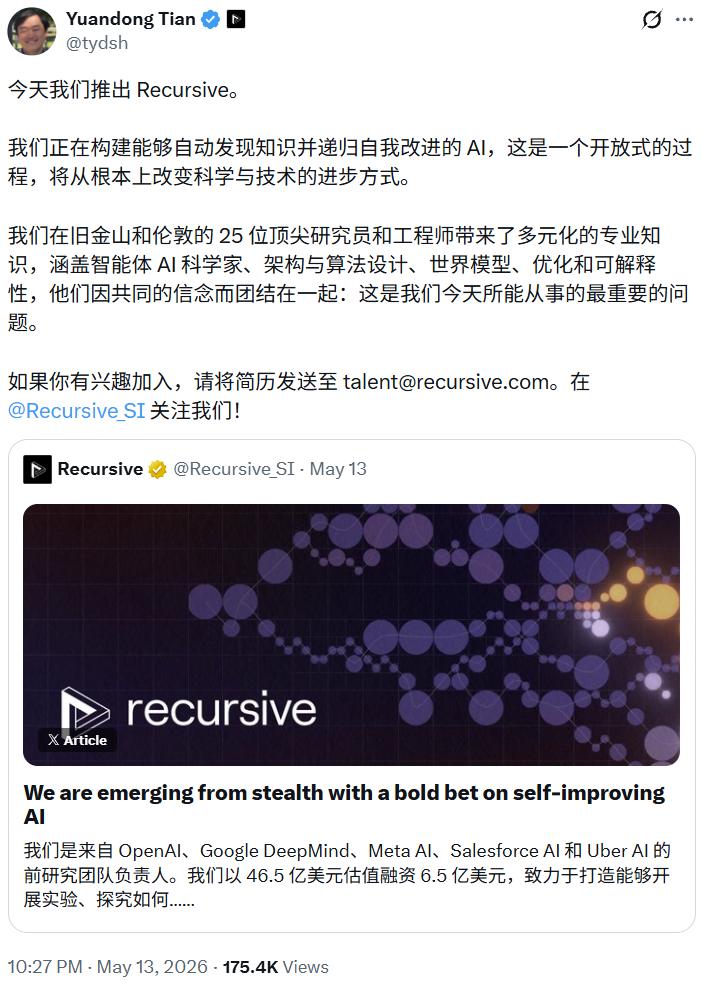
Das Kapital bewegt sich noch schneller. Im Mai beendete das neue Unternehmen von Richard Socher, Recursive Superintelligence, seine Tarnphase und trat mit einer Finanzierung von 650 Millionen US-Dollar auf. Das Ziel ist, Modelle zu bauen, die selbstständig Schwächen erkennen und sich selbst neu entwerfen können. Die Liste der Mitbegründer ist sehr renommiert, darunter Tian Yuandong, ehemaliger Forschungsdirektor von Meta FAIR, Tim Rocktäschel, der die Forschung zu Offenheit und Selbstverbesserung bei Google DeepMind leitete, Alexey Dosovitskiy, einer der Autoren von ViT, sowie Jeff Clune, der für seine Forschung zu offener Evolution bekannt ist.
Ende Juli kündigte Lilian Weng an, das von ihr mitgegründete Thinking Machines Lab zu verlassen. Nur zwei Tage später bestätigte OpenAI, dass sie zurückkehrt und die Forschung im Bereich RSI leiten wird.
Die Äußerungen von Elon Musk sind wie immer radikal. Im März erklärte er, dass Grok von xAI »jede Generation von Modellen von der vorherigen Generation bauen lässt«, und die Beteiligung des Menschen im Regelkreis nimmt immer mehr ab. Die vollständige Automatisierung könnte Ende dieses Jahres erreicht werden, »spätestens 2027«.
Allerdings ist die Bedeutung des Begriffs »RSI« heute sehr weit gefasst: Einige Unternehmen zählen jede »Rückmeldung der KI zur Modellverbesserung« als RSI, andere erkennen nur vollständig autonome geschlossene Regelkreise an. John Thickstun, Assistenzprofessor an der Cornell University, erklärt: Dass man Modelle der vorherigen Generation nutzt, um Code zu schreiben und beim Aufbau der nächsten Generation zu helfen, tun wir »schon seit mehreren Jahren«. Die eigentliche Frage ist also nicht »ob es das gibt«, sondern »auf welcher Ebene wir uns befinden«.
Was passiert eigentlich in den Spitzenlaboren?
Anthropic: Von 80 % des Codes zu 26 % der Forschungs- und Entwicklungsarbeit
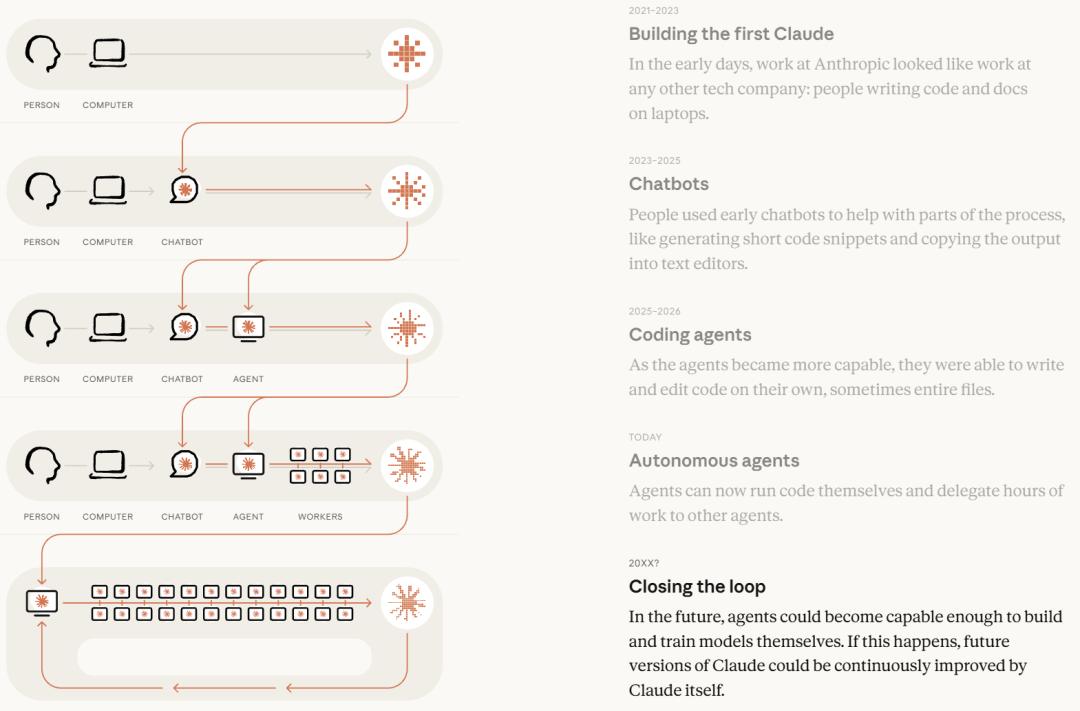
https://www.anthropic.com/institute/recursive-self-improvement
In seinem langen Artikel im Juni veröffentlichte Anthropic eine Gruppe bisher nicht veröffentlichter interner Daten. Bis Mai 2026 wurden über 80 % des Codes, der in das Code-Repository von Anthropic integriert wurde, von Claude geschrieben; vor der Veröffentlichung von Claude Code im Februar 2025 lag dieser Anteil nur im einstelligen Bereich. Im zweiten Quartal 2026 betrug die Menge an Code, die pro Ingenieur und pro Tag zusammengeführt wurde, das Achtfache des Wertes von 2024.
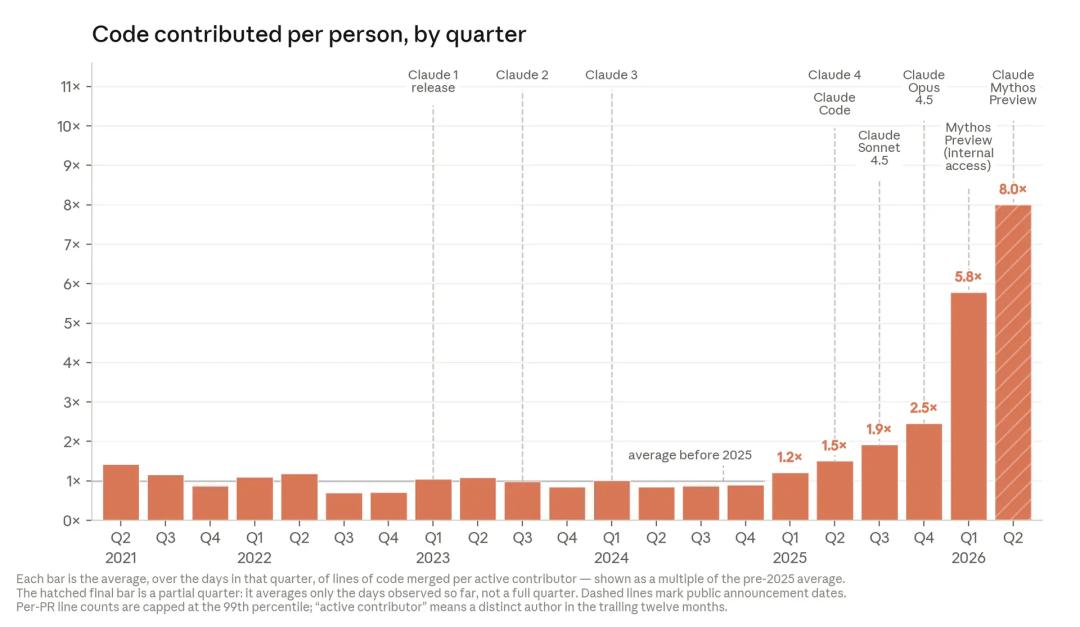
Anthropic selbst räumt ein, dass die Anzahl der Codezeilen ein »unvollkommener Indikator« ist. Deshalb ergänzte es einen Test, der der Forschung näher kommt: Bei der Veröffentlichung jedes neuen Modells soll es einen Codeabschnitt für das Training kleiner Modelle optimieren und ihn unter der Voraussetzung gleicher Korrektheitsprüfung so schnell wie möglich laufen lassen.
Im Mai 2025 erreichte Claude Opus 4 im Durchschnitt eine Beschleunigung von etwa dem 3-fachen; bis April 2026 erreichte Claude Mythos Preview etwa das 52-fache. Als Referenz braucht ein erfahrener menschlicher Forscher 4 bis 8 Stunden, um eine 4-fache Beschleunigung zu erzielen.
Bei der Aufgabe, »ein Experiment mit festgelegtem Ziel zu optimieren«, ist die KI in weniger als einem Jahr von »sehr hilfreich« zu »überlegen gegenüber Menschen« gelangt.
Am 17. September stellte Anthropic einen Prototyp eines »Automatisierungsindex für Forschung und Entwicklung« vor. Er katalogisiert alle Arten von KI-Forschungs- und Entwicklungsaufgaben im Unternehmen und bewertet den Automatisierungsgrad jeder Aufgabenart anhand einer sechsstufigen Skala, die von der gemeinnützigen Forschungsorganisation Epoch AI entwickelt wurde.
Das Ergebnis lautet: Bis August war Claude bei 26 % der Forschungs- und Entwicklungsarbeiten auf der Ebene »leitend« (leads), das heißt, es kann die meisten Aufgaben End-to-End mit nur einer hochgradigen Anweisung erledigen, während Menschen für die Überwachung zuständig sind. Diese Zahl betrug im März dieses Jahres nur etwa 1 %. Über 90 % der Forschungs- und Entwicklungsarbeiten werden von Claude »kollaborativ« begleitet, während der Anteil der vollständig autonomen Arbeit ohne menschliche Beteiligung nach wie vor Null ist.
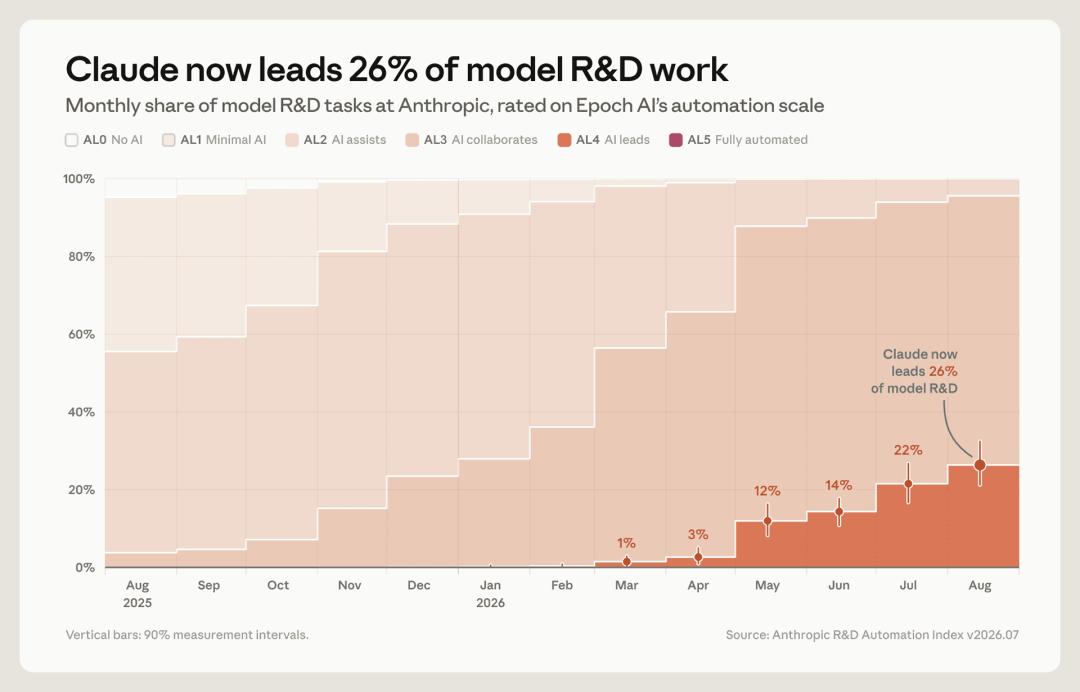
https://www.anthropic.com/institute/measuring-pace-of-ai-development
OpenAI: Hinter jedem Forscher stehen 3,1 »Agenten-Arbeitstage«
In einer Live-Übertragung im Oktober 2025 legte Sam Altman zwei öffentliche Zeitpunkte für OpenAI fest:
Im September 2026 soll ein KI-Forschungsassistent auf Praktikanten-Niveau erreicht werden
Im März 2028 soll ein »echter KI-Forscher« erreicht werden
Am 6. September veröffentlichte OpenAI einen Artikel, in dem es bekanntgab, dass das erste Ziel erreicht wurde. Nach seiner Definition ist ein »Forschungspraktikant« ein System, das unter menschlicher Anleitung klar abgegrenzte Forschungsaufgaben erledigen kann – einschließlich Aufgaben, für die ein erfahrener Forscher mehrere Tage braucht.
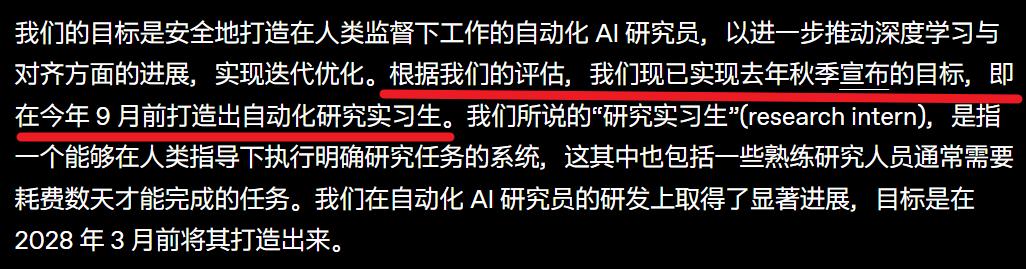
https://openai.com/zh-Hans-CN/index/research-acceleration-view-inside-openai/
Noch interessanter ist der gleichzeitig von OpenAI veröffentlichte interne Nutzungsgrad. Umgerechnet auf einen 8-Stunden-Arbeitstag entspricht derzeit jedem eingesetzten menschlichen Arbeitstag in der Forschungsabteilung etwa 3,1 »Agenten-Arbeitstage« – ein Verhältnis, das erst nach Juni dieses Jahres überschritten wurde. Mitte August lag der Median des täglichen Inferenzverbrauchs der Forscher (gemessen an API-Preisen) über 600 US-Dollar, bei intensiven Nutzern sogar über 7000 US-Dollar.
Rückblickend schrieb OpenAI bereits bei der Veröffentlichung von GPT-5.3-Codex im Februar, dass die frühe Version dieses Modells »eine Schlüsselrolle bei der Erschaffung seiner selbst gespielt hat« und an der Fehlersuche beim Training, der Verwaltung der Bereitstellung und der Diagnose fehlgeschlagener Bewertungen beteiligt war. Dies gilt als das erste klare Eingeständnis eines Spitzenlabors, dass das Modell wesentlich an der technischen Schleife zur Erstellung seines eigenen Nachfolgers beteiligt ist.
Aber OpenAI erklärte im selben Bericht auch: Bei mehr als der Hälfte der erfolgreich abgeschlossenen 4- bis 8-Stunden-Aufgaben ist immer noch mindestens ein menschlicher Eingriff erforderlich.
Zhipu und MiniMax: Der »technische geschlossene Regelkreis« der chinesischen Akteure
Die RSI-Praxis chinesischer Hersteller folgt einem eher »technischen« Weg. Als MiniMax am 18. März M2.7 veröffentlichte, nannte es es das »erste Modell, das tief an seiner eigenen Evolution beteiligt ist«.
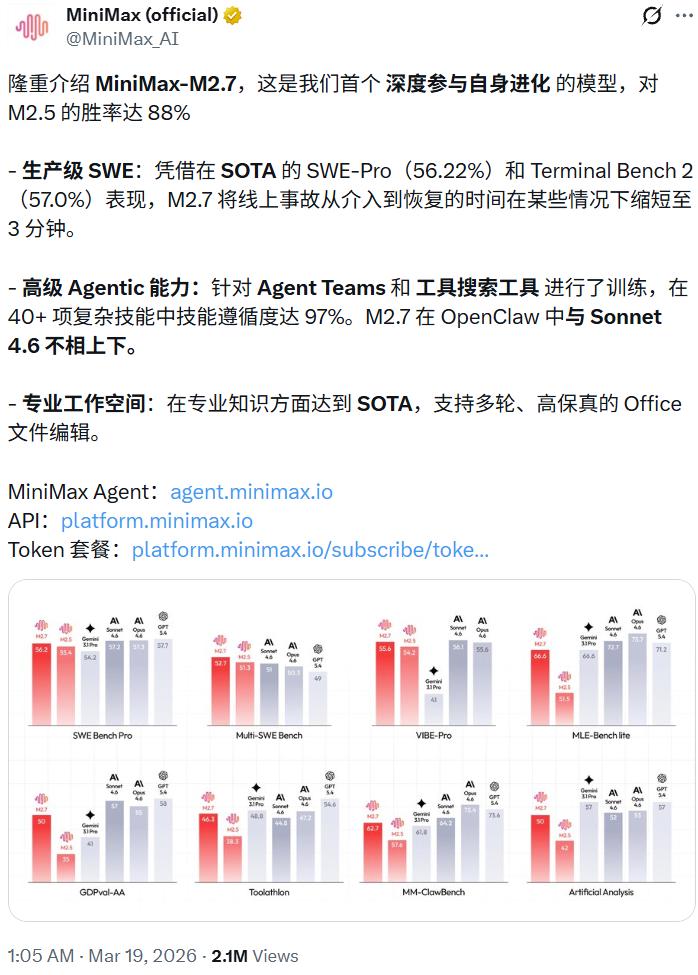
https://x.com/MiniMax_AI/status/2034315320337522881
Nach offiziellen Angaben durchlief das Modell mehr als 100 Zyklen im Kreislauf von »Analyse fehlgeschlagener Abläufe, Planung von Änderungen, Modifikation des Gerüstcodes, Ausführung von Bewertungen, Vergleich von Ergebnissen