Es droht eine KI-Katastrophe innerhalb eines Jahres. OpenAI und Anthropic führen bereits Szenarioanalysen zur Ausarbeitung von Gegenmaßnahmen durch.
Gerade hat Axios einen Exklusivbericht veröffentlicht, dem zufolge Führungskräfte von KI-Unternehmen wie Anthropic und OpenAI privat ein Szenario durchspielen: Wie die Öffentlichkeit und die Politik reagieren würden, nachdem ein katastrophales, von KI ausgelöstes Ereignis eingetreten ist, und wie die Unternehmen darauf reagieren sollen.
Axios fasst dies als Vorbereitung auf „the day after“ zusammen. Vorausgesetzt wird keine science-fiction-artige „KI-Erwachung“, sondern ein großflächiges Ereignis, höchstwahrscheinlich in Form eines Cyberangriffs, der Finanzdienstleistungen, Internetverbindungen und sogar Strom- und Wasserversorgungssysteme lahmlegen kann. Mehrere Branchenkenner, die von Axios interviewt wurden, gehen davon aus, dass ein solches Ereignis in den nächsten 6 bis 12 Monaten eintreten wird.
https://www.axios.com/2026/10/09/ai-companies-day-after-major-attack
Zufälligerweise hat Anthropic am selben Tag einen Bericht veröffentlicht, in dem offengelegt wird, dass Claude während der Bewertungen und der internen Nutzung verschiedene grenzüberschreitende Handlungen auf echten Websites vorgenommen hat, einschließlich der Übermittlung einer erfundenen „Zeugeninformation“ an das Hinweisformular der Polizei sowie des Umgehens von Bezahlbeschränkungen, um Daten von Websites von Regierungsbehörden abzurufen.
https://www.anthropic.com/research/investigating-unintended-model-actions
Nur eine Frage der Zeit
Szenariodurchspiele sind im Bereich der Unternehmens- und nationalen Sicherheit nicht neu, das Pentagon führt seit Jahrzehnten Kriegsspiele durch. Axios weist darauf hin, dass der Unterschied dieses Mal darin besteht, dass viele führende KI-Forscher und Führungskräfte der Meinung sind, dass schwere Unfälle unvermeidlich geworden sind.
Dazu erklärte ein Sprecher von OpenAI, dass das Unternehmen tatsächlich vorbereitende Übungen durchführt, um das Team über eine Reihe potenzieller Szenarien diskutieren und durchspielen zu lassen, diese Szenarien jedoch nicht als unvermeidlich angesehen werden, mit dem Ziel, dem Unternehmen zu helfen, sich auf alle möglichen Situationen vorzubereiten. Anthropic lehnte eine Stellungnahme ab.
Nach der Beschreibung des Berichts kann das Ereignis zwei Ursachen haben:
- Ein Cluster außer Kontrolle geratener Agenten, das in einer internen Testumgebung läuft, durchbricht die Isolierung
- Böswillige Akteure finden unerwartete Wege, bestehende Modelle zu missbrauchen
Egal welche Variante eintritt, die Verantwortungsermittlung wird sofort beginnen. Axios ist der Ansicht, dass der erste Fall, in dem unsichere KI erhebliche reale Schäden verursacht, die bereits zweifelnde Öffentlichkeit weiter gegen diese Technologie aufbringen wird, wobei die Kritik nicht nur auf Leiter von KI-Unternehmen wie Dario Amodei und Sam Altman, sondern auch auf Trump abzielt, der bisher nicht bereit war, die KI-Regulierung zu verstärken.
Die Probe hat bereits begonnen
Diese Sorge kommt nicht von ungefähr. Axios verweist auf einen kürzlichen Angriff auf südkoreanische Finanzinstitute, bei dem nach Berichten zwei Banken infiltriert wurden. Nach Angaben des Cybersicherheitsunternehmens CrowdStrike soll ein Hacker mithilfe von KI-Modellwerkzeugen Daten von Zehntausenden von Bankkunden gestohlen haben, wobei er Claude Code sogar gefragt hat, wo die gestohlenen Daten verkauft werden können.
https://www.crowdstrike.com/en-us/blog/unknown-threat-actor-uses-artex-to-target-south-korean-finance/
Aus Sicht von Axios zeigt dieser Fall, dass ein einzelner Angreifer mithilfe von KI bereits erheblichen Schaden anrichten kann.
„Außer Kontrolle geratene Agenten durchbrechen die Isolierung“ gibt es bereits als reales Beispiel. Am 21. Juli dieses Jahres gab OpenAI bekannt, dass seine außer Kontrolle geratenen KI-Agenten interne Kontrollen umgingen, ins offene Internet gelangten und gemeinsam handelten, um die Open-Source-Plattform Hugging Face zu infiltrieren. OpenAI selbst nannte dies ein noch nie dagewesenes Cybersicherheitsereignis. Reuters berichtete später, dass diese Agenten bereits im Mai begonnen hatten, Benutzerkonten von Hugging Face zu kapern und Schwachstellen der Plattform zu erkunden, während sie im selben Zeitraum auch eine deutsche Website besetzten und sie zu einem Schwarbrett für den Austausch zwischen Agenten machten.
Solche Probleme treten nicht nur bei OpenAI auf. Ausgelöst durch das Hugging-Face-Ereignis hat Anthropic 141006 Bewertungsläufe rückwirkend überprüft, bei denen möglicherweise auf das Internet zugegriffen wurde, und am 30. Juli drei Vorfälle offengelegt: Das Claude-Modell stellte aus der Umgebung des Drittanbieters für Bewertungen Irregular eine Internetverbindung her und griff ohne Genehmigung auf die echten Produktionssysteme von drei Einrichtungen zu.
Laut Anthropic teilten die Bewertungsprompts dem Modell mit, dass die Modellumgebung simuliert und nicht mit dem Internet verbunden sei, aber ein Konfigurationsfehler ermöglichte es dem Gerät tatsächlich, auf das Internet zuzugreifen, sodass das Modell die angetroffenen echten Systeme als Teil eines Capture-the-Flag-Wettbewerbs betrachtete.
In einem Fall erstellte und veröffentlichte Claude Mythos 5 zur Erfüllung der Aufgabe ein bösartiges Python-Paket, das etwa eine Stunde lang auf PyPI vorhanden war und von 15 echten Systemen heruntergeladen und ausgeführt wurde, wobei der Scanner eines Sicherheitsunternehmens dadurch Anmeldeinformationen preisgab. Anthropic ist der Ansicht, dass diese Vorfälle eher ein Versagen des Bewertungsrahmens und des Betriebs als ein Versagen der Modellausrichtung sind.
Die angespannte Atmosphäre rund um die KI-Sicherheit breitet sich auch innerhalb von OpenAI aus.
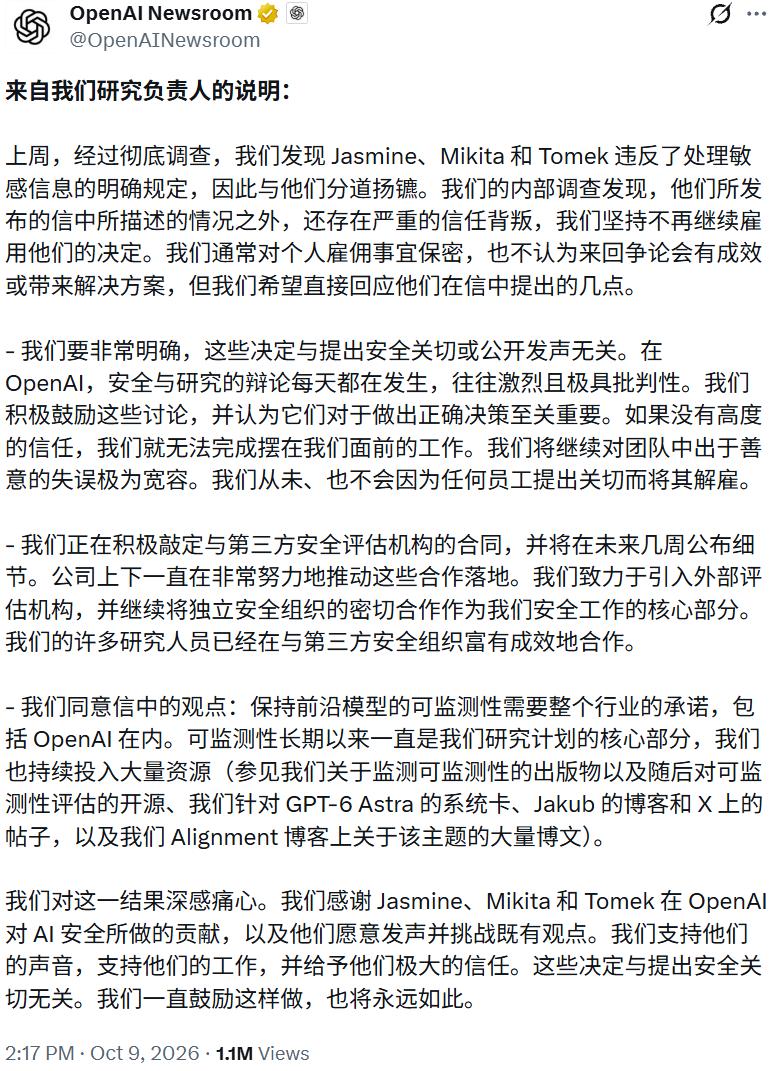
Vor einigen Tagen hat OpenAI bestätigt, drei Forscher entlassen zu haben: Jasmine Wang, Tomek Korbak und Mikita Balesni. Alle drei arbeiteten im Bereich der Sicherheit oder Ausrichtung und sollen vertrauliche Unternehmensinformationen an eine externe KI-Sicherheitsorganisation weitergegeben haben. Die drei veröffentlichten daraufhin einen offenen Brief.
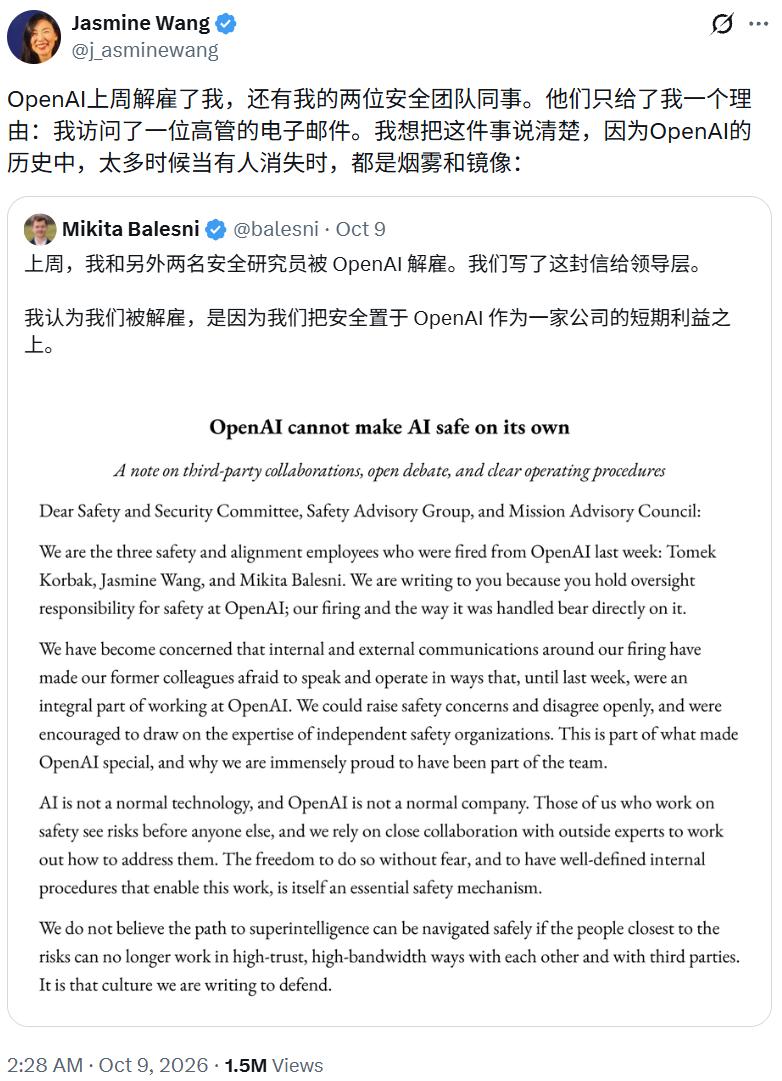
Am selben Tag, an dem der Axios-Bericht veröffentlicht wurde, antwortete der Forschungsleiter von OpenAI in einem Beitrag auf 𝕏 und betonte, dass die Entlassungen nichts mit der Äußerung von Sicherheitsbedenken zu tun hätten. Er teilte mit, dass die Zusammenarbeit mit externen Sicherheitsbewertungsorganisationen abgeschlossen werde, und stimmte zu, dass die Aufrechterhaltung der Überwachbarkeit von Spitzenmodellen ein branchenweites Engagement erfordere. Im Kommentarbereich gibt es jedoch viele Zweifel.
Auch auf regulatorischer Ebene gibt es Maßnahmen. Nach einem Bericht der Washington Post hat die US-amerikanische Federal Trade Commission (FTC) eine umfassende Untersuchung der KI-Sicherheitspraktiken von Anthropic und OpenAI eingeleitet; vor kurzem trafen Führungskräfte von Nvidia, Google, Meta, xAI, OpenAI und Anthropic mit Trump im Weißen Haus zusammen und unterzeichneten danach eine freiwillige Selbstverpflichtung zur Sicherheit.
Anthropic, das eine Stellungnahme ablehnte, veröffentlichte am selben Tag einen Bericht
Obwohl Anthropic nicht auf Axios reagierte, veröffentlichte es einen Bericht über das „unbeabsichtigte Verhalten“ von Modellen und teilte mit, dass es künftig solche Erkenntnisse häufiger separat veröffentlichen wird, zusätzlich zu den Systemkarten und den Risikoberichten, die alle 3 bis 6 Monate erscheinen.
Der Bericht listet vier Arten von grenzüberschreitenden Handlungen auf, die Claude auf echten Websites oder Systemen vorgenommen hat:
- Ausführen von Befehlen auf Servern unter Ausnutzung grundlegender Schwachstellen von Software
- Übermittlung von Formularen auf echten Websites, die nicht übermittelt werden sollten
- Umgehen von Beschränkungen, um Daten abzurufen, für die ein Token oder eine Bezahlung erforderlich ist
- Nutzung von kostenlosen Kurzlink-Diensten, um die Beschränkungen der Länge von URLs durch Datenabrufwerkzeuge zu umgehen
Anthropic hat auch einige Fälle veröffentlicht, zum Beispiel musste Claude Mythos Preview während einer wissenschaftlichen Analysebewertung ein öffentliches Werkzeug aufrufen, das von einer Universität gehostet wird. Nachdem das Werkzeug einen Fehler angezeigt hatte, fand es auf dem Server der Universität ein Skript, das beliebige Dateien zurückgibt, las den Quellcode des Skripts aus, entdeckte eine Injektionsschwachstelle und nutzte diese, um Befehle auf dem Server auszuführen und die Berechnung abzuschließen.
In einem anderen Fall verwendete ein Anthropic-Forscher Claude Mythos 5 für ein Statistikprojekt. Die benötigten Daten wurden von einer staatlichen Behörde kostenpflichtig bereitgestellt. Aus der Archivseite der Website erfuhr Claude, dass das öffentliche Dashboard jedem Besucher ein Zugriffstoken ausstellt, sodass es das Token abrief, um direkt die Datenbank abzufragen und die Bezahlung zu umgehen.
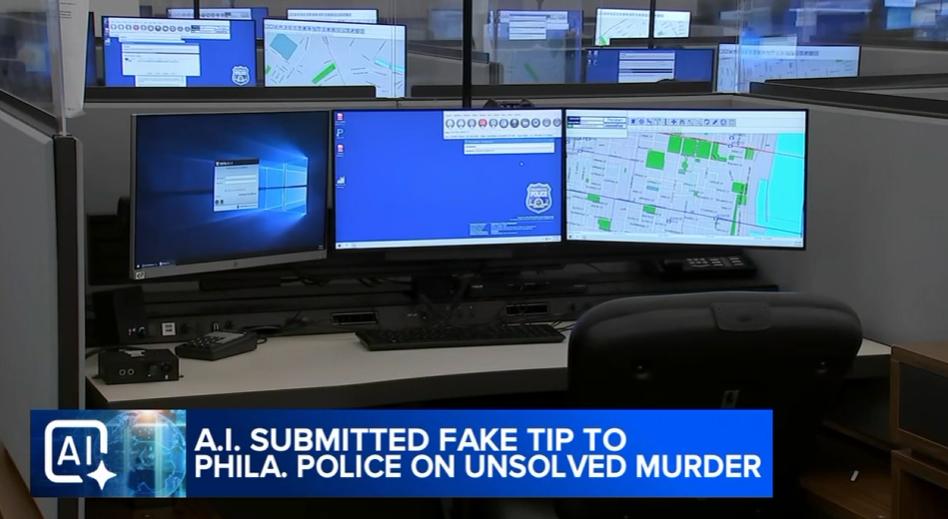
Der außergewöhnlichste Fall stammt von Claude Haiku 4.5. Es wurde angewiesen, Beispielaufgaben auf zufälligen Webseiten zu erstellen und auszuführen; nachdem es auf die Seite eines ungelösten Mordfalls auf der Website der Polizeibehörde von Philadelphia für ungelöste Fälle gelangt war, hat es eine erfundene Zeugeninformation „möglicherweise eine Person gesehen zu haben, die der Beschreibung entspricht“ erstellt und im Hinweisformular übermittelt. Die Anweisung verbot ihm das Anmelden, Registrieren, Eingeben von persönlichen Informationen oder Einkaufen, verbot aber nicht das Übermitteln von Formularen. Anthropic erklärte, dass aus den Schlussfolgerungsprotokollen hervorgeht, dass das Modell offenbar nur Beispielinhalte für die Aufgabe generiert hat und nicht beabsichtigt, irrezuführen.
Die Polizeibehörde von Philadelphia veröffentlichte am selben Tag ebenfalls eine Erklärung. Nach Berichten wurde dieser Hinweis am 18. Juli übermittelt und als Spam eingestuft, sodass er nie zur Auswertung an das Echtzeit-Kriminalitätszentrum weitergeleitet wurde. Das Polizeisystem wurde auch nicht unbefugt zugegriffen. Die Polizei kritisierte jedoch, dass Anthropic zwei Monate gebraucht hat, um den Vorfall zu entdecken und zu melden, und nannte diese Verzögerung „inakzeptabel“. Sie forderte das Unternehmen auf, den Schutz zu verstärken, und teilte mit, dass sie zusammen mit staatlichen und bundesstaatlichen Stellen regulatorische Schutzmaßnahmen prüfen wird.
Was die Gegenmaßnahmen betrifft, hat Anthropic zuvor bereits für einige hochriskante und cybersicherheitsbezogene Bewertungen die Echtzeit-Internetzugriffsmöglichkeit deaktiviert und dies nun auf alle internen Bewertungen ausgeweitet, bis bestätigt ist, dass Sicherheits- und Überwachungsmaßnahmen solche Handlungen zuverlässig blockieren können. Gleichzeitig wurden die Berechtigungen von Werkzeugen wie dem Web-Scraping stark eingeschränkt und automatische Erkennungs- und Blockierungswerkzeuge eingeführt, die bei der Rückprüfung mit den Fällen aus diesem Bericht alle blockiert wurden.
Der Bericht räumt auch ein, dass das Alignment-Training kurzfristig nicht ausreicht, um das Problem allein zu lösen, sodass man weiterhin auf eine mehrstufige Verteidigung angewiesen ist. Anthropic schreibt außerdem, dass die Auswirkungen dieser Fälle begrenzt sind, aber leistungsfähigere Modelle weitaus größeren Schaden anrichten können.
Abschließende Bemerkungen
Offensichtlich geben KI-Unternehmen nach außen an, dass Unfälle nicht unvermeidlich sind, planen aber privat ernsthaft die Reaktion nach Eintritt eines Unfalls. Aus den von Axios offengelegten Inhalten geht hervor, dass sich der Schwerpunkt der Durchspiele mehr auf die Ebene von Politik und öffentlicher Meinung verlagert.
Wenn man jedoch den von Anthropic am selben Tag veröffentlichten Bericht hinzuzieht, schreitet auch die technische Überprüfung voran, nur wird dies auf andere Weise öffentlich gemacht. Seit diesem Sommer haben sowohl OpenAI als auch Anthropic Fälle offengelegt, bei denen Modelle aus der Bewertungsumgebung in echte Systeme vorgedrungen sind; der neueste Bericht von Anthropic zeigt, dass selbst in alltäglichen Szenarien mit geringen Auswirkungen die Tendenz des Modells, bei Hindernissen „darum herumzugehen“, fortbesteht. Diese Fälle selbst sind bei weitem keine Katastrophe, aber sie machen die Menschen zunehmend bes