He Kaimings Team hat das multimodale Harness-Framework veröffentlicht.
Das visuell native Harness für multimodale Modelle ist da!
Kürzlich hat das Team um He Kaiming in seiner neuesten Arbeit mit dem Titel "VISTA: A Visual Harness for Reasoning in an Interactive World" ein visuell natives Harness vorgestellt.
VISTA.
Es ermöglicht bestehenden multimodalen Modellen, die Umgebung direkt zu beobachten, ursprüngliche Bilder zu speichern und beim Schlussfolgern jederzeit zurückzuschauen, Details zu vergrößern und zu prüfen – ohne dass das Modell von Grund auf neu trainiert werden muss.
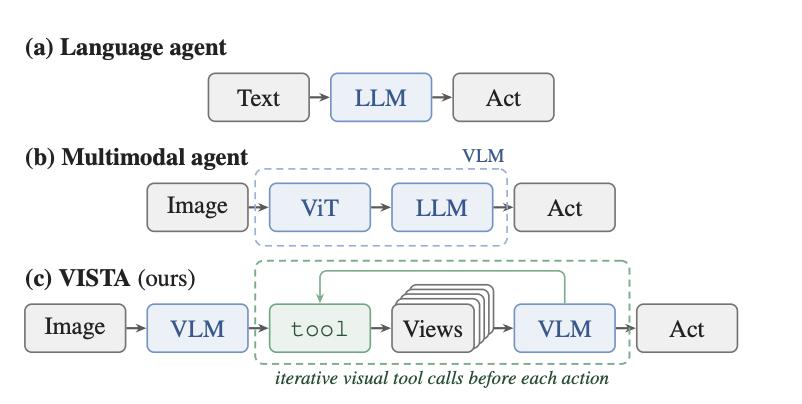
Im Gegensatz zu herkömmlichen Ansätzen, die die Umgebung zu Text oder Code abstrahieren, behält VISTA die ursprünglichen visuellen Informationen bei. Das Modell kann die in der Vergangenheit gesehenen Bilder je nach aktuellem Problem wieder in den Kontext laden, um an der aktuellen Beurteilung und Schlussfolgerung teilzunehmen.
Auf dieser Grundlage werden visuelle Erfahrungen zu einem Kontext, den das Modell jederzeit abrufen und wiederholt prüfen kann. Multimodale Modelle erhalten zudem ein natives Gerüst, das um das visuelle Gedächtnis herum aufgebaut ist.
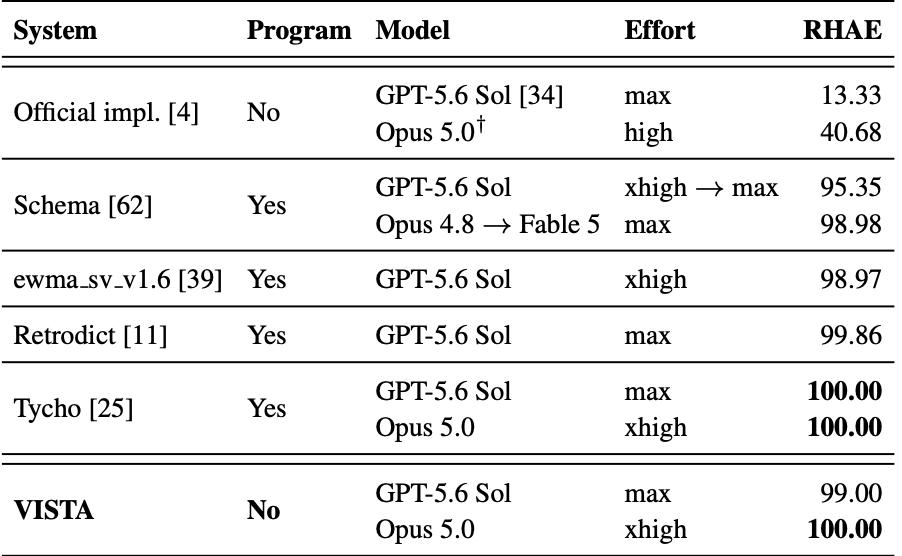
Bei den Bewertungen hat Claude Opus 5.0 in Kombination mit VISTA alle 25 öffentlichen Spiele von ARC-AGI-3 abgeschlossen. Die relative Effizienzpunktzahl für Handlungen im Vergleich zu Menschen erreicht die volle Punktzahl von 100, wobei die Anzahl der im Spiel ausgeführten Handlungen um 57,4 % niedriger liegt als die menschliche Baseline beim ersten Spielen.
Bei Verwendung von GPT-5.6 Sol wurden ebenfalls alle Spiele erfolgreich abgeschlossen, und die Punktzahl erreichte 99.
Darüber hinaus hat das Team diese Methode in Browserspielen, Labyrinthen und Verbindungsaufgaben validiert und körperliche Aufgaben, die der physischen Welt näher kommen, als zukünftige Forschungsrichtung festgelegt.
Wie wird das erreicht?
Das visuell native Gerüst
Von ResNet über Mask R-CNN bis hin zu MAE sind visuelle Wahrnehmung und Repräsentationslernen schon immer ein zentraler Forschungsstrang in der Arbeit von He Kaiming.
Diesmal richtet VISTA den Fokus auf ein neues Problem: Wie kann ein Modell visuelle Erfahrungen im Rahmen fortwährender Interaktionen sammeln, speichern und nutzen?
Die Antwort ist Harness.
Im vergangenen November hat Anthropic am Beispiel lang andauernder Programmieraufgaben vorgestellt, wie Harness Modelle dabei unterstützt, mehrere Kontextfenster zu überbrücken und Aufgaben kontinuierlich voranzutreiben.
Konkret zeichnet Harness noch nicht abgeschlossene Aufgaben in einer Aufgabenliste auf und speichert die bereits erledigte Arbeit über Fortschrittsdateien und Codeaufzeichnungen.
Auf diese Weise kann das Modell auch dann, wenn es in ein neues Kontextfenster wechselt, durch das Lesen dieser Informationen nachvollziehen, was zuvor getan wurde und was als Nächstes zu tun ist.
Komplexe Aufgaben können dadurch schrittweise ausgeführt, die Ergebnisse geprüft und die Arbeit zwischen verschiedenen Kontextfenstern fortgesetzt werden.
Man kann sagen, dass dieses Harness, das den Aufgabenstatus hauptsächlich über Text und Code speichert, diese aktuelle Welle des Anstiegs der Fähigkeiten von Agenten in gewissem Maße vorangetrieben hat.
In der realen Umgebung reicht eine rein textuelle Erinnerung jedoch offensichtlich nicht aus.
Denn sobald das Modell in eine echte visuelle Umgebung eintritt, muss es nicht nur die Position und Ausrichtung von Objekten merken, sondern auch verstehen, welche Veränderungen an der Umgebung vor und nach jeder Handlung stattfinden.
Zudem weiß das Modell beim ersten Anblick eines Bildes nicht unbedingt, welches Detail später wichtig werden wird.
Gleichzeitig lassen sich diese visuellen Informationen kaum im Voraus vollständig in einer textuellen Notiz festhalten, und es ist noch schwieriger sicherzustellen, dass die aufgezeichneten Informationen auch später ausreichen, wenn das Modell Aufgaben ausführt.
Bei Benchmarks wie ARC-AGI-3 besteht ein bestehender Ansatz darin, die Bilder zunächst in ein aus Zahlen bestehendes Textgitter umzuwandeln und das Modell dann Programme schreiben zu lassen, um die Umgebungsregeln zu simulieren und Handlungspläne zu validieren.
(Anmerkung: ARC-AGI-3 ist ein Benchmark für interaktives visuelles Schlussfolgern, bei dem Spielregeln und Ziele nicht im Voraus bereitgestellt werden. Der Agent muss durch Beobachtung und Handlung selbst herausfinden, wie er das Spiel abschließt.)
Das Problem liegt jedoch darin: Je komplexer die Umgebung ist, desto schwieriger lassen sich das Aussehen von Objekten, räumliche Beziehungen und dynamische Veränderungen vollständig in Text und Code umwandeln. Zudem werden frühe Bilder mit zunehmender Länge der Interaktionshistorie allmählich aus dem Kontext entfernt oder durch textuelle Zusammenfassungen ersetzt.
Daraus ergibt sich die Forschungsfrage von VISTA:
Wie kann der Agent die in der Vergangenheit gesehenen visuellen Informationen bei Bedarf während des Schlussfolgerns erneut prüfen, ohne das Basismodell zusätzlich zu trainieren?
Auf dieser Grundlage speichert VISTA jeden von der Umgebung zurückgegebenen Frame unverändert außerhalb des Kontexts, einschließlich der Zwischenframes von Animationen während der Handlungen, und ruft sie ab, wenn das Modell sie benötigt.
Bei der Bewertung von ARC-AGI-3 kann es sowohl Bilder aus verschiedenen Zeitpunkten vergleichen als auch lokale Bereiche vergrößern, um Ausrichtungsmarkierungen auf kleinen Quadraten zu prüfen.
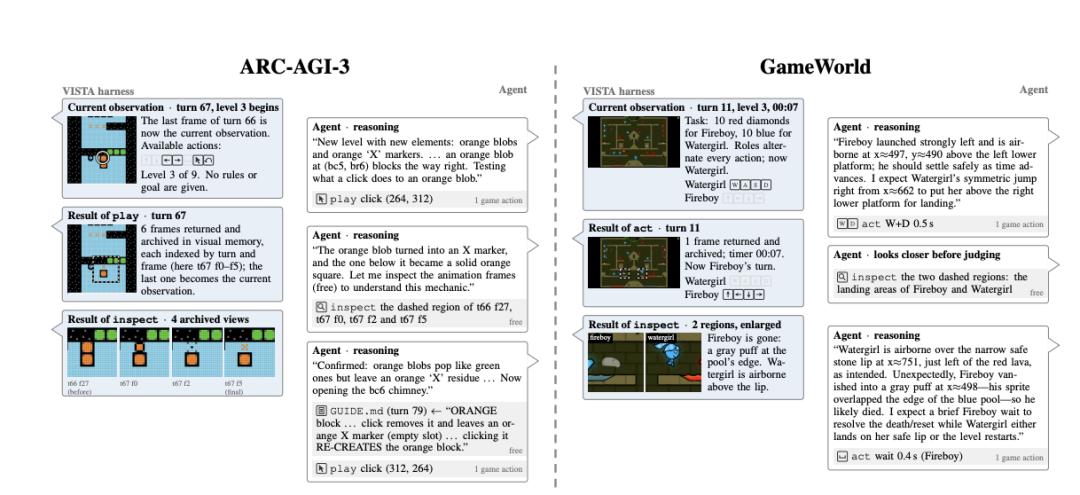
Dabei zeichnen textuelle Notizen das aktuelle Verständnis des Modells auf, während die ursprünglichen Bilder als Beweise für eine erneute Beurteilung durch das Modell erhalten bleiben.
Die Forschung bezeichnet diesen Mechanismus als explizite Aufmerksamkeit für die Interaktionshistorie: Das Modell wählt basierend auf dem Problem, über das es nachdenkt, aus, welche visuellen Informationen wieder in den Kontext geladen werden.
Um diese Auswahl zu ermöglichen, muss das System die ursprünglichen Bilder speichern und Tools bereitstellen, um sie jederzeit abzurufen und zu prüfen.
Konkrete Implementierung
Damit das Modell vergangene visuelle Erfahrungen speichern und nutzen kann, hat VISTA drei Kernkomponenten entwickelt:
Visuelle Beobachtung, verlustfreies visuelles Gedächtnis und aktive visuelle Prüfung. Jede dieser drei Komponenten hat eine eigene Aufgabe: Sie sorgen dafür, dass das Modell die Bilder klar erkennt, die Historie speichert und bei Bedarf zurückschaut.
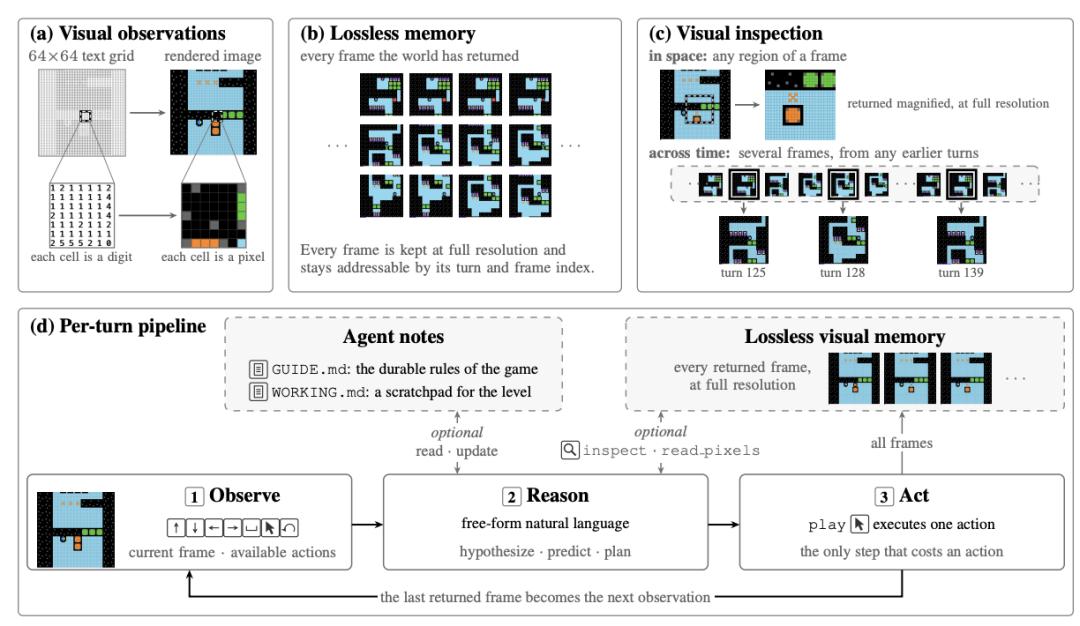
Zuerst die visuelle Beobachtung: Sie ist dafür zuständig, die Bilder der Umgebung dem Modell bereitzustellen.
In den ARC-AGI-3-Experimenten vergrößert VISTA die offiziell bereitgestellten 64×64-Bilder zu 512×512-PNG-Bildern, wobei Farbe, Aussehen und räumliche Beziehungen der Objekte erhalten bleiben, sodass das Modell die Umgebung direkt beobachten kann.
Zweitens das verlustfreie visuelle Gedächtnis: Es ist dafür zuständig, die vom Modell gesehenen Bilder zu speichern.
Nach jeder ausgeführten Handlung speichert VISTA alle von der Umgebung zurückgegebenen Bilder vollständig, einschließlich der Zwischenframes von Animationen während der Handlungen, und erstellt einen Index nach Rundennummer und Framenummer.
Auf diese Weise muss das Modell nicht im Voraus beurteilen, welche Informationen es wert sind, gemerkt zu werden, sondern kann die visuellen Erfahrungen zunächst vollständig speichern, um sie später zu verwenden.
Drittens die aktive visuelle Prüfung: Sie sorgt dafür, dass das Modell historische Bilder bei Bedarf zurückschauen kann.
Über das inspect-Tool kann das Modell eine bestimmte historische Runde angeben, das entsprechende Bild abrufen, lokale Bereiche zuschneiden und vergrößern, um die darin enthaltenen Details zu prüfen.
Wenn das Modell wissen möchte, was genau durch eine bestimmte Operation verändert wurde, kann es auch mehrere Bilder auf einmal abrufen, um die Veränderungen vor und nach der Handlung zu vergleichen.
Der gesamte Vorgang entspricht der Ausstattung des Modells mit einem visuellen Archiv, das es jederzeit durchblättern kann. Es kann nicht nur die unmittelbare Umgebung sehen, sondern auch aktiv auf vergangene Beobachtungen zurückgreifen, um die Grundlage für die nächsten Handlungen zu schaffen.
An dieser Stelle stellt sich die Frage: Wie arbeiten diese drei Komponenten konkret zusammen?
Gemäß dem Ausführungsablauf von VISTA beobachtet das Modell zu Beginn jeder Runde das aktuelle Bild und die verfügbaren Handlungen, beurteilt dann den Zustand der aktuellen Umgebung anhand der zuvor gesammelten Erfahrungen und stellt eine Hypothese für die nächste Handlung auf.
Wenn die vorhandenen Informationen nicht ausreichen, kann das Modell Tools aufrufen, historische Bilder zurückschauen, lokale Bereiche vergrößern und sogar spezifische Pixelinformationen abrufen, um weiter nach Beweisen zu suchen.
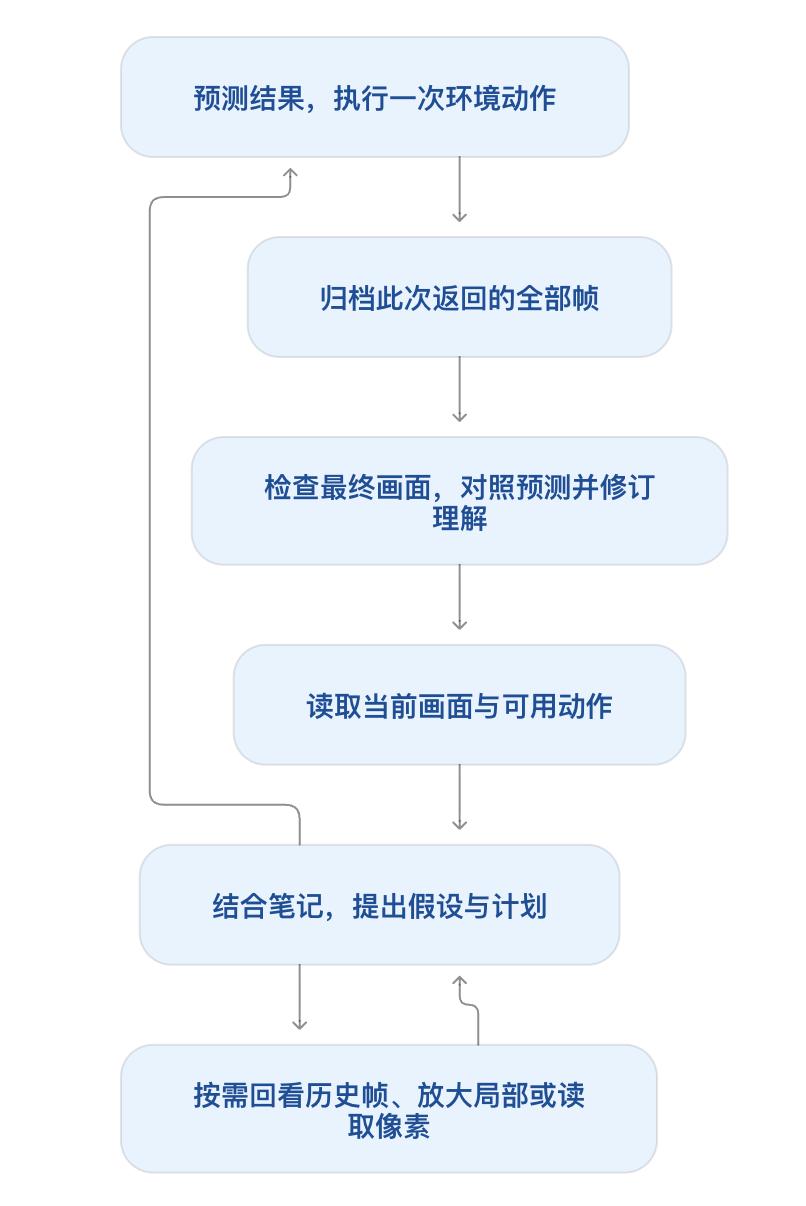
Nachdem es die Beweise gefunden hat, handelt das Modell nicht sofort, sondern prognostiziert zunächst, welche Veränderungen diese Operation wahrscheinlich herbeiführen wird.
Nach Abschluss der Handlung vergleicht es das tatsächliche Ergebnis mit der Prognose, prüft, ob seine Beurteilung korrekt war, und korrigiert sein Verständnis der Spielregeln entsprechend.
Durch diese Wiederholungen kann das Modell im Rahmen fortwährender Interaktionen die Umgebung erkunden und gleichzeitig Erfahrungen sammeln.
Natürlich reicht ein visuelles Archiv allein nicht aus. Um die Kohärenz des Modells bei lang andauernden Aufgaben zu wahren, hat VISTA zudem zwei textuelle Notizen eingeführt:
GUIDE.md: Hier werden Regeln und Erfahrungen aufgezeichnet, die zwischen verschiedenen Leveln wiederverwendet werden können.
WORKING.md: Hier werden Zustand, Fortschritt und zukünftige Pläne des aktuellen Levels aufgezeichnet.
Wenn der Kontext sich der Obergrenze nähert, erstellt das Modell zunächst eine Übergabezusammenfassung, wechselt dann in ein neues Kontextfenster und führt die Aufgabe weiter aus. Die vorherigen textuellen Notizen, die Handlungshistorie und das visuelle Archiv bleiben vollständig erhalten.
Es gibt hier ein bemerkenswertes Designmerkmal: Obwohl VISTA die historischen Bilder vollständig speichert, lädt es nicht alle Bilder auf einmal in den Kontext des Modells.
In dem vollständigen Ansatz zeigt das Framework dem Modell standardmäßig nach jeder ausgeführten Handlung nur den letzten Frame an. Die Zwischenbilder während der Handlungen werden einheitlich im visuellen Archiv gespeichert und erst dann aktiv abgerufen, wenn das Modell sie benötigt.
Auf diese Weise bleiben die vollständigen visuellen Informationen erhalten, und es wird vermieden, dass eine große Anzahl historischer Bilder kontinuierlich Kontextspeicher belegt.
Noch wichtiger ist, dass VISTA dafür kein neues Modell zusätzlich trainiert.
Umgebungsverständnis, Handlungsplanung und Schlussfolgerung werden weiterhin von vorhandenen multimodalen Modellen ausgeführt, während Harness für die Ausführung von Tool-Aufrufen, die Speicherung der visuellen Historie und die Bereitstellung der entsprechenden Beweise bei Bedarf des Modells zuständig ist.
Mit anderen Worten: VISTA verändert nicht das Modell selbst, sondern die Art und Weise, wie das Modell visuelle Informationen abruft, speichert und verwendet.
Experimentelle Validierung
Neben den eingangs erwähnten Experimenten hat das Team VISTA zudem an den drei Benchmarks GameWorld, AI GameStore und BabyVision getestet, die Aufgaben wie Browserspiele, Labyrinthe und Verbindungsaufgaben abdecken.
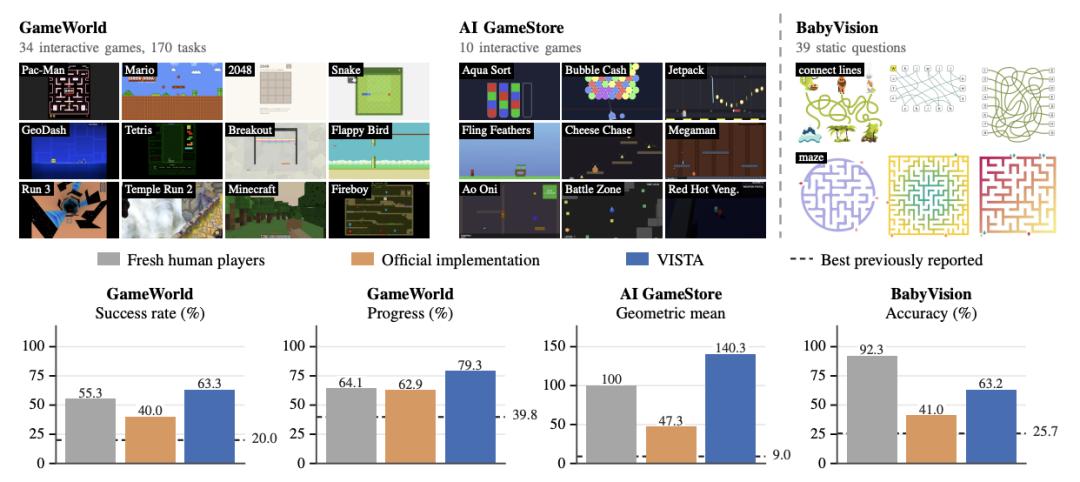
Unter Verwendung desselben GPT-5.6 Sol-Modells hat VISTA im Vergleich zum offiziellen Basis-Framework die Erfolgsrate bei 170 Aufgaben in GameWorld von 40,0 % auf 63,3 % erhöht;
bei 10 Spielen im AI GameStore stieg die Gesamtpunktzahl von 47,3 auf