ByteDance hat den Grund herausgefunden, warum die Leistung von DeepSeek zwischen stark und schwach schwankt.
Die zwiespältige Natur von DeepSeek, die mal hervorragend und mal völlig versagt, wurde vom Seed-Team von ByteDance entdeckt.
Bei derselben Aufgabe wurde nichts geändert, nur ein paar unbedeutende Zeichen vorne hinzugefügt – und plötzlich kann das Modell die Aufgabe nicht mehr lösen???
Und das ist kein zufälliger Ausfall.
Die Forscher des Seed-Teams fanden heraus, dass die Leistung von DeepSeek-V4 in Abhängigkeit von der Eingabeposition der Informationen periodisch alle 4 Tokens schwankt.
Was bedeutet das? Ob sich das Modell an eine Sache erinnern kann, hängt tatsächlich davon ab, an welcher Stelle diese Sache in der Eingabe steht??
Fügt man vorne zwei weitere Tokens hinzu, kann sich die Antwort von falsch zu richtig ändern, fügt man noch zwei hinzu, springt sie wieder zurück zur Falschantwort.
Na also, jetzt achten die Modelle bei der Aufgabenbearbeitung auch schon auf die richtige Positionierung.
Bei Abruftests mit 128K-Token-langem Kontext fanden die Forscher heraus, dass sich die Abrufgenauigkeit der DeepSeek-V4-Modellreihe um bis zu 40,2 Prozentpunkte unterscheidet, wenn dieselbe Information nur an eine andere Stelle verschoben wird.
Das Team stellte weiter fest, dass dieses Problem mit einer Langkontext-Optimierungstechnik zusammenhängt, die DeepSeek-V4 einsetzt –
Chunk-basierte KV-Cache-Komprimierung.
Diese Technik sollte ursprünglich dazu dienen, dass das Modell lange Texte speichereffizienter und schneller verarbeiten kann.
Nach der Komprimierung führt sie aber dazu, dass das Modell mal hervorragend und mal völlig unbrauchbar funktioniert (doge).
Zwei zusätzliche Tokens – und plötzlich gibt DeepSeek die richtige Antwort
Die Forscher des Seed-Teams von ByteDance führten zunächst ein Experiment mit dem eigenen Code von DeepSeek durch.
Das Testobjekt war DeepSeek-V4-Flash-Base.
Sie schnitten einen FP8-Quantisierungsfunktionscode aus dem offiziellen Inferenzcode von DeepSeek-V4 heraus und ließen das Modell das letzte Token ergänzen.
Die richtige Antwort für diese Aufgabe sollte 8 sein, da dieser Code eine typbezogene Umwandlung im Zusammenhang mit FP8 durchführen muss.
Aber manchmal war das Modell überzeugt, dass es die Zahl 32 ergänzen sollte.
Um herauszufinden, was genau vor sich geht, fügten die Forscher vor dem Code eine rein dekorative Dokumentationszeichenfolge hinzu, die aus mehreren sich wiederholenden Gleichheitszeichen bestand.
Dann begannen sie, die Anzahl der Gleichheitszeichen anzupassen.
Der Code selbst wurde nicht verändert, die zu ergänzende Position blieb gleich, und die richtige Antwort änderte sich natürlich auch nicht … Die einzige Änderung waren die paar zusätzlichen Tokens vorne, die keine praktische Bedeutung haben.
Daraufhin begann die Antwort von DeepSeek ständig zwischen Richtig und Falsch zu springen.
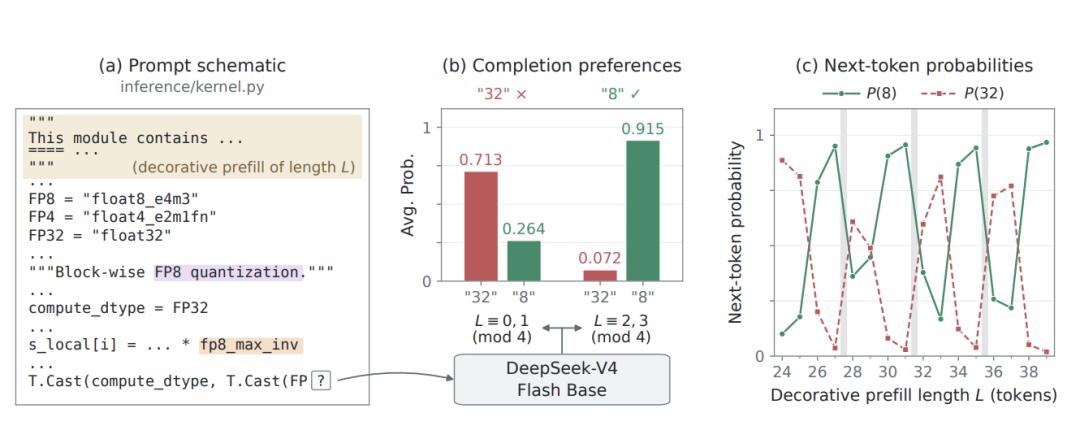
Wenn die Fülllänge bestimmte Positionen erreichte, tendierte das Modell eher zur falschen Antwort 32.
Verschob man sie um ein oder zwei Tokens nach vorne, tendierte es wieder zur richtigen Antwort 8.
Wenn man weiter verschob, kam die Falschantwort zurück –
Der gesamte Vorgang wiederholte sich mit einem Zyklus von 4 Tokens.
Genauer gesagt: Bei den 16 getesteten Fülllängen in der Studie tendierte das Modell zur Falschantwort 32, wenn der Rest der Länge modulo 4 gleich 0 oder 1 war; wenn der Rest 2 oder 3 war, tendierte es zur richtigen Antwort 8.
Die Forscher werteten außerdem die Wahrscheinlichkeiten aus, die das Modell den beiden Kandidatenantworten zugewiesen hat.
Bei einer Gruppe von Positionen lag die durchschnittliche Wahrscheinlichkeit der Falschantwort 32 bei 71,3 %, die der richtigen Antwort 8 nur bei 26,4 %.
Bei einer anderen Gruppe von Positionen kehrte sich das Verhältnis direkt um:
Die durchschnittliche Wahrscheinlichkeit der richtigen Antwort 8 stieg auf 91,5 %, die der Falschantwort 32 fiel auf nur 7,2 %.
Das heißt, die Längenänderung der paar unbedeutenden Zeichen vorne reicht aus, damit das Modell zu völlig unterschiedlichen Urteilen bei derselben Aufgabe kommt.
Das ist kaum zu bewerten.
Wenn Programmierer Code debuggen, prüfen sie normalerweise zuerst die Logik, Variablen und Abhängigkeiten.
Jetzt scheint es, dass sie auch noch prüfen müssen, ob sie nicht versehentlich zwei zusätzliche Gleichheitszeichen vorne eingegeben haben.
Aber ein einzelnes Beispiel für Codeergänzung reicht nicht aus, um zu zeigen, wie weit verbreitet das Problem ist.
Deshalb erweiterte das Seed-Team die Tests weiter.
Sie wandten sich einer sehr klassischen Aufgabe im Bereich der Langkontext-Fähigkeiten von großen Modellen zu: der Nadel-im-Heuhaufen-Aufgabe.
Die Forscher erstellten einen Kontext mit einer Länge von 128.000 Tokens, der etwa 16.000 Schlüssel-Wert-Paare enthielt.
Beispielsweise entspricht K1 V1, K2 entspricht V2 …
Dann ließen sie das Modell den Wert finden, der einem bestimmten Schlüssel entspricht.
Während des Tests blieben die Schlüssel-Wert-Beziehungen, die Frage und die Gesamtlänge des Kontexts unverändert.
Die Forscher passten vor allem die Position der Zielinformation relativ zur Grenze des Komprimierungsfensters an.
Das Ergebnis zeigte, dass die Genauigkeitskurve der DeepSeek-V4-Reihe sehr deutliche periodische Schwankungen aufweist.
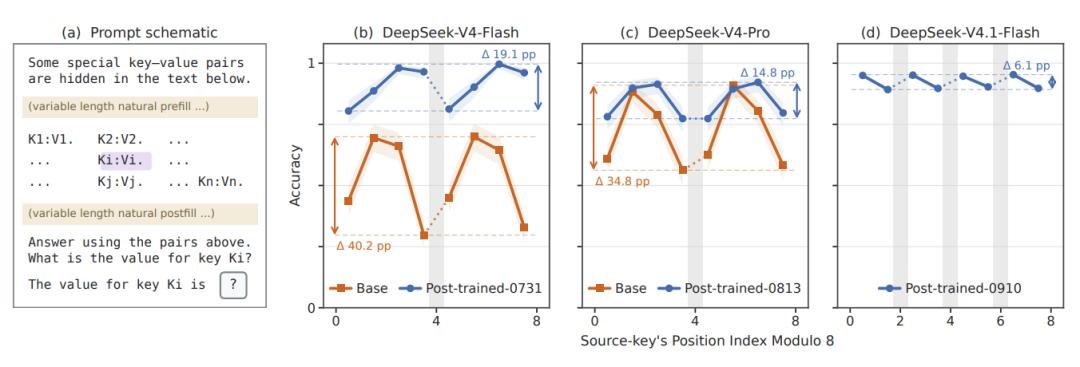
Bei DeepSeek-V4-Flash-Base betrug der maximale Genauigkeitsunterschied zwischen verschiedenen Positionen 40,2 Prozentpunkte.
Bei DeepSeek-V4-Pro-Base lag er bei 34,8 Prozentpunkten.
Nach dem Post-Training verbesserte sich die Situation.
Der Unterschied bei DeepSeek-V4-Flash-0731 verkleinerte sich auf 19,1 Prozentpunkte, bei DeepSeek-V4-Pro-0813 auf 14,8 Prozentpunkte.
Bei dem neueren DeepSeek-V4.1-Flash-0910 sank der Unterschied weiter auf 6,1 Prozentpunkte.
Aber die periodischen Unterschiede bestehen weiterhin.
Woher kommt diese Unterschiedlichkeit?
Bei genauerer Betrachtung beträgt der Schwankungszyklus von DeepSeek-V4 4 Tokens, bei DeepSeek-V4.1 nur 2 Tokens.
Die Forscher fanden heraus, dass dies genau der Komprimierungsschrittweite entspricht, die jede der beiden Modellgenerationen verwendet.
Na also, selbst der Schwankungszyklus der Antwortleistung stimmt mit der zugrundeliegenden Komprimierungskonfiguration überein.
Liegt das Problem an der KV-Cache-Komprimierung?
Reden wir also über die KV-Cache-Komprimierung.
Wenn große Modelle lange Kontexte verarbeiten, müssen sie viele Key- und Value-Informationen zu historischen Tokens speichern, die für spätere Aufmerksamkeitsberechnungen benötigt werden.
Je länger der Kontext ist, desto größer ist der Speicherbedarf und der Rechenaufwand für diesen Cache.
Besonders bei Langaufgaben mit Hunderttausenden oder Millionen von Tokens wird der KV-Cache leicht zum Engpass für die Inferenzeffizienz.
Deshalb setzt DeepSeek-V4 auf die chunk-basierte KV-Cache-Komprimierung.
Die Idee ist, aufeinanderfolgende Tokens in einzelne Fenster aufzuteilen und die Informationen innerhalb eines Fensters zu weniger Cache-Einträgen zu komprimieren.
Auf diese Weise muss das Modell nicht für jedes historische Token einen gleich großen Cache vorhalten.
Das spart nicht nur Speicher, sondern senkt auch die Kosten für die Aufmerksamkeitsberechnung bei langen Kontexten.
Aber das Seed-Team fand heraus, dass der Grund für die zwiespältige Leistung von DeepSeek in diesem Chunking-Prozess verborgen sein könnte.
Nehmen wir an, jede 4 Tokens bilden einen Komprimierungsschritt.
Dann kann sich dieselbe Information, wenn sie an der 1., 2., 3. oder 4. Stelle im Fenster steht, in unterschiedlichen Bedingungen während der Komprimierung befinden.
In der Studie wird diese Position relativ zur Grenze des Komprimierungsfensters als Phase bezeichnet.
Die Forscher fanden heraus, dass das Modell systematische Unterschiede in der Abrufleistung für Informationen in verschiedenen Phasen aufweist.
Sie nannten dieses Phänomen Phase Sensitivity (Phasenempfindlichkeit).
Ein Beispiel: Man gibt dem Modell dieselbe Informationssammlung:
Bei der ersten Formatierung fällt die wichtige Zahl genau auf eine Position, die das Modell leicht behalten kann;
Bei der zweiten Formatierung fügt man nur ein paar zusätzliche Wörter vorne hinzu – dadurch ändert sich die Position der wichtigen Zahl relativ zum Komprimierungsfenster.
Die Informationssammlung ist immer noch dieselbe, aber ob das Modell die Zahl später wiederfinden kann, kann deutlich unterschiedlich sein.
Außerdem lässt sich dieses Problem nicht einfach damit erklären, dass die Information genau zwischen zwei Fenster geteilt wird.
Die Forscher fanden heraus, dass selbst wenn sowohl der Schlüssel als auch der Wert im selben Komprimierungsfenster liegen, die Abrufgenauigkeit an verschiedenen Positionen stark unterschiedlich sein kann.
Das zeigt, dass das Problem auch damit zusammenhängt, wie das Modell Informationen in den komprimierten Cache schreibt und später daraus liest.
Um dies weiter zu bestätigen, trainierte das Seed-Team selbst eine Reihe von Modellen von Grund auf neu.
Sie nutzten die Qwen3-0.6B-Architektur als Basis, erstellten verschiedene KV-Cache-Komprimierungsschemata und setzten ein volles Aufmerksamkeitsmodell ohne Chunk-Komprimierung als Kontrollgruppe ein.
Sie änderten nur den Komprimierungsmechanismus, um zu sehen, ob die periodischen Schwankungen auftreten werden.
Das Ergebnis: Alle getesteten Modelle mit Chunk-Komprimierung zeigten periodische Schwankungen, die der Komprimierungsschrittweite entsprachen.
Im Gegensatz dazu zeigte das volle Aufmerksamkeits-Basismodell keine gleich starken Periodizitäten.
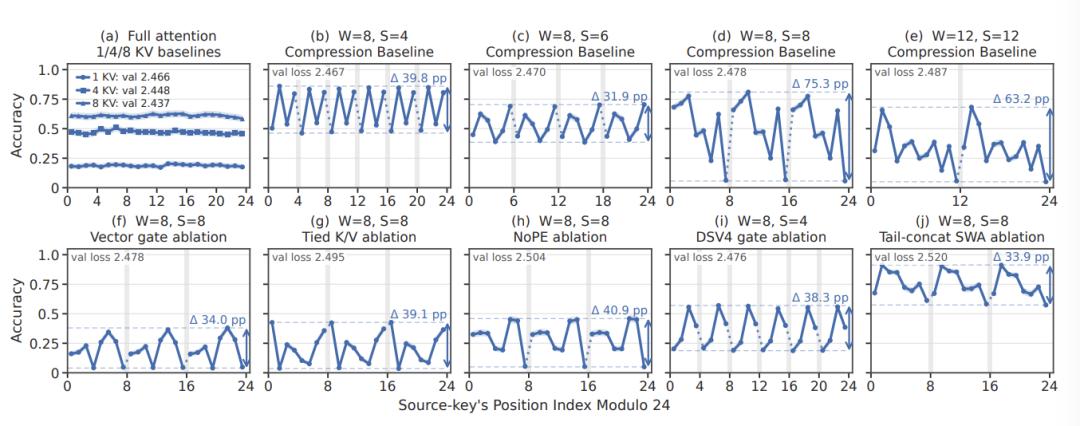
Die Forscher passten separat die Fenstergröße und die Komprimierungsschrittweite an und fanden heraus, dass der Zyklus hauptsächlich der Komprimierungsschrittweite folgt.
Bei einer Schrittweite von 4 schwankt die Leistung mit einem Zyklus von etwa 4 Tokens;
Bei einer Schrittweite von 6 wird der Zyklus ebenfalls etwa 6 Tokens lang;
Bei einer Schrittweite von 8 ist es genauso;
…
Sogar wenn man keine RoPE-Positionscodierung verwendet oder die lernbaren Komprimierungsgewichte durch einfache Mittelwertbildung ersetzt, bleibt dieses Phänomen bestehen.
Das heißt, das Problem wird nicht durch eine einzelne Positionscodierung oder ein einzelnes spezielles Modul verursacht.
Das Design der Chunk-Komprimierung selbst kann periodische Schwächen beim Abruf einführen.
Das Seed-Team griff weiter in die Aufmerksamkeitsköpfe ein und beobachtete, wie sich die Abrufleistung des Modells in allen Phasen ändert, nachdem verschiedene Komponenten entfernt wurden.
Das Ergebnis zeigte, dass verschiedene Aufmerksamkeitsköpfe unterschiedlich stark zu verschiedenen Phasen beitragen.
Einige Köpfe sind besser darin, Informationen an bestimmten Positionen zu verarbeiten, andere spielen eine größere Rolle an anderen Positionen.
Die Forscher nannten dies Phase Specialization (Phasenspezialisierung).
Das heißt, im Inneren des Modells hat sich offenbar eine Arbeitsteilung gebildet: Verschiedene Aufmerksamkeitskomponenten haben eine Präferenz für unterschiedliche Positionen im Komprimierungsfenster entwickelt.
