Die Turbo-Version von GPT-6.1 Sol ist online gegangen, die Zugangsschwelle von 500 US-Dollar erzürnt die Nutzer: Man zahlt für eine höhere Geschwindigkeit, aber das verfügbare Nutzungskontingent wird noch rasanter aufgebraucht?
OpenAI hat den Agenten eine weitere Geschwindigkeitsstufe hinzugefügt.
Laut dem offiziellen Update-Protokoll hat OpenAI am 8. Oktober in der Responses API für GPT-6.1 Sol den Ultrafast-Modus hinzugefügt, der allen API-Nutzern zur Verfügung steht und weiterhin den Ratenbegrenzungen unterliegt. Entwickler müssen den Modellnamen nicht ändern, sondern nur bei dem Aufruf von gpt-6.1-sol die Dienststufe auf ultrafast setzen, um diesen Modus zu nutzen.
Dieses Update zielt hauptsächlich auf die Generierungsgeschwindigkeit ab.
Das Modell GPT-6.1 Sol selbst wurde bereits am 29. September veröffentlicht. Daher bedeutet die „Veröffentlichung der Ultra-Schnell-Version“ genauer gesagt, dass dem vorhandenen Modell eine schnellere Dienststufe hinzugefügt wurde. OpenAI positioniert Ultrafast als seine schnellste API-Dienststufe für Arbeiten, die empfindlich auf Latenz reagieren und bei denen Nutzer bereit sind, höhere Kosten für die Geschwindigkeit zu zahlen.
Der Preis steigt entsprechend: Der Einzelpreis für API-Token im Ultrafast-Modus von GPT-6.1 Sol ist sechsmal so hoch wie im Standardmodus. Dadurch verlagert sich der Fokus dieses Updates weiter von der Frage „Wie intelligent ist das Modell?“ hin zu „Wie viel ist es wert, ein bisschen weniger zu warten?“.
Offiziell wird angegeben, dass die Leistung nahe an Astra liegt
OpenAI positioniert GPT-6.1 Sol so, dass es bei komplexer Programmierung, Computeroperationen und professionellen Arbeiten eine Leistung nahe an GPT-6 Astra zu geringeren Kosten bietet.
Tatsächlich zeigt das Modell GPT-6.1 Sol in einigen Benchmark-Tests viele beeindruckende Ergebnisse.
Im Vergleich zu GPT-6 Sol hat es bei komplexen professionellen Aufgaben eine deutlich verbesserte Leistung, die die Codeerstellung und -debugging, das Dokumentenverständnis sowie die Ausführung mehrstufiger Arbeitsabläufe im Unternehmen umfasst. In vielen dieser Bewertungen erreicht es eine Leistung nahe an GPT-6 Astra zu deutlich geringeren Kosten.
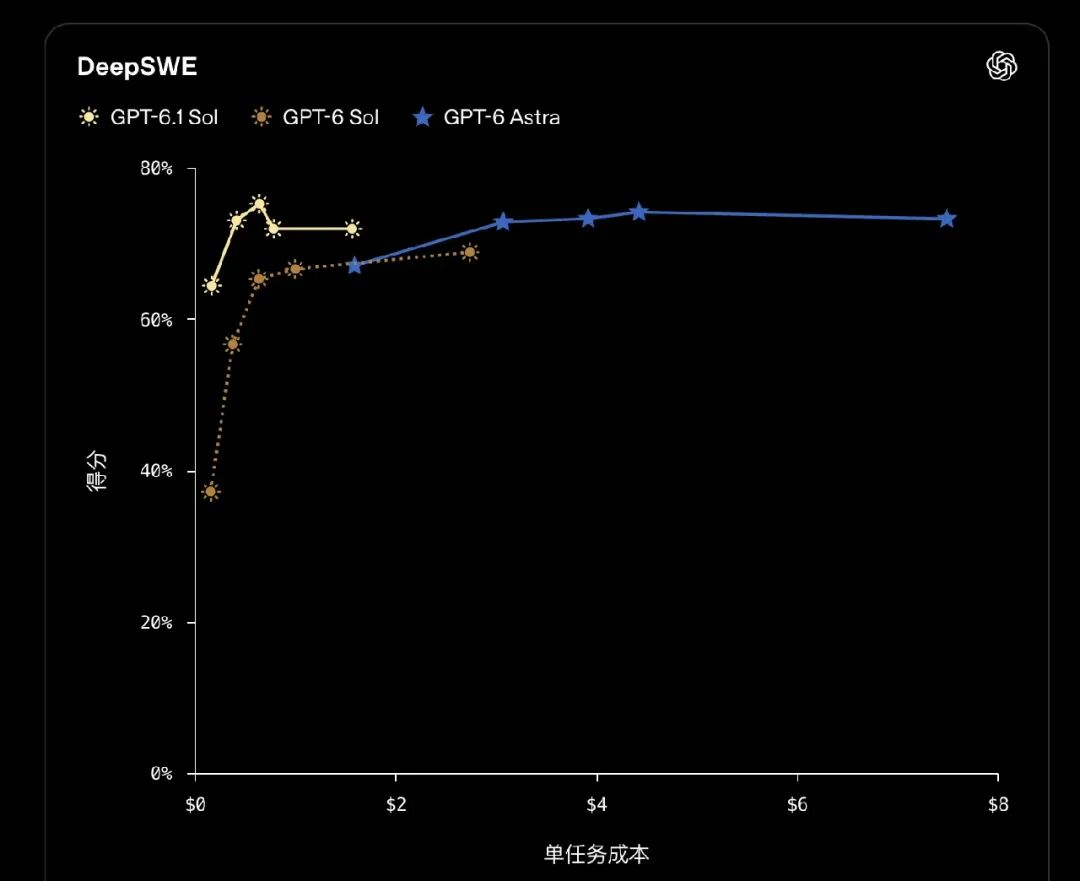
Im Bereich der Programmierung erreicht GPT-6.1 Sol im Test DeepSWE v1.1 mit etwa einem Fünftel der Kosten ein Niveau, das mit GPT-6 Astra vergleichbar ist. Gleichzeitig übertrifft es den Höchstwert von GPT-6 Sol um 6,4 Prozentpunkte bei geringerer Inferenzintensität und niedrigeren Kosten.
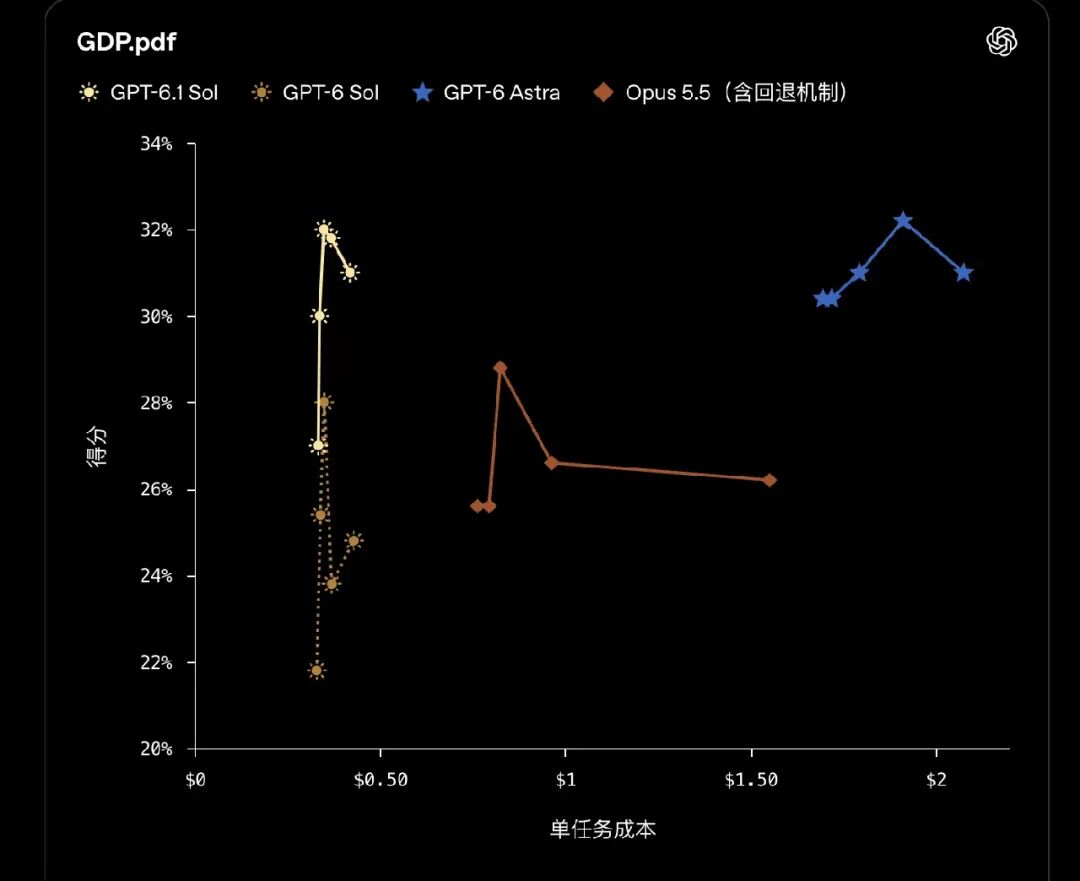
Im Bereich der professionellen Arbeit liegt bei GDP.pdf unter allen getesteten Inferenzeinstellungen die Punktzahl von GPT-6.1 Sol über der von Opus 5.5 mit Rollback-Mechanismus, während die Kosten pro Aufgabe weniger als die Hälfte davon betragen. Es erreicht mit etwa einem Fünftel der Kosten pro Aufgabe auch eine Leistung nahe an GPT-6 Astra.
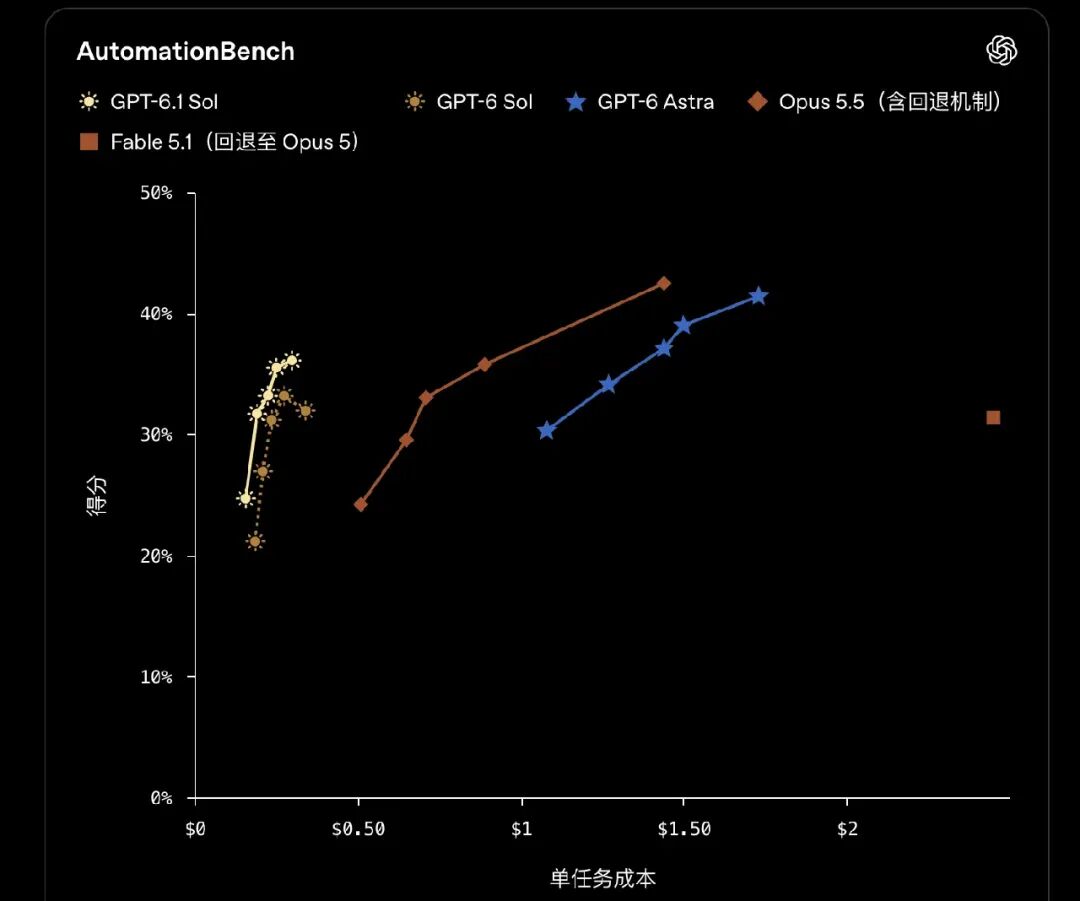
AutomationBench misst, ob Agenten mehrstufige Unternehmensarbeitsabläufe korrekt abschließen können. Bei dieser Bewertung liegt die Punktzahl von GPT-6.1 Sol bei mittlerer Inferenzintensität um 2,2 Prozentpunkte höher als die von Opus 5.5, während die Kosten etwa ein Drittel davon betragen. Diese Punktzahl liegt auch um 4,8 Prozentpunkte höher als die von GPT-6 Sol unter denselben Einstellungen.
Auf X schrieb Tibo, Leiter des Codex-Teams: „Wir haben einige Funktionen verbessert, um die Antwortgeschwindigkeit des Modells zu erhöhen, sodass wir schneller auf die Anpassungen der Nutzer reagieren können. Sie können die Ausrichtung in Echtzeit korrigieren und vermeiden, dass das Modell Ressourcen verschwendet. Gleichzeitig haben wir die Ultrafast-Version von GPT-6.1 Sol veröffentlicht. Die Kombination beider Funktionen funktioniert hervorragend.“
Gleichzeitig positioniert die offizielle Seite Astra weiterhin als das leistungsstärkste Modell für die Bewältigung der schwierigsten Aufgaben und empfiehlt den Nutzern, beide Modelle für ihre eigenen Aufgaben zu vergleichen, um den Kompromiss zwischen Qualität und Kosten zu beurteilen.
Aus den öffentlichen Spezifikationen gehen hervor, dass Sol und Astra dieselbe Kontextkapazität und maximale Ausgabelänge haben, während die Einzelpreise für Eingabe und Ausgabe im Standardmodus deutlich voneinander abweichen.
Quelle: Offizielle Modellvergleichsseite von OpenAI.
Bei gleicher Anzahl von Token sind die Standard-Eingabe- und Ausgabekosten von Sol um 80 % niedriger als die von Astra. Dieser Prozentsatz lässt sich jedoch nicht direkt in „80 % günstiger für die Erledigung derselben Aufgabe“ umrechnen: Wie viele Inferenz- und Ausgabetoken das Modell tatsächlich generiert, ob Wiederholungen erforderlich sind und wie viele Tools aufgerufen werden, wirken sich alle auf die endgültige Rechnung aus.
Bei diesem Ultrafast-Update müssen auch zwei Arten von „Leistung“ unterschieden werden: Die eine ist die Qualität der Aufgabenerledigung, die andere die Geschwindigkeit der Aufgabenerledigung.
Wie wird der Preis berechnet?
Der Standardmodus, der Fast-Modus und der Ultrafast-Modus von GPT-6.1 Sol werden jeweils zu unterschiedlichen Einzelpreisen berechnet. Für Anfragen mit nicht mehr als 272.000 Eingabetoken gelten folgende API-Preise:
Quelle: Offizielle API-Preisseite von OpenAI.
Das bedeutet, dass der Einzelpreis des Ultrafast-Modus sechsmal so hoch ist wie der des Standardmodus und dreimal so hoch wie der des Fast-Modus. Es ist hervorzuheben, dass der sechsfache Preis nicht die sechsfache Geschwindigkeit bedeutet – beide Größen lassen sich nicht direkt einander zuordnen.
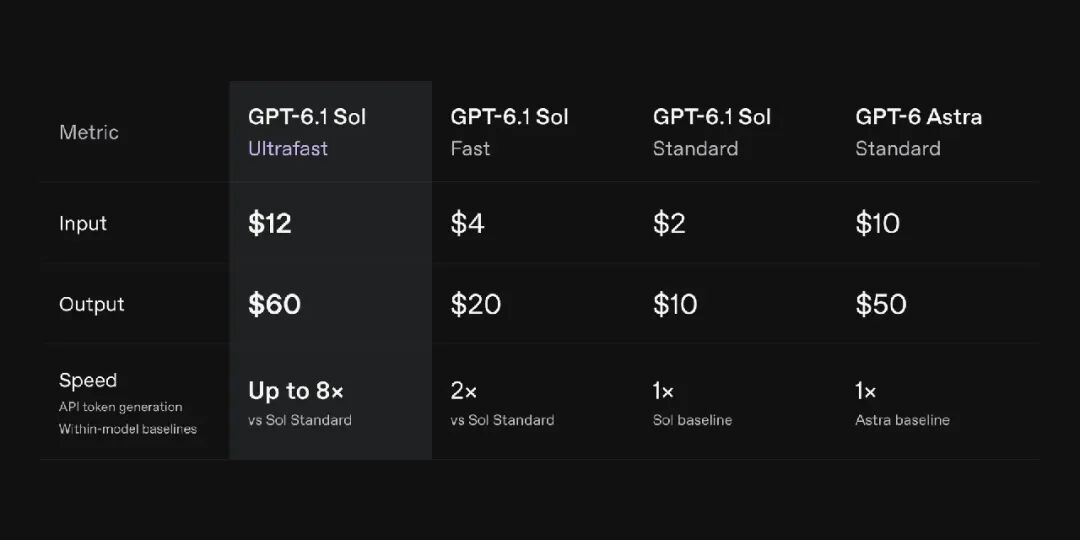
Ein vereinfachtes Beispiel für eine Rechnung: Angenommen, eine Anfrage verbraucht 100.000 nicht zwischengespeicherte Eingabetoken und 10.000 abrechenbare Ausgabetoken, ohne Berücksichtigung anderer Kosten wie Tools. Dann betragen die Kosten im Standardmodus etwa 0,30 US-Dollar, im Fast-Modus etwa 0,60 US-Dollar und im Ultrafast-Modus etwa 1,80 US-Dollar. Dies ist ein Berechnungsbeispiel nach den offiziellen Einzelpreisen und kein praktischer Aufgabentest.
Lange Kontexte erhöhen den Preis weiter. Wenn die Eingabe 272.000 Token überschreitet, steigt der Eingabepreis von GPT-6.1 Sol im Ultrafast-Modus auf 24 US-Dollar pro Million Token und der Ausgabepreis auf 90 US-Dollar. Laut offizieller Regelung wirkt sich der Multiplikator für lange Kontexte auf die gesamte Anfrage aus, nicht nur auf den Teil, der den Schwellenwert überschreitet.
Ein weiterer leicht zu übersehender Vergleich: Die Eingabe- und Ausgabepreise von Sol im Ultrafast-Modus betragen 12 US-Dollar bzw. 60 US-Dollar pro Million Token und liegen damit bereits über denen von Astra im Standardmodus (10 US-Dollar bzw. 50 US-Dollar). Bei gleicher Token-Anzahl ist der erstere um 20 % höher. Daher muss der Vorteil von Sol mit „niedrigeren Kosten“ in Verbindung mit der Dienststufe beurteilt werden. Nach der Auswahl des Ultrafast-Modus stammt der Wert, den Nutzer erwerben, hauptsächlich aus der verkürzten Wartezeit.
Auf der API-Seite ist der Ultrafast-Modus von GPT-6.1 Sol allen API-Nutzern zugänglich und verfügt über eine von dem Standard- und Fast-Modus unabhängige Ratenbegrenzung. Er unterstützt die globale Verarbeitung sowie die Datenresidenz in den USA und der Europäischen Union.
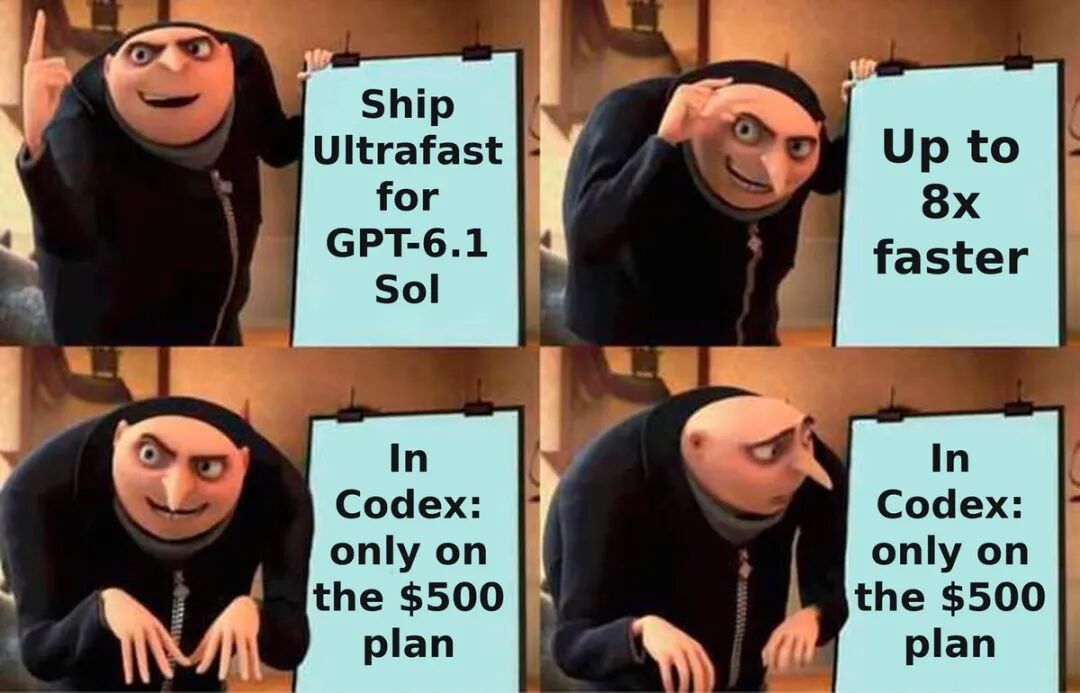
Der Zugriff auf der Produktseite von ChatGPT ist eingeschränkter. Laut der offiziellen Dokumentation ist GPT-6.1 Sol in Work und Codex verfügbar, das normale Chat-Modus bietet dieses Modell nicht an. Die Erstveröffentlichung des Sol-Modells deckt Plus, Pro, Business, Enterprise und Edu ab, aber der Ultrafast-Modus ist nur für die Pro-Stufe mit 500 US-Dollar sowie für berechtigte Enterprise- und Edu-Pläne zugänglich. Die tatsächliche Verfügbarkeit hängt zudem von den Einstellungen des Clients, des Arbeitsbereichs und dem Rollout-Fortschritt ab.
Der Verbrauch des Abonnementguthabens lässt sich auch nicht direkt auf den Preis-Multiplikator der API übertragen. Laut der offiziellen Preiserklärung verbraucht der Ultrafast-Modus von GPT-6.1 Sol das im Abonnement enthaltene Nutzungsguthaben achtmal so schnell wie der Standardmodus. Bei gekauften zusätzlichen Guthaben und nutzungsbasierter Bezahlung für Unternehmen gilt der Multiplikator 6.
Nutzer: Wir brauchen mehr Guthaben, ihr bietet uns nur Geschwindigkeit
Rund um den Ultrafast-Modus von GPT-6.1 Sol führen Nutzer auf Plattformen wie X und Reddit lebhafte Diskussionen. Die Diskussionen konzentrieren sich hauptsächlich auf zwei Fragen: Ob die Geschwindigkeitssteigerung Agenten wirklich praktikabel macht, und ob Nutzer die deutlich höheren Kosten dafür übernehmen sollten.
Befürworter sind der Meinung, dass die Bedeutung der Geschwindigkeit für Agenten über „schnellere Antworten auf Fragen“ hinausgeht.
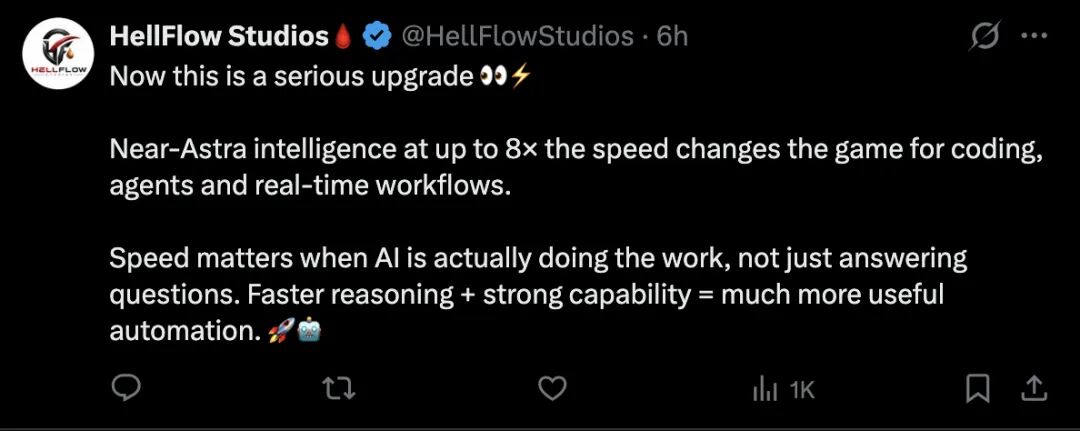
Auf X gab der Nutzer mit dem ID-Namen HellFlow Studios an, dass schnellere Inferenz in Kombination mit starker Fähigkeit die Praktikabilität der Automatisierung verbessern kann, wenn KI tatsächlich Aufgaben ausführt – insbesondere in der Programmierung, bei Agenten und in Echtzeit-Arbeitsabläufen.
Brian Gastón und Shrilaxmi richten ihren Fokus auf die wiederholten Arbeitszyklen von Agenten: Die Latenz in mehrstufiger Inferenz und Tool-Aufrufen summiert sich ständig, und die Geschwindigkeit bestimmt, ob solche Produkte zu alltäglichen Werkzeugen werden können.
Brian wies jedoch auch darauf hin, dass es noch zu beobachten gilt, ob der Ultrafast-Modus seine Leistung bei Aufgaben mit lang andauernden, aufeinanderfolgenden Tool-Aufrufen aufrechterhalten kann.
Ein anderer Nutzer äußerte, dass die Nutzer längere Nutzungszeit brauchen, keine schnelleren Modelle. Wenn man das Guthaben nie aufbrauchen kann, welchen Sinn hat dann die extrem hohe Geschwindigkeit???
Clarity Today wies darauf hin, dass die Abrechnungsgrundlagen für API, Codex und Work unterschiedlich sind und man das Budget nicht direkt übertragen kann. Ob sich die Geschwindigkeitssteigerung lohnt, hängt davon ab, ob die Wartezeit der Nutzer hauptsächlich von der Modellgenerierung oder der Ausführung externer Tools verursacht wird.
Die Zugriffshürden und der Guthabenverbrauch des Ultrafast-Modus haben auch die Unzufriedenheit einiger zahlender Nutzer ausgelöst.
Auf X richtete der Nutzer DoubleStraddle seine Kritik an der Abonnement-Schichtung und spottete, dass diese Veröffentlichung Nutzer, die monatlich 200 US-Dollar zahlen, das Gefühl gibt, ignoriert zu werden – als ob nur Nutzer der 500-US-Dollar-Stufe neue Funktionen erhalten dürfen.
