Das von der Tsinghua-Universität entwickelte verkörperte Modell belegt den ersten Platz weltweit, übertrifft GPT-6 und NVIDIA, ohne auf externe Erweiterungen und zusätzliche Daten angewiesen zu sein.
Mensch, auf dem Gebiet der World Action Model (WAM) hat ein chinesisches Team direkt den ersten Platz weltweit erreicht?!
Zudem wurden zahlreiche weltweit führende Embodied-Modelle wie GPT-6-Astra, π0.5 von Physical Intelligence und NVIDIA GR00T-N1.7 dieses Mal alle hinter sich gelassen.
Der Akteur ist ein chinesisches Robotikunternehmen – Xingdong Era, das einzige direkt verbundene Embodied-Unternehmen, das ausschließlich von der Tsinghua-Universität gehalten wird.
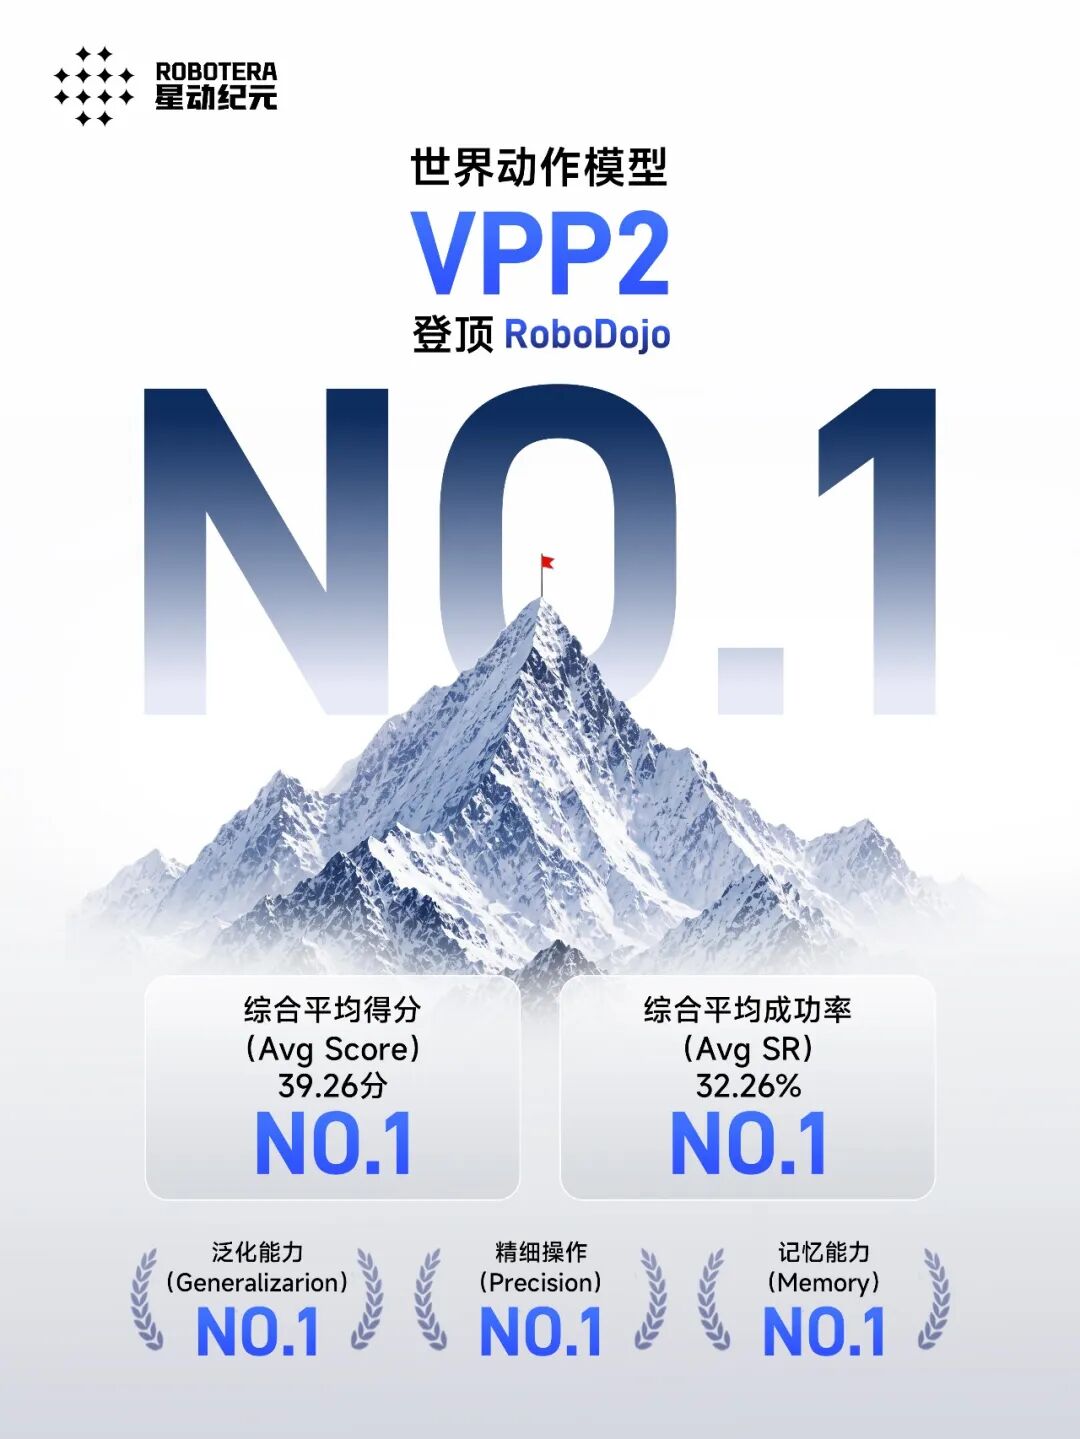
Kürzlich hat das selbstentwickelte World Action Model VPP2 von Xingdong Era direkt die Spitze der RoboDojo-Simulationsrangliste erklommen.
Mit einer durchschnittlichen Gesamterfolgsrate von 32,26 % und einer durchschnittlichen Gesamtpunktzahl von 39,26 Punkten belegen beide Indikatoren den ersten Platz.
Der entscheidende Punkt ist, dass dieser Wettbewerb wirklich nicht einfach zu gewinnen ist.
RoboDojo wird als „Mount Everest“ der Embodied-Intelligenz bezeichnet und wird vom MMLab der Universität Hongkong angeführt, gemeinsam von fast 20 weltweit führenden akademischen Einrichtungen aufgebaut.
Es stellt Aufgaben genau dort, wo Roboter schlecht abschneiden: Können sie ihre Arbeit noch erledigen, wenn sie in eine andere Umgebung versetzt werden? Können sie Objekte noch präzise greifen, wenn diese schief stehen? Erinnern sie sich noch an das, was zuvor passiert ist, wenn sie die Aufgabe zur Hälfte erledigt haben?
Kurz gesagt, es ist nicht so einfach, nur durch Übungserfahrung durchzukommen.
Und das Ergebnis?
VPP2 von Xingdong Era hat nicht nur den ersten Gesamtrang belegt, sondern auch in den drei Dimensionen Generalisierungsfähigkeit, feine Manipulation und Gedächtnisleistung den Spitzenplatz erreicht.
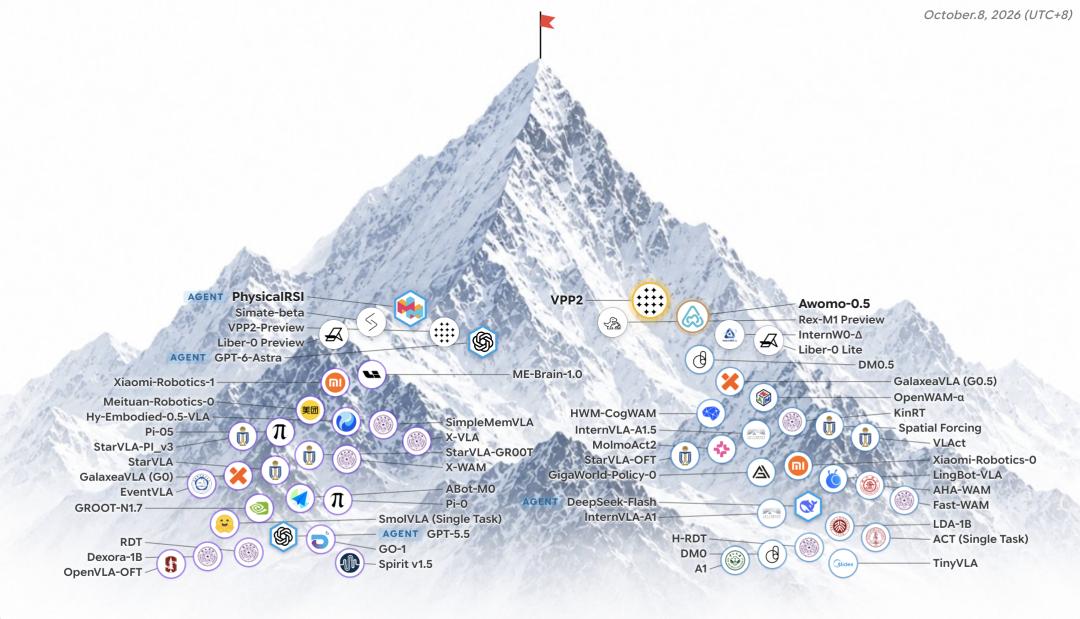
Es heißt, dass VPP2 dieses Mal keine zusätzlichen Daten hinzugefügt und keine Erweiterungsmethoden wie Agent RSI verwendet hat, sondern nur mit dem „Standard-Datensatz“ zahlreiche Konkurrenten übertroffen hat.
Das bedeutet, dass das VPP2-Modell selbst stark genug ist, die Leistungssteigerung kommt vom Vortraining, die Basis verfügt über ausreichende Generalisierung, sodass es keine externen Erweiterungsstrategien oder erweiterte Daten zum „Punkte sammeln“ benötigt.
Moment mal, wie zum Teufel wurde dieses so leistungsstarke Modell trainiert???
Wir haben uns die technische Route genauer angesehen, und tatsächlich hat der Durchbruch von VPP2 dieses Mal etwas Besonderes.
Es zielt auf ein altes, schwieriges Problem der World Action Model ab: Wenn die Vorhersage falsch ist, folgen die Aktionen ebenfalls falsch.
Die Lösung von VPP2 besteht darin, zuerst die Fähigkeit zur Videovorhersage so stark wie möglich zu trainieren, bevor der Roboter in einer unbekannten Umgebung wirklich in Bewegung gesetzt wird.
Von der Vorhersage zur Aktion werden beide Generalisierungsfähigkeiten gleichzeitig verbessert.
Aus den derzeit veröffentlichten Testergebnissen ist VPP2 bereits einer der wettbewerbsfähigsten Kandidaten auf dem Gebiet des World Action Model WAM.
World Action Model WAM: Ein neuer Champion geht aus dem harten Wettbewerb hervor
In der Embodied-Intelligenz-Branche gibt es ein ziemlich peinliches Phänomen.
Die Demo-Vorführungen von Robotern werden immer spektakulärer, die Punktzahlen der Modellranglisten steigen stetig an – aber wenn man fragt, wessen Roboter klüger ist und besser arbeiten kann?
Darauf gibt es keine einfache Antwort.
Nehmen wir das Beispiel, dass ein Roboter einen Becher greifen soll. Auf dem Tisch, den er während des Trainings gesehen hat, trifft er möglicherweise jedes Mal zielgenau. Sobald man aber einen anderen Becher nimmt oder die Position verändert, gerät er sofort in Verwirrung.
Ganz zu schweigen von Aufgaben, die mehrere aufeinanderfolgende Schritte erfordern.
Aus diesem Grund verdient das Bewertungssystem von RoboDojo Aufmerksamkeit.
Sein Ziel ist es, ein einheitliches, reproduzierbares Bewertungsstandard für Embodied-Intelligenz zu etablieren. Die Simulationstests umfassen 42 Aufgaben für zweihändige Manipulation und decken fünf Dimensionen ab: Generalisierung, präzise Manipulation, Langzeitaufgaben, Gedächtnis und Verständnis von Anweisungen in offenem Vokabular.
Einfach ausgedrückt: Es holt den Roboter aus seiner Komfortzone heraus.
Herkömmliche Robotermodelle erreichen bei vertrauten Aufgaben fast die volle Punktzahl, sobald sich Umgebung, Objektposition oder Aufgabenkombination ändern, sinkt die Erfolgsrate deutlich.
RoboDojo untersucht gezielt solche komplexen Situationen, um zu prüfen, wie viel Generalisierungsfähigkeit der Roboter bei Veränderungen aufweist.
Das Ergebnis, das VPP2 dieses Mal vorgelegt hat, ist sehr beeindruckend.
Mit einer durchschnittlichen Erfolgsrate von 32,26 % und einer durchschnittlichen Punktzahl von 39,26 Punkten belegen beide Indikatoren den ersten Platz.
Zum Vergleich: In der Nachtrainingsbewertung des RoboDojo-Simulationsbenchmarks erreicht GPT-6-Astra eine durchschnittliche Erfolgsrate von 22,48 % und eine durchschnittliche Punktzahl von 28,97 Punkten.
Und VPP2 liegt um 9,78 Prozentpunkte bzw. 10,29 Punkte vorne.
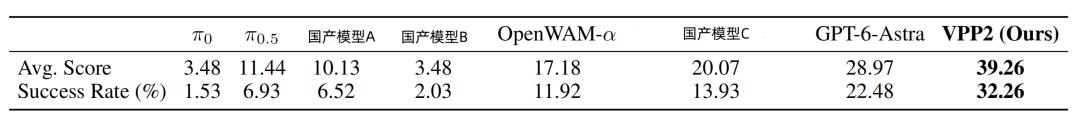
△ Screenshot aus der Arbeit, die Basismodelldaten stammen von der offiziellen Rangliste
Die beiden Indikatoren haben unterschiedliche Schwerpunkte: Die Erfolgsrate misst, ob der Roboter die Aufgabe vollständig abschließen kann; die durchschnittliche Punktzahl misst, bis zu welchem Schritt die Aufgabe fortgeschritten ist, und spiegelt auch die phasenweise Leistung wider, selbst wenn die Aufgabe nicht vollständig abgeschlossen werden kann.
Beide Indikatoren kombinieren die Testergebnisse der fünf Fähigkeitsdimensionen.
Mit anderen Worten: VPP2 schließt nicht nur einen höheren Anteil von Aufgaben ab, sondern zeigt auch bei nicht abgeschlossenen Aufgaben eine stärkere Fähigkeit zur phasenweisen Erledigung.
Und diese Überlegenheit beschränkt sich nicht auf das Gesamtergebnis.
Wenn man die fünf Fähigkeitsdimensionen einzeln betrachtet, belegt VPP2 auch in den Dimensionen Generalisierung, präzise Manipulation und Gedächtnis den ersten Platz.
Diese drei Fähigkeiten entsprechen mehreren Hürden, die Roboter beim Eintritt in die reale Welt überwinden müssen: Ob sie in einer neuen Umgebung arbeiten können, ob ihre Manipulation präzise ist und ob sie sich bei aufeinanderfolgenden Aufgaben an die vorherigen Schritte erinnern können.
Überlegenes Gesamtergebnis und starke Kernfähigkeiten.
Aber selbst wenn RoboDojo sehr schwierig ist, befindet sich die Testumgebung schließlich immer noch in einer „simulierten Umgebung“. In der physischen Welt führen Reibung, Verformung und Positionsabweichungen von Objekten zu weiteren unvorhergesehenen Variablen.
Die Generalisierungsfähigkeit, die VPP2 in der Simulation gezeigt hat, gilt sie auch auf echten Robotern?
Xingdong Era hat dazu ebenfalls Experimente durchgeführt.
Dieses Mal hat das Team VPP2 direkt auf einem echten ALOHA-Zweiarme-Roboter bereitgestellt und 10 Arten von Zero-Shot-Manipulationsaufgaben wie Greifen, Ablegen, Stapeln, Falten und Ausgießen getestet.
Das heißt, der Roboter muss die Aufgaben direkt ausführen, ohne dass er zusätzlich auf diese Testaufgaben abgestimmt wird.
Als Ergebnis liefert VPP2 wieder ein überlegenes Ergebnis: Die durchschnittliche Erfolgsrate beträgt 58,5 %, höher als die 40 % von π0.5.
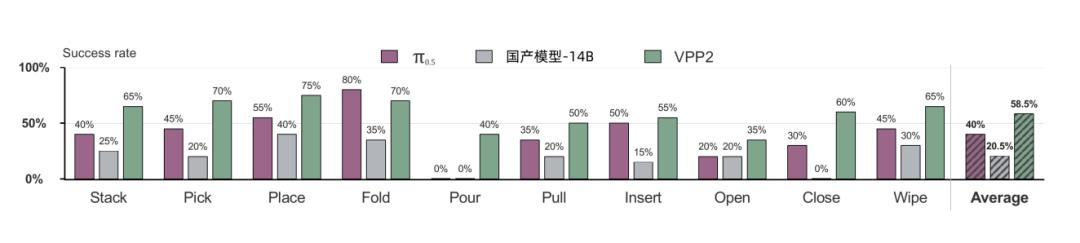
Von den 10 Aufgabentypen erzielt VPP2 bei 9 Typen das beste Ergebnis.
Das ist sehr interessant.
Der erste Platz in der Rangliste beweist seine Fähigkeit im Standardbewertungssystem; die Zero-Shot-Manipulation auf echten Robotern prüft zusätzlich, ob diese Fähigkeiten auf die reale physische Umgebung übertragen werden können.
Mit diesen beiden Ergebnissen wird der technische Vorteil von VPP2 noch tiefergehend zu untersuchen.
Man muss wissen, dass VPP2 der Richtung des World Action Model (WAM) folgt.
Die Grundidee dieser Art von Modellen besteht darin, zu verstehen, wie sich die physische Welt in Zukunft verändern wird, mithilfe von Videovorhersage und diese Vorhersage dann in Roboteraktionen umzuwandeln.
Aber diese Richtung hat seit langem ein Problem: Eine schöne Videovorhersage bedeutet nicht, dass der Roboter wirklich arbeiten kann.
VPP2 zielt dieses Mal genau auf dieses Problem ab.
Von der Vorhersagegeneralisierung zur Aktionsgeneralisierung: Wie hat VPP2 das geschafft?
Um den Durchbruch von VPP2 zu verstehen, betrachten wir zunächst eine einfache Aufgabe: Der Roboter soll den Becher auf dem Tisch in eine Box legen.
Für Menschen ist das Ausstrecken der Hand, Greifen, Anheben und Hineinlegen fast ohne Nachdenken möglich.
Aber der Roboter muss die Position des Bechers, die Bewegungsbahn des mechanischen Arms, den Zeitpunkt des Schließens der Greifzange beurteilen und vorhersagen, welche Veränderungen in der physischen Welt während des gesamten Vorgangs stattfinden. Jede Abweichung in einem Schritt kann zum Scheitern führen.
Genau hier treten Probleme bei den vorhandenen World Action Modellen (WAM) auf.
Auf der einen Seite sind gewöhnliche Videomodelle gut darin, Bilder zu erzeugen, aber dass die Bilder vernünftig aussehen, ist nicht dasselbe wie der Einhaltung echter physikalischer Gesetze.
Zum Beispiel soll der Roboter den Becher auf der linken Seite greifen, aber das Modell sagt voraus, dass er den Becher auf der rechten Seite greift. Das Video kann trotzdem erzeugt werden, aber der Roboter weicht bei der Ausführung direkt vom richtigen Weg ab.
Auf der anderen Seite kann das direkte Hinzufügen von Aktionslernen zum Videomodell die ursprüngliche Generalisierungsfähigkeit beeinträchtigen.
Das Ergebnis ist, dass der Roboter die Aktionen gelernt hat, aber in einer neuen Umgebung nicht mehr arbeiten kann.
VPP2 trifft eine sehr direkte Feststellung: Die Qualität der Videovorhersage bestimmt die Obergrenze der Aktionen.
Auf dieser Grundlage hat Xingdong Era sich entschieden, Videovorhersage und Aktionslernen phasenweise zu trainieren. Der Schwerpunkt liegt nicht darauf, „Video und Aktion zusammen zu mischen“, sondern die beiden zu „entkoppeln“ und neu zu „ordnen“.
Xingdong Era hat dafür eine dreistufige Trainingsstrategie entwickelt:
Erste Stufe: Weiteres Vortraining von ereignisbasierten Videos, sodass das Modell lernt, den vollständigen Manipulationsvorgang vorherzusagen.
Zweite Stufe: Nachtraining und Destillation von Videos mit fester Dauer, sodass die Vorhersagefähigkeit der Echtzeit-Ausführungsgeschwindigkeit des Roboters folgt.
Dritte Stufe: Training von Aktionsspezialisten, um die Videovorhersage in konkrete Aktionen umzuwandeln und gleichzeitig die ursprüngliche Generalisierungsfähigkeit so weit wie möglich zu erhalten.
