Übertragung der haptischen Eigenschaften menschlicher Hände auf Roboter: Mit 500 Stunden an realen Betriebsdaten wird die Erfolgsrate der Aufgaben verdoppelt.
Nimmt man ein rohes Ei in die Hand, müssen die Finger genau die richtige Kraft ausüben: Es darf nicht herunterrutschen, aber auch nicht zerdrückt werden. Beim Auswringen eines nassen Handtuchs muss die Kraft der Fingerspitzen ständig angepasst werden, während das Wasser herausgedrückt wird. Für den Menschen geschehen diese Handlungen fast instinktiv. Verläßt man sich aber ausschließlich auf das Sehen, kann die Kamera die Bewegung der Hände aufzeichnen, nicht aber die Stelle, an der die Finger den Kontakt berühren, und den ausgeübten Druck erfassen.
In den letzten Jahren hat sich die Menge an menschlichen Videos aus der Egoperspektive in der akademischen Welt schnell auf zehntausende Stunden ausgeweitet, und immer mehr Arbeiten zeigen die Vorteile, die durch die wachsende Datenmenge entstehen. Visuell-taktile Daten haben dieses Ausmaß bei weitem nicht erreicht: Die meisten bisher veröffentlichten menschlichen visuell-taktilen Datensätze umfassen nur wenige bis mehrere Dutzend Stunden. Wenn man einfach mehrere kleine Datensätze zusammenführt, unterscheiden sich die taktilen Sensoren, Erfassungsverfahren und Datenformate der einzelnen Quellen zwar. Die Datenmenge steigt, aber gleichzeitig ändern sich auch die Hardware und die Abläufe, sodass es schwierig ist, zu beurteilen, wie viel Beitrag die „größere Datenmenge“ allein leistet.
Kürzlich haben Forscher von 15 Institutionen wie der Texas A&M University, Google DeepMind, der Carnegie Mellon University (CMU), der Stanford University, der University of California, Berkeley, der Yale University, Microsoft, NVIDIA, der University of Liverpool, Meta, der University of Washington, der Northwestern University, Sony, dem Georgia Institute of Technology (Georgia Tech) sowie Overfit Lab (Datenanbieter) TouchScale veröffentlicht: ein 500-stündiger menschlicher visuell-taktiler Datensatz, der mit einheitlichen Sensoren sowie einheitlichen Erfassungs- und Synchronisationsverfahren aufgebaut wurde.
Das Team möchte damit eine Schlüsselfrage beantworten: Wenn man nicht mehr Daten aus unterschiedlichen Quellen zusammenfügt, sondern innerhalb desselben Sensor- und Erfassungssystems hochwertige visuell-taktile Daten aus der Egoperspektive tatsächlich auf hunderte Stunden ausweitet – zeigt dies dann ebenso wie bei großen Videodaten Skalierungsvorteile, die mit der wachsenden Datenmenge einhergehen? Wie viel dieser Skalierungsvorteile kann darüber hinaus in die Bedienfähigkeiten von Robotern umgewandelt werden?
Was bringt TouchScale?
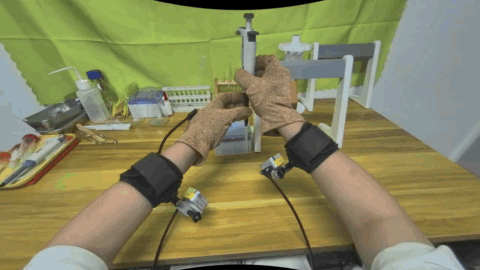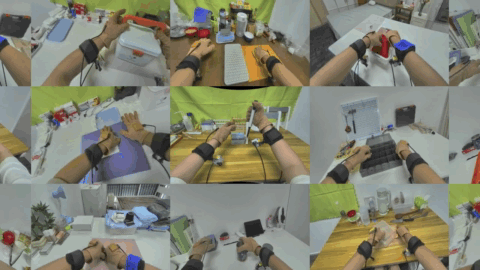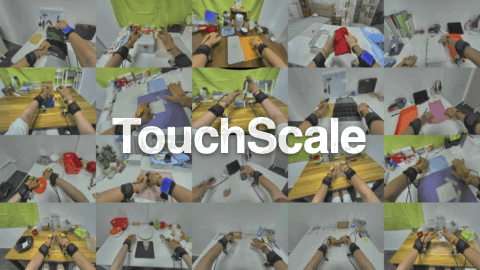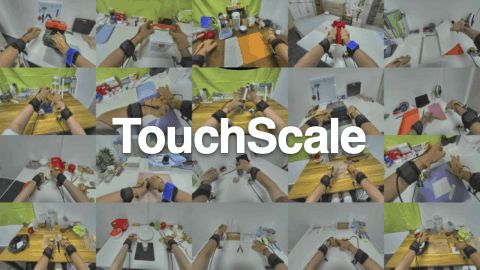
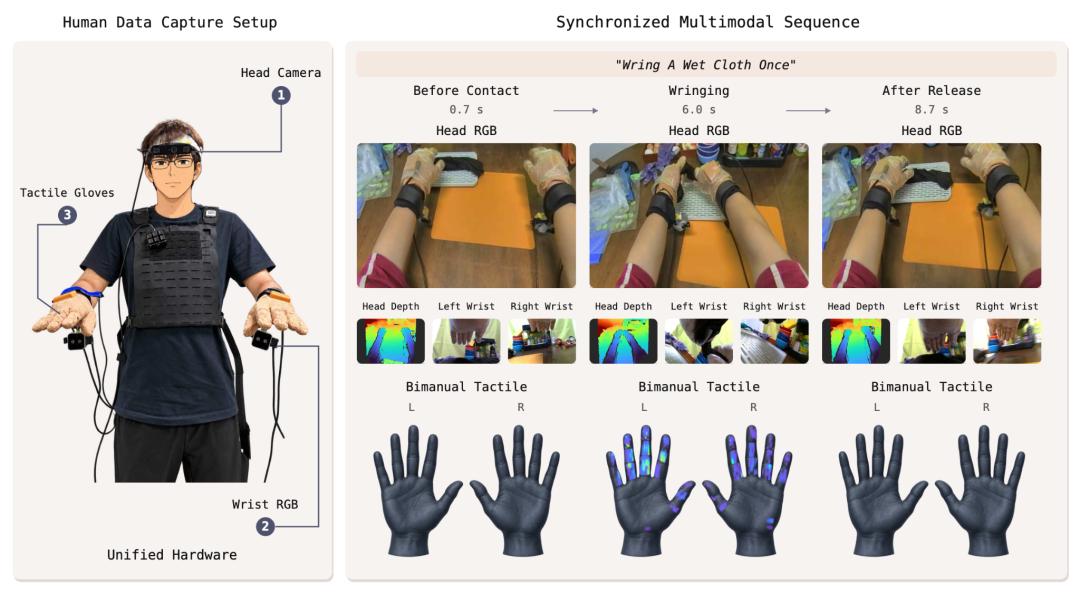
1. 500 Stunden Erfassung mit einheitlichen tragbaren Geräten. TouchScale umfasst 500 Stunden synchroner visuell-taktiler Daten von menschlichen Händen, die vollständig mit demselben tragbaren System erfasst wurden. Es werden gleichzeitig das RGB-D-Signal des Kopfes, die RGB-Signale beider Handgelenke und die taktilen Signale der gesamten beiden Hände aufgezeichnet.
2. Das menschliche „Tastgefühl“ kann auf Roboter übertragen werden. Ohne Notwendigkeit von Beschriftungen menschlicher Bewegungen und ohne Abbildung menschlicher Handbewegungen auf den Roboter wird nur mit menschlichen visuell-taktilen Daten ein Mid-Training durchgeführt. Dadurch steigt die durchschnittliche Erfolgsrate des Roboters bei vier realen Kontaktaufgaben von 22,5 % auf 57,5 %.
3. Hunderte Stunden menschlicher visuell-taktiler Daten zeigen deutliche Skalierungsvorteile. Wenn TouchScale für das Mid-Training verwendet wird, verbessert sich die Leistung des Roboters bei realen Bedienaufgaben mit zunehmender Datenmenge; in unabhängigen Experimenten zur taktilen Vorhersage ohne vorherige Beispielanpassung wurde derselbe Aufwärtstrend beobachtet. Die Skalierungsvorteile erstrecken sich von der Wahrnehmung bis hin zur Robotersteuerung.
- Titel: TouchScale: 500 Hours of Human Vision and Touch for Visual-Tactile Learning
- Link zur Arbeit: https://arxiv.org/abs/2610.10288
- Projektseite: https://touch-scale.github.io/
- Adresse des Datensatzes: https://huggingface.co/datasets/2077AIDataFoundation/TouchScale
500 Stunden taktile Daten: Die Herausforderung liegt nicht nur in der „großen Menge“
Für TouchScale besteht die eigentliche Schwierigkeit nicht darin, die Stundenzahl einfach auf 500 zu stapeln, sondern die Datenmenge kontinuierlich mit denselben Sensoren sowie denselben Synchronisations- und Erfassungsverfahren auszuweiten. Die meisten bisher veröffentlichten menschlichen visuell-taktilen Datensätze umfassen weniger als 30 Stunden; wenn man mehrere kleine Datensätze direkt zusammenfügt, ändern sich unterschiedliche Hardware und Erfassungsverfahren gemeinsam mit der Datenmenge, sodass es schwierig ist, den Einfluss der Datenmenge allein separat zu untersuchen.
TouchScale hat daher die Hardware bereits bei der Erfassung festgelegt. Die RGB-D-Kamera am Kopf zeichnet den gesamten Bedienvorgang und die Tiefe der Szene auf, während die RGB-Kameras an beiden Handgelenken die Interaktionsdetails zwischen Hand und Objekt aus nächster Nähe aufzeichnen. Beide Hände tragen taktile Handschuhe für die gesamte Hand, wobei jeder Handschuh 880 taktile Sensoreinheiten (Taxel) umfasst, die fünf Finger und die Handfläche abdecken, um den Normaldruck bei Kontakt aufzuzeichnen.
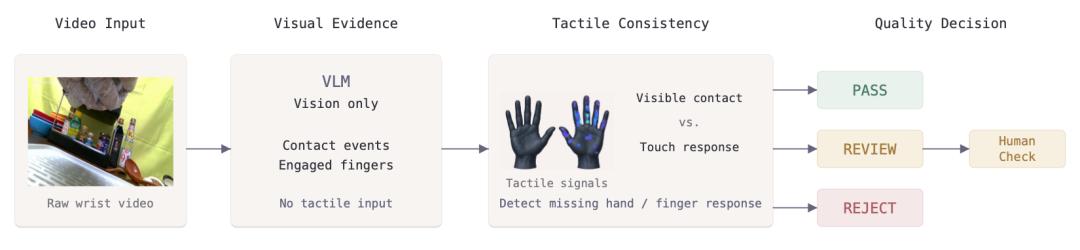
Um die Qualität der großen Menge taktiler Daten zu gewährleisten, steuert TouchScale die Datenqualität sowohl über die Hardware als auch über Algorithmen. Auf der Erfassungsseite werden hochpräzise, rauscharme flexible taktile Hautsensoren verwendet, um die Druckänderungen von Fingern und Handfläche während der Interaktion stabil aufzuzeichnen. Nach Abschluss der Erfassung wird durch einen VLM-gestützten automatischen Qualitätsprüfprozess anhand der Videos der Handgelenke beurteilt, ob ein Greifvorgang, ein Loslassen stattfindet und welche Finger am Kontakt beteiligt sind, was dann mit der tatsächlichen taktilen Reaktion abgeglichen wird. Deutliche Sensorausfälle werden direkt aussortiert, unsichere Proben wie fehlende Daten einzelner Finger, starke Verdeckungen oder unzureichende visuelle Beweise werden automatisch zur manuellen Überprüfung weitergeleitet.
Was wurde in den 500 Stunden genau erfasst?
TouchScale umfasst etwa 87.000 aufgenommene Interaktionen, rund 2000 Aufgabenbeschreibungen und mehr als 1500 Objekte, deckt 9 Arten von Erfassungsumgebungen und über 800 Szenenkonfigurationen ab und wurde von etwa 20 Erfassern durchgeführt. Die Aufgaben umfassen sowohl alltägliche Handlungen als auch feinere Kontaktvorgänge und die Verwendung von Werkzeugen. Zum Beispiel muss beim Eingießen von Wasser aus einer Kanne in eine Weithalsflasche die Haltung des Behälters ständig angepasst werden; das Aufrollen des Ladekabels eines Notebooks und die Befestigung mit einem Klettverschluss erfordert die Zusammenarbeit beider Hände und kontinuierlichen Kontakt; das Verschließen der oberen Fuge eines Kartons mit Klebeband umfasst Vorgänge wie das Greifen des Werkzeugs, die Positionierung und das anhaltende Drücken. Unterschiedliche Aufgaben, Objekte und Ausführungsarten führen auch zu unterschiedlichen Hando-Objekt-Haltungen und taktilen Kontaktmustern.
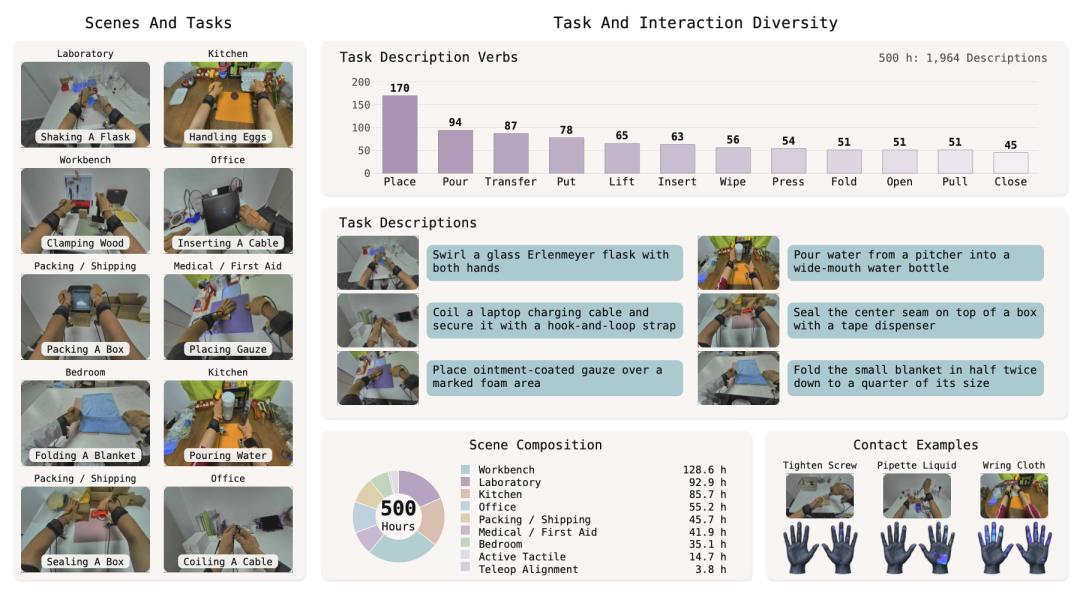
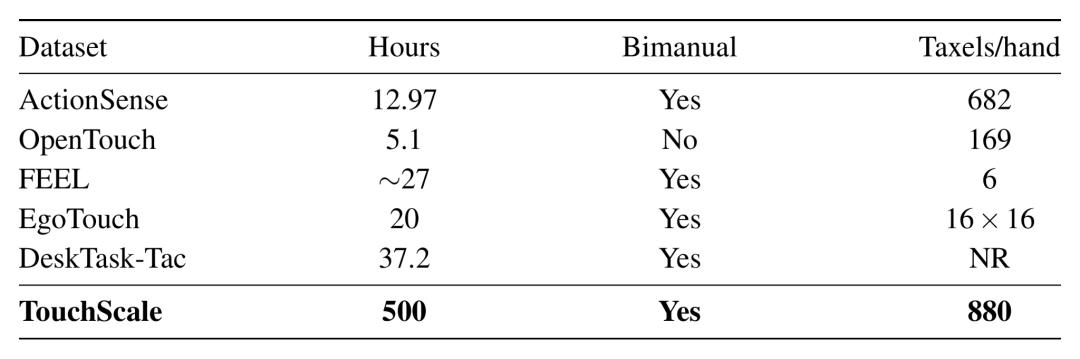
Im Vergleich zu den bereits veröffentlichten menschlichen visuell-taktilen Daten erweitert TouchScale nicht nur die Datenmenge auf 500 Stunden, sondern behält durchgehend einheitliche Sensoren und Erfassungsverfahren bei und bietet die taktile Erfassung der gesamten beiden Hände, wobei jede Hand 880 Taxel umfasst. Dies schafft die Voraussetzungen, um den Einfluss der Datenmenge selbst separat zu untersuchen.
Von der Wahrnehmung zur realen Robotersteuerung: Was bringen die 500 Stunden Daten?
Bei gleicher 16-stündiger Trainingsmenge bessere Generalisierung über unterschiedliche Sensoren hinweg
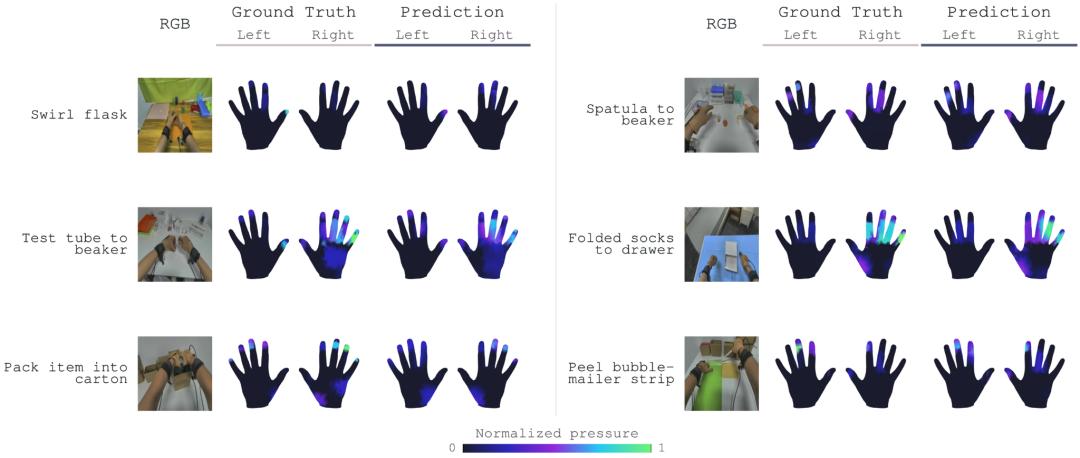
In der ersten Versuchsgruppe wurde die taktile Vorhersage ohne vorherige Anpassung über unterschiedliche Sensoren hinweg untersucht. Das Modell sagt das Tastgefühl der Hand anhand von Videos aus der Egoperspektive und den Handgelenksvideos voraus und wird direkt auf dem EgoTactile-Datensatz getestet, der mit anderen taktilen Handschuhen erfasst wurde, ohne dass eine Feinabstimmung mit Zieldaten erfolgt. Da die Sensoranordnungen unterschiedlicher Handschuhe variieren, werden die Ergebnisse bei der Auswertung auf 12 einheitliche anatomische Regionen der Hand abgebildet.
Zuerst wurde die Trainingsdatenmenge auf etwa 16 Stunden festgelegt: Das Modell, das mit einem Teildatensatz von TouchScale trainiert wurde, erreichte einen cIoU-Wert (Kontakt-Intersection-over-Union) von 0,181 und liegt damit über dem Wert von 0,134 bei EgoTouch. Dieser Vergleich schließt den Faktor „größere Datenmenge“ aus und zeigt, dass TouchScale bei gleicher Trainingsmenge auch für eine bessere Generalisierung über unterschiedliche Sensoren hinweg sorgt.
Taktile Überwachung kann umgekehrt auch das Sehen unterstützen
In der zweiten Versuchsgruppe wurde das taktile Signal als Überwachungssignal für einen visuellen Kodierer verwendet, und die erlernten visuellen Repräsentationen wurden dann auf Aufgaben zur Aktionserkennung übertragen. Die Forscher führten das Vortraining mit TouchScale, OpenTouch, FEEL und EgoTouch durch und behielten dabei dieselbe Initialisierung und dasselbe Trainingsbudget bei.
Auf den drei Benchmarks MECCANO, Something-Something V2 und Ego-Exo4D erzielte der visuelle Kodierer, der mit TouchScale vortrainiert wurde, sowohl bei der linearen Erkennung als auch bei der End-to-End-Feinabstimmung die höchste Genauigkeit im Vergleich zu den Kodierern, die mit OpenTouch, FEEL und EgoTouch vortrainiert wurden.
Abschließend der Test am realen Roboter: Kann der Roboter das menschliche „Tastgefühl“ nutzen?
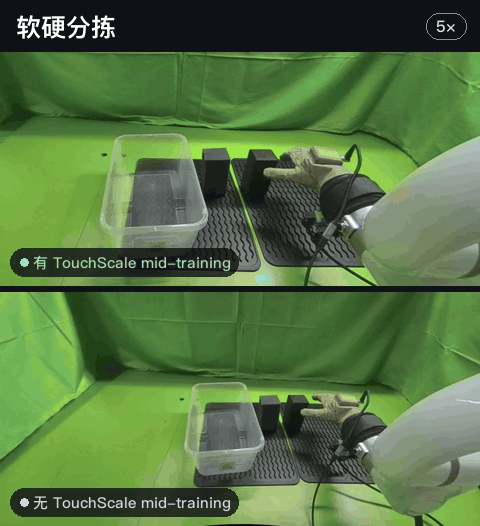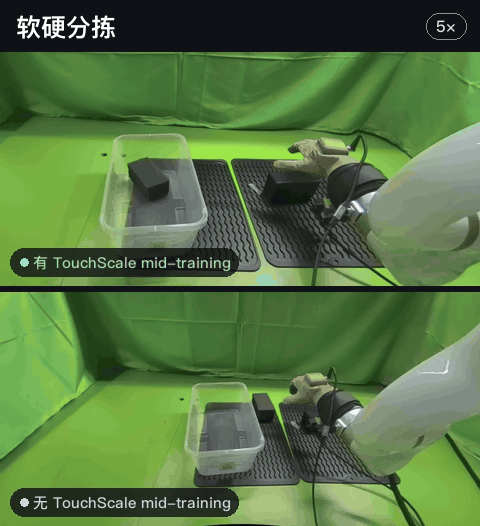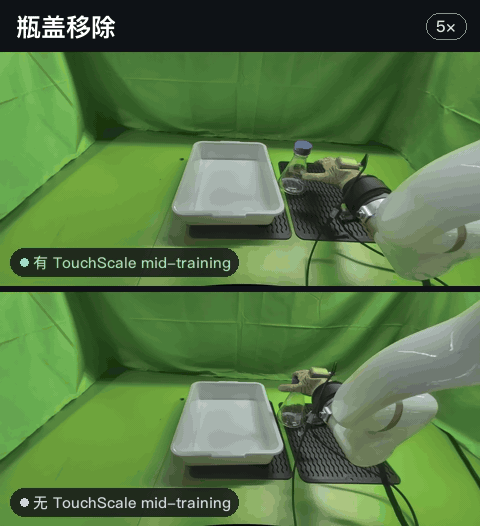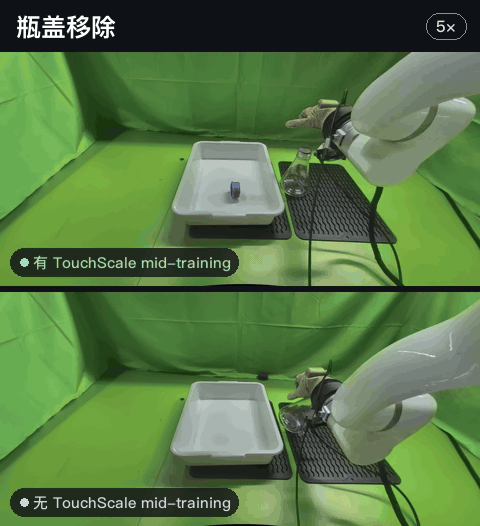
Bei den Experimenten am realen Roboter wurden ein xArm6-Manipulator und eine BrainCo Revo 2-Greifhand verwendet. Vier kontaktintensive Aufgaben wurden festgelegt: das Sortieren weicher und harter Objekte, das Entfernen von Flaschenverschlüssen, das Übertragen von Reagenzgläsern und das Wischen von Whiteboards. Für jede Aufgabe wurden 50 Demonstrationen des Roboters verwendet und 20 Tests durchgeführt.
Die Vergleichseinstellungen sind einfach: Beide Versionen gehen von demselben N0-VTLA-Checkpoint aus, verwenden visuelle und taktile Eingaben und nutzen exakt dieselben Roboter-Demonstrationen für das Post-Training. Der einzige Unterschied besteht darin, dass eine der Versionen vor dem Post-Training zunächst das TouchScale-Mid-Training durchläuft.
Beim TouchScale-Mid-Training werden keine Beschriftungen menschlicher Bewegungen verwendet, und die Bewegungsbahnen der menschlichen Hände werden nicht in Roboterbewegungen umgewandelt. Es wird das Ziel der zukünftigen taktilen Vorhersage von N0-VTLA beibehalten, sodass das Modell die nachfolgenden taktilen Änderungen anhand des aktuellen visuellen, sprachlichen und taktilen Zustands vorhersagt. Mit anderen Worten: Der Roboter lernt aus menschlichen Daten nicht, „wie sich die Hand bewegen soll“, sondern „wie der Kontakt zustande kommt“.
Nach der Integration des TouchScale-Mid-Trainings stieg die durchschnittliche Erfolgsrate bei den vier Aufgaben von 22,5 % auf 57,5 %, wobei sich alle vier Aufgaben verbesserten:
- Sortieren weicher und harter Objekte: 10 % → 60 %
- Entfernen von Flaschenverschlüssen: 40 % → 70 %
- Übertragen von Reagenzgläsern: 30 % → 60 %
- Wischen von Whiteboards: 10 % → 40 %