Gerade ist GPT-6.1 Sol Ultrafast erschienen.
Heute ist der vierte Tag von Tibos großartiger Aktion „28 aufeinanderfolgende Tage mit Veröffentlichungen oder Zurücksetzungen“ – jetzt kommt das Großartige!
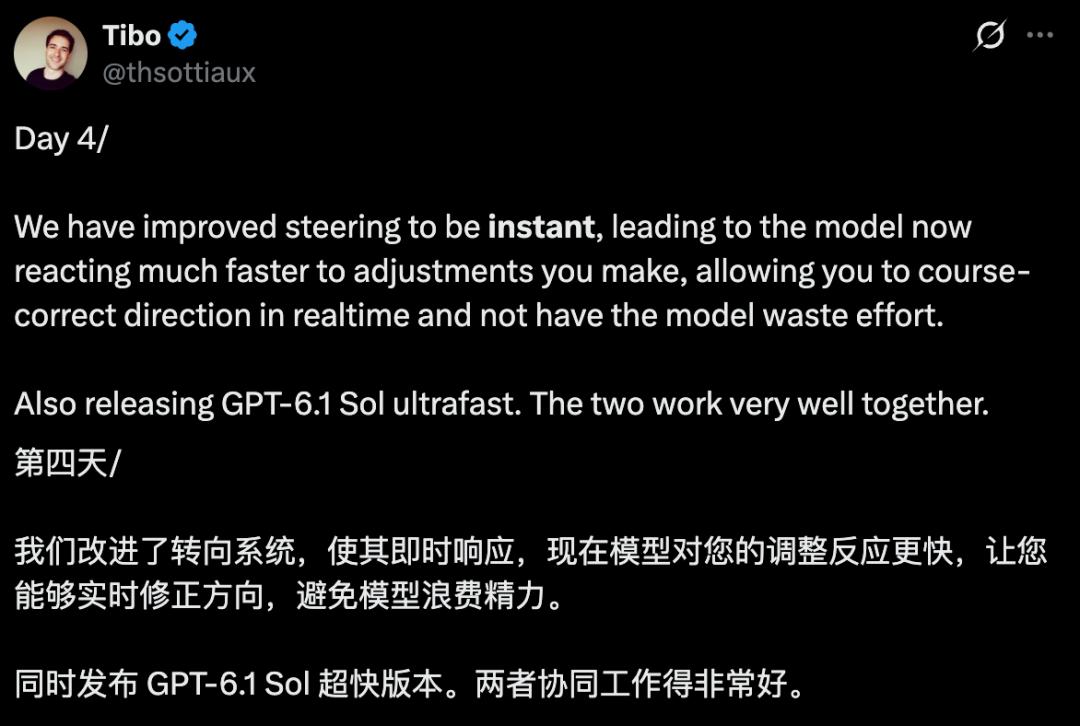
Gestern hat OpenAI beschlossen, GPT-6 für alle Nutzer (einschließlich kostenfreier und zahlender Nutzer) freizugeben, und heute wird direkt das brandneue Modell die Ultrafast-Version von GPT-6.1 Sol vorgestellt! In Kombination mit dem aktualisierten Modellsteuerungssystem kann es umgehend auf Anpassungen der Nutzeranweisungen reagieren.
Turboaufladung
GPT-6.1 Sol selbst wurde gerade am 29. September auf der DevDay vorgestellt, mit der Positionierung „Leistung nahe Astra, zu einem Fünftel des Preises“. Die Preisgestaltung der Standard-API beträgt 2 US-Dollar pro Million Eingabe-Token und 10 US-Dollar pro Million Ausgabe-Token, was es bereits zu einem der kostengünstigsten hochmodernen Modelle auf dem Markt macht.
Im Ultrafast-Modus steigt die Geschwindigkeit direkt auf das 8-fache des Standardwerts.
OpenAI bezeichnet es als „Near-Astra intelligence at up to 8x faster speeds than Sol Standard“. Das bedeutet: Das Intelligenzniveau stimmt mit der Standardversion überein, nähert sich nach wie vor dem Flaggschiff Astra an, die Geschwindigkeit ist aber um das 8-fache gestiegen.
Dies ist auch die zweite Iteration von OpenAI zum Konzept „Ultrafast“. Anfang dieses Jahres haben sie in Zusammenarbeit mit Cerebras eine Ultrafast-Vorschauversion von GPT-5.6 Sol vorgestellt, die damals eine Ausgabegeschwindigkeit von bis zu 750 Token/s versprach, also das 14-fache der Standardgeschwindigkeit. Die 8-fache Geschwindigkeitssteigerung von GPT-6.1 Sol Ultrafast wirkt etwas konservativer, aber da das Intelligenzniveau von 6.1 Sol selbst 5.6 Sol weit übertrifft, ist der Wertgewinn bei einer 8-fachen Beschleunigung auf einer höheren Leistungsbasis tatsächlich noch höher.
Die Bedeutung dieser Geschwindigkeit für Entwicklungsszenarien steht außer Frage. Die typischen Anwendungsfälle, die OpenAI nennt, umfassen die Online-Fehlerbehebung, Echtzeit-Navigationsanwendungen für Agenten sowie alle Echtzeit-Interaktionsszenarien, bei denen „jede Sekunde Geld kostet“.
Bei der API-Preisgestaltung gilt: Im Ultrafast-Modus kostet eine Million Eingabe-Token 12 US-Dollar und eine Million Ausgabe-Token 60 US-Dollar, genau das Sechsfache des Standardpreises.
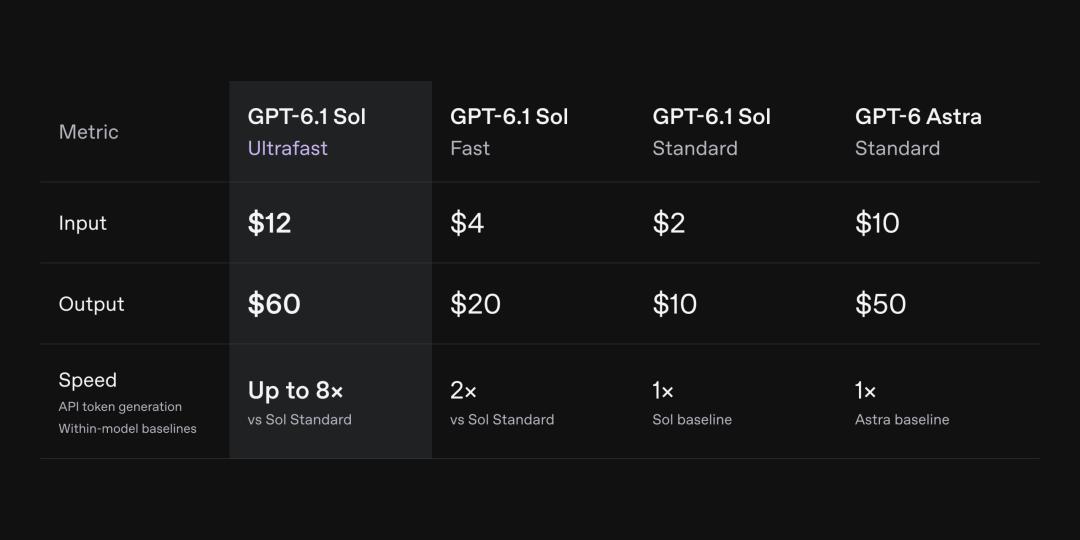
Dominik Kundel, Entwicklerbeziehungsingenieur bei OpenAI, hat eine intuitivere Positionierung gegeben: „Intelligenz nahe Astra-Niveau, 8-fache Geschwindigkeit von Sol, Kosten nur das 1,2-fache von Astra.“
Verglichen mit dem Standard-API-Preis von Astra (10 US-Dollar pro Million Eingabe-Token, 50 US-Dollar pro Million Ausgabe-Token) ist Ultrafast tatsächlich nur geringfügig teurer, bietet aber eine weit höhere Reaktionsgeschwindigkeit als Astra. Wenn die Geschwindigkeit von Astra in Ihrem Geschäftsszenario nicht ausreicht, bietet Ultrafast die Option „etwas mehr zu zahlen, um eine deutliche Geschwindigkeitssteigerung zu erhalten“.
Die Leistungsparameter von Ultrafast sind verlockend, aber eine wichtige Information ist fast in der Ankündigung untergegangen.
Auf Seiten von Codex und ChatGPT Work ist Ultrafast nur für Pro 500-Abonnenten, berechtigte Enterprise-Nutzer mit nutzungsbasierter Bezahlung und Edu-Nutzer freigegeben.
Pro 500 ist das hochwertige Abonnementprogramm von OpenAI mit einer monatlichen Gebühr von 500 US-Dollar, das dieses Jahr eingeführt wurde. Das bedeutet, dass normale ChatGPT Plus-Nutzer (20 US-Dollar pro Monat) oder sogar Pro-Nutzer (200 US-Dollar pro Monat) zusätzlich zahlen müssen, um Ultrafast in ChatGPT oder Codex nutzen zu können. Dies hat zu Unzufriedenheit unter den Nutzern geführt.
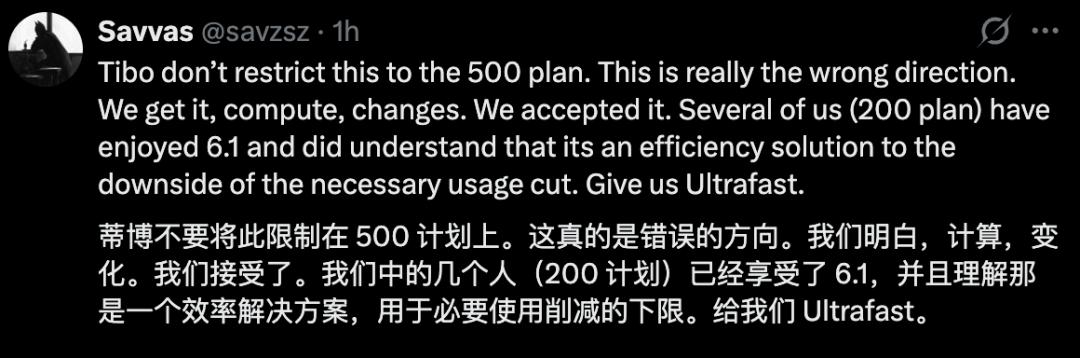
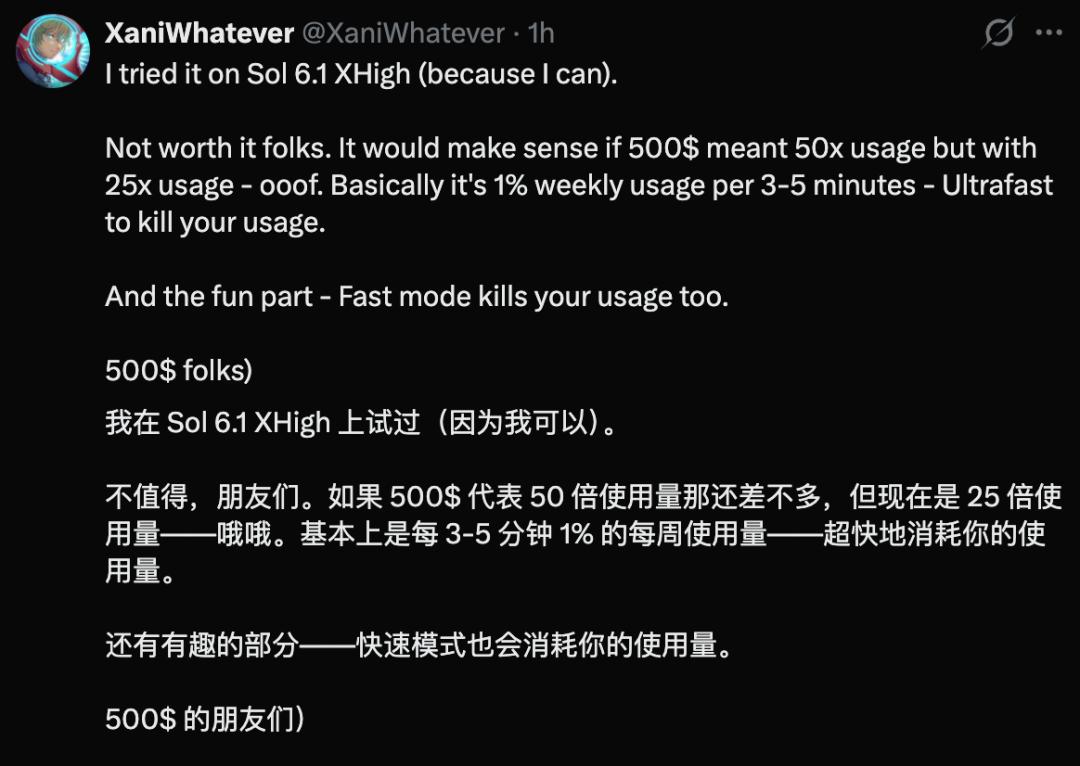
Ein Entwickler hat nach dem Testen angegeben, dass Ultrafast im XHigh-Effort-Modus tatsächlich erstaunlich schnell ist, aber auch der Token-Verbrauch ist gleichermaßen hoch: Das 25-fache Nutzungslimit, das der monatlichen Gebühr von 500 US-Dollar entspricht, kann in diesem Modus „innerhalb weniger Minuten zu 1 % verbraucht werden“. Andere haben die Logik der Beschränkung selbst in Frage gestellt: „Wenn Ultrafast mein Nutzungslimit schneller verbraucht, warum lassen Sie nicht alle zahlenden Nutzer selbst wählen? Ich bin bereit, den Nachteil zu tragen, dass das Limit schneller aufgebraucht wird.“
Natürlich ist die API-Seite nicht durch Abonnementstufen beschränkt: Entwickler können direkt das Modell gpt-6.1-sol aufrufen und den Ultrafast-Modus aktivieren, wobei die Bezahlung nach Nutzung erfolgt. Für Teams, die Agenten aufbauen und Echtzeitanwendungen entwickeln, ist die Hürde nicht hoch.
Der unmittelbare Wert von GPT-6.1 Sol Ultrafast liegt darin, dass es auf API-Ebene eine Kombination aus „nahe Flaggschiff-Intelligenz + extremer Geschwindigkeit“ bietet, ohne auf eine Preissenkung von Astra warten zu müssen. Für normale Nutzer ist die Verbesserung des Nutzungserlebnisses durch sofortige Reaktionen vielleicht noch direkter, schließlich mag niemand zusehen, wie das Modell in die falsche Richtung läuft.
Was wird Tag 5 bringen? Wir sehen uns morgen.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Machine Heart“, Autor: Machine Heart, Redakteur: Leng Mao, veröffentlicht mit Genehmigung von 36Kr.