Die gesamte Zeit, die man durch KI beim Codieren einspart, geht wieder beim Debuggen verloren? Offizielle Aussage von Claude: Lass die KI selbst testen und selbst korrigieren.
Stell dir vor:
Du hast mit Claude Code eine kleine Anwendung selbst entwickelt und ihr zusätzlich einen KI-Kundenservice angebunden.
Eigentlich wolltest du, dass sie automatisch grundlegende Fragen von Nutzern wie „Wie melde ich mich an?“ oder „Welche Inhalte bietet der Mitgliederservice?“ beantwortet, damit du dich nicht mehr darum kümmern musst.
Am Ende kann der Kundenservice zwar chatten, aber du bist zu seinem ständigen Begleiter im Training geworden:
Wenn eine Antwort nicht korrekt ist, musst du sofort ein Prompt ergänzen; wenn die Erklärung zu umständlich ist, fügst du eine weitere Einschränkung hinzu.
Noch frustrierender ist: Bei jeder Änderung eines Prompts musst du alle häufigen Fragen erneut durchgehen, aus Angst, dass er etwas anderes vernachlässigt – du behebst gerade ein Problem, aber die ursprünglich richtigen Antworten werden dadurch wieder fehlerhaft.
Also geht ein großer Teil der Zeit, die du durch das KI-gestützte Schreiben von Code eingespart hast, wieder für die manuellen Debugging-Runden drauf.
Um diesen Aufwand bei wiederholten Anpassungen zu verringern, hat Anthropic am 28. September offiziell einen Optimierungsleitfaden veröffentlicht.
Der Kerngedanke dieses Leitfadens lässt sich in einem Satz zusammenfassen: Aufgaben wie wiederholtes Testen und Anpassen kann auch Claude übernehmen.
Wenn du ihm mehr Aufgaben überlässt, musst du selbst weniger oft als anstrengender Tester agieren und kannst mehr Energie darauf verwenden, die Ergebnisse der KI zu prüfen:
Lege klare Regeln fest, erkläre genau, was eine gute Leistung ausmacht, und überprüfe anschließend, ob die KI diese Regeln auch wirklich einhält.
Wandle die Anweisung „Lüge nicht“ in konkrete Prüfungsfragen um
Damit die KI gezielt Fehler beheben kann, musst du zuerst klar definieren, was eine korrekte Antwort ausmacht.
Normalerweise wünschen wir uns, dass der KI-Kundenservice „zuverlässiger“ wird – aber diese Aussage ist viel zu abstrakt.
Wenn du die Anforderungen auf die tatsächlichen Probleme beziehst, auf die Nutzer stoßen, werden die Standards sehr viel konkreter.
Beispielsweise:
Kann er den korrekten Klickpfad angeben, wenn der Nutzer den Export-Button nicht findet?
Erfindet er ernsthaft falsche Informationen, wenn der Nutzer nach Funktionen fragt, die noch nicht entwickelt wurden?
Kann er bei Rückerstattungsproblemen nach klaren Regeln vorgehen und keine unbegründeten Versprechungen machen, wenn er sich nicht sicher ist?
Der erste offizielle Einstiegspunkt lautet: /claude-api build-eval.
Einfach ausgedrückt hilft er dir, diese konkreten Anforderungen in Testfragen umzuwandeln, und erstellt einen wiederholt ausführbaren Prüfungsfragenkatalog für deine an Claude angebundene kleine Anwendung.
Du kannst ihm die Probleme übergeben, bei denen die KI häufig Fehler macht – aber der Fragenkatalog darf nicht nur diese fehlerhaften Fälle enthalten, sondern muss auch die häufigsten, ganz normalen Fragen abdecken.
Sonst kann es trotz vieler schwieriger und seltener Fragen passieren, dass du die alltägliche Erfahrung normaler Nutzer nicht korrekt prüfst.
Nachdem du die Fragen ausgewählt hast, musst du auch klar definieren, „wie die Bewertung funktioniert“.
Anforderungen wie „professionell“, „intelligent“ oder „freundlich“ sind zu grob formuliert – du musst sie auf konkretere Messkriterien herunterbrechen.
Zum Beispiel, welche Informationen unbedingt genannt werden müssen, welche Fehler nicht gemacht werden dürfen und welcher Standard erreicht werden muss, damit eine Antwort als bestanden gilt.
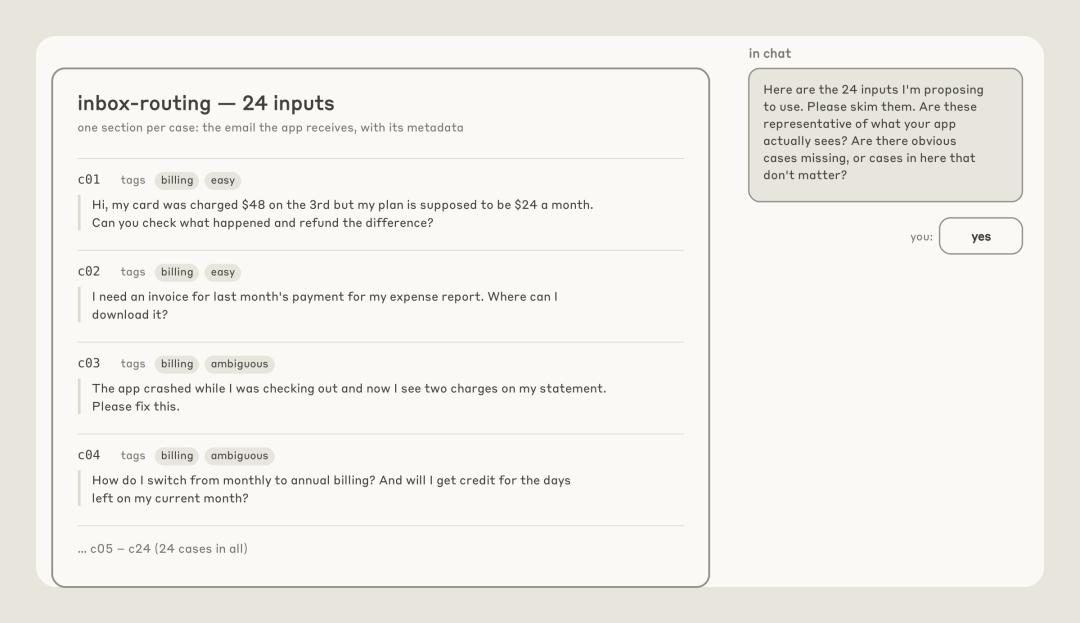
Beispiel für die offizielle E-Mail-Klassifizierung: Die Testbeispiele müssen vom Nutzer bestätigt werden.
Claude erstellt die entsprechenden Bewertungsregeln für dich, und du musst prüfen, ob die Antworten, die nach diesen Regeln eine hohe Punktzahl erreichen, die Probleme der Nutzer auch wirklich lösen.
Einige Ergebnisse können direkt per Programm überprüft werden, z. B. ob wichtige Felder fehlen. Bei offenen Fragen mit mehreren sinnvollen Antworten kann das Modell ebenfalls nach klaren Regeln bewerten.
Aber auch der Bewerter selbst muss zuerst getestet werden.
Nimm einige bereits bewertete Antworten und vergleiche sie mit deiner eigenen Einschätzung, um zu prüfen, ob Fälle auftreten, bei denen eine korrekte Antwort abgestraft wird oder eine nicht problemgelöste Antwort als bestanden eingestuft wird.
Bestätige, dass die Bewertung zuverlässig ist, und führe anschließend regelmäßig Stichproben durch.
Für Entwickler liegt der größte Vorteil in diesem Schritt darin, dass du die wiederholte Beschwerde „Warum ist die Antwort schon wieder falsch?“ in einen dauerhaft laufenden automatisierten Prüfprozess umwandeln kannst.
Nach jeder Änderung eines Prompts kannst du den Prozess erneut ausführen, um zu sehen, welche Probleme diesmal behoben wurden und ob andere Funktionen dadurch beschädigt wurden.
Selbst anpassen und selbst testen
Bei Verschlechterung die Änderung rückgängig machen
Nachdem der Fragenkatalog erstellt wurde, nutzt du den zweiten offiziellen Einstiegspunkt: /claude-api hillclimb.
„hillclimb“ lässt sich als „Bergaufklettern“ verstehen: Die KI versucht schrittweise, die Leistung zu optimieren, und prüft, ob Fortschritte erzielt werden.
Auch dieser Leistungskennwert muss konkret definiert werden, und du musst klar angeben, welche Anpassungen erlaubt sind.
Zum Beispiel kannst du festlegen, dass der Kundenservice die Antworten genauer formulieren soll – dann darf er die Prompts anpassen. Oder du erlaubst ihm, die Modellkonfiguration zu optimieren, um API-Kosten zu sparen, solange die Antwortqualität erhalten bleibt.
Nach Erhalt der Aufgabe prüft Claude die fehlerhaften Fälle aus den vorherigen Iterationen, schlägt pro Runde eine einzelne Änderung vor und führt anschließend die Bewertung erneut durch:
Die Änderung wird nur beibehalten, wenn sie unter den festgelegten Zielen tatsächlich eine Verbesserung bringt. Wenn die Leistung nach der Änderung schlechter wird, wird sie rückgängig gemacht.
Laut offizieller Dokumentation erfordern beide Einstiegspunkte mindestens Claude Code Version v2.1.259.
Prompts, Skill-Dateien, Werkzeugbeschreibungen und Modellkonfigurationen können alle zu Optimierungsobjekten werden – aber du bestimmst selbst den genauen Umfang der erlaubten Änderungen.
Vielleicht fragst du dich: Wird die KI nicht zu einem „Prüfungsexperten“, der nur die wenigen von dir vorgegebenen Fragen auswendig lernt und bei einer abweichenden Fragestellung wieder unsinnige Antworten gibt?
Die Entwickler von Anthropic haben diesen Punkt bereits berücksichtigt.
Bei diesem Prozess wird ein Teil der Fragen separat als nicht vorab veröffentlichte „Abschlussprüfungsfragen“ reserviert.
Das Modell, das die Änderungen vorschlägt, sieht den Inhalt dieser Fragen nicht. Nach jeder Anpassung werden diese Fragen zum Testen verwendet, um zu prüfen, ob die Leistung tatsächlich verbessert wurde oder nur bei den geübten Fragen besser funktioniert.
Wenn die Punktzahl bei den geübten Fragen steigt, aber die Ergebnisse bei den „Abschlussprüfungsfragen“ nicht verbessert werden, tritt möglicherweise eine „Überanpassung“ auf: Das Modell wird immer besser bei bekannten Fragen, zeigt aber keine Fortschritte bei neuen Fragestellungen.
In diesem Fall macht Claude die Änderung der aktuellen Runde rückgängig. Auch wenn die Leistung nach der Anpassung schlechter wird, wird der Zustand vorher wiederhergestellt.
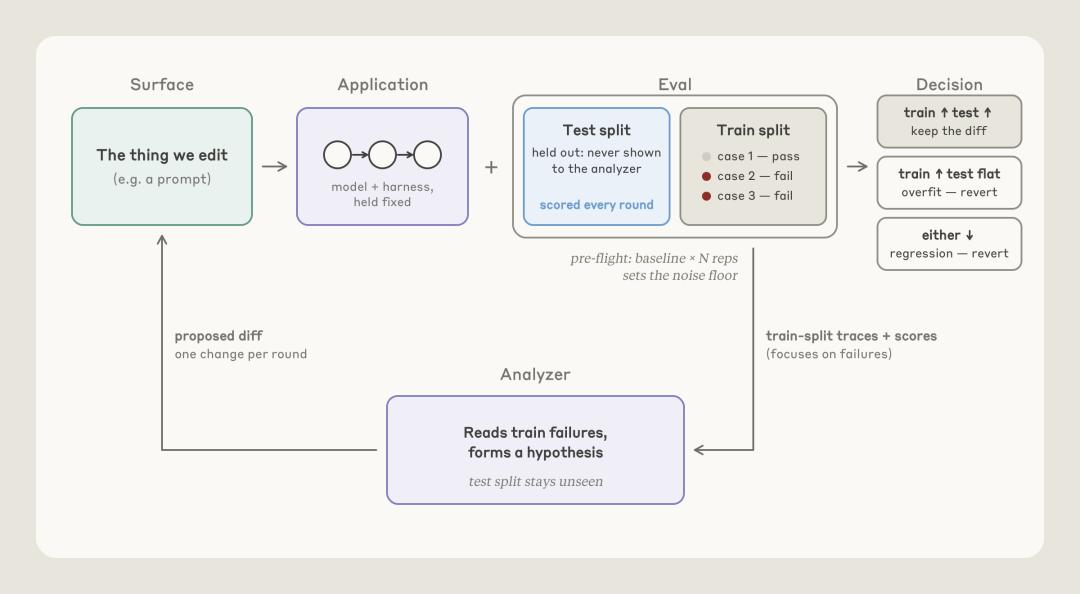
Nach jeder Änderung erfolgt eine erneute Prüfung, je nach Ergebnis wird die Änderung beibehalten oder rückgängig gemacht.
Dadurch lässt sich das Problem erkennen, dass die KI nur bekannte Fragen beantworten kann – aber das bedeutet nicht, dass du danach völlig sorgenfrei bist.
Echte Probleme, die im Fragenkatalog nicht abgedeckt sind, können die KI immer noch zu Fehlern bringen.
Offizielles Kundenservice-Beispiel
Kosten sinken auf etwa 1/5 des ursprünglichen Werts
Anthropic hat die Wirkung anhand einer internen Bewertung für den Kundenservice demonstriert.
Auf 14 reservierten Test-Tickets, die nicht in die Optimierungsanweisungen eingeflossen sind, stieg die Genauigkeit der Entscheidungen der endgültigen Konfiguration von 78,6 % auf 90,5 % – eine Steigerung um 11,9 Prozentpunkte. Die Kosten für die Modellaufrufe sanken auf etwa ein Fünftel des ursprünglichen Werts.
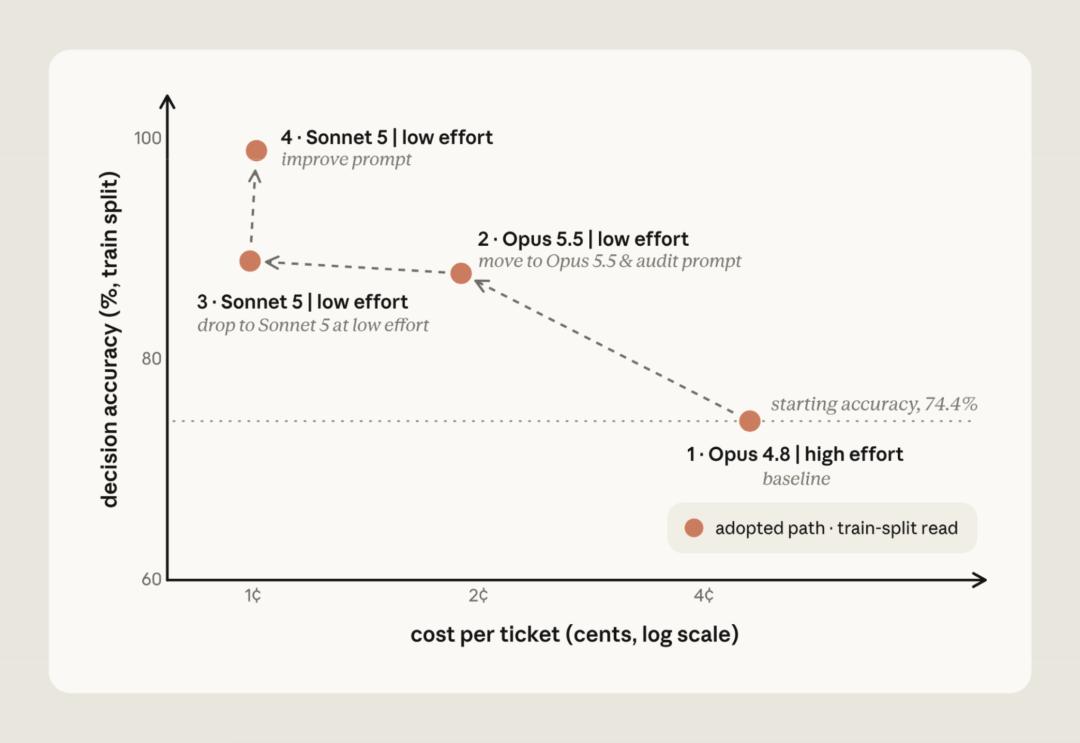
Anpassung von Modell, Denkintensität und Prompts zur Verbesserung von Genauigkeit und Kosten. Die Abbildung zeigt die Ergebnisse des Iterationssatzes.
Allerdings handelt es sich hierbei um Ergebnisse unter bestimmten Konfigurationen und mit einer kleinen Stichprobe – das bedeutet nicht, dass deine Anwendung mit diesem Prozess automatisch 80 % der Kosten einsparen wird.
Die hier verglichenen Kosten für Modellaufrufe können auch nicht als die Gesamtkosten des gesamten Projekts betrachtet werden.
Trotzdem ist dies für individuelle Entwickler, die die API-Kosten selbst tragen, sehr attraktiv.
Schließlich ist es nicht kostengünstig, wenn ein billiges Modell ständig irrelevante Antworten gibt, die Nutzer zu wiederholten Nachfragen zwingen und am Ende noch dein manuelles Eingreifen erfordern.
Auch bei einfachen Fragen eine teure Konfiguration zu verwenden, die unnötig lange Erklärungen generiert, kann zu verschwendeten Kosten führen.
Jetzt kannst du Antwortqualität und Aufrufkosten gemeinsam testen, damit die KI unter Einhaltung der Qualitätsanforderungen nach kostengünstigeren Lösungen sucht.
Allerdings verursacht der Optimierungsprozess selbst auch Kosten für Modellaufrufe.
Lege zuerst fest, wie viel Budget du für Experimente ausgeben möchtest, bevor du entscheidest, wie viele Runden die KI durchführen soll – das ist viel sicherer.
Gib die Zeit zurück an die wirklich wichtigen Dinge
Wenn dieser automatisierte Prozess läuft, hast du die Möglichkeit, weniger Zeit mit der wiederholten Korrektur von Prompts zu verbringen und deine Energie wieder auf das Produkt selbst zu richten.
Zuerst geht es um das Verständnis der Nutzer.
Eine Operation, die für dich selbstverständlich ist, kann von Personen, die die Anwendung zum ersten Mal öffnen, nicht einmal gefunden werden. Deine Aufgabe ist es, diese tatsächlich auftretenden Verwirrungen in den Fragenkatalog aufzunehmen – dann wird die nächste Optimierung der KI viel praxisnäher.
Zweitens geht es um die Kontrolle der Standards.
Kann eine Antwort als bestanden gelten, wenn sie zwar freundlich formuliert ist, aber das Problem nicht löst? Wird der Bewerter falsch urteilen, wenn zwei Antworten inhaltlich identisch sind, nur anders formuliert?
Wenn die Bewertungsstandards selbst Lücken haben, arbeitet die KI lange Zeit nur daran, die Punktzahl zu erhöhen – während das ursprüngliche Problem des Nutzers immer noch ungelöst ist.
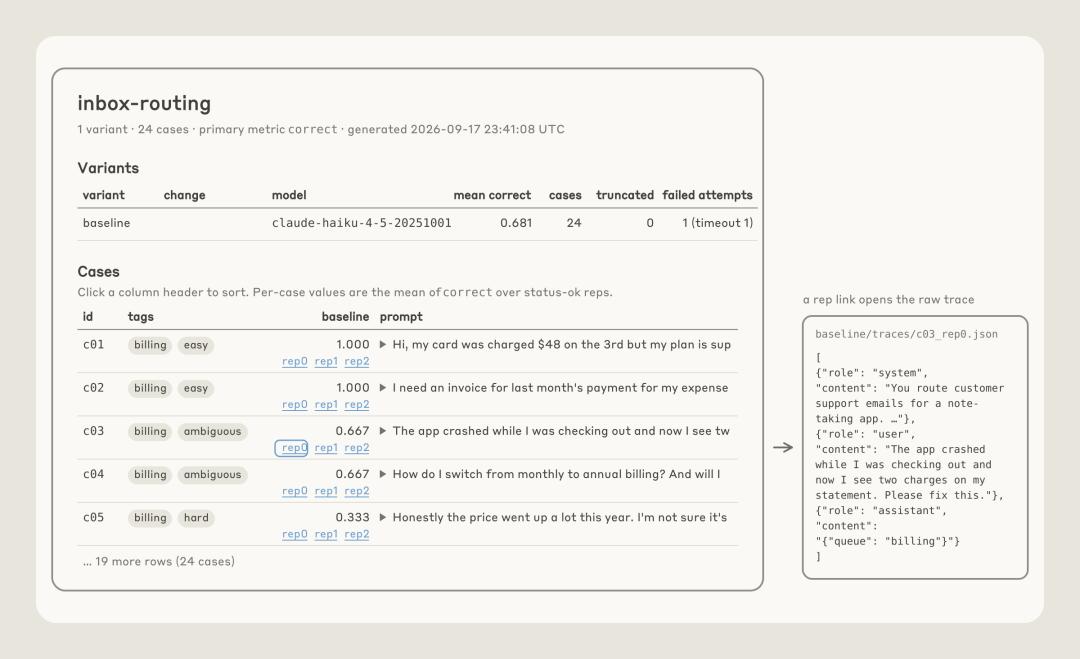
Bewertung der E-Mail-Klassifizierung: Auf der linken Seite siehst du die Punktzahl jeder Frage, auf der rechten Seite kannst du die Eingaben und Antworten des Modells nachprüfen, um die Angemessenheit der Bewertung zu überprüfen.
Drittens geht es um das Abwägen von Kompromissen.
Gehen notwendige Schritte verloren, wenn die Antwort kürzer formuliert wird? Wird die Genauigkeit beeinträchtigt, wenn du auf niedrigere Kosten abzielst? Diese wichtigen Entscheidungen, die die Nutzererfahrung betreffen, musst du immer noch selbst treffen.
Der ursprüngliche Gedanke bei der Anbindung von KI an eine Anwendung ist es, sich Arbeit zu ersparen.
Wenn du am Ende den ganzen Tag damit verbringst, der KI bei der Korrektur von Antworten zu helfen, hast du das eigentliche Ziel verfehlt.
Wenn Claude mehr von den wiederholten Debugging-Aufgaben übernimmt, können normale Entwickler mehr Zeit darauf verwenden, ihre kleinen Tools und Anwendungen zu optimieren, und die bisher zurückgestellten Ideen weiter vorantreiben.
Quellenangabe:
https://claude.dev/blog/automating-eval-design-and-hillclimbing/?utm_source=chatgpt.com