Fei-Fei Lis Team hat ein Welt-Aktionsmodell entwickelt: Mit einem ausgetauschten Unterbau steigt die Erfolgsrate der Roboter direkt sprunghaft an.
Am 22. September veröffentlichte Black Forest Labs, das für sein FLUX-Bildmodell bekannt ist, überraschenderweise das quelloffene 7B-Weltaktionsmodell FLUX 3 Action. Laut seinem offiziellen Blog übertrifft dieses Modell das bisher leistungsstärkste quelloffene Modell Cosmos 3 Nano auf der Nvidia-RoboLab-120-Bestenliste, verfügt aber über weniger als die Hälfte der Parameterzahl. Dass ein Unternehmen, das sich mit Bildgenerierung befasst, plötzlich in den Bereich der Robotersteuerung einsteigt, zeigt, dass die durch Videomodelle angesammelte „physikalische Intuition“ zunehmend von mehr Teams als Grundgerüst für das Gehirn von Robotern verwendet wird.
Dieser Ansatz ist das sogenannte Weltaktionsmodell (World-Action Model, WAM). Seit Nvidia diesen Begriff im Februar dieses Jahres in der DreamZero-Arbeit explizit vorgestellt hat, sind zahlreiche entsprechende Forschungsarbeiten schnell erschienen. Aber hinter dem Hype verbirgt sich ein peinliches Problem: Fast alle diese Systeme haben gleichzeitig das Videobackbone, die Trainingsdaten, die Interaktionsweise zwischen Video und Aktion sowie den Inferenzablauf ausgetauscht, sodass niemand klar sagen kann, welches Design die Leistungssteigerung tatsächlich herbeigeführt hat.
Diese Woche veröffentlichte das Team um Li Fei-Fei, Wu Jiajun und Ehsan Adeli von der Stanford University eine Forschungsarbeit, die das offene Rahmenwerk für die Weltaktionsmodellierung OpenWAM vorstellt, um eine systematische Antwort auf dieses Problem zu liefern.
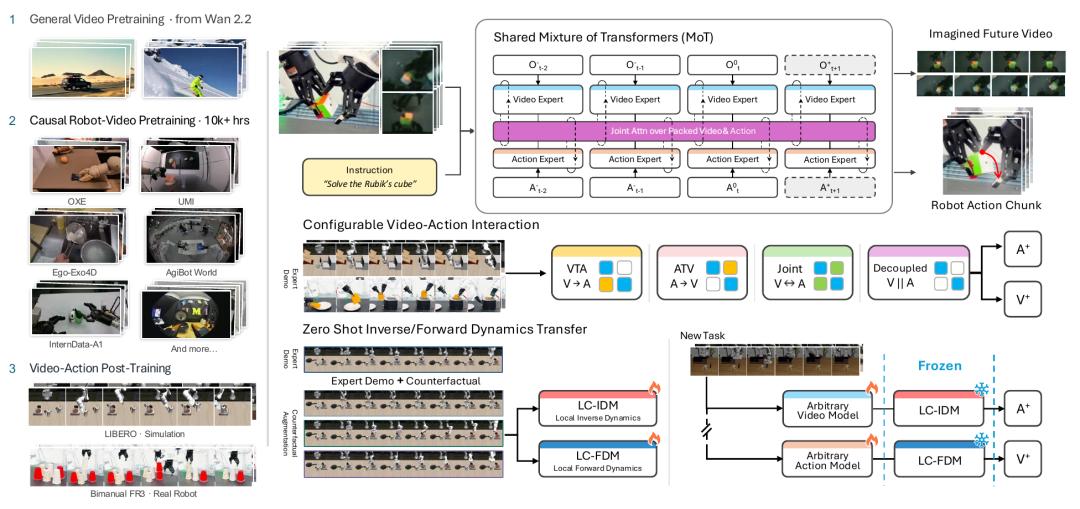
Überblick über das OpenWAM-Rahmenwerk: dreistufiges Training, gemeinsame MoT-Architektur, vier konfigurierbare Interaktionsweisen und ein lokales dynamisches Modell, das eingefroren und wiederverwendet werden kann.
- Titel der Arbeit: OpenWAM: An Open Framework for Composable World-Action Models
- Adresse der Arbeit: https://arxiv.org/abs/2610.07922
- Projekt-Homepage: https://openwam.stanford.edu
- Code-Repository: https://github.com/OpenWAM/OpenWAM
Warum braucht man eine „einheitliche Prüfungsvorlage“
Herkömmliche Visuell-Sprach-Aktions-Modelle (VLA) ähneln einem Fahrer, der durch Reflexe fährt: Sie sehen das Bild, hören die Anweisung und geben direkt die entsprechende Aktion aus.
WAM führt einen zusätzlichen Schritt der „Vorhersage im Kopf“ ein: Es sagt gleichzeitig voraus, wie das Bild in den nächsten Sekunden aussehen wird und wie man sich dafür bewegen muss. Videos erfassen auf natürliche Weise, wie Objekte herunterfallen, kollidieren und geschoben werden, sodass Modelle, die mit riesigen Videomengen vortrainiert wurden, von vornherein über physikalische Vorwissen verfügen.
Das Problem liegt darin, dass es viele verschiedene Kopplungsarten zwischen „Bild vorhersagen“ und „Aktion generieren“ gibt: Zuerst vorstellen dann handeln, zuerst handeln dann die Folgen vorstellen, beide gleichzeitig generieren oder getrennt berechnen. Jeder Anbieter wählt andere Ansätze, Grundgerüste und Daten. Wenn man sie miteinander vergleicht, ist es wie mehrere Köche, die gleichzeitig Zutaten, Kochgeräte und die Reihenfolge des Garens austauschen – es ist schwer zu beurteilen, welcher Schritt für den guten Geschmack des Gerichts verantwortlich ist.
Das zweite Problem ist noch verborgener. Die meisten Trainingsdaten für Roboter bestehen aus erfolgreichen Demonstrationen, die dem Modell nur zeigen, „wie man den richtigen Weg geht“, und enthalten kaum Informationen darüber, „was passiert, wenn man die Hand zwei Zentimeter weiter ausstreckt“. Das ist vergleichbar mit einem Fahrschüler, der nur perfekte Videos des Fahrlehrers beim Slalomfahren gesehen hat: Er merkt sich die Route, versteht aber nicht, um wie viel das Fahrzeug abweicht, wenn man das Lenkrad um einen bestimmten Betrag dreht.
OpenWAM beantwortet das erste Problem mit einem gemeinsamen Grundgerüst und umschaltbaren Interaktionsweisen, das zweite Problem mit umfangreichen „kontrafaktischen“ Daten.
Dasselbe Grundgerüst, vier Varianten von „zuerst vorstellen oder zuerst handeln“
OpenWAM baut auf dem quelloffenen Videomodell Wan2.2-5B von Alibaba auf und wird zunächst mit etwa 3,34 Millionen Videos von Interaktionen zwischen Robotern und Menschen weiter vortrainiert, mit einer nominalen Gesamtdauer von etwa 14.600 Stunden. Der gesamte Prozess läuft ohne Aktionslabels ab und wurde auf 32 B200-Grafikkarten über 14 Tage trainiert.
Die entscheidende Änderung ist die Kausalisierung: Jeder Videoblock kann nur den aktuellen und vorherigen Inhalt sehen, nicht in die Zukunft blicken. Das ursprüngliche Modell war wie jemand, der das gesamte Drehbuch in der Hand hält und die Dialoge ständig ändert, während es jetzt wie eine Live-Übertragung ist, die zeitlich nacheinander abläuft – genau das, was Roboter für ihre schrittweise Ausführung von Aktionen benötigen.
Anschließend kombiniert das Team das 5B-Videoexperten-Modell und das 2B-Aktionsexperten-Modell mit der Mixture-of-Transformers (MoT)-Architektur. Beide behalten ihre eigene Normalisierungs-, Projektions- und Feedforward-Schicht bei und tauschen Informationen nur in einer gemeinsamen Aufmerksamkeitsschicht aus.
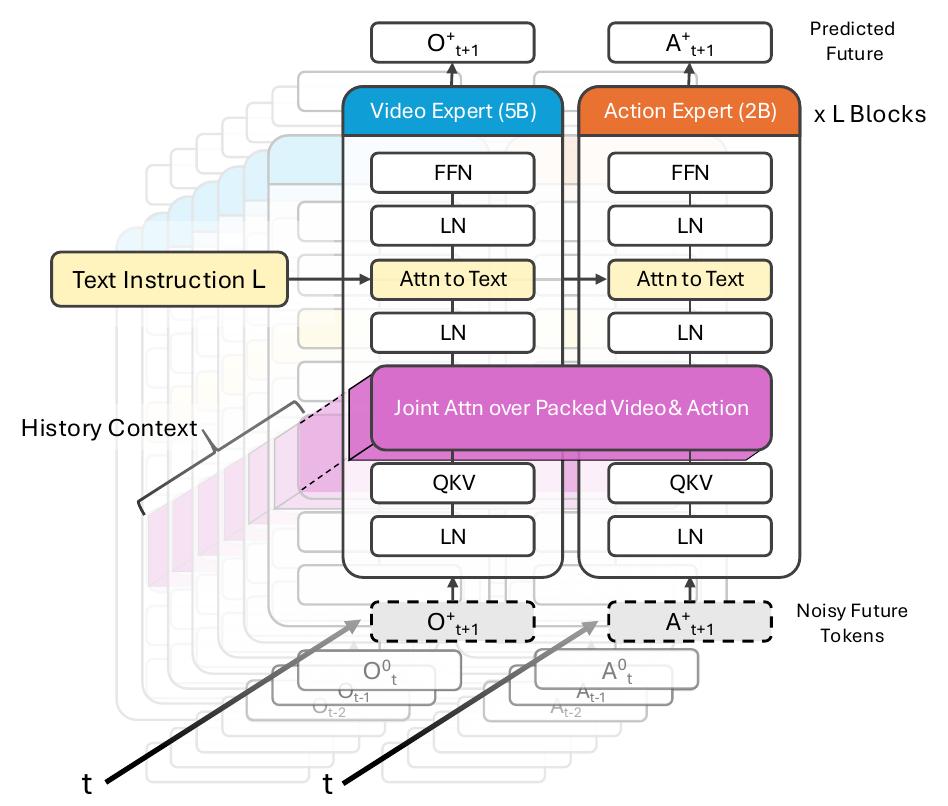
Gemeinsame MoT-Architektur: Videoexperte und Aktionsexperte führen gemeinsame Aufmerksamkeitsberechnungen auf den gepackten Tokens durch.
Auf diesem Grundgerüst definiert das Team vier „Interaktionsabläufe“:
- VTA stellt zuerst das Bild vor und generiert dann die Aktion
- ATV hat die umgekehrte Reihenfolge
- Joint lässt beide gleichzeitig generieren und sich gegenseitig als Referenz dienen
- Decoupled sorgt dafür, dass beide im zukünftigen Teil des Ablaufs keine Informationen voneinander sehen können
Das ist wie dieselbe Band, die dasselbe Stück spielt, bei dem sich nur ändert, wer zuerst anfängt zu spielen und ob die Musiker sich gegenseitig hören können. Alle vier Varianten nutzen dasselbe Grundgerüst, dieselbe Tokenisierung und dasselbe Flow-Matching-Ziel. Die einzige Variable ist die Generierungsreihenfolge und die crossmodale Aufmerksamkeit, sodass der Vergleich den Charakter eines „Kontrollvariablen-Experiments“ bekommt.
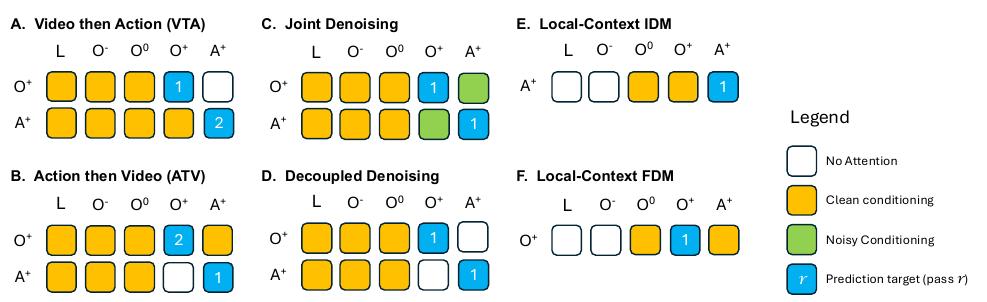
Aufmerksamkeitsmasken für vier Interaktionsabläufe (A–D) und zwei lokale dynamische Abläufe (E–F).
Den „Aktionsübersetzer“ herauslösen und separat trainieren
Der innovativere Teil der Arbeit besteht darin, das umgekehrte dynamische Modell (IDM) und das vorwärts gerichtete dynamische Modell (FDM) zu unabhängig trainierbaren Komponenten zu trennen.
IDM funktioniert wie ein Übersetzer: Es nimmt das aktuelle Bild, den Zustand des Roboters selbst und ein vorgestelltes zukünftiges Video als Eingabe und gibt die konkrete Aktion aus. FDM funktioniert umgekehrt und sagt voraus, wie sich das Bild entsprechend der Aktion verändern wird.
Der entscheidende Punkt ist der lokale Charakter: Beide erhalten keine Aufgabenanweisungen und keine älteren Verläufe, sie kümmern sich nur darum, „welche Aktion dieser kleine Bildänderung entspricht“. Daher sind sie nicht an bestimmte Aufgaben gebunden und können mit jedem kompatiblen Videovorhersager kombiniert werden: Das Videomodell bestimmt „was passieren soll“, während IDM dafür verantwortlich ist, „wie man das erreicht“.
Aber ein Übersetzer, der nur erfolgreiche Demonstrationen gelernt hat, hat einen zu begrenzten Erfahrungshorizont. Dafür hat das Team das LIBERO-Long-CF-Dataset erstellt: Es stellt den Zustand des Simulators aus den Demonstrationen wieder her und führt veränderte Aktionen aus, z. B. Anhalten, Umkehren, Hinzufügen von Rauschen oder Änderung des Öffnungs- und Schließzeitpunkts des Greifers. Insgesamt ergeben sich 32.000 Segmente mit etwa 4,1 Millionen Steueraufzeichnungen, das 29,7-fache der ursprünglichen Demonstrationen. 72,3 % der Segmente haben den Zustand der Platzierung von Objekten verändert. Viele Zweige können die Aufgabe überhaupt nicht abschließen, aber genau das ist der entscheidende Punkt. Zurück zum Vergleich mit der Fahrschule: Das entspricht dem Fahrlehrer, der den Fahrschüler auffordert, das Lenkrad absichtlich um eine halbe Umdrehung mehr zu drehen. Der Schüler merkt sich dann nicht nur die Route, sondern auch das Verhalten des Fahrzeugs selbst.
Experiment: Das Grundgerüst ist leistungsstark, der Übersetzer kann portiert werden
Auf den vier Teilmengen von LIBERO erreichen alle vier Interaktionsabläufe eine hohe Erfolgsrate. VTA erreicht im Durchschnitt 98,6 %, was leicht über den bereits berichteten Ergebnissen von LingBot-VA (98,5 %) und π0.5 (96,9 %) liegt, die in der Arbeit zitiert werden. Da LIBERO aber bereits nahe an der Sättigung ist, ist ein aufschlussreicheres Detail: Auf LIBERO-Long erreicht Decoupled, bei dem die zukünftigen Teile für beide Seiten unsichtbar sind, 97,0 %, was mit dem bidirektional interagierenden Joint (96,6 %) vergleichbar ist.
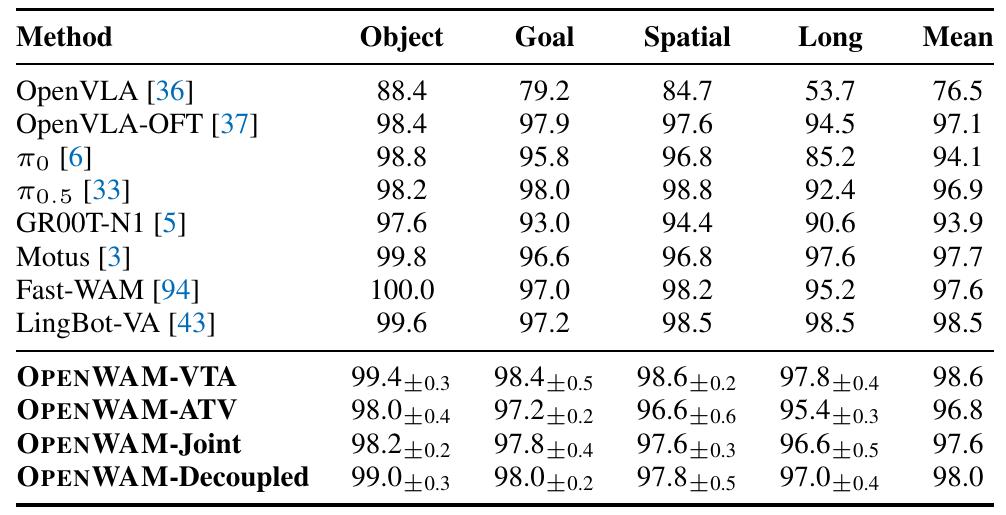
Erfolgsrate im geschlossenen Regelkreis (%) auf den vier LIBERO-Teilmengen, die Baseline sind bereits berichtete Ergebnisse.
An echten Robotern hat das Team mit zwei Franka-FR3-Roboterarmen drei Aufgaben getestet: Toasten von Brot, Wiederherstellung der letzten Schicht eines 2×2-Zauberwürfels und Sortieren von Bechern nach Farbe. Die durchschnittlichen Erfolgsraten von VTA und Joint betragen 92,1 % bzw. 91,9 %.
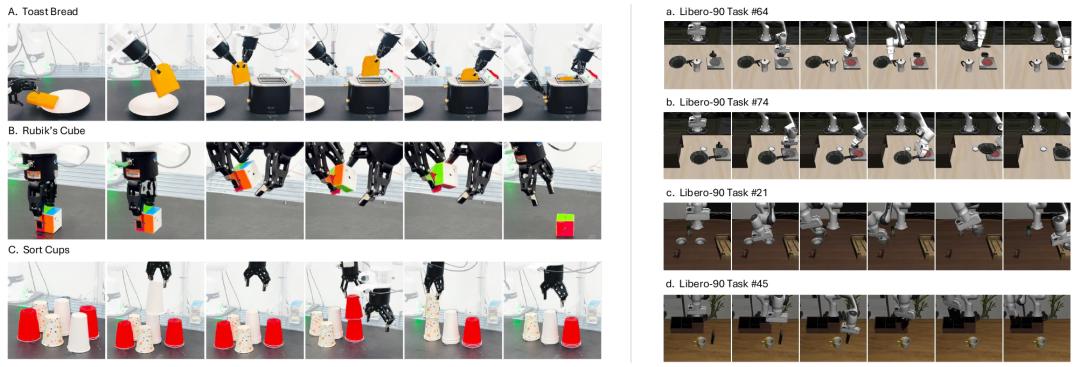
Links die drei echten zweiarmeigen Aufgaben, rechts die vier LIBERO-90-Aufgaben für die Portierung von Komponenten.
Ablationsstudien zeigen die Bedeutung des Grundgerüsts: Unter sonst gleichen Bedingungen erreicht VTA bei Initialisierung mit dem Original-Wan2.2 nur 68,4 % auf LIBERO-Long. Nach Austausch gegen das kausale Grundgerüst, das mit Robotervideos vortrainiert wurde, steigt der Wert auf 97,8 %, eine Steigerung um 29,4 Prozentpunkte. Die Autoren betonen, dass dies das gemeinsame Ergebnis von Daten und kausaler Umgestaltung ist.
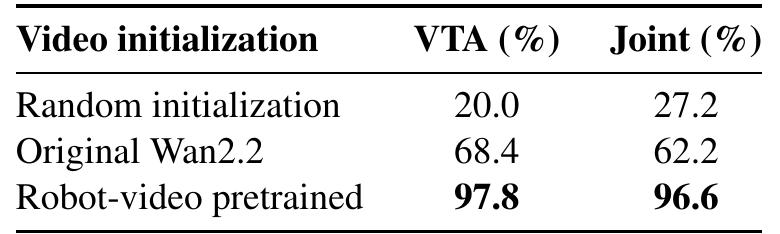
Einfluss der Initialisierungsmethode des Videobackbones auf die Erfolgsrate auf LIBERO-Long.
Der wichtigste Punkt ist das Experiment zur Portierung von Komponenten. Das Team friert das IDM ein, das auf LIBERO-Long trainiert wurde, und kombiniert es mit einem Videovorhersager, der für vier neue Aufgaben von LIBERO-90 angepasst wurde.
Das Ergebnis zeigt, dass das lokale IDM, das mit Demonstrationen und kontrafaktischen Daten trainiert wurde, eine durchschnittliche Erfolgsrate von 84,0 % erreicht. Dagegen erreicht das IDM, das den vollständigen Kontext erhält, nur 47,0 %, und das lokale IDM, das nur mit Demonstrationen trainiert wurde, erreicht sogar nur 21,5 %.
„Nur lokale Informationen betrachten“ und „genug verschiedene Folgen kennengelernt haben“ sind beide unverzichtbar. Nur ihre Kombination ergibt einen portierbaren Aktionsübersetzer. Es ist zu beachten, dass der Videovorhersager für die Zielaufgabe mit Demonstrationen mit Aktionslabels feinabgestimmt wurde. Dies ist kein Zero-Shot-Portierung, was die Autoren explizit anmerken.
