Der von Meta unterstützte Biohub führt den Aufbau der Dateninfrastruktur für die KI-gestützte Arzneimittelentwicklung an, und der Gesamtumfang ist auf 1,8 Milliarden US-Dollar angestiegen.
Nach dem Erfolg des persönlichen KI-Assistenten Muse hat die jüngste Expansion von Meta (META.US) im Biotechnologiebereich ebenfalls die Aufmerksamkeit des Marktes auf sich gezogen. Am 7. Oktober erweitert das von Meta unterstützte Biotechnologieinstitut Biohub eine „Virtual Biology Initiative“ mit einem Gesamtvolumen von etwa 1,8 Milliarden US-Dollar. Biohub gab zudem bekannt, dass das US-Energieministerium, die National Institutes of Health, Google DeepMind, Isomorphic Labs und Meta sich dieser Initiative anschließen werden. NVIDIA stellt die Recheninfrastruktur bereit. Zahlreiche Einrichtungen für Zell- und Genomforschung werden an der Datenerzeugung und der Festlegung von Standards teilnehmen.
Die 1,8 Milliarden US-Dollar stellen nicht vollständig neu hinzugekommenes Bargeld dar: Biohub steuert 500 Millionen US-Dollar bei; das US-Energieministerium (DOE) wird in den kommenden fünf Jahren mehr als 500 Millionen US-Dollar investieren; die National Institutes of Health (NIH) werden die Daten und wissenschaftlichen Einrichtungen koordinieren, die aus früheren bundesstaatlichen Investitionen von über 500 Millionen US-Dollar hervorgegangen sind; Google DeepMind, Isomorphic Labs und Meta steuern zusammen 300 Millionen US-Dollar bei.
Biohub wurde von dem Meta-Gründer Mark Zuckerberg und seiner Frau Priscilla Chan gegründet und unterstützt, es handelt sich um eine unabhängige gemeinnützige Forschungseinrichtung, die nicht zu Meta gehört. Dennoch ist Meta sowohl Investor als auch Quelle für einen Teil der KI-Technologien und des Personals von Biohub.
01
Biohub: Ziel ist die Erzeugung von Trainingsdaten für virtuelle Zellen
Ein zentrales Ziel von Biohub ist der Aufbau einer „virtuellen Zelle“, eines KI-Systems, das aus Genom-, Protein-, Bildgebungs- und Zellstörungsdaten lernt, um die Reaktion von Zellen auf Medikamente, Genbearbeitung oder Umweltveränderungen vorherzusagen. Forscher können Medikamente, Genbearbeitungen oder andere Lösungen zunächst im Modell testen, bevor sie Projekte auswählen, die es wert sind, im Labor umgesetzt zu werden.
Ziel der erweiterten „Virtual Biology Initiative“ ist es, das Datenproblem der KI-Biotechnologie zu lösen. Vorhandene biologische Daten sind in wissenschaftlichen Arbeiten, Versuchsaufzeichnungen und öffentlichen Datenbanken verteilt, weisen unterschiedliche Formate und Versuchsbedingungen auf, und fehlgeschlagene Ergebnisse werden nur selten veröffentlicht.
Biohub plant, im Rahmen dieser Initiative einheitliche Standards, Identifikatoren und Zugangspunkte zu schaffen und mehr Interventionsdaten zu erzeugen (Interventionsdaten erfassen die Reaktion von Zellen nach Exposition gegenüber Medikamenten, Genbearbeitung oder Umweltveränderungen).
Wie „Bright Company“ bereits früher erwähnt hat, sind solche Modelle derzeit durch Daten eingeschränkt. Biologische Daten sind in wissenschaftlichen Arbeiten, Versuchsaufzeichnungen und öffentlichen Datenbanken verteilt. Verschiedene Einrichtungen verwenden unterschiedliche Proben, Geräte und Aufzeichnungsverfahren. Öffentliche Daten bestehen hauptsächlich aus erfolgreichen Ergebnissen. Ergebnisse, bei denen es zu keiner Bindung oder fehlgeschlagenen Synthesen gekommen ist, gelangen nur selten in wissenschaftliche Arbeiten.
Für die KI-gestützte Entdeckung neuer Medikamente benötigen Modelle auch Daten zu fehlgeschlagenen Versuchen. Nur wenn das Modell genügend erfolgreiche und fehlgeschlagene Ergebnisse gesehen hat, kann es die Wirkung neuer Medikamente oder neuer Zielstrukturen vorhersagen. Darüber hinaus können fehlgeschlagene Ergebnisse erklären, warum ein bestimmtes Design nicht exprimiert werden kann, warum es zu unspezifischen Bindungen kommt oder warum es nur in bestimmten zellulären Umgebungen wirksam ist.
Im Rahmen der Initiative wird Biohub 400 Millionen US-Dollar für Kryo-Elektronentomographie, intravitale Mikroskopie und Bioingenieurwerkzeuge einsetzen, weitere 100 Millionen US-Dollar werden für externe Forschungsvorhaben bereitgestellt. Das kooperierende US-Energieministerium stellt Supercomputing-, Bildgebungseinrichtungen und automatisierte Labore zur Verfügung, während die NIH Krankheitsdaten und öffentliche Datenbanken bereitstellen.
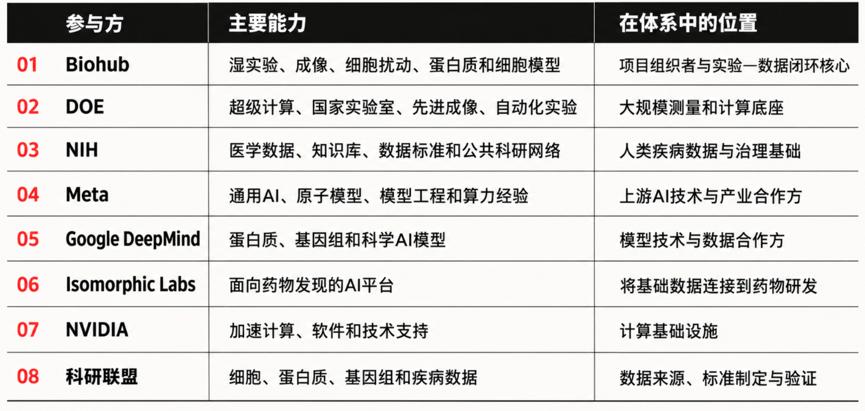
Dieser Ablauf ähnelt der Logik, nach der KI-Pharmaunternehmen Nasslabore aufbauen: Das Modell schlägt Lösungen vor, das Labor führt die Überprüfung durch, und die Ergebnisse werden für die nächste Trainingsrunde verwendet. Der Unterschied besteht darin, dass Biohub Daten und Werkzeuge als wissenschaftliche Infrastruktur für die Öffentlichkeit zugänglich machen möchte, anstatt sie nur für eine eigene Medikamentenpipeline zu nutzen.
02
Meta expandiert im Biotech-Bereich: Von Proteinmodellen bis hin zu Zelldaten
Meta ist schon früh über das FAIR-Labor in die rechnergestützte Biologie eingestiegen. FAIR hat das ESM-Proteinsprachmodell entwickelt. Der Leiter des ESM-Projekts, Alex Rives, gründete später EvolutionaryScale, dessen Team 2025 zu Biohub stieß, wo Rives als wissenschaftlicher Leiter von Biohub fungiert.
Im Mai 2026 veröffentlichte Biohub ESMC, ESMFold2 und ESM Atlas. ESM Atlas umfasst 6,8 Milliarden Proteinsequenzen und 1,1 Milliarden vorhergesagte Strukturen. Biohub nutzte ESMFold2 zudem, um Proteinbindungsmittel für mehrere Krebs- und Immunzielstrukturen zu entwickeln, wobei einige Designs bereits die Laborkontrolle bestanden haben.
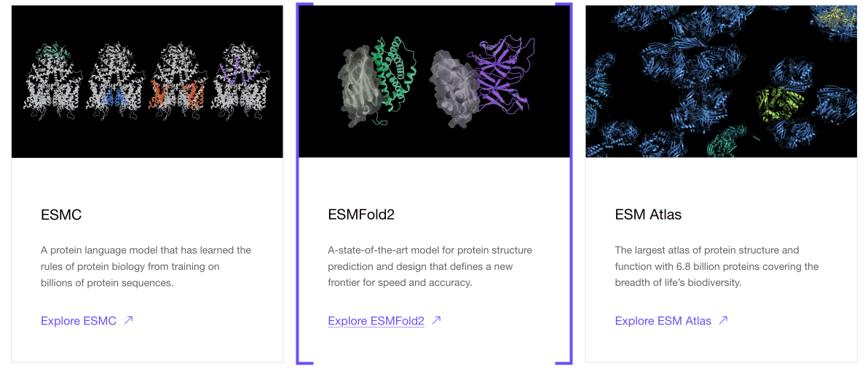
Quelle: Offizielle Website von Biohub
Meta selbst behält die Forschung auf Atom- und Molekülebene bei.
Im Jahr 2025 veröffentlichte Meta FAIR Open Molecules 2025 und das Universal Model for Atoms, um die Wechselwirkungen von Atomen in Molekülen und Materialien vorherzusagen. Nach der Teilnahme am Biohub-Plan deckt die öffentliche Expansion von Meta nun Proteinmodelle, Atommodele und Zelldateninfrastruktur ab.
Dennoch verfügt Meta derzeit über keine öffentliche Medikamentenklinikpipeline, seine Position ähnelt eher einem Anbieter von Modellen, Daten und Rechenleistung. Biohub ist für Experimente und Datenerzeugung zuständig, während nachgelagerte Pharma- und Biotechnologieunternehmen für die Kandidatenmedikamentenentwicklung und klinische Entwicklung verantwortlich sind.
„Bright Company“ bereits früher erwähnt hat, nähern sich auch OpenAI, Anthropic, Google und ByteDance dem experimentellen Bereich an.
OpenAI hat GPT-Rosalind auf den Markt gebracht und in Red Queen Bio, Chai Discovery und Valthos investiert; Anthropic hat ein molekularbiologisches Labor in der Bay Area aufgebaut; Google hat sich von AlphaFold zu Isomorphic Labs weiterentwickelt; ByteDance hat Anew Labs ausgegliedert und behält nach der Finanzierung die Mehrheitsbeteiligung.
Die Wege der verschiedenen Unternehmen sind unterschiedlich. Google nähert sich über Isomorphic Labs der Medikamentenpipeline; OpenAI setzt auf Modelle, Kooperationen und Investitionen; Anthropic baut direkt Nasslaborkapazitäten auf; ByteDance behält seine KI-Pharma-Vermögenswerte; Meta und Biohub konzentrieren sich stärker auf Daten und Basismodelle.
Die Signale, die diese Maßnahmen aussenden, sind, dass der Wettbewerb im Bereich der KI-gestützten Pharmazeutika von Modellen hin zur Datenerzeugung ausweitet. Modelle können den Suchbereich erweitern, aber Experimente nicht ersetzen. Wer fortlaufend Daten mit einheitlichem Format und einschließlich fehlgeschlagener Ergebnisse erhalten kann, hat größere Chancen, die Vorhersagefähigkeit des Modells für neue Zielstrukturen und neue Medikamente zu verbessern.
Biohub muss noch nachweisen, dass virtuelle Zellen unbekannte Medikamente, Patienten und Versuchsbedingungen vorhersagen können. Aus diesem Plan geht hervor, dass die Investitionen der KI-Giganten in die Biotechnologie bereits von einzelnen Modellen hin zu Daten-, Experimentier- und Recheninfrastrukturen übergehen.