Überseeische Open-Source-Modelle gewinnen wieder an Fahrt: Mistral und das "US-amerikanische DeepSeek" legen gleichzeitig ihre Karten offen
Das westliche Lager der Open-Source-Modelle beschleunigt sein Tempo.
Am 5. Oktober Ortszeit veröffentlichte das US-amerikanische Startup Reflection, das als „US-amerikanisches DeepSeek“ bezeichnet wird, sein erstes Open-Weight-Modell Beam; einen Tag später stellte das französische Unternehmen Mistral das bisher größte Modell Mistral Large 4 vor. Die Hauptvergleichsobjekte, die beide Unternehmen bei der Veröffentlichung ihrer Modelle ausgewählt haben, stimmen weitgehend überein: GLM, Kimi, DeepSeek und Qwen.
Daten von Hugging Face zeigen, dass chinesische Modelle im vergangenen Jahr etwa 41 % der Downloads von Modellen auf der Plattform ausmachten, und sowohl die monatlichen Downloads als auch die kumulierten Downloads übersteigen die der USA. Modelle wie DeepSeek, Alibaba Qwen, Moonshot Kimi, Zhipu GLM, MiniMax und Xiaomi MiMo haben nacheinander die Obergrenze der Fähigkeiten von Open-Source-Modellen neu definiert, und chinesische Open-Source-Modelle sind zu dem Ziel geworden, das globale Open-Source-Entwickler verfolgen.
Auf der anderen Seite sind Open-Source-Modelle nicht mehr nur eine „Nischenalternative“, die von Forschern und Geeks verwendet wird: Die Produktivverkehrsdaten von Vercel AI Gateway zeigen, dass Open-Weight-Modelle im August dieses Jahres bereits 56 % der Token auf ihrer Plattform verarbeitet haben, während dieser Anteil im Dezember letzten Jahres noch unter 10 % lag. Daher ist der globale Wettbewerb um Open-Source-Modelle unvermeidlich.
US-amerikanische und europäische Open-Source-Modelle werden zeitgleich vorgestellt
Das „US-amerikanische DeepSeek“ liefert erstmals sein Ergebnis ab: Es gibt noch Lücken
Das vielversprechende Unternehmen Reflection wurde 2024 gegründet, und seine beiden Gründer stammen von Google DeepMind: CEO Misha Laskin war für die Belohnungsmodellierung von Gemini verantwortlich, und CTO Ioannis Antonoglou war an der Entwicklung von AlphaGo und AlphaZero beteiligt und leitete später die Arbeit an der Verstärkenden Lernmethode mit menschlichem Feedback (RLHF) für Gemini.
Allerdings verfolgte Reflection anfangs nicht das Ziel, ein „US-amerikanisches DeepSeek“ zu werden. Das Unternehmen konzentrierte sich ursprünglich auf autonomes Programmieren und wollte mit Hilfe der Verstärkenden Lernmethode ein „Superintelligenz-System“ entwickeln, das komplexe Arbeiten selbstständig erledigen kann. Gleichzeitig ging man davon aus, dass im Westen ständig ausreichend leistungsstarke Open-Source-Modelle entstehen werden, auf denen Reflection direkt aufbauen kann.
Was den Kurs des Unternehmens grundlegend änderte, war DeepSeek V3. Nach Angaben der Gründer von Reflection hat das Unternehmen beschlossen, selbst fortschrittliche Open-Source-Modelle zu trainieren, nachdem sich chinesische Open-Source-Modelle rasant weiterentwickelt haben, während im Westen lange keine gleichwertigen Alternativen entstanden sind. Das Ziel wurde allmählich klar definiert: „Die Spitzenposition der Open-Source-Modelle zurück in den Westen zu bringen“.
Zwei Jahre später ist Beam das erste echte Ergebnis, das Reflection vorlegt.
Beam ist ein MoE-Modell mit einer Gesamtparameterzahl von 501 Milliarden, von denen 23 Milliarden Parameter pro Token aktiviert sind. Es richtet sich hauptsächlich an Programmier-, Inferenz- und Agent-Arbeitslasten. Das Modell wurde mit 23,8 Billionen Token vortrainiert. Reflection hat 10.500 Nvidia GB300-Grafikkarten eingesetzt, um vier Wochen lang kontinuierlich Verstärkendes Lernen mit hoher Rechenleistung durchzuführen und mehr als 100 Millionen Rollouts zu generieren. Das Modell befindet sich derzeit noch in der abschließenden Red-Team-Testphase. Reflection plant, die Modellgewichte, den technischen Bericht und die Entwicklungstools im Oktober öffentlich zugänglich zu machen.
Aus den von Reflection selbst veröffentlichten Testergebnissen geht hervor, dass das größte Highlight von Beam nicht die absolute Leistungsfähigkeit ist, sondern die Effizienz der Inferenz. Das Unternehmen gibt an, dass es bei einigen fortgeschrittenen Inferenzaufgaben mit etwa einem Viertel bis einem Drittel der Inferenzrechenleistung von GLM-5.2 eine nahezu vergleichbare Leistung erzielen kann.
Wenn man es jedoch mit der neuesten Generation chinesischer Modelle vergleicht, gibt es bei Beam noch deutliche Lücken, um wirklich gleichzuziehen.
Beispielsweise erreicht Beam im Agent-Programmiertest DeepSWE v1.1 einen Wert von 44,4, der fast dem Wert von GLM-5.2 (44,0) entspricht, liegt aber unter dem Wert von GLM-5.3 (61,0), dem von Kimi K3 (68,0) und dem von DeepSeek V4.1 Flash (74,2); bei Terminal Bench v2.1 erreicht Beam einen Wert von 80,1, während GLM-5.3, Kimi K3 und DeepSeek V4.1 Flash Werte von 88,2, 88,3 bzw. 90,6 erreichen. Bei Humanity's Last Exam (HLE) erreicht Beam einen Wert von 36,2, der ebenfalls unter dem Wert von GLM-5.3 (42,3) und dem von Kimi K3 (46,9) liegt.
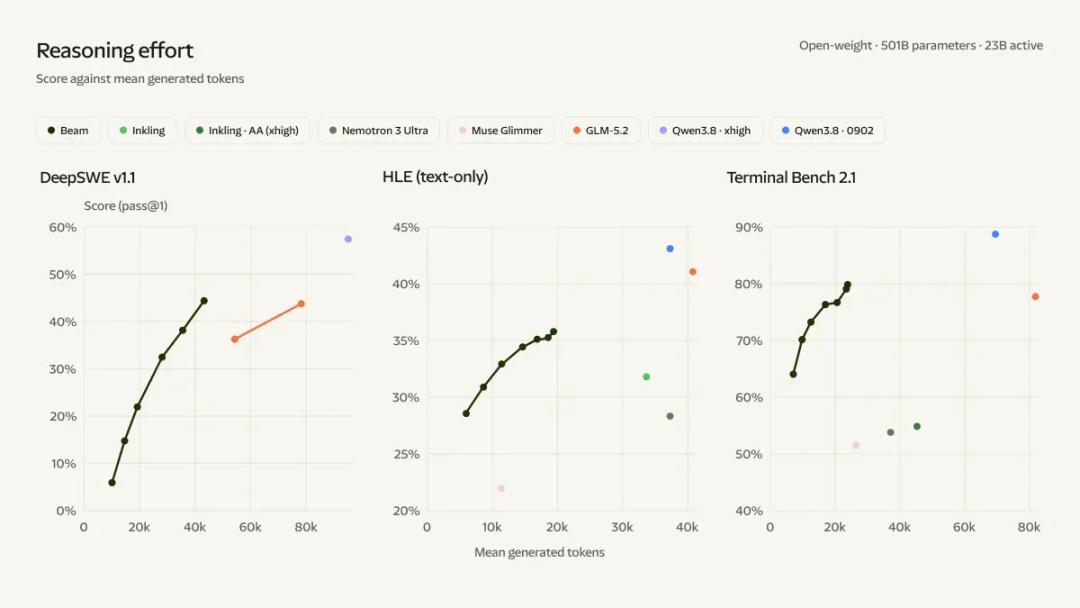
Daher hat Beam derzeit die US-amerikanischen Open-Source-Modelle wieder in die Nähe der führenden chinesischen Modelle gebracht, aber es hat hauptsächlich die vorherige Generation GLM-5.2 eingeholt, und es gibt noch eine Lücke von etwa einer Generation zu der neuesten Runde chinesischer Open-Source-Modelle.
Reflection verheimlicht dies nicht. Die offizielle Seite gibt direkt zu, dass Kimi K3 in der absoluten Leistungsfähigkeit immer noch führend ist, und lenkt das Verkaufsargument von Beam auf „wie viel Intelligenz man pro Einheit der Inferenzrechenleistung erhalten kann“. CEO Misha Laskin positioniert Beam als ein „Hauptmodell“, das Unternehmen langfristig betreiben können, und nicht als das größte Modell, das nur dazu dient, Ranglisten zu erobern.
Das ähnelt auch der ursprünglichen Logik, mit der DeepSeek den Markt überzeugt hat: Der Wert liegt nicht darin, ob das Modell das erste ist, sondern darin, wie viel Kosten man aufwenden muss, um eine bestimmte Leistungsfähigkeit zu erreichen. Der Unterschied besteht darin, dass Reflection kaum als eine „kostengünstige Version von DeepSeek“ bezeichnet werden kann.
Allein die letzte Runde des Verstärkenden Lernens von Beam hat gleichzeitig mehr als 10.000 der neuesten GB300-Grafikkarten belegt. Das Unternehmen hat mehrere Milliarden US-Dollar an Finanzmitteln aufgenommen, eine große Investition von Nvidia erhalten und durch Kooperationen mit Unternehmen wie SpaceX und Nebius eine große Menge an Rechenleistung gesichert. Es ist eine „vermögensintensive Version von DeepSeek“, die von US-amerikanischem Kapital und der neuesten Hardware von Nvidia unterstützt wird.
Ioannis gibt an, dass das Ziel des Unternehmens in den nächsten Jahren darin besteht, dass die „fortschrittliche Ebene der Open-Source-Modelle“ und die „fortschrittliche Ebene der Closed-Source-Modelle“ letztendlich zu derselben Ebene werden. Im Jahr 2027 plant Reflection, Modelle mit größerem Umfang zu veröffentlichen, gleichzeitig die Rechenleistung für das Verstärkende Lernen weiter zu erhöhen und wie Modelle wie GLM mehrere durch Verstärkendes Lernen erweiterte Versionen auf dem Basismodell aufbauend nacheinander herauszubringen.
Misha ist der Ansicht, dass hinter diesem Kurs tatsächlich eine größere Einschätzung steckt: Das Verstärkende Lernen hat sich von einer Technologie für spezielle Bereiche wie einst bei AlphaGo und AlphaZero zu einer grundlegenden Methode entwickelt, die die Weiterentwicklung von allgemeinen Modellen, Programmiermodellen und Agent-Modellen nachhaltig vorantreiben kann.
Seiner Ansicht nach sind diese Modelle derzeit „entweder bereits eine Form von AGI oder befinden sich zumindest eindeutig auf einem kontinuierlichen Weg zu AGI“. Die Kernfrage besteht nicht mehr nur darin, wie man die Modelle weiter stärken kann, sondern darin, wie man diese Fähigkeit technisch umsetzen und zu einem Produkt machen kann und sie über eine multipolare Ökologie mit höherem Offenheitsgrad verbreitet.
Mistral startet erneut den Angriff auf die führenden Open-Source-Modelle
Im Vergleich zu Reflection, das gerade sein erstes Basismodell veröffentlicht hat, steht der europäische Modellanbieter Mistral unter einem größeren Druck.
Vor zwei oder drei Jahren war es zeitweise das repräsentativste Unternehmen für Open-Source-Modelle. Aber mit der schnellen Iteration von Modellen wie DeepSeek, Qwen, Kimi und GLM ist die Präsenz von Mistral in den Ranglisten der fortschrittlichen Fähigkeiten stetig gesunken. Im September dieses Jahres wurde CEO Arthur Mensch in einem Interview sogar direkt gefragt: Die Modelle von Mistral sind in der Rangliste von Artificial Analysis auf den Platz außerhalb der Top 20 gefallen – wurden sie von den USA und China abgehängt?
Mensch antwortete damals, dass die neue Generation großer Modelle bald veröffentlicht wird und das Unternehmen für das nächste Jahr bereits die nächsten zwei Produktgenerationen geplant hat. Die neu aufgenommenen Finanzmittel von Mistral werden in großem Umfang zur Erweiterung der Trainingsrechenleistung verwendet, sodass die insgesamt aufrufbare Trainingsrechenleistung künftig um etwa das 20-fache steigen könnte.
Zwei Wochen später tauchte Mistral Large 4 auf.
Mistral Large 4 hat 52 Milliarden aktive Parameter und 1,05 Billionen Gesamtparameter, ist mit einem visuellen Encoder mit 1,6 Milliarden Parametern ausgestützt, unterstützt nativ Multimodalität und mehr als 160 Sprachen und verfügt über ein Kontextfenster von 1 Million Token. Bemerkenswert ist, dass es in den Rechenzentren von Mistral in Europa mit etwa 3800 Nvidia Grace Blackwell GPUs von Grund auf trainiert wurde. Das Modell ist derzeit bereits als API-Vorschau zugänglich, und die vollständigen Gewichte werden Ende Oktober veröffentlicht.
Im offiziell von Mistral vorgelegten Coding Agent Index hat Large 4 DeepSeek V4 Pro und Qwen 3.8 Max übertroffen, liegt aber unter Kimi K3. Bei einem Blindtest in Zusammenarbeit mit dem Drittanbieter Surge AI bewerteten die Fachgutachter die Codequalität von Large 4 mit 3,74 Punkten, was unter dem Wert von Claude Opus 5 (4,22) liegt, aber über den Werten von Kimi K3 (3,59), GLM-5.3 (3,60) und GLM-5.2 (3,40).
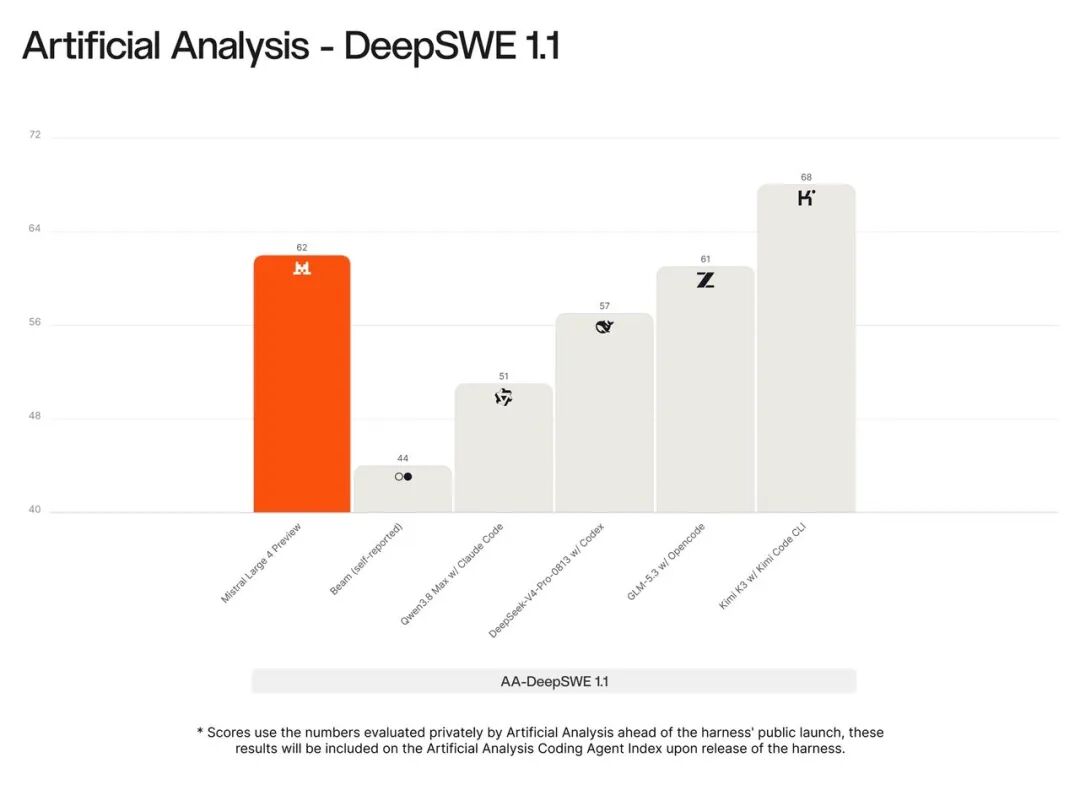
Mistral zielt offensichtlich auf „Unternehmens-Agenten“ ab und nicht nur auf Entwickler. Bei 657 Geschäftsabläufen in AutomationBench, die Anwendungen wie Gmail, Google Sheets, Slack und Salesforce umfassen, gibt Mistral an, dass Large 4 Kimi K3, MiMo-V2.6-Pro und DeepSeek V4 Pro übertroffen hat, aber unter GLM-5.3 liegt. Bei wissenschaftlichem Code, Cybersicherheit sowie einigen Finanz- und Rechtsaufgaben behauptet Mistral ebenfalls, das Spitzenniveau der Open-Source-Modelle erreicht zu haben.
Diesmal hat Mistral besonders die Fähigkeiten im Bereich Cybersicherheit vorgestellt. Mistral gibt an, dass Large 4 in die globalen Top 5 des Artificial Analysis Cyber Index eingetreten ist und bei einer Aufgabe zur „Nachbildung echter Schwachstellen und deren Behebung“ einen Wert von 82 % erreicht hat, was die Höchstpunktzahl bei diesem Test ist. Bei Cybench wurden 93 % der Herausforderungen gemeistert. Mistral betont absichtlich, dass einige Closed-Source-Modelle aufgrund von Mechanismen zur Ablehnung aus Sicherheitsgründen bei bestimmten Aufgaben zur Nachbildung von Schwachstellen kaum eine Antwort liefern können, während Open-Weight-Modelle es Unternehmen ermöglichen, eigene Sicherheitsrichtlinien zu definieren und sie in privaten Clouds oder lokalen Umgebungen bereitzustellen.
Natürlich stammt ein großer Teil dieser Daten derzeit noch aus den eigenen Tests von Mistral, und Large 4 befindet sich noch in der Phase der öffentlichen Vorschau, die echten Gewichte sind noch nicht freigegeben.
Das Geschäftsmodell, das chinesische Anbieter anfänglich in der Grundform umgesetzt haben
Neben den Modellfähigkeiten verfolgen Mistral und Reflection auch einen kommerziellen Kurs, der von inländischen Anbietern anfänglich bestätigt wurde.
Reflection erzählt eine sehr „amerikanische“ Geschäftsgeschichte: Es möchte ein neuer vollständiger Anbieter von KI-Infrastruktur werden, der von Basismodellen ausgeht und nach oben Inferenz, Agenten, Software und Unternehmensbereitstellung übernimmt, während er nach unten tief in die Rechenleistungsverwaltung und Clusterplanung einsteigt und langfristig sogar eigene Rechenzentren besitzt.
Er ist der Ansicht, dass jede Schicht wie Modelle, Anwendungen, Cloud-Computing und Bare-Metal langfristig zu einer Ware wird. Unternehmen, die nachhaltig hohe Gewinne erzielen können, sind in der Regel diejenigen, die den gesamten Technologie-Stack vertikal integrieren. Misha hat sogar eine sehr „silicon-valley-typische“ Formel vorgelegt:
Einnahmepotenzial = Intelligenzdichte × Rechenleistungsumfang × Vertrauen der Unternehmen.
Misha gibt an, dass Open-Source-Modelle selbst nicht unbedingt direkt Geld einbringen, aber sie können eine enorme Nachfrage nach Inferenz erzeugen. So wie Kubernetes selbst quelloffen ist, aber den Cloud-Markt vorangetrieben hat, werden Open-Source-Modelle Unternehmen dazu bringen, Rechenleistung, Inferenz und vollständige KI-Infrastruktur zu erwerben. Daher verkauft Reflection tatsächlich die Fähigkeit, eine gesamte intelligente Infrastruktur rund um Beam aufzubauen.
Es vergleicht sich sogar mit den frühen Phasen von AWS und GCP. AWS wurde ursprünglich von Amazon entwickelt, um die eigenen Probleme mit der Serverinfrastruktur zu lösen, und Google Cloud entstand aus den Fähigkeiten von Google im Bereich groß angelegter verteilter Systeme, die zur Unterstützung des Suchgeschäfts gebildet wurden. Die Logik von Reflection lautet: Das Unternehmen muss selbst Probleme wie den Dienst von Billionen von Token, Milliarden von Agent-Sandboxen und die Planung von GPUs lösen, um fortschrittliche Modelle zu trainieren. Diese internen Technologien können letztendlich wie Cloud-Computing nach außen ausgegeben werden.
Das Geschäftsmodell von Mistral betont ebenfalls die Bereitstellung für Unternehmen, aber es richtet sich stärker an eine „europäische Version der vollständigen KI-Stacks“.
Arthur vertritt die Ansicht, dass kleine und effiziente Open-Source-Modelle, die angepasst und bereitgestellt werden können, den Anforderungen von Unternehmen besser entsprechen als allgemeine Modelle, die nur nach maximaler Größe streben. Mistral baut gleichzeitig eigene Modelle, Plattformen für die unternehmensspezifische Anpassung und europäische Rechenleistungsinfrastruktur auf und möchte ein Anbieter werden, bei dem Training, Inferenz und Bereitstellung alle innerhalb des europäischen Rechts- und Infrastruktursystems stattfinden können.
Seiner Ansicht nach können europäische Unternehmen ihre zentralen KI-Fähigkeiten nicht vollständig davon abhängig machen, ob ausländische Anbieter weiterhin Dienstleistungen erbringen wollen, und sie können ihre technologische Grundlage nicht auf Modelle anderer Länder übertragen. Daher will Mistral nicht nur selbst Modelle trainieren, sondern auch Rechenzentren in Europa bauen, um die gesamte Kette von Rechenleistung, Modellen bis zur Bereitstellung für Unternehmen zu kontrollieren.