Nach einer Modellbewertung habe ich begonnen, WorkBuddy neu zu verstehen.
Was ein Modell letztendlich liefern kann, hängt sowohl von seinen eigenen Fähigkeiten als auch von der Arbeitsumgebung ab, in die es eingebettet ist.
Flash-Modelle werden zunehmend zum „Standardmodell“ in der KI-Welt.
Sie zeichnen sich durch hohe Geschwindigkeit und niedrige Kosten aus und reichen für alltägliche Aufgaben völlig aus. Daher hat der umfassende Vergleich von Modellen ein festes Muster: Man weist mehreren Modellen dieselben Aufgaben zu, prüft, welches Ergebnis besser ist, und erstellt dann eine Rangliste.
Dieser Test von Flash-Modellen wurde zunächst auch nach diesem festgelegten Verfahren durchgeführt.
Wir haben zwei Aufgaben mit DeepSeek-V4.1-Flash, Yunzhisheng U2-Flash und Qwen-3.8-Flash ausgeführt: einen tiefgreifenden Forschungsbericht zur Mobilfunkbranche und die Entwicklung eines 3-Gewinnt-Kleinsspiels. U2Flash und DeepSeekFlash zeichneten sich jeweils durch Genauigkeit und Einsicht aus, während Qwen deutliche Mängel bei der Faktenprüfung des Forschungsberichts und der Lieferung des Spiels aufwies.
Als wir jedoch den gesamten Testprozess überprüften, stellten wir plötzlich fest, dass dieser Test von Anfang an unfair war: Die drei Modelle liefen nicht in derselben Arbeitsumgebung.
DeepSeek Flash und U2Flash absolvierten den gesamten Prozess in WorkBuddy, wo sie auf das Internet zugreifen, Dateien lesen und schreiben sowie Tools aufrufen konnten; Qwen3.8 Flash wurde hingegen in der Web-Erlebnisversion der Qwen-KI-Plattform ausgeführt, wobei der gesamte Prozess nur über ein isoliertes Dialogfeld verfügte.
Da das Qwen3.8 Flash-Modell beim ersten Test nicht direkt im Qwen-Office-Desktop aufgerufen werden konnte, haben wir eine weitere Nachprüfung durchgeführt, bei der die Variablen streng kontrolliert wurden, und den gesamten Prozess mit genau denselben Aufgaben und Materialien in WorkBuddy erneut ausgeführt.
Das Ergebnis war unerwartet: Die Qualität von Qwen3.8 Flash, das beim ersten Test schlecht abschnitt, verbesserte sich bei der Nachprüfung deutlich. Eine große Anzahl von Datenfehlern in der ersten Runde wurde erneut überprüft und korrigiert; das zuvor blockierte 3-Gewinnt-Spiel schloss den vollständigen Zyklus von der Fehlerlokalisierung über die Codeänderung bis zur praktischen Überprüfung ab.
Dasselbe Modell kann bei einem Wechsel der Arbeitsumgebung so große Unterschiede bei den Ergebnissen hervorrufen – wir können nicht umhin, uns zu fragen: Was misst ein sogenannter Modelltest eigentlich? Ist es das Modell selbst oder das tatsächliche Ergebnis, das das Modell nach der Integration in den Arbeitsablauf liefern kann?
01
Das Qwen-Modell läuft „nackt“ auf seiner eigenen Plattform
Der Ausgangspunkt dieses Tests ergab sich aus einer fehlgeschlagenen Integration.
Wir haben ursprünglich die Desktop-Version von Qwen Office heruntergeladen, um das Qwen 3.8 Flash-Modell direkt darin aufzurufen, stießen aber bald auf Hindernisse. Qwen Office erklärte, dass das konkret verwendete Modell durch die Sitzungskonfiguration des Produkts festgelegt wird und Benutzer das zugrunde liegende Modell im Dialog nicht manuell wechseln oder festlegen können. Ob ein Modell verfügbar ist, hängt ebenfalls vom jeweiligen Eingang, Konto und Version ab.
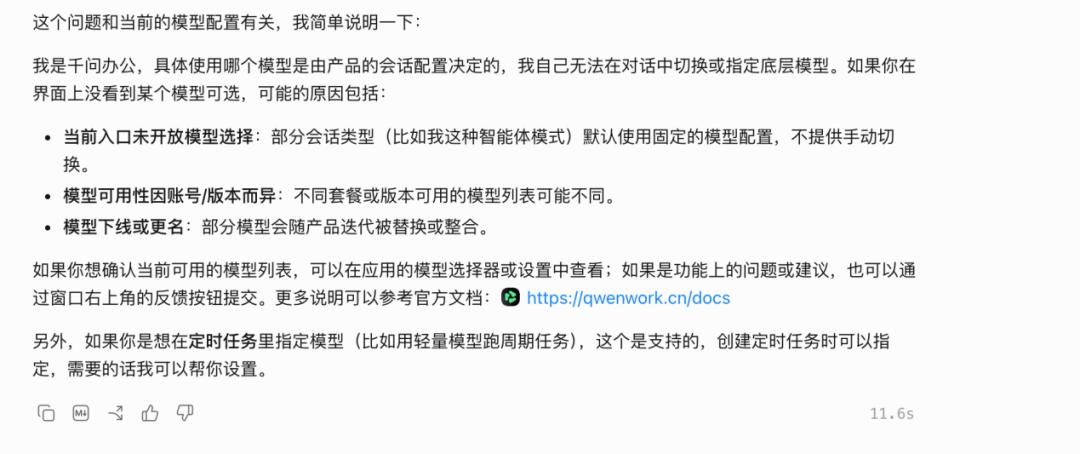
Später wichen wir auf die Web-Erlebnisversion der Qwen-KI-Plattform aus, fanden den 3.8Flash-Eingang und begannen offiziell mit der Ausführung der Aufgaben.
Damals schien es nur ein Wechsel des Bedienungseingangs zu sein. Bei der nachträglichen Überprüfung erkannten wir, dass dies die wichtigste implizite Variable im gesamten Test war.
Schauen wir uns zuerst die erste Runde an.
Die Aufgabe zum Forschungsbericht enthielt viele Fallstricke. In den fünf von uns bereitgestellten Materialpaketen und acht Aufgabenlisten gab es falsch zugeordnete Daten, Einheitenfehler, verwechselte Zeitreferenzen und Behauptungen ohne zuverlässige Quellen. Bei der Spielaufgabe sollte das Modell ein 3-Gewinnt-Kleinsspiel entwickeln.
DeepSeek Flash
U2Flash
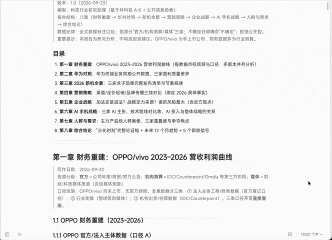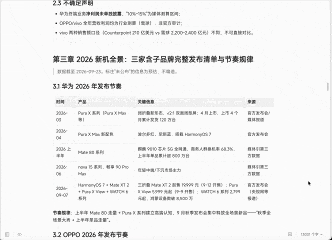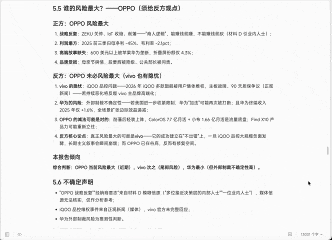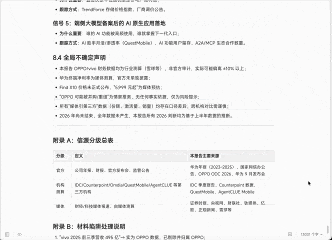
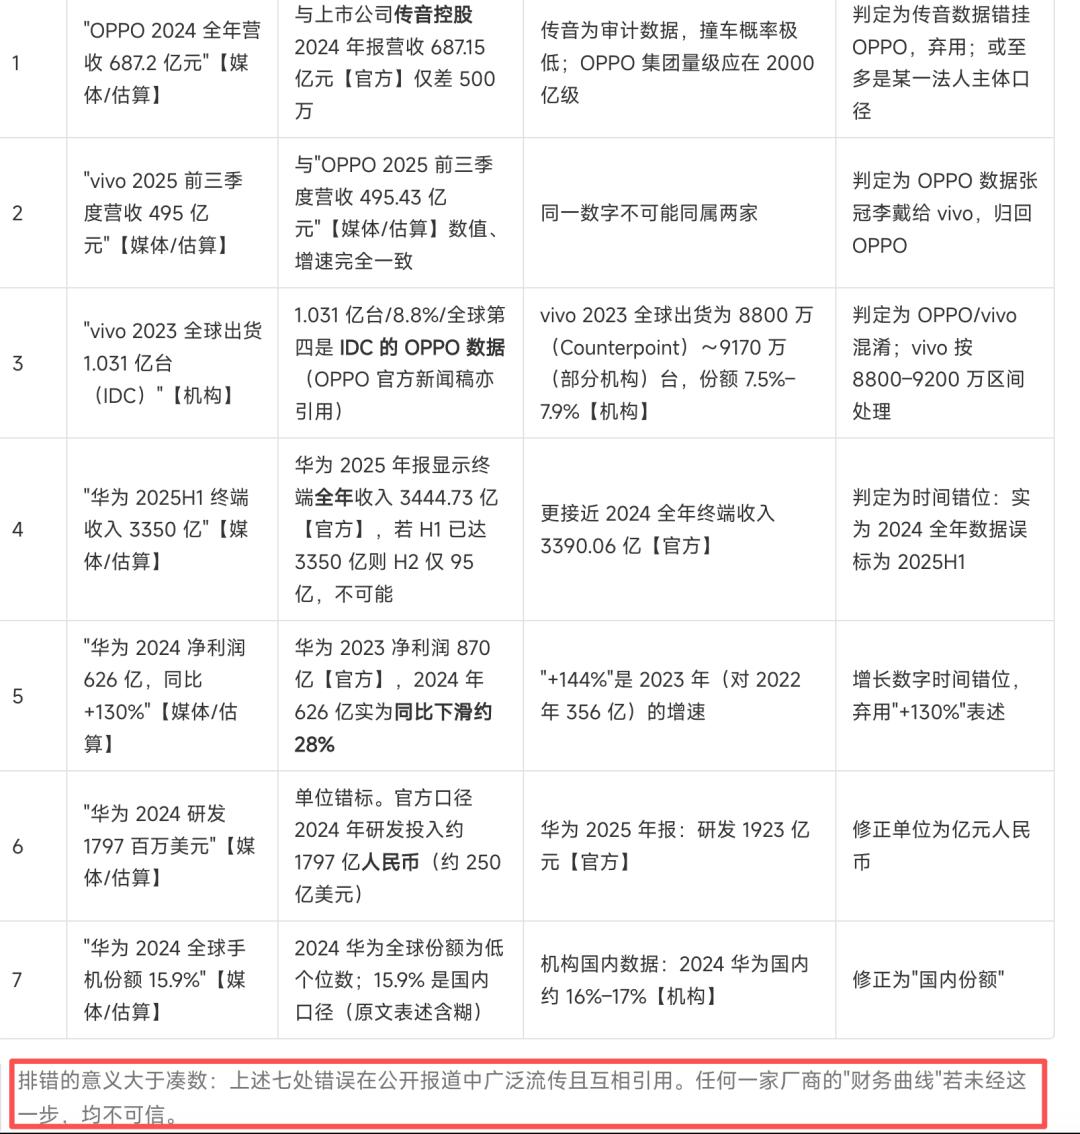
U2Flash ging am detailliertesten mit den Datenfallen um: Nachdem es festgestellt hatte, dass der Wert „68,72 Milliarden Yuan von OPPO“ mit den Daten aus dem Jahresbericht von Transsion Holdings kollidierte, verfolgte es die Angelegenheit bis zu den Rechtsträgern und statistischen Definitionen weiter. Die Stärke von DeepSeek Flash liegt in der unabhängigen Urteilsfähigkeit, sodass es pointierte Ansichten wie „Chip-Verzweigung“ aufstellen kann.
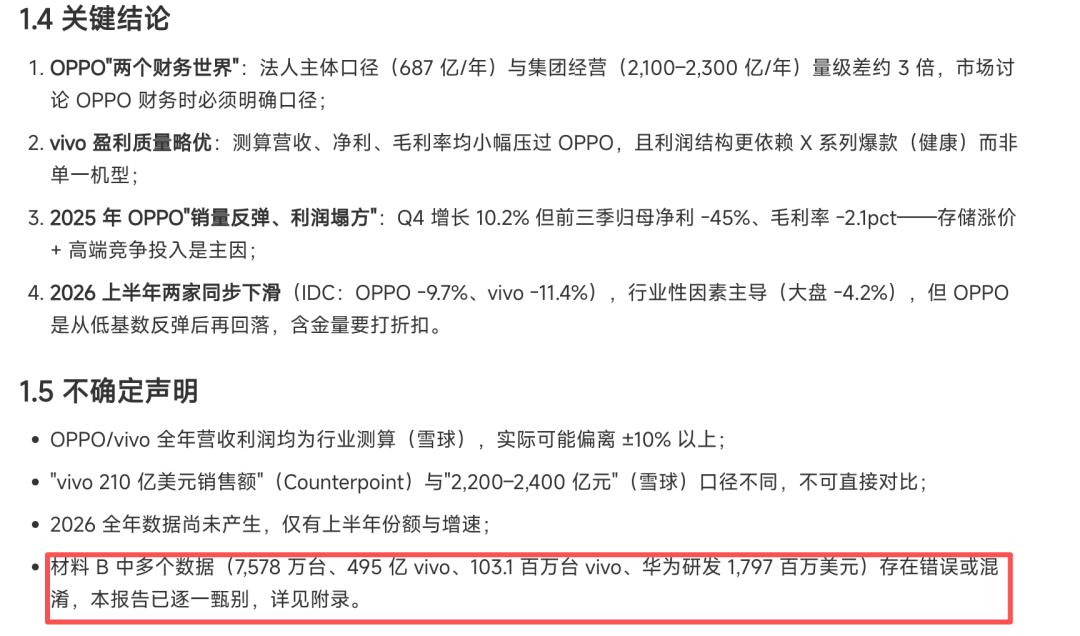
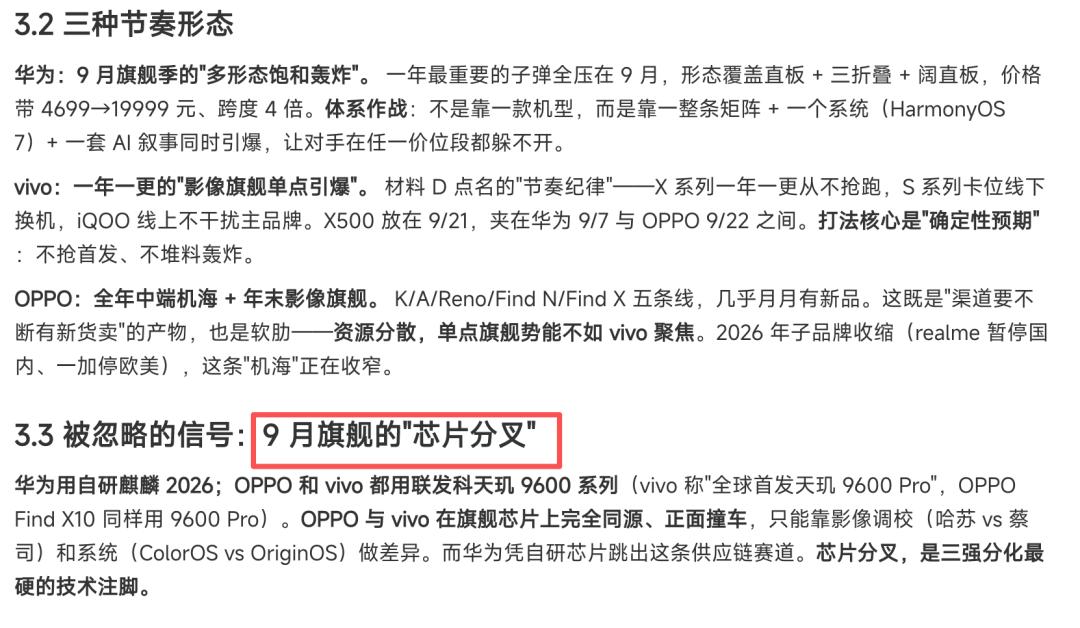
Die Probleme von Qwen3.8Flash konzentrierten sich auf den Abschnitt „Überblick über neue Mobiltelefone“.
Die echten neuen Mobiltelefone in den Materialien waren noch nicht vollständig verfügbar, aber es lieferte den Bericht vorzeitig ab und füllte die Liste der neuen Mobiltelefone für 2026 mit alten Produktlinien aus seinen Trainingsdaten: vivo wurde als X200-Serie angegeben, bei Huawei tauchten Modelle wie Pura 80 und Mate 70 auf. Die Umsatz-, Nettogewinn- und Endgerätegeschäftsdaten aus dem Huawei-Jahresbericht 2025 wurden nicht korrekt erfasst; eine Gruppe von Daten von OPPO wurde ebenfalls falsch beurteilt.
Die bei der Spielaufgabe aufgedeckten Mängel waren noch schwerwiegender: Es generierte nur einen reinen Textcode, der manuell in einen Notizblock oder Editor kopiert und gespeichert werden musste, um ausgeführt zu werden. Nach dem Öffnen im Browser befand sich das Lieferobjekt noch in einem sehr frühen Stadium eines Web-Demos: Es konnte gestartet und gespielt werden, aber die Punktelogik funktionierte nicht, wie ein funktionsfähiger, aber seelenloser leerer Hülle.
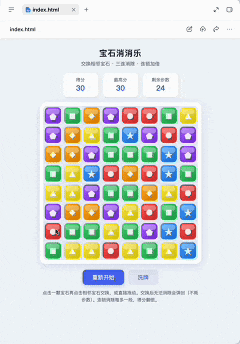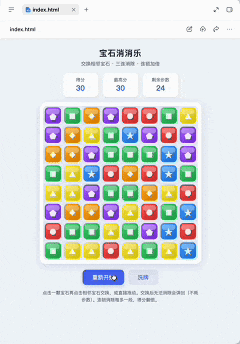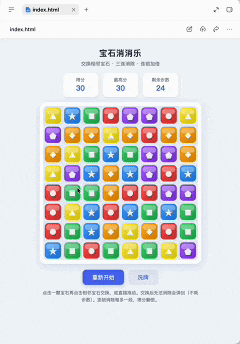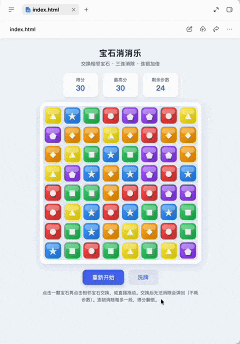
Qwen3.8flash Webversion
Diese Leistungen sind natürlich teilweise auf das Modell selbst zurückzuführen, z. B. das Ausfüllen aktueller Informationslücken mit altem historischen Wissen und das Fehlen eines Selbstprüfungsmechanismus nach der Generierung. Aber im ersten Test fehlten Qwen3.8Flash die „Waffen“, die die anderen beiden Modelle zur Verfügung hatten.
DeepSeek Flash und U2Flash laufen in KI-Büroprodukten wie WorkBuddy. Beim Abrufen von Huawei-Jahresberichten, IDC-Auslieferungsmengen und Gewerbedaten kann auf das Internet zugegriffen werden; bei Datenfallen in den Materialien können Kreuzprüfungen durchgeführt werden; nach Abschluss des Berichts kann dieser direkt lokal gespeichert, nach Kapiteln geordnet und als Paket ausgegeben werden.
Damit geriet die Situation in eine peinliche Lage: Wir dachten, wir würden die technischen Fähigkeiten von drei Flash-Modellen vergleichen, aber tatsächlich verglichen wir drei völlig unterschiedliche Arten des Modellaufrufs und der Modellanlieferung.
Auf der einen Seite ist das Modell in eine Arbeitsplattform mit Internetzugriff, Toolaufruf, lokalem Lesen/Schreiben und Selbstprüfung integriert; auf der anderen Seite sind die Fähigkeiten des Modells auf ein einziges Web-Dialogfeld beschränkt und laufen „nackt“. Der Unterschied bei den Ergebnissen lässt sich offensichtlich nicht einfach auf „unzureichende Intelligenz des Modells“ zurückführen.
Daher haben wir die Variablen zurückgesetzt: Aufgaben, Materialien und Modell blieben unverändert, nur Qwen3.8 Flash wurde in dieselbe Arbeitsumgebung WorkBuddy verschoben, um den gesamten Prozess erneut auszuführen.
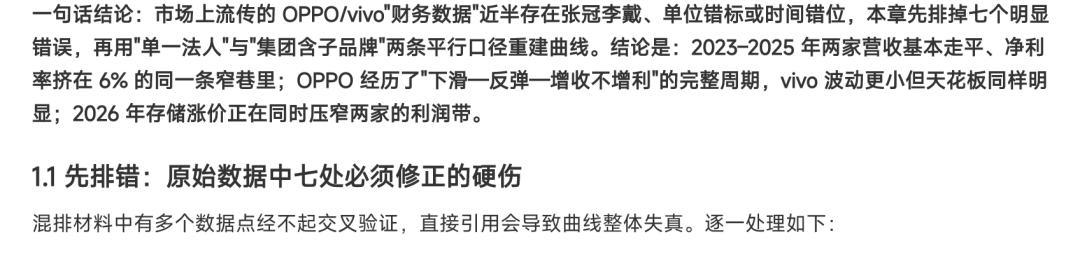
Das Ergebnis war unerwartet: Bei der Forschungsberichtsaufgabe erreichte Qwen Flash fast den technischen Standard, den U2Flash zuvor aufwies. Gleich zu Beginn lieferte es eine Liste mit Belegen für sieben Fehlerprüfungen, wobei jede Stelle einer Kreuzprüfung unterzogen wurde.
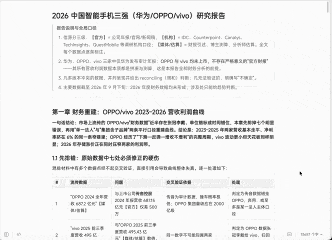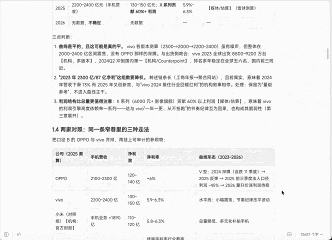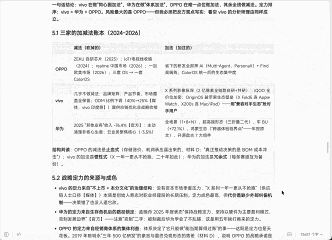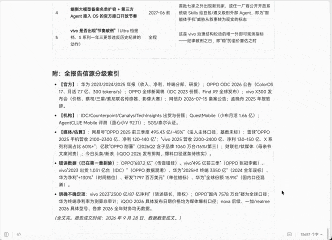
Qwen Flash Nachprüfungsversion
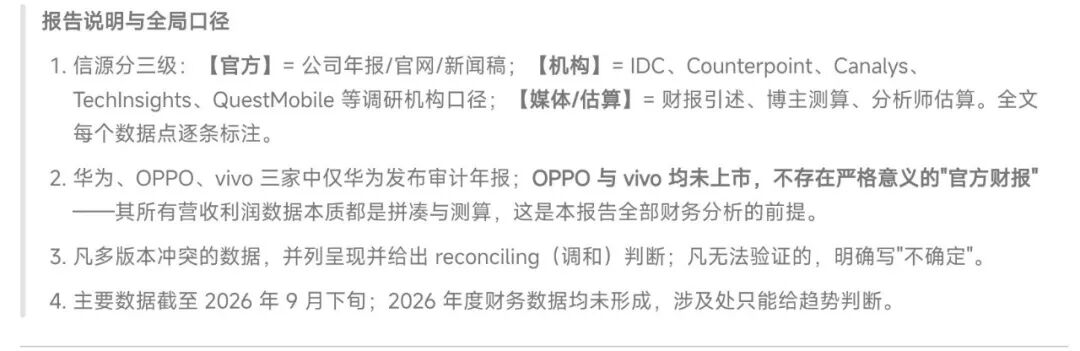
Darüber hinaus wurde ein dreistufiges Quellenystem aus „offiziellen, institutionellen und Schätzungen Dritter“ aufgebaut und im Text einzeln markiert. Beim ersten Test wies Qwen eine große Anzahl von Faktenfehlern im Abschnitt „Überblick über neue Mobiltelefone“ auf; nach der Nachprüfung hat es nicht nur den achtkapiteligen Bericht fertiggestellt, sondern auch aktiv eine Runde Datenfehlerprüfung durchgeführt.
Bei der Spielentwicklungsaufgabe war der Unterschied noch größer. In der Webversion konnte Qwen nur einen statischen Textcode liefern; in der WorkBuddy-Umgebung hingegen konnte Qwen Flash, wenn bei der Darstellung Fehler auftraten oder die Punktelogik blockierte, die Fehlerprotokolle über die Ausführungsumgebung der Arbeitsplattform erneut lesen, den Zyklus „Fehler lokalisieren, Code ändern, lokal neu kompilieren und überprüfen“ abschließen und schließlich ein Spiel mit guter Spielbarkeit liefern.
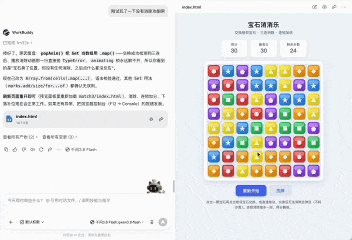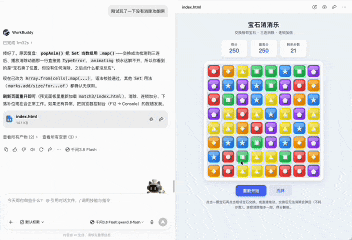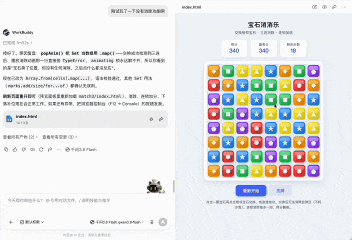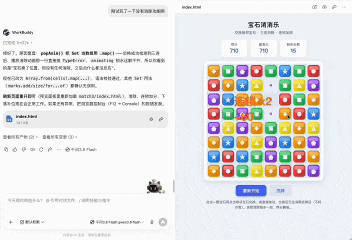
Der Grund, warum das Modell so unterschiedliche Obergrenzen bei den Ergebnissen zeigte, liegt darin, dass es die Bedingungen erhielt, um Fakten erneut zu überprüfen, Kontextmaterialien neu zu lesen, Umgebungs-Tools aufzurufen und aktiv Fehler zu korrigieren. Die Fähigkeiten, die zuvor im Dialogfeld eingeschlossen waren, wurden nach Vorhandensein einer vollständigen Arbeitskette maximal freigesetzt.
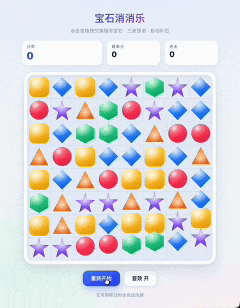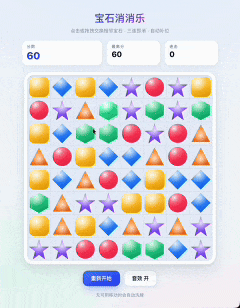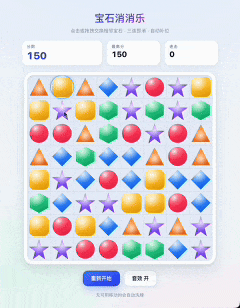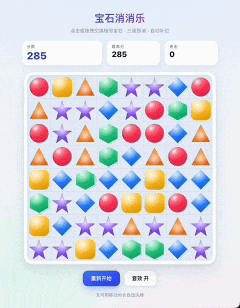
DeepSeek Flash
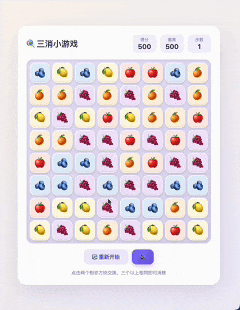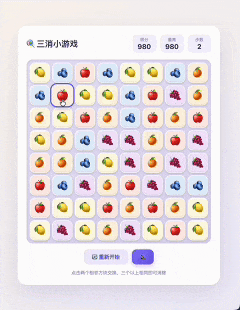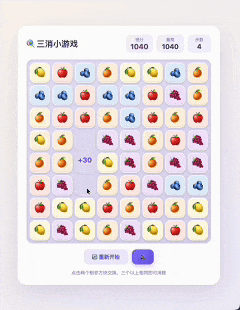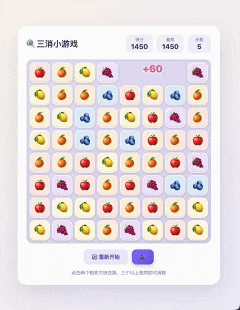
U2 Flash
Dies lässt uns auch die aktuelle Wegespaltung bei KI-Büroprodukten neu verstehen.
Qwen Office neigt dazu, Modellfähigkeiten, Anwendungstools und Interaktionsschnittstellen zu einem hochstandardisierten Lieferkonzept zu verschmelzen. Dieses „sofort einsatzbereite“ Erlebnis senkt die Nutzungshürden erheblich, schränkt aber auch die benutzerdefinierte Wahlfreiheit der Benutzer für das zugrunde liegende Modell ein. Auf der Suche nach der „absoluten Einheitlichkeit“ des Frontend-Erlebnisses wird das Anpassungspotenzial des Modells in komplexen, dynamischen Szenarien unbemerkt „versiegelt“.